
《海外 GEO 白皮书(四)方法与度量体系:GEO“五可”工程框架、分场景方案、指标体系与 GA4 流量归因》
将海外 GEO 工程化为“可抓取、可解析、可引用、可归属、可监测”五层体系。提供独立站、SaaS 与跨境电商分阶段 SOP,给出 SoM(模型声量份额)与引用率计算公式,并说明 GA4 AI 流量自定义渠道组配置。
方法论:GEO“五可”框架
GEO 工程方法可归纳为五个依次递进的环节:可抓取、可理解、可信任、可引用、可推荐。
前三项与传统 SEO 重合度高、实证依据最充分,应优先落地;后两项属于 GEO 的增量工作,潜在收益大但机制仍在演进,需要边改边测。
框架总览
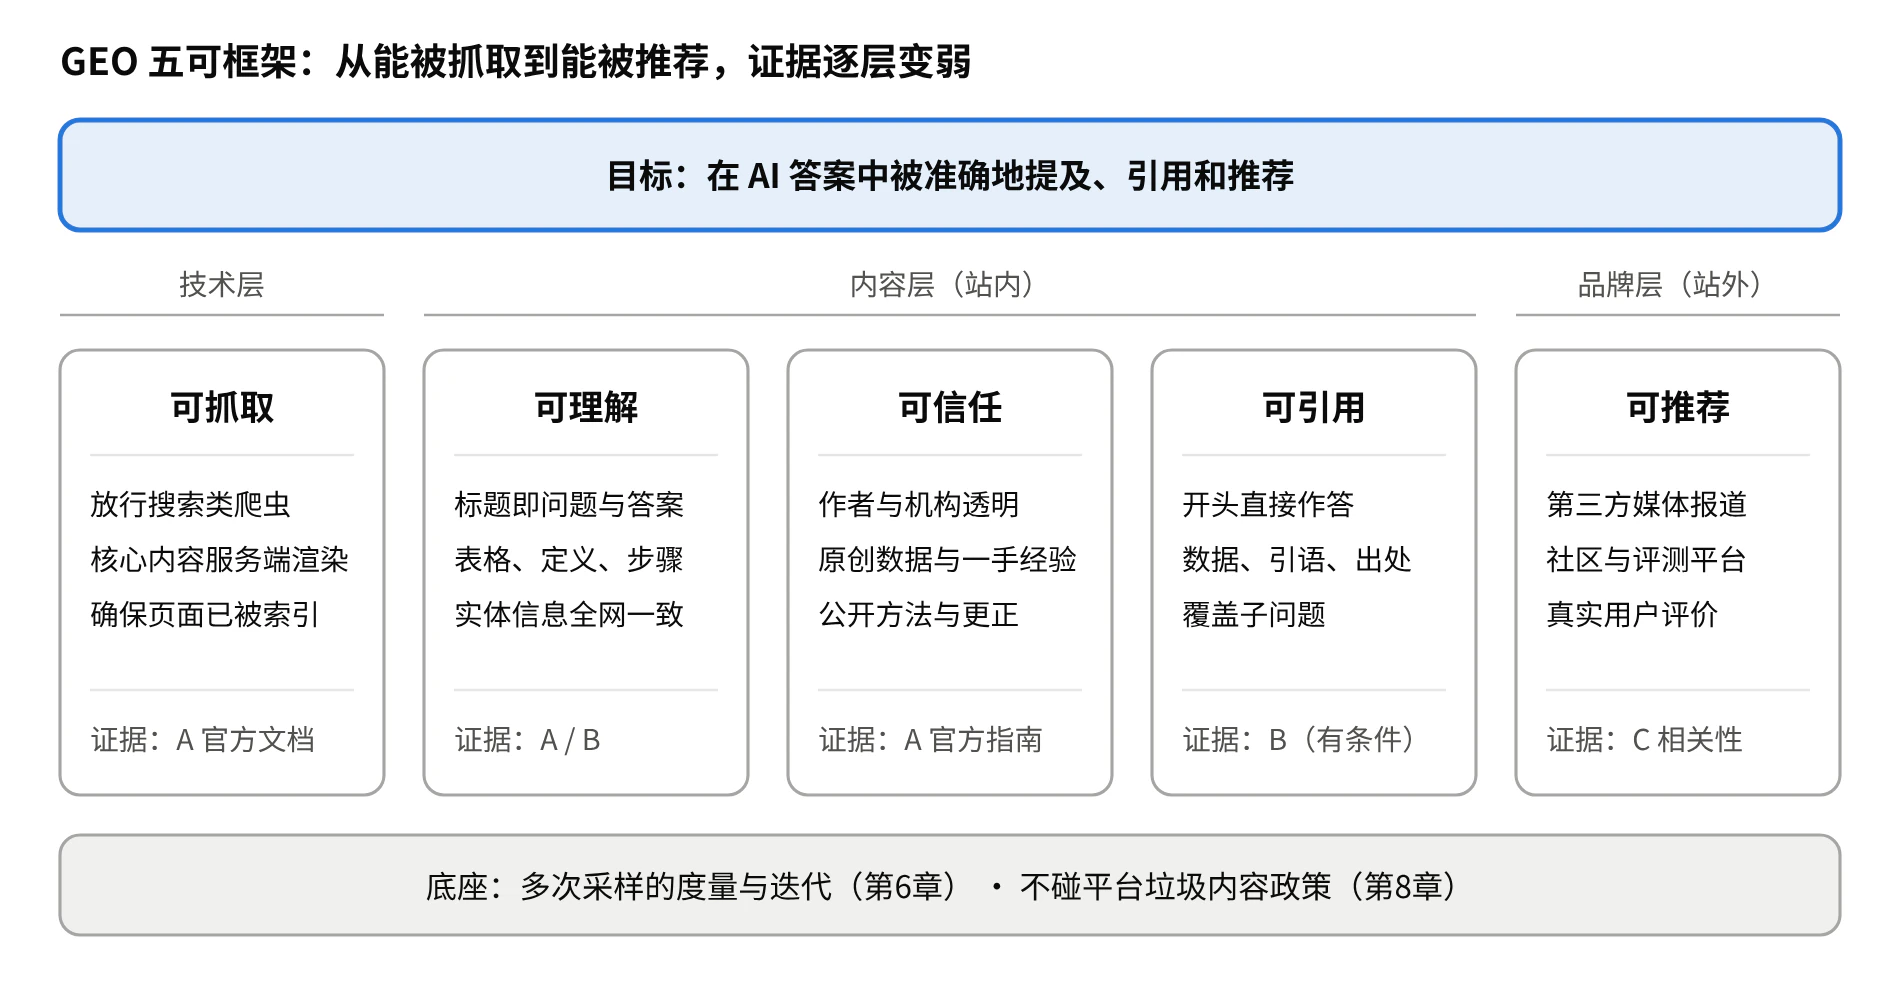
可抓取解决“抓取与索引”;可理解和可信任解决“召回与重排”;可引用解决“生成与引用”及“吸收与保真”;可推荐则作用于模型参数知识与站外信源。
可抓取:先让 AI 看得见
爬虫放行矩阵
主流平台已将“搜索引用”和“模型训练”拆分为不同爬虫,品牌可按需分别配置权限。对于希望获得 AI 推荐的绝大多数品牌,建议按以下矩阵配置:
| 爬虫类型 | 代表 | 建议 | 理由 |
|---|---|---|---|
| 搜索与引用 | Googlebot、OAI-SearchBot、PerplexityBot、Claude-SearchBot | 放行 | 一旦屏蔽即退出对应平台的实时检索引用 |
| 用户发起的访问 | ChatGPT-User、Perplexity-User、Claude-User | 放行 | 用户在对话中点击或要求读取你的页面时才会触发 |
| 模型训练 | GPTBot、ClaudeBot、Google-Extended | 按内容资产价值决定 | 影响长期参数记忆;付费内容与独家数据可考虑屏蔽。注意 Google-Extended 同时控制 Gemini 应用的联网引用 |
技术检查点
CDN 与防火墙
2025 年 7 月 1 日起,Cloudflare 对托管站点默认拦截 AI 爬虫,并推出“按抓取付费”机制(MIT Technology Review)。
许多网站在未察觉的情况下误拦了搜索类 AI 爬虫,应逐一核对 robots.txt、CDN 和 WAF 三层规则。
JavaScript 渲染
Vercel 在 2024 年 12 月的网络统计显示,GPTBot、ClaudeBot 和 PerplexityBot 等主要 AI 爬虫均不执行 JavaScript,仅有共用 Googlebot 基础设施的 Gemini 和 Applebot 支持客户端渲染。此外,ChatGPT 和 Claude 的抓取请求中约三成碰到 404 错误(Vercel)。核心内容必须启用服务端渲染,并持续维护重定向与 sitemap。
索引底座
Google 系产品看 Google 索引,Claude 可参考 Brave 收录状态,ChatGPT 和 Perplexity 则看各自爬虫日志。服务器原始日志是核验 AI 爬虫是否来访的最直接证据。
llms.txt
Google 已明确声明不使用该文件。Chrome Lighthouse 13.3 的“智能体浏览”审计虽会检查该文件是否存在,但其定位是辅助浏览器智能体理解站点目录,不影响搜索排序或 AI 引用。开发者文档类站点可低成本提供,常规站点无需优先投入。
智能体可操作性
按钮、表单和导航菜单应采用语义化 HTML 与 ARIA 标签,这也是 OpenAI 针对 Atlas 浏览器智能体给出的明确工程建议。
可理解:让每一段都能单独回答一个问题
Google 官方指南建议使用描述性标题、短段落与清晰定义,配合列表、对比表格、分步说明与 FAQ,同时明确无需把正文生硬切碎。
具体执行要点如下:
标题直接写成问题或结论(如“X 和 Y 有什么区别”“X 适合哪些场景”),直接匹配查询扇出拆解出的子问题。
每小节只讲一件事,写明具体主语,避免依赖上文语境的“它”或“该产品”。
技术参数、定价梯度与竞品对比优先使用 HTML 表格,操作流程使用有序列表。
保持实体信息一致:品牌名、产品名、创始人、成立时间与总部地址,在官网、维基百科、工商登记与社交主页上须完全统一;Organization 等结构化数据须与页面正文一致。
核心参数与政策直接用 HTML 文本呈现,不要仅封装在图片或 PDF 附件里。
可信任:让模型和读者都敢用你的内容
Google 强调在 E-E-A-T 评估体系中“信任度”权重最高,并将“非同质化原创内容”列为提升 AI 可见性的首要因素。具体做法包括:
公开作者署名、专业资质与审稿人信息,并在页脚提供真实企业主体信息与联系方式。
优先发布原创统计数据、实测记录、真实截图、实用模板与一手案例,避免二次拼凑网上已有信息。
写明调研与测试方法,引用一手信源链接,并公开内容编辑与勘误机制。
明确标注文章首次发布日期与最近更新日期,按周期刷新过期数据。
可引用:提高段落摘取率
学术界围绕这一环节开展的控制实验最多,但其生效前提是页面已经先进入检索候选集。
首句直接给结论:每小节第一句话直接写出结论与核心数字,随后再展开背景解释。
提高事实证据密度:补充统计数字、专家引述与可靠出处,是 GEO-bench 基准测试中最有效的三类改写手段。所有数据必须真实可核查,杜绝第 8 章提及的造假黑帽行为。
写明具体价格、日期与规格:大规模对照实验表明,清晰的定价数字与近期时间戳有助于提高引用率。
完整覆盖衍生子问题:围绕单一主题写清定义、横向对比、适用边界、成本估算、潜在风险与实操步骤,承接多路查询扇出。
兼顾检索相关性:SAGEO Arena 实验表明,单纯迎合生成摘录的改写可能会拉低初筛检索召回率,改写前后均需验证整体曝光。
可推荐:经营站外的品牌证据
独立第三方的品牌提及与 AI 可见度高度相关,AI 搜索引用中有 69%~92% 来自第三方“赢得媒体”。
媒体与行业报告通过公关传播、发布原创研究与输出专家观点,进入主流行业媒体与垂直评测站。
百科满足收录门槛时,确保维基百科等词条事实准确且附有第三方可靠出处;严禁自建词条或付费找人代写。
社区与视频在 Reddit 和 YouTube 等平台以官方认证身份真实互动,持续发布实操教程、答疑与产品实测。
评价平台B2B 品牌重点维护 G2 与 Gartner Peer Insights;消费品关注电商评论与 Trustpilot;本地服务重点运营 Google Business Profile 与 Yelp。
语言策略Claude 更偏重英文信源,ChatGPT 和 Perplexity 更常召回当地语言信源。出海品牌需同步建设英文主流媒体报道与目标市场本地语种内容。
红线Google 已明确禁止购买品牌提及、批量水军发帖、刷虚假好评及付费换取引用,违规站点将受垃圾内容政策处罚。
分场景打法
| 场景 | 典型问题 | 优先动作 | 重点平台 |
|---|---|---|---|
| B2B / SaaS | “X 类软件哪家好”“A 和 B 对比” | 公开定价与功能对比页、开发者文档、G2 真实评价、行业分析师报告 | ChatGPT、Claude、Perplexity |
| 电商 / 品牌零售 | “适合 X 的 Y 推荐” | 接入 Merchant Center 与 OpenAI 商品 Feed、补齐产品结构化数据、积累真实评价、合作评测媒体与 YouTube 开箱 | Google AI Mode、Gemini、ChatGPT、Perplexity |
| 本地服务 | “附近的 X 哪家好” | 完善 Business Profile、统一全网名称地址与电话(NAP)、积累真实门店评价、建设各门店独立落地页 | Google AI Overviews / AI Mode |
| 媒体 / 出版 | 时效性、解释性问题 | 发布独家数据与深度调查、标注精确发布时间、评估内容授权与分成协议 | 全部平台 |
| 出海品牌 | 英文及当地语言的品类问题 | 建设英文官网与技术文档、获取海外媒体与社区报道、积累目标市场本地语言评价 | 按目标市场选择 |
组织与流程
GEO 工程横跨 SEO、内容、公关、电商运营、数据分析与前端开发团队,建议指定专职负责人统筹,按以下五步循环推进:
诊断核查爬虫放行策略、服务端渲染状态、搜索引擎收录与全网实体信息一致性。
建立基线使用固定提示词库在五个平台重复采样,测算品牌提及率、引用率、事实准确率与竞品声量对比(见第 6 章)。
差距分析逐项排查品牌漏提的高优问题、AI 高频引用的竞品与第三方信源,以及表述失实的品牌信息。
执行补全站内核心事实页,推进站外媒体与社区合作,修正全渠道商品参数。
复测沿用同一提示词库与采样规则复测,仅采信通过统计显著性检验的变化。
90 天参考路线图
| 阶段 | 时间 | 主要工作 | 产出 |
|---|---|---|---|
| 打基础 | 第 1 天~第 30 天 | 爬虫与 CDN 审计、服务端渲染检查、提示词库搭建、首轮基线测量、GA4 AI 渠道配置 | 技术审计报告、可见性基线 |
| 补内容 | 第 31 天~第 60 天 | 改写核心落地页(首句作答、对比表格、统计数据、更新日期)、补全子问题内容、统一全网实体信息、上线商品 Feed | 内容更新清单 |
| 做站外 | 第 61 天~第 90 天 | 发布原创行业研究、推进媒体报道与社区视频合作、运营评价平台、纠正外部错误描述、执行第二轮复测 | 复测报告与下季度计划 |
指标度量体系
GEO 度量需应对两项现实约束:AI 答案存在随机波动,单次截图没有统计意义;直接引荐点击仅反映了少部分曝光影响。
因此应建立分层指标 + 固定提示词库 + 重复采样 + 日志与归因分析的组合体系,放弃单一“AI 排名”数字。
| 层次 | 指标 | 定义 | 数据来源 |
|---|---|---|---|
| 可发现 | AI 爬虫抓取覆盖率 | 重点页面中被各平台搜索类爬虫访问过的比例 | 服务器 / CDN 日志 + sitemap |
| 可发现 | 抓取错误率 | AI 爬虫请求中返回 4xx、5xx 状态码或超时的比例 | 服务器 / CDN 日志 |
| 被引用 | 提及率 | 正文提到品牌名的回答数 ÷ 有效回答数 | 提示词库采样 |
| 被引用 | 引用率 | 来源列表引用品牌自有域名的回答数 ÷ 有效回答数 | 提示词库采样 |
| 被引用 | 声量份额(SoV) | 本品牌提及次数 ÷ 同品类全部品牌提及总次数 | 提示词库采样 |
| 被引用 | 首位率 | 在推荐清单类回答中排在第一位的比例 | 提示词库采样 |
| 被吸收且准确 | 事实准确率 | 关键事实(价格、功能、资质等)表述无误的回答比例 | 采样 + 人工或模型核查 |
| 被吸收且准确 | 情感倾向 | 提及品牌时的正面、中性与负面评价占比 | 采样 + 情感分类 |
| 业务结果 | AI 引荐会话与转化 | 来自 AI 平台的访问会话、留资线索与成交订单 | GA4、网站分析工具 |
| 业务结果 | AI 展示次数 | 页面链接在 AI Overviews 与 AI Mode 中的展示次数 | Search Console 生成式 AI 报告 |
| 业务结果 | 品牌搜索量 | 品牌词自然搜索量的变化趋势,用于量化间接影响 | Search Console、Google Trends |
提示词库设计
提示词库相当于 GEO 度量的基准关键词表,应长期保持固定,仅按季度小幅迭代。
按搜索意图分层:涵盖品类认知(“什么是 X”)、产品推荐(“好用的 X 推荐”)与竞品对比(“A 和 B 选哪个”);同时纳入决策细节(价格、评价、适用场景)、品牌查询(“X 品牌怎么样”)与问题排查(“如何解决 Y”)。
以不带本品牌名的通用问题为主:第 4 章实证显示,带品牌名提问时被识别,与在无品牌品类问题中获主动推荐差距悬殊(99.4% vs 3.32%)。
为每个信息需求准备 3 种~5 种问法:同时覆盖口语长句、短关键词组与要求输出对比表等句式。
按目标市场与语种独立建库:不同语种召回的信源结构差异显著,中文、英文及目标市场本地语种需分别维护。
同步追踪核心竞品:在同一批回答中提取竞品提及次数,用于计算声量份额(SoV)。
采样与统计
Martinez 等人的综述研究给出了一套可直接落地的采样与统计规范(arXiv 2607.14035):
单题重复采样 7 次~8 次起步,并分散在多个日期窗口内采集。
完整保留“空结果”样本:未触发联网检索、未附引用链接或请求报错的记录均属真实观测分布,不可剔除。
控制环境变量并留档:固定记录采集平台、模型版本与联网模式,同步标记日期、IP 地区、界面语言、登录状态及账号等级,并归档原始回答全文与来源列表。
用概率分解式定位波动根因:
式中 A = 1 表示触发了联网检索,s ∈ R 表示自有页面进入检索候选集。当引用率下滑时,可依次排查是平台减少了联网触发、页面掉出检索候选集,还是进入候选集后未被生成模型采纳。
输出聚类置信区间:按提示词和采集日期做聚类标准误计算;若引入大模型自动判分,裁判模型与被测模型须来自不同厂商,并定期人工抽检。
设立实验对照组:改版评估时仅修改实验组页面,保留同类型未改版页面作对照;也可采用中断时间序列或双重差分(DID)方法剥离平台大盘自然波动。
流量归因
GA4 渠道识别:2026 年 5 月,Google Analytics 在默认渠道组中新增“AI Assistant”类别,无需手动配置即可自动归类 ChatGPT、Gemini 和 Claude 等引荐流量;官方未公开完整域名白名单,企业可通过自定义渠道组正则补充 Perplexity 等平台(Search Engine Journal)。
UTM 参数:ChatGPT 网页端外跳链接默认附带 utm_source=chatgpt.com 参数。
Google 自有 AI 流量:AI Overviews 与 AI Mode 的外跳点击在 GA4 中统一归入自然搜索(Organic Search),需借助 Search Console 生成式 AI 报告查看展示次数。
归因盲区补全:移动端原生应用、内置浏览器及手动复制网址带来的访问,均不携带 Referer 来源,会被归入直接访问(Direct)。实证显示受 AI 影响的访问中仅有 8.8% 来自对话链接直接点击,因此应同步监控品牌词搜索量与直接访问量趋势,并在留资表单中增设“你是从哪里了解到我们的”自报来源字段。
工具生态
| 类别 | 代表 | 能回答的问题 | 局限 |
|---|---|---|---|
| 平台官方工具 | Google Search Console 生成式 AI 报告、GA4 AI Assistant 渠道 | 在 Google AI 中的链接展示次数;各 AI 平台的引荐会话数 | 仅覆盖自家平台或带 Referer 的外跳流量 |
| 商业 AI 可见性监测 | Ahrefs Brand Radar、Semrush、Profound、Dageno AI 等 | 大规模提示词下的品牌提及率、引用率与竞品对比 | 内置词库与采样频次不透明,各服务商统计口径不一 |
| 开源 AI 爬虫与引荐分析 | GEOInflow |
AI 爬虫是否来访、抓取了哪些 URL、是否报错;AI 引荐会话与转化明细 | 无法直接观测 AI 回答正文中的无点击提及 |
| 自建采样流水线 | 各平台 API 或浏览器自动化 + 自有提示词库 | 统计口径透明可控的提及率、引用率与事实准确率 | API 返回结果可能与终端网页界面存在差异,需遵守平台服务条款 |
GEOInflow
GEOInflow 是一款面向 GEO 工程的自托管网站与 AI 爬虫日志分析系统,由猎看科技与北京日报社智源 GEO 联合发布,采用 MIT 许可证开源,当前版本为 v1.2(GitHub)。
该系统在同一站点上下文中关联三类数据:前端脚本采集的访客会话与转化事件、服务器与 CDN 原始抓取日志,以及导入的 sitemap 内容目录。
与本章指标体系直接对应的四项工程能力如下:
拆分识别爬虫身份与用途:内置规则库覆盖 OpenAI、Anthropic、Perplexity、Google、Microsoft、字节跳动、百度、Kimi 与腾讯混元等主流爬虫,按“模型训练、AI 搜索、用户触发”三类用途归类。系统分别校验 User-Agent 声明、官方 IP 网段与反向 DNS 记录,仅凭 UA 声明的请求不标记为已认证身份,直接支撑前文的“抓取覆盖率”与“抓取错误率”核算。
排查抓取覆盖盲区:将抓取日志与导入的 sitemap 目录比对,定位长期未被搜索类 AI 爬虫访问的核心落地页。
诊断抓取异常并导出规则:分类统计 HTTP 状态码、缓存命中、响应耗时与超时错误,支持一键导出 robots.txt 与 Nginx 放行拦截配置。
追踪 AI 引荐与业务转化:识别来自各 AI 搜索引擎的引荐会话,串联落地页、自定义转化目标与订单归因。
GEOInflow 官方文档明确界定了数据边界:“抓取记录能说明观察到的访问行为;收录、模型训练、回答引用、推荐排名和获客效果需要各自的证据。”
这一界定与本白皮书的分层度量框架一致:日志与引荐工具负责解决“可发现”与“业务结果”两层度量,“被引用”与“表述准确度”两层仍须配合固定提示词库采样完成。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。