向阳乔木(@vista8)实测:字节 Seedream 5.5 五项能力拆解
本文整理自向阳乔木(@vista8)对字节跳动 Seedream 5.5 的一手实测。内容包含它与 GPT Image 2.5 / 2.6(Sunburst)、Google Nano Banana 2.1 的横向对比,重点测试了 100 轮连续编辑的画面稳定性。文中还逐一实测了即梦画布多轮换装与京津雪景世界知识推理,并展示了 Capwise 透明图标拆分与李清照古画转真人,最后对比了高密度中英文信息图的文字准确率。
引言:100 轮连续编辑实测,对比 GPT Image 2.5 / 2.6
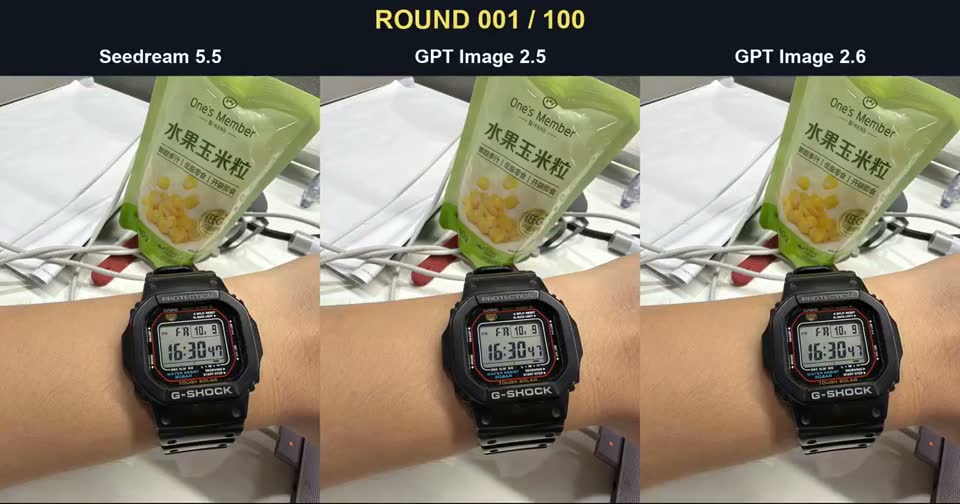
前一天看到小互和宝玉评测 Seedream 5.5,他们都重点提到了多轮编辑的稳定性。随后我在 X 上刷到一段对比测试视频,直观展示了各模型的连续迭代表现。测试将 Seedream 5.5 与 GPT Image 2.5、2.6 同台对比,每次基于上一张图预测下一秒画面,连续迭代 100 轮。结果刚过 10 轮,GPT Image 2.5 和 2.6 就出现了明显的画面涂抹与细节劣化(俗称“包浆”)。
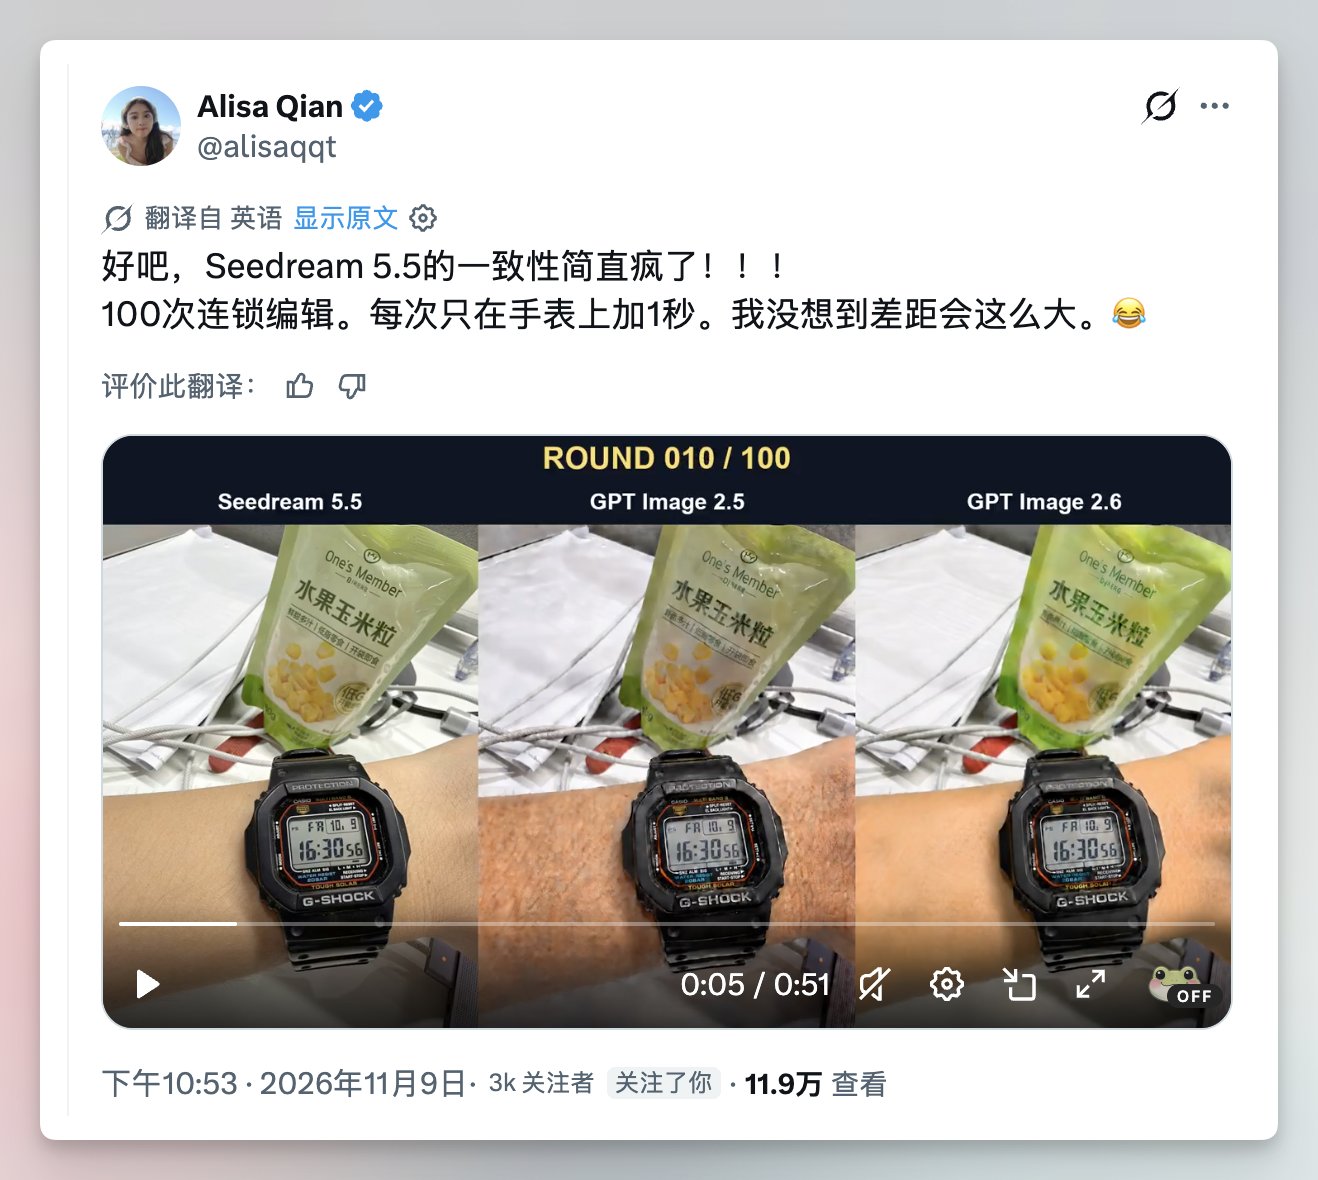
相比之下,Seedream 5.5 只有手表秒针在走动,其余背景与表盘细节保持不变,具体效果见下方视频。
小互发布的模特换装测试同样验证了这一点:GPT Image 在连续换装 10 轮后,人物面部开始走形。
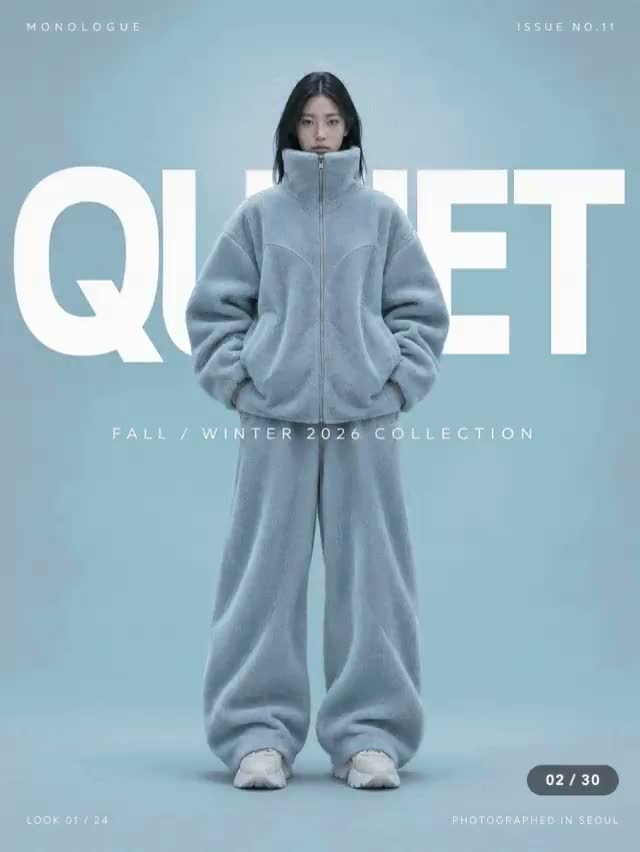
而在几十轮连续编辑后,Seedream 5.5 生成的人物主体几乎没有变化。为了验证实际体验,我也上手做了一轮完整测试。
一、多轮编辑一致性
参考小互的建议,我直接在即梦的画布模式下测试多轮编辑。
体验入口:打开即梦官网,依次进入“创作”与“画布”模块。
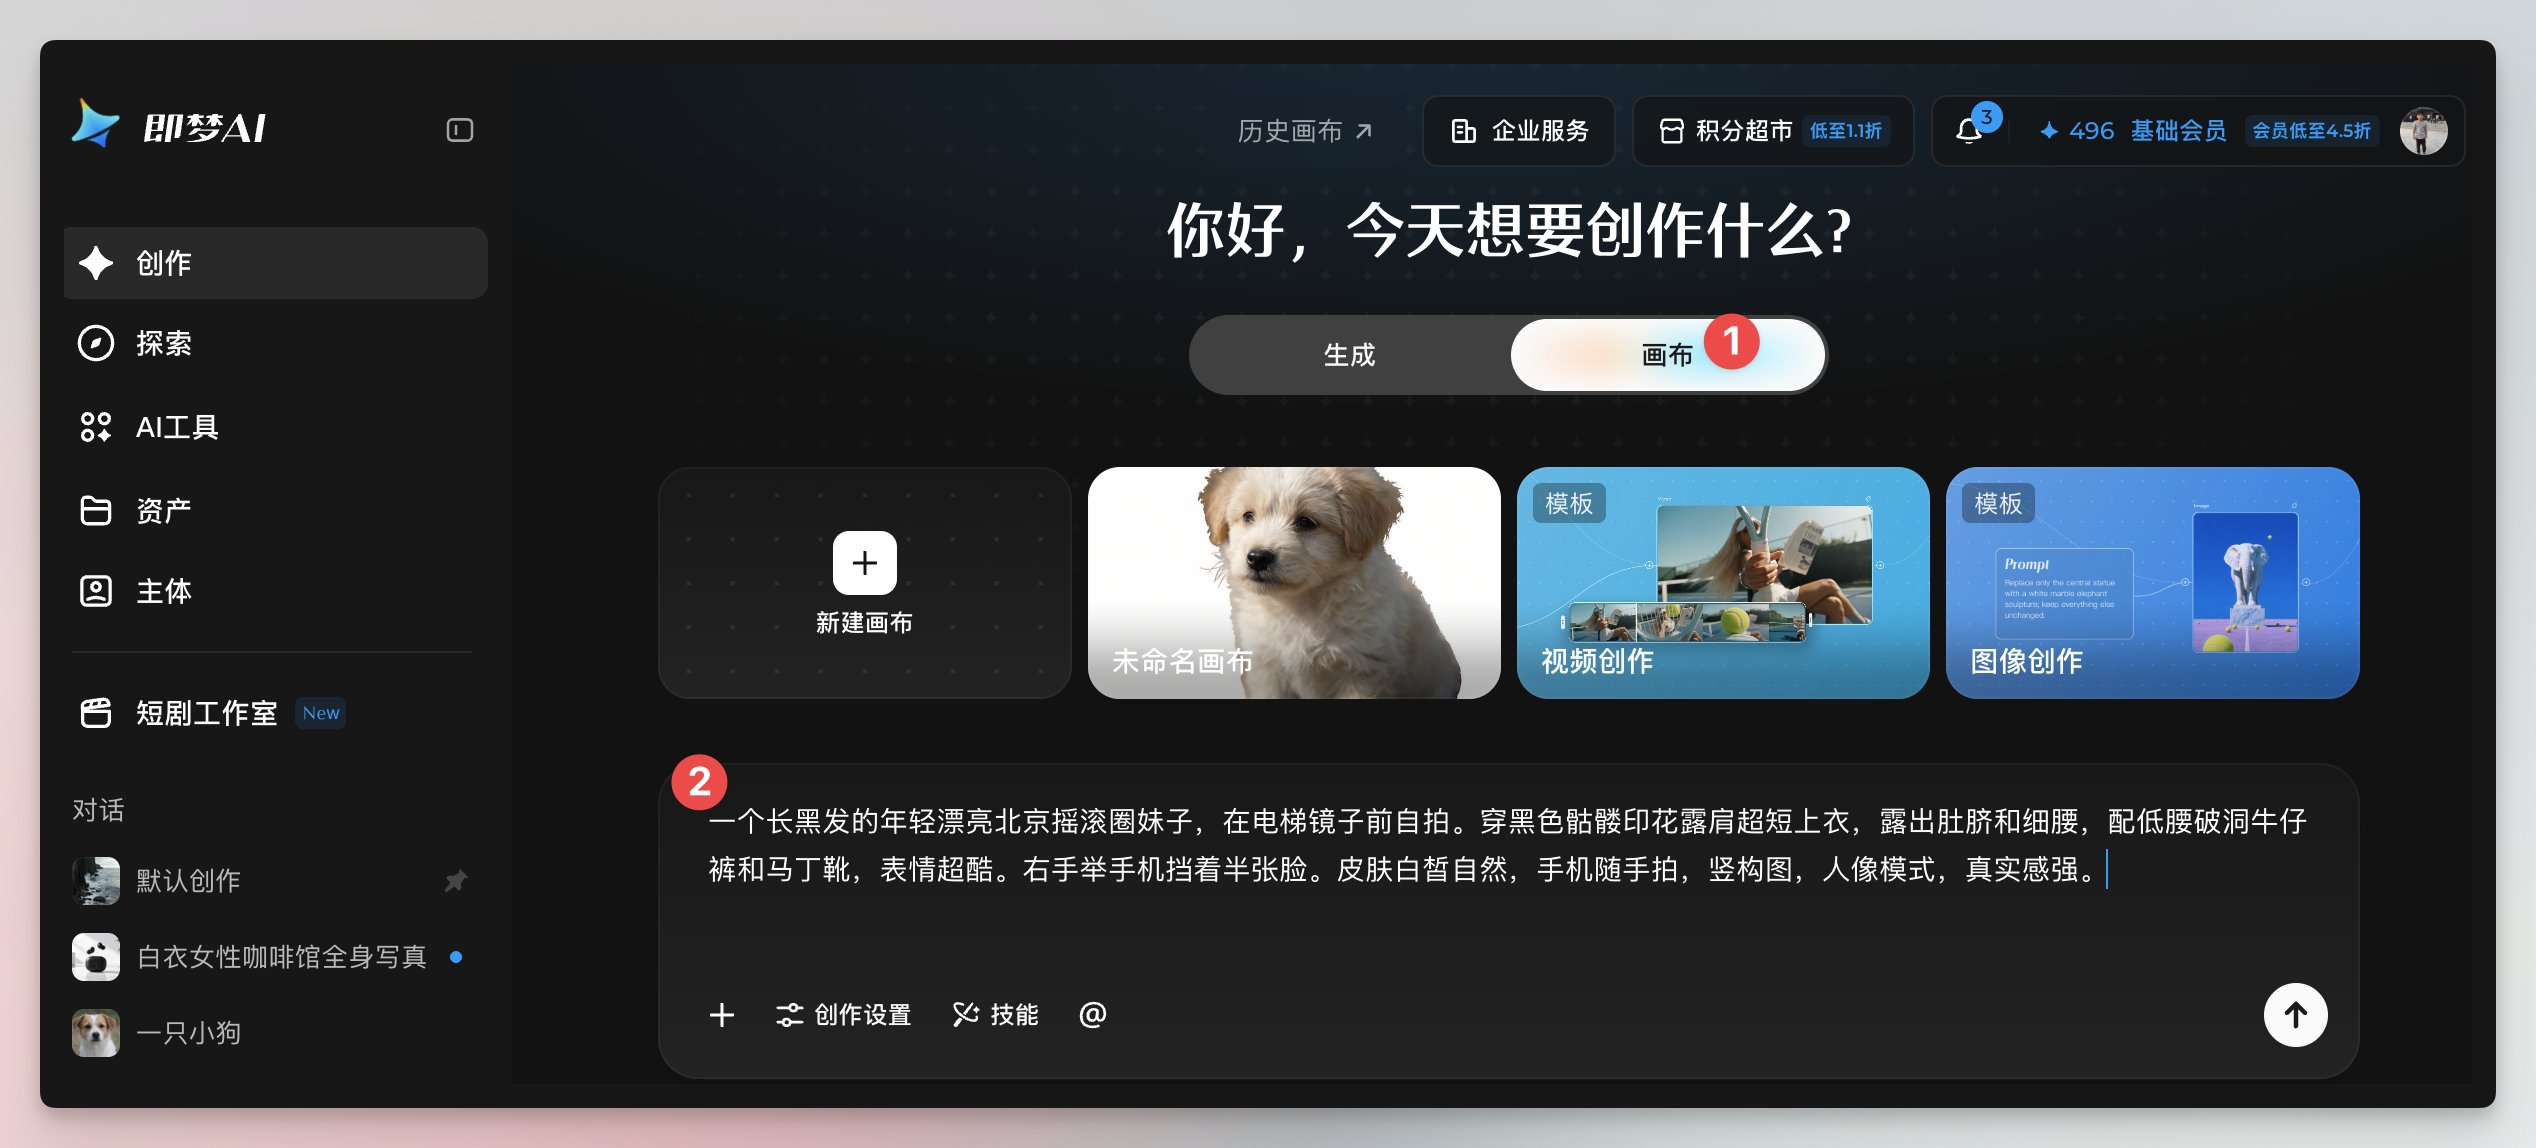
首先输入首轮生图提示词:
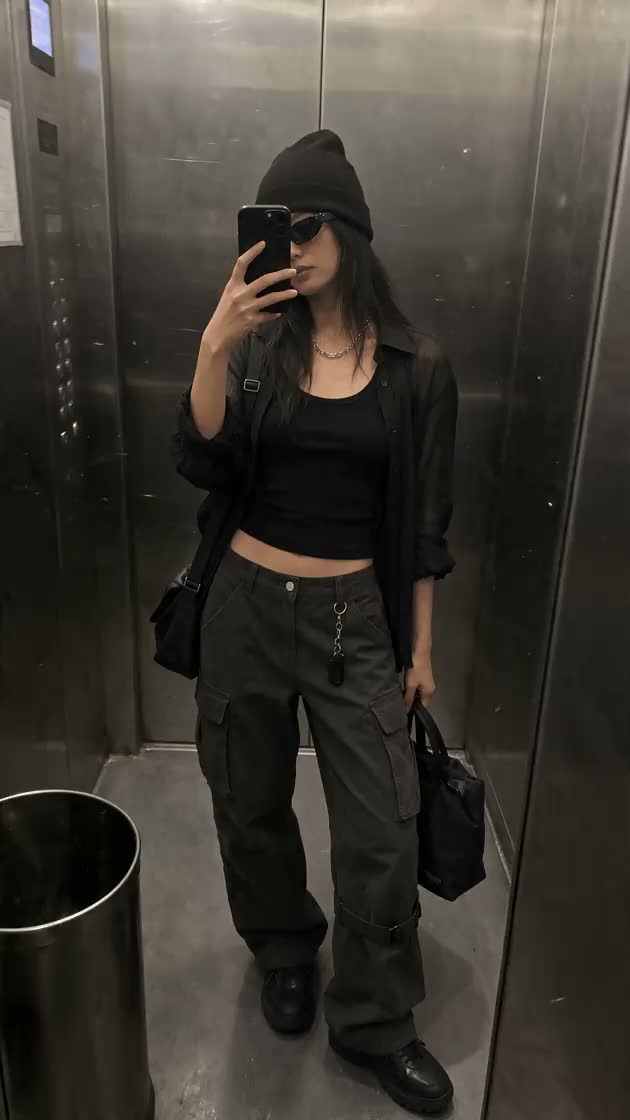
Prompt · 北京摇滚女孩电梯镜前自拍一个长黑发的年轻漂亮北京摇滚圈妹子,在电梯镜子前自拍。穿黑色骷髅印花露肩超短上衣,露出肚脐和细腰,配低腰破洞牛仔裤和马丁靴,表情超酷。右手举手机挡着半张脸。皮肤白皙自然,手机随手拍,竖构图,人像模式,真实感强。
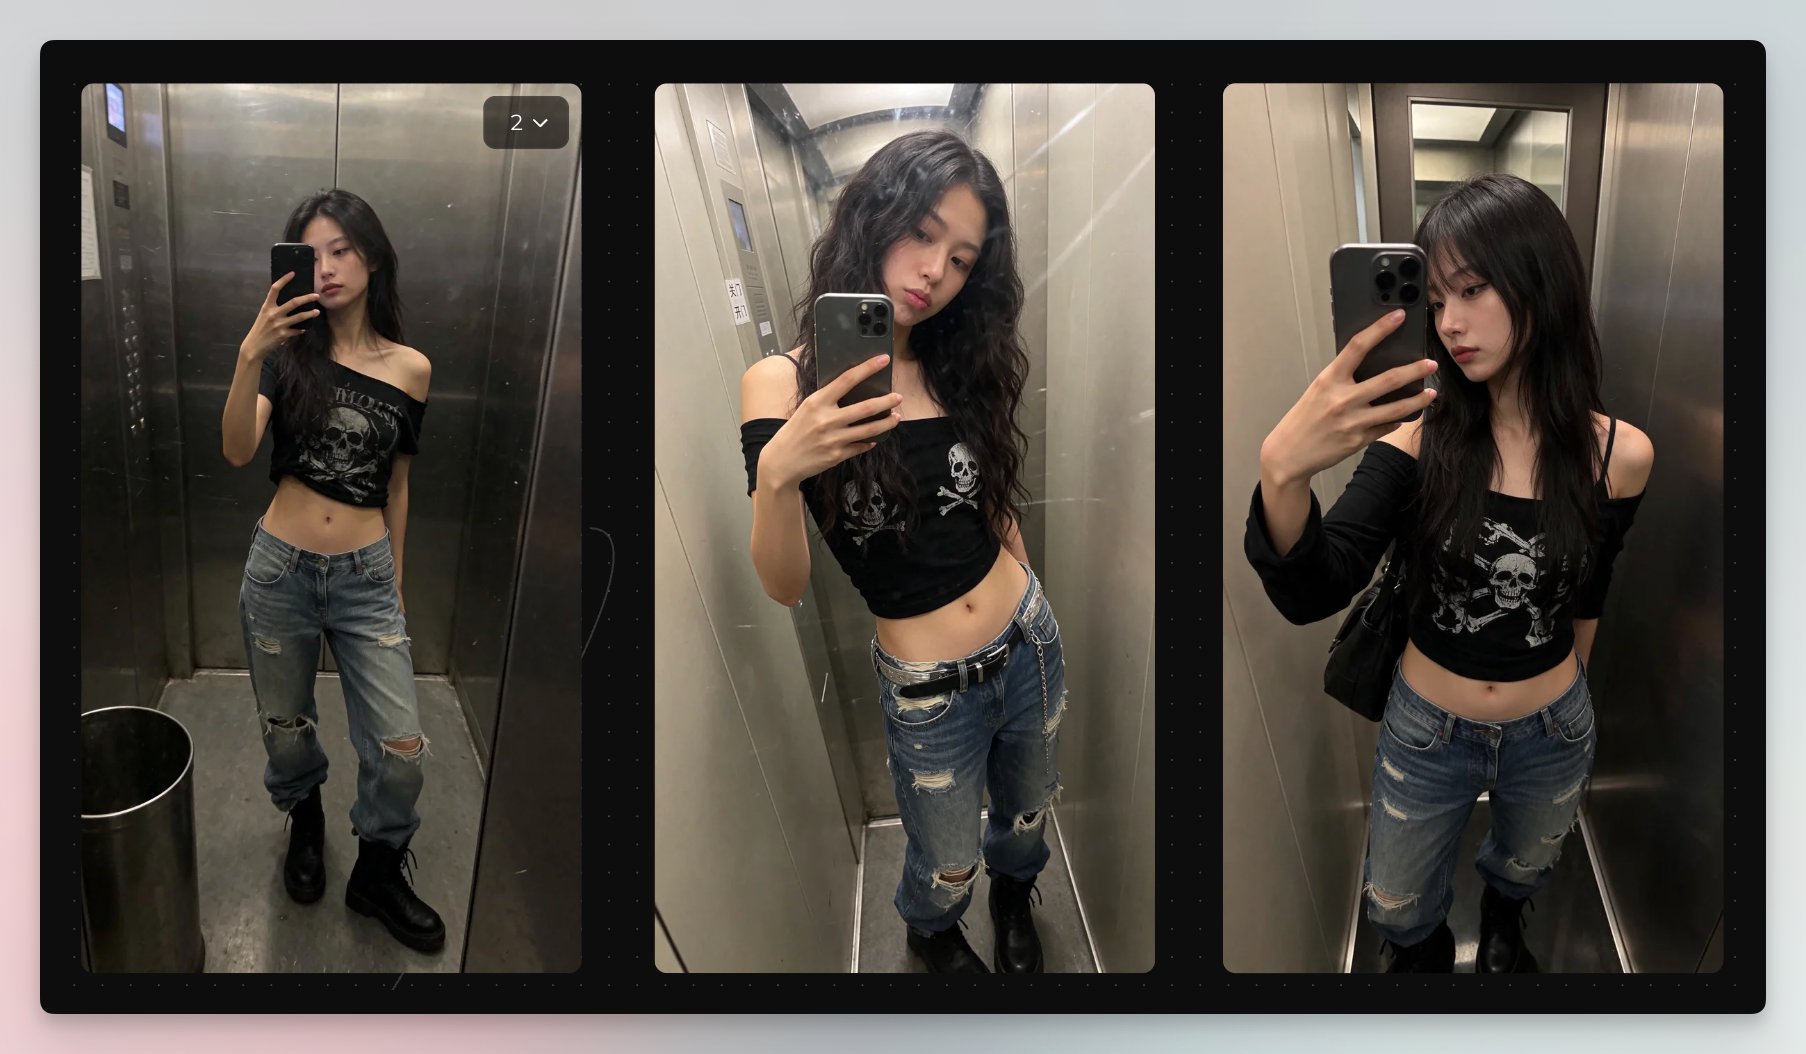
首轮生成的 4 张人像质量都不错,不过后两张构图空间偏窄。我选中第一张图继续追问,依次输入“形态不动,换一套衣服”和“主体不动,换一套差异大的衣服”。
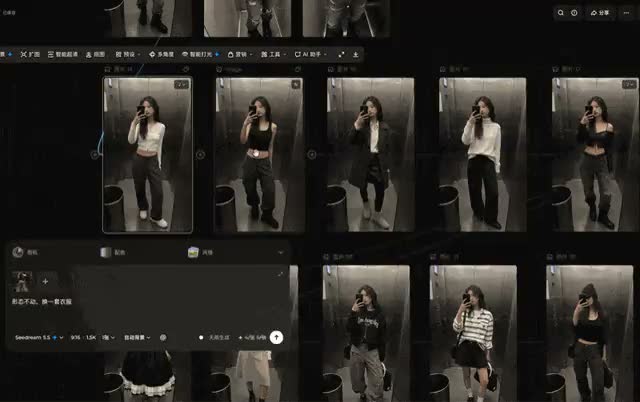
把多轮生成结果合成 GIF 动图后可以看到,除了个别款式的服装边缘有轻微位移,人脸五官和电梯背景几乎固定不动。
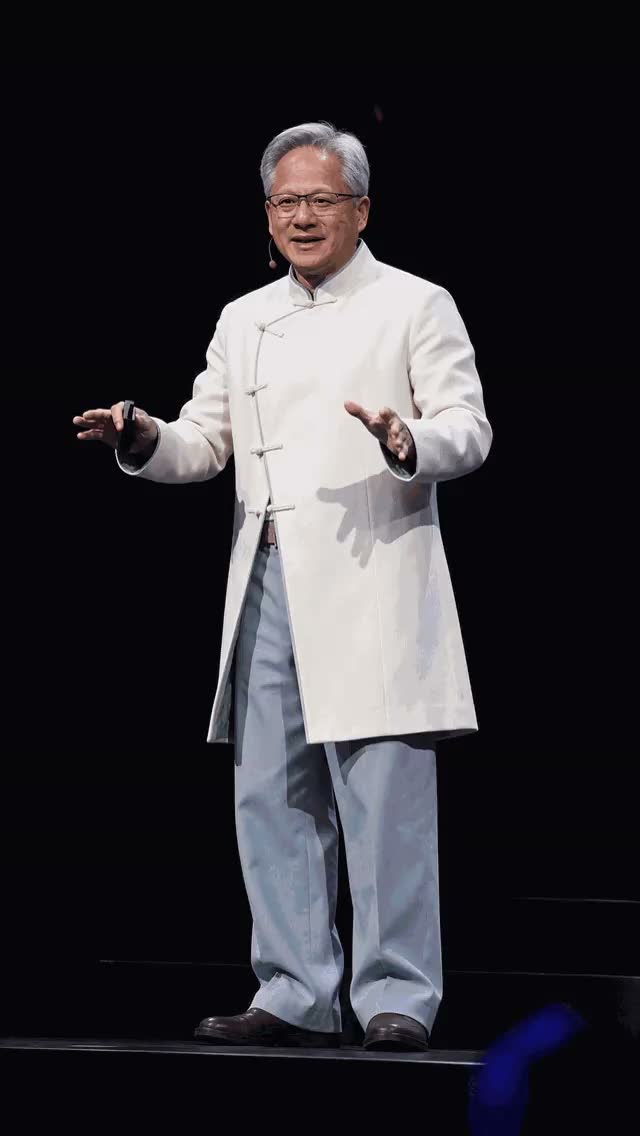
接着我又用英伟达创始人黄仁勋(老黄)的照片做测试,看看脱下标志性黑皮衣、换上不同款式服装后的连续一致性表现。
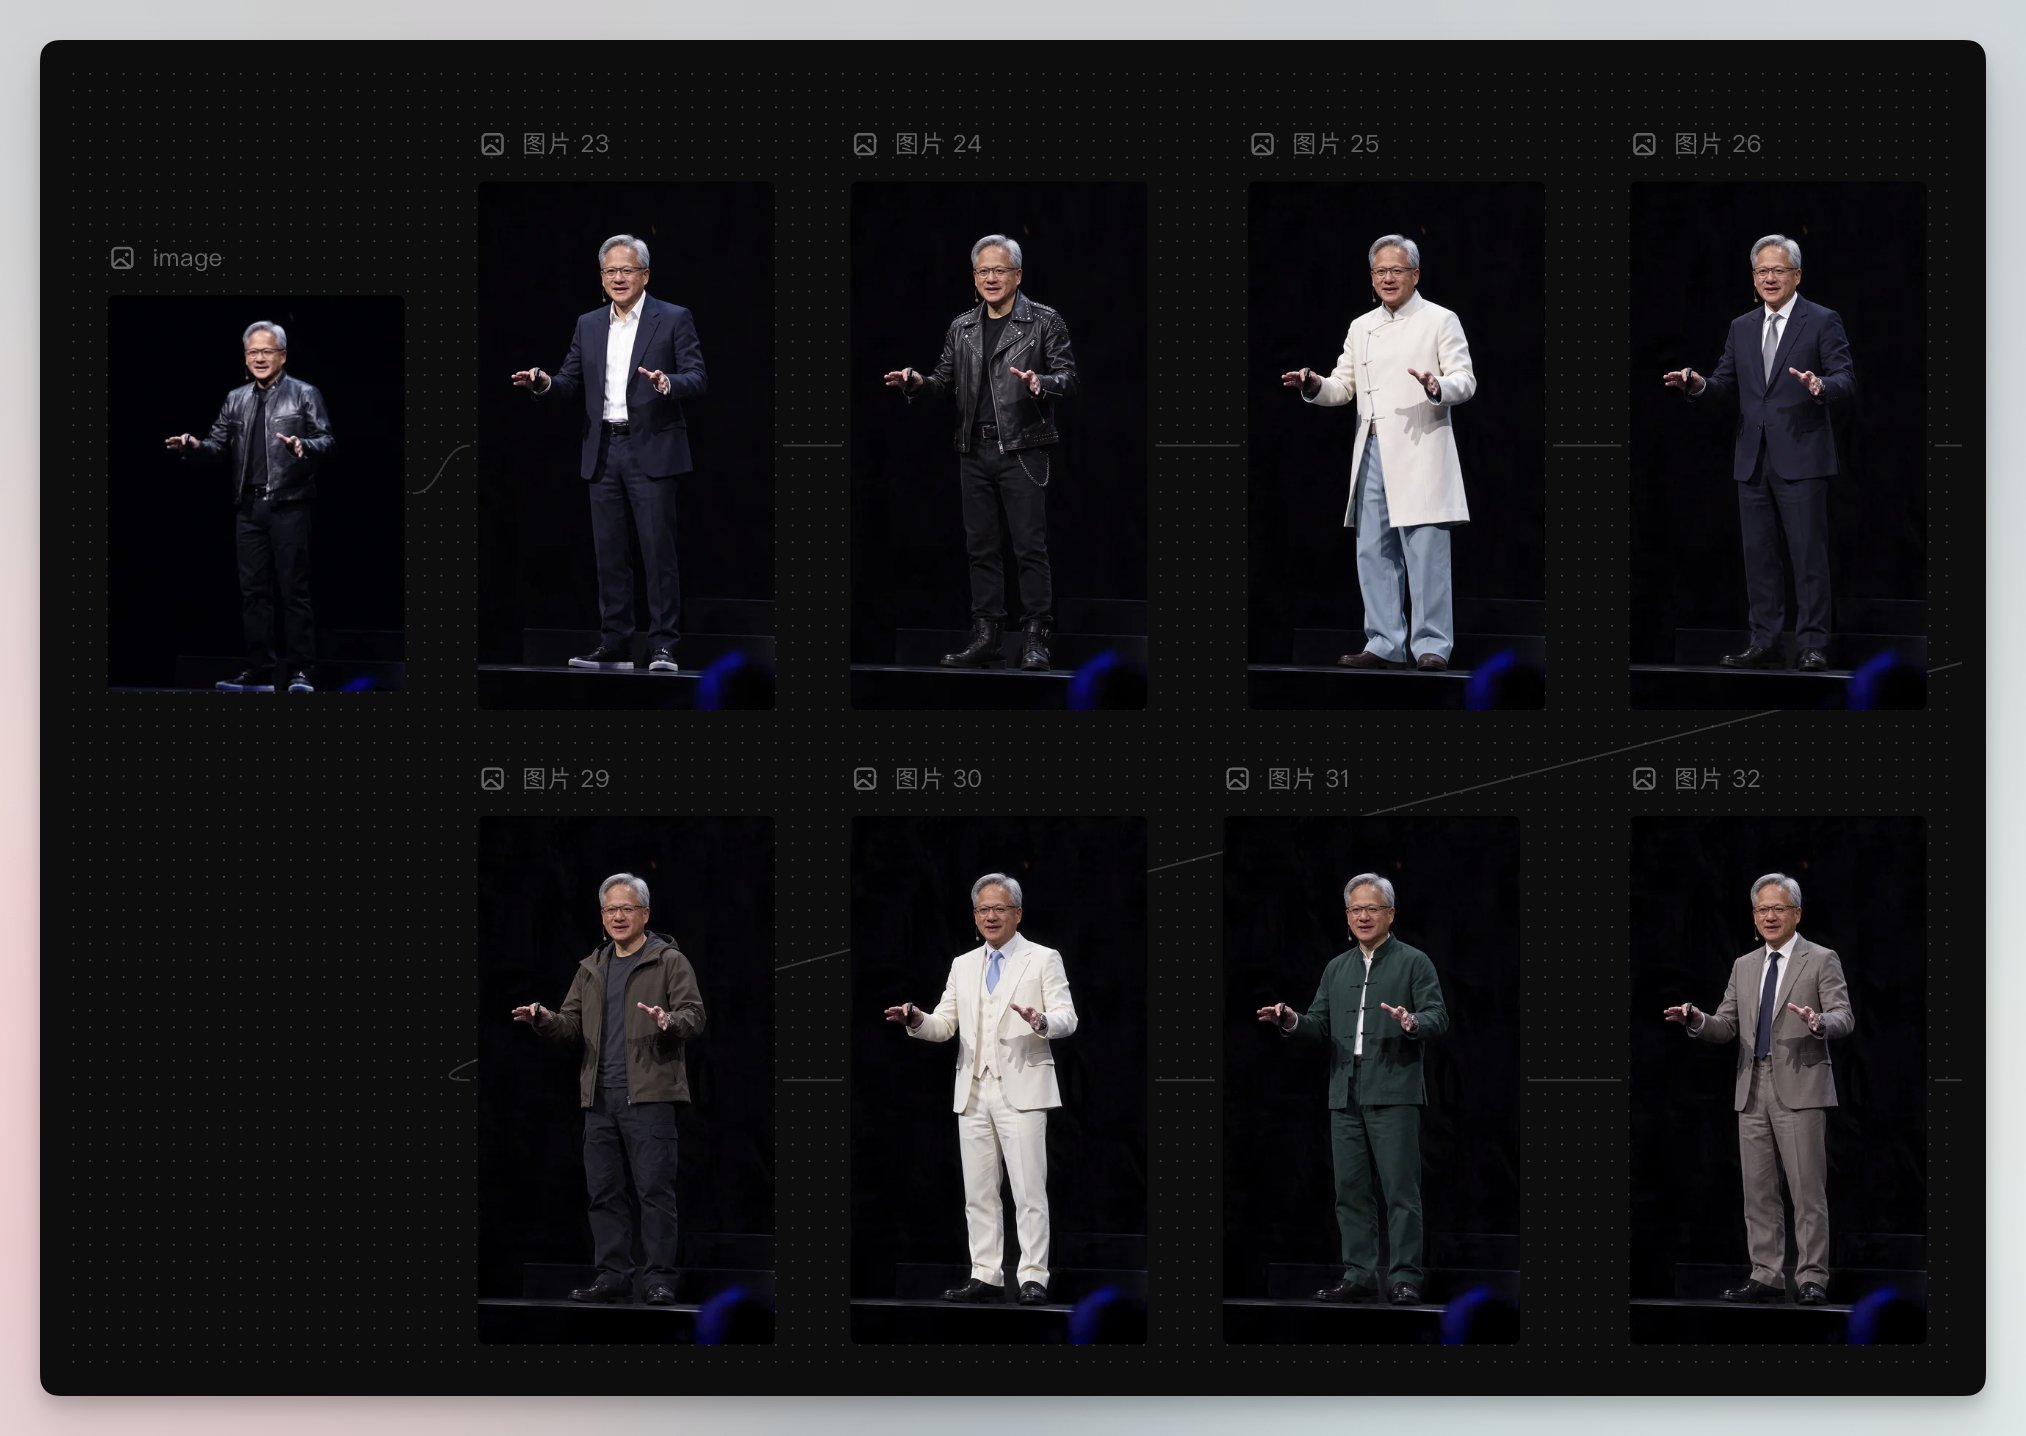
多轮换装合成动图的效果如下:
过去两年,主流生图模型大多集中在提升单图质感、构图审美与 4K 分辨率,但局部可控修改与多轮编辑一致性始终不理想。Seedream 5.5 重点补齐了这一短板,多轮编辑一致性达到了当前公开模型的 SOTA 水平。
SOTA 是 State of the Art 的缩写,在人工智能、机器学习与计算机视觉领域指代某项任务上“当前表现最好的技术水平”。
这项能力可直接用于电商换装、AI 短剧分镜、影视概念设计和商业广告改稿,在锁死背景与人物特征的前提下单独替换指定元素。
二、真实性提升
除了连续编辑一致性,单图真实感同样关键,因为静态生图直接决定了图生视频的画面上限。目前短剧平台上的 AI 作品仍以漫剧居多,尝试真人质感的只有《持械入宋》和《归墟》等少数剧集。受限于此前模型的物理光影表现,即便口碑较好的《持械入宋》,部分角色皮肤仍有塑料感,主要靠剧情与台词弥补。
提升生图的日常真实感,能直接降低 AI 短剧与广告制片的废片率。近期北京和天津刚下过雪,我先用几组日常雪景测试了它的实拍还原度:
Prompt · 老北京胡同雪景手机随手拍,超真实,北京一个胡同,下雪了
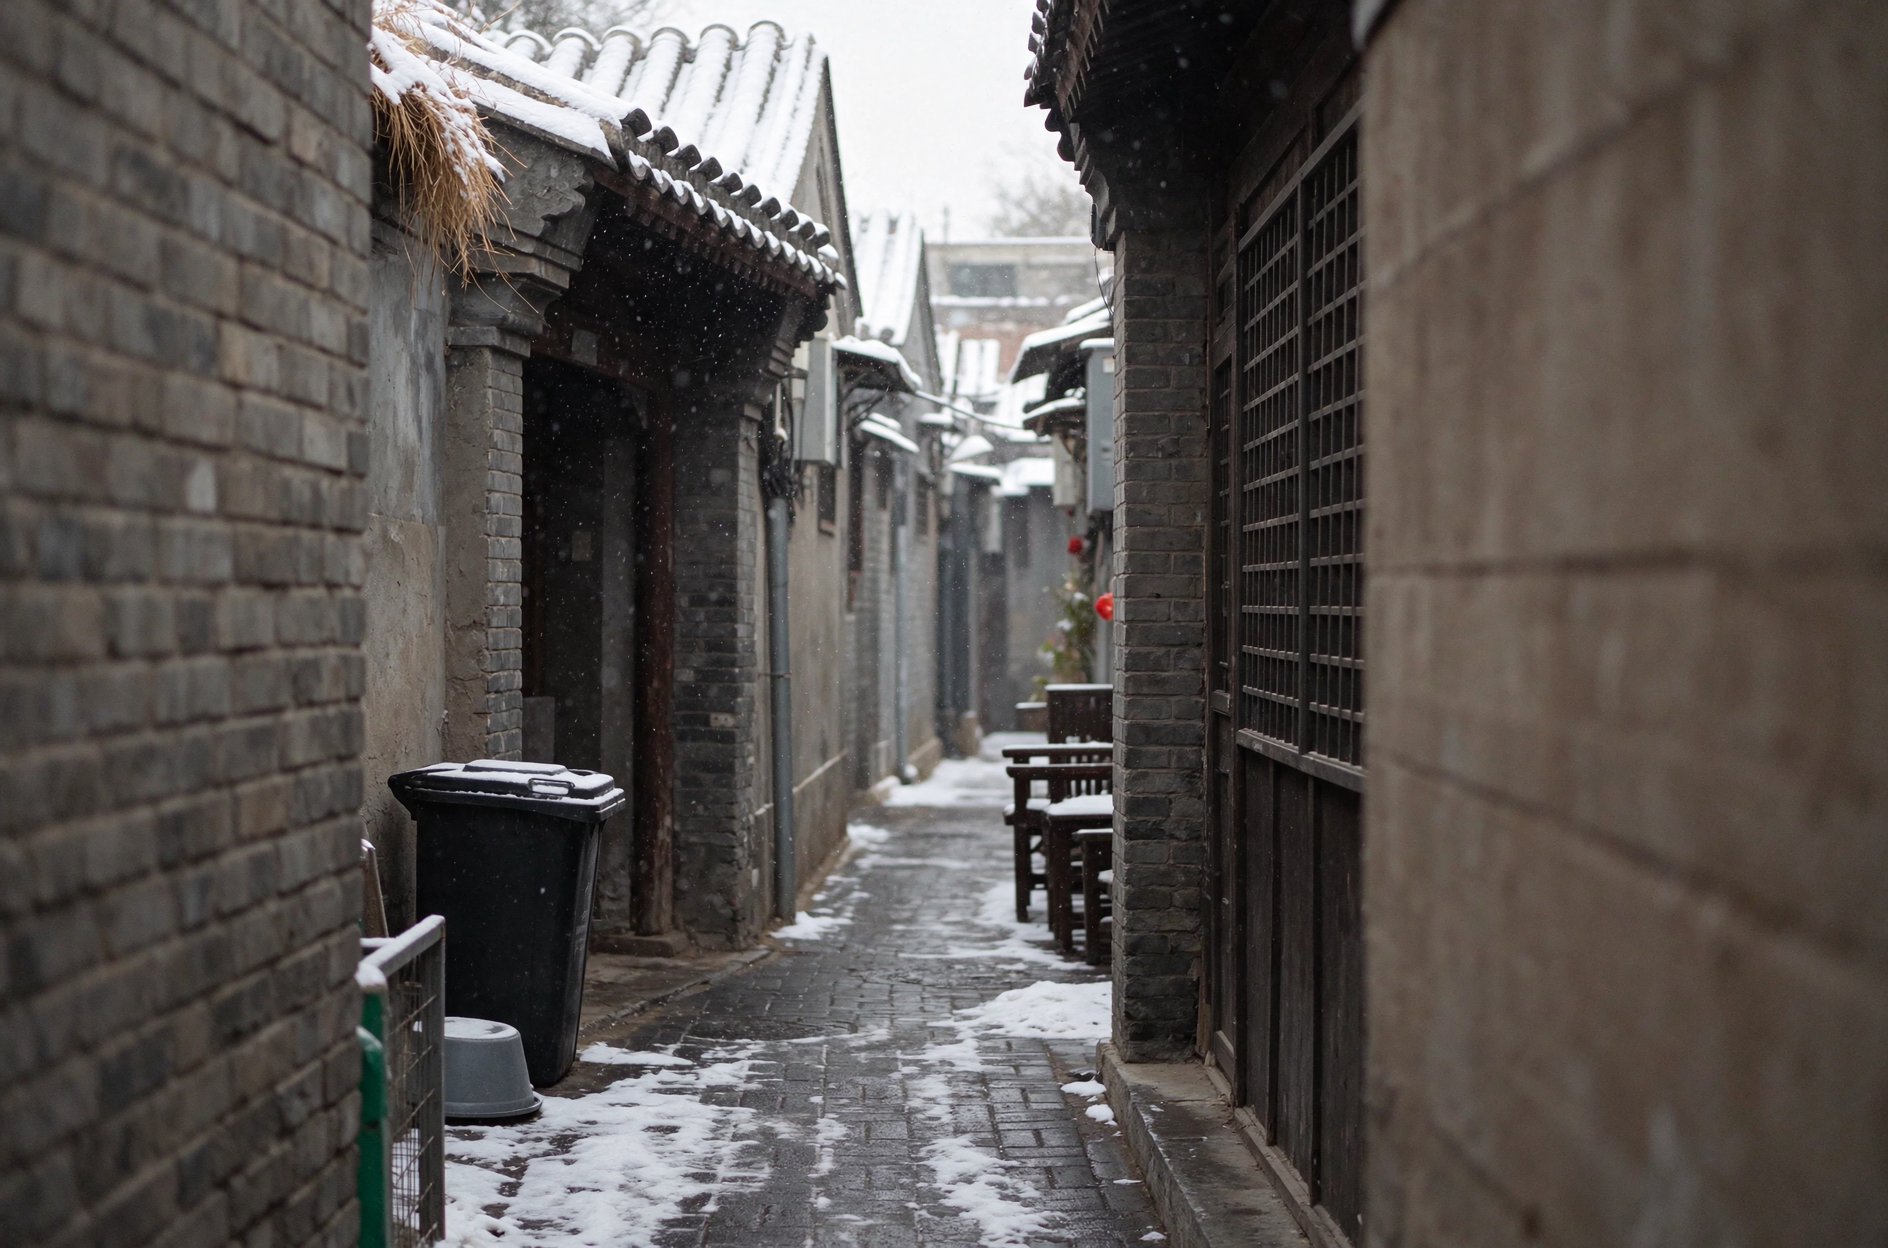
画面还原了空中飘落的细碎雪花,胡同里常见的绿色塑料垃圾桶、老旧墙体外加装的管道和门前板凳都符合北京日常街景特征。
接着测试第二个提示词:手机随手拍,北京五环外,环卫工人在扫雪,超真实
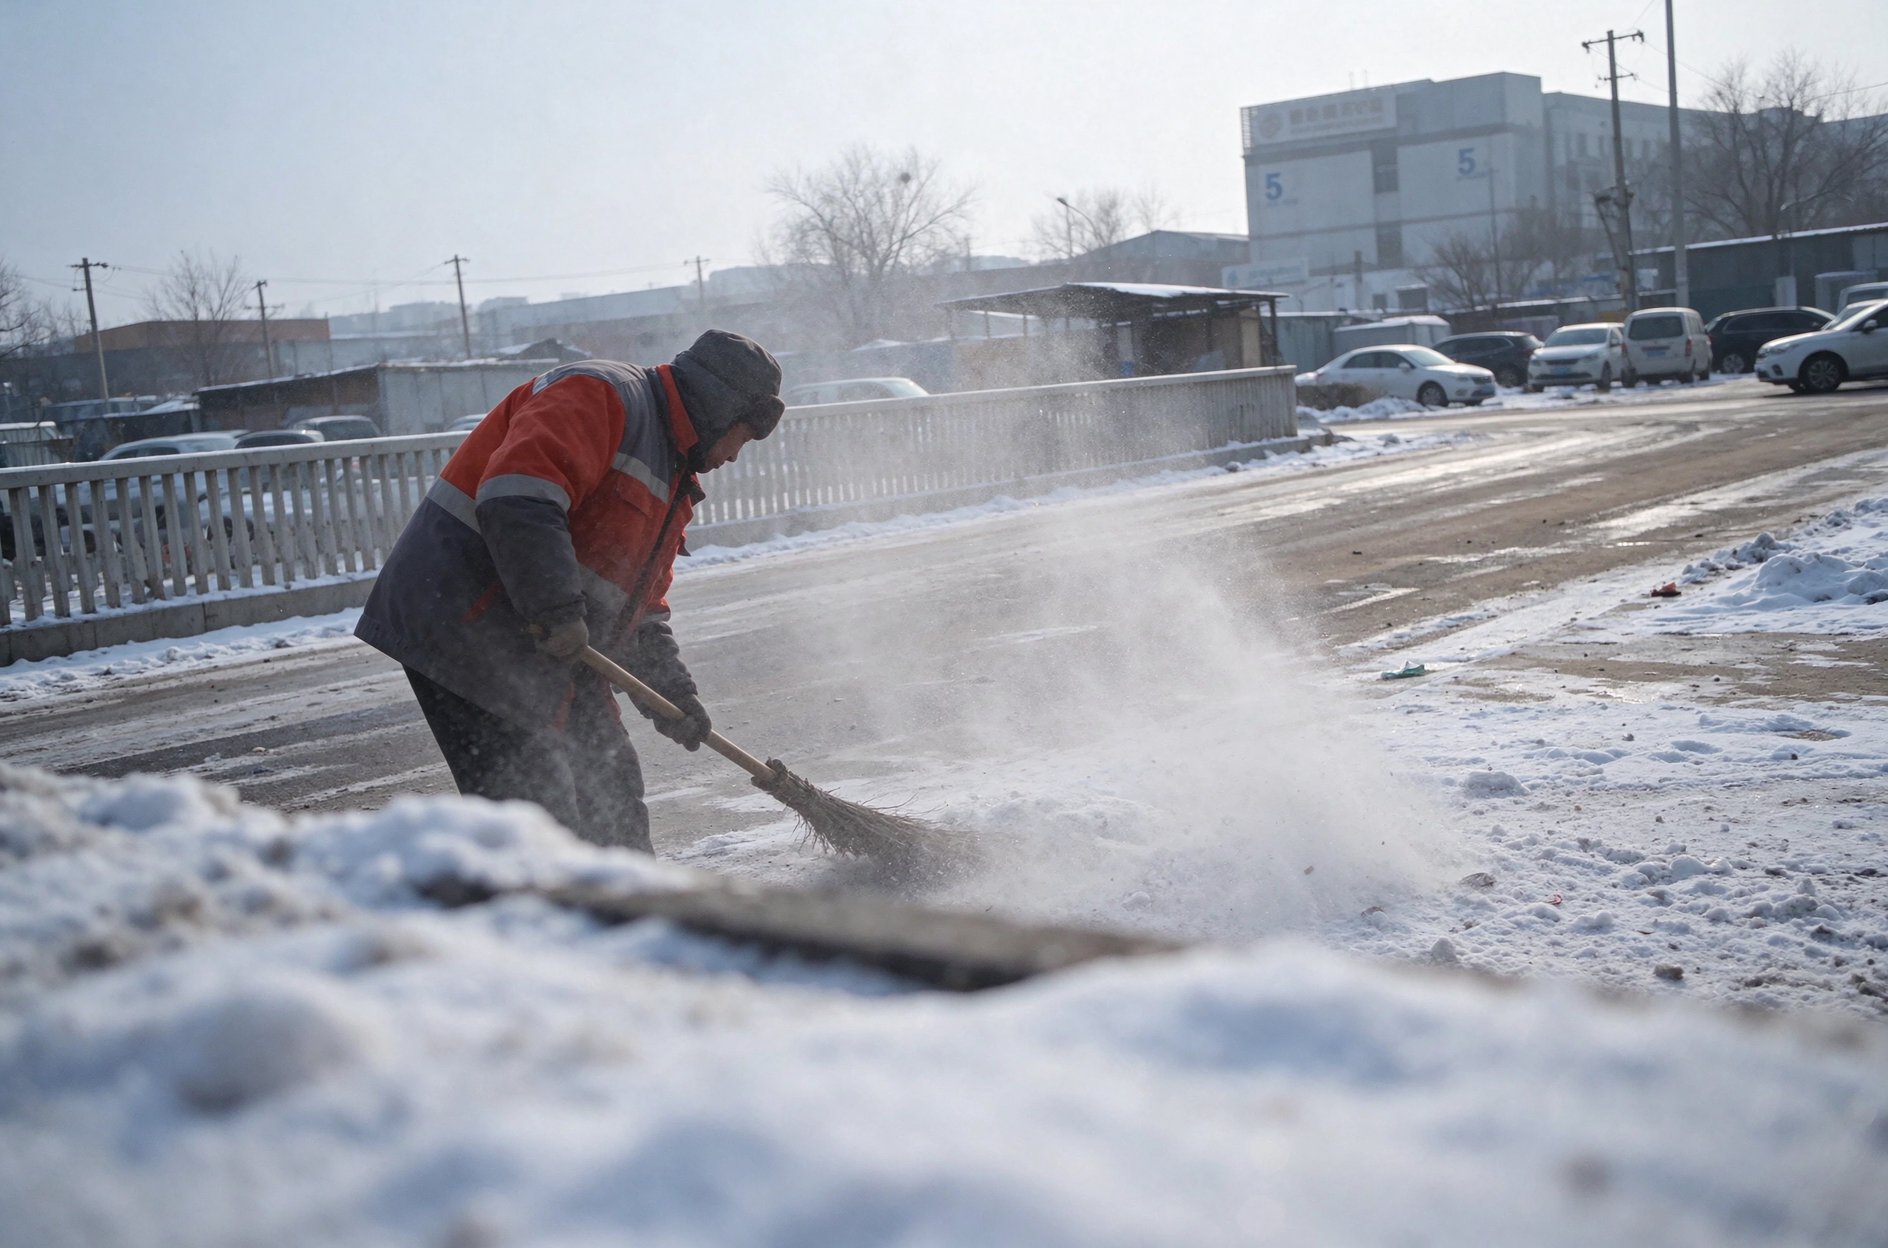
远处失焦模糊的招牌、车轮碾压后的雪泥路面以及扫帚带起的雪雾,整体观感接近本地民生新闻的现场抓拍。随后我又测试了一张天津海河边的雪景:
Prompt · 天津海河边雪景手机随手拍,超真实,天津海河边,下雪了
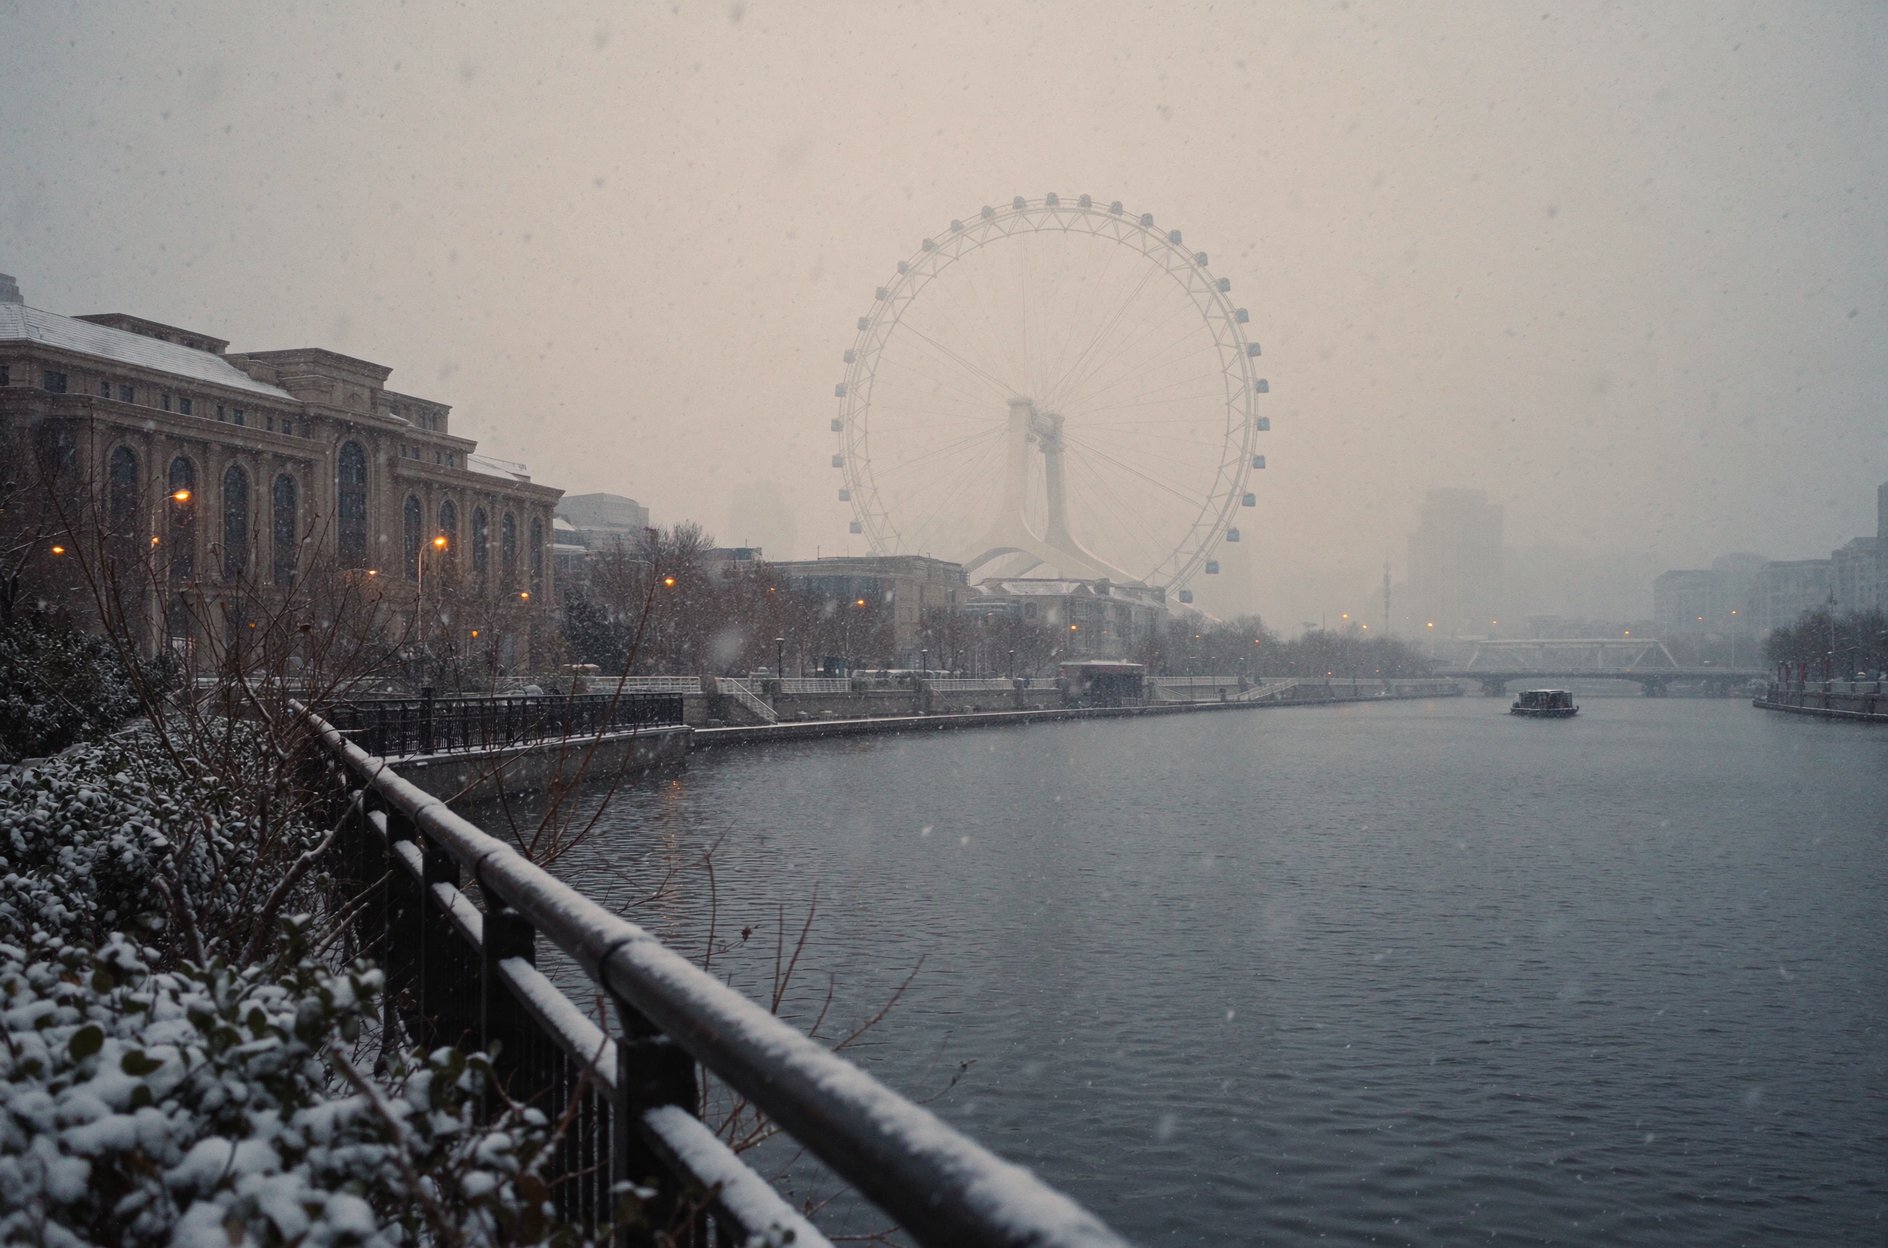
提示词里只写了“天津海河边”,Seedream 5.5 却主动在背景中画出了地标建筑“天津之眼”。为了核对细节是否胡编,我从维基百科找来实拍照片做对比,发现摩天轮与跨河桥体的钢结构造型高度吻合。
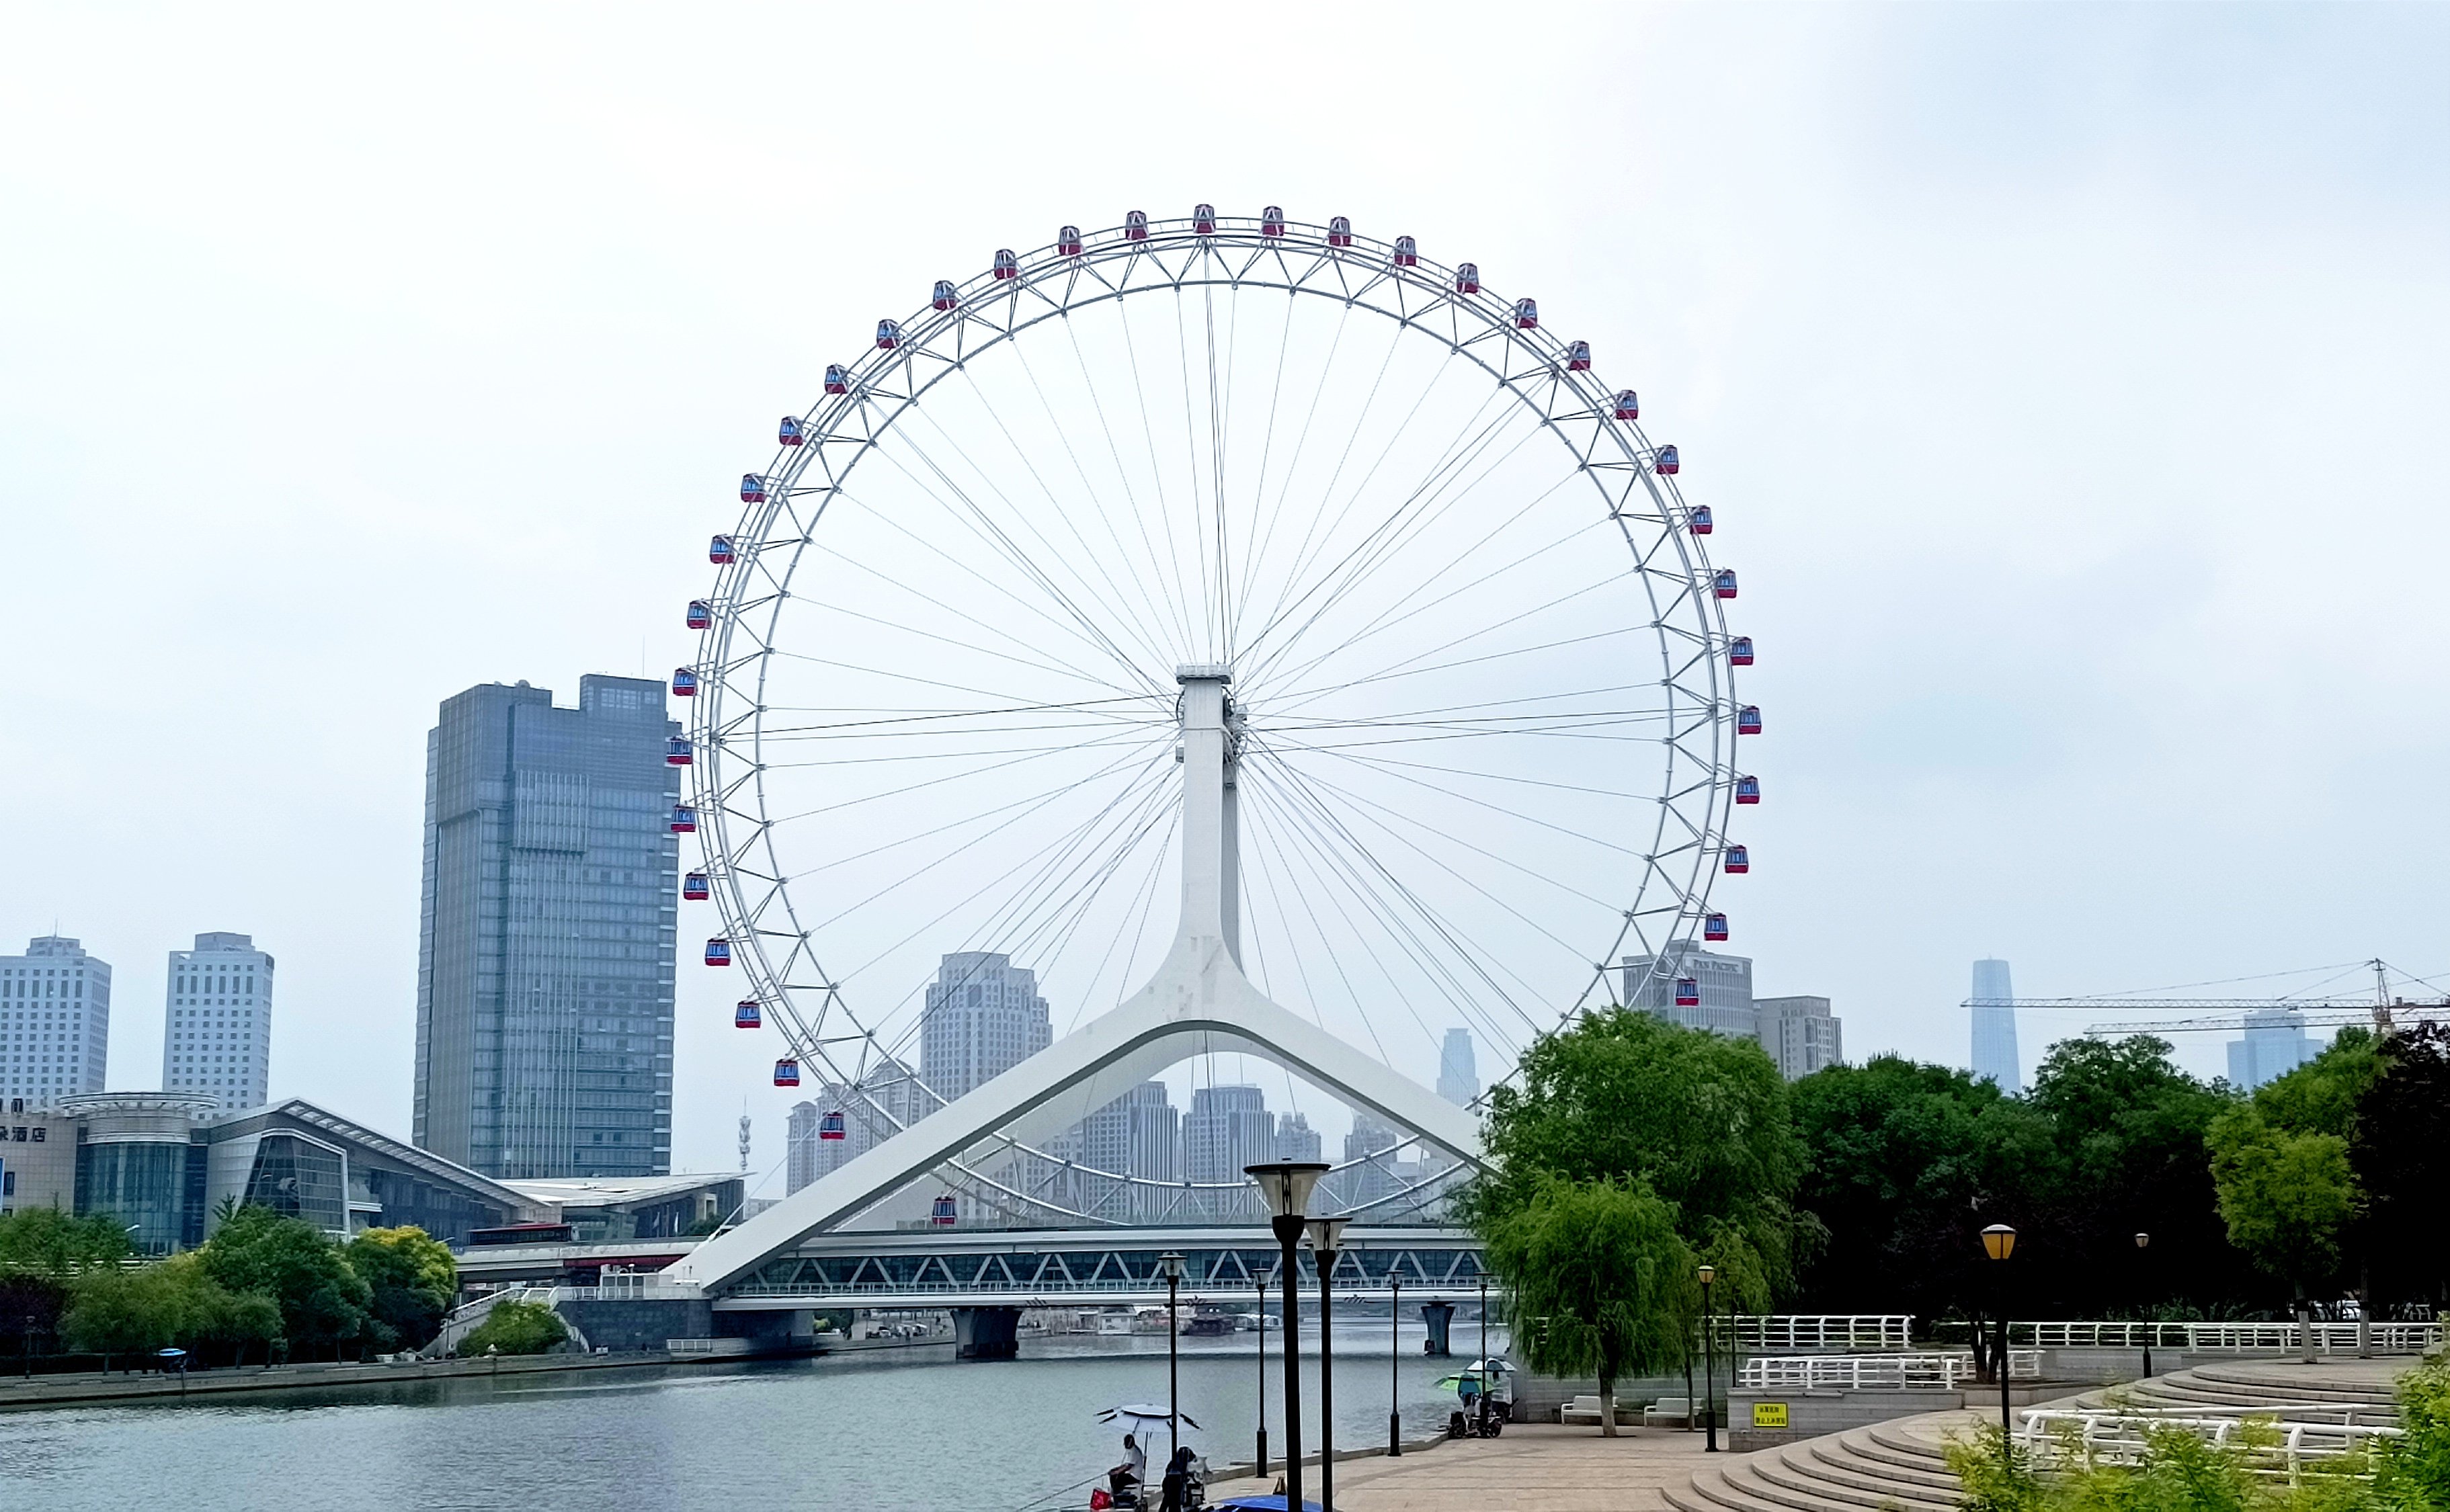
小互推测 Seedream 5.5 升级了基座模型,这一实测印证了他的判断。如果模型缺乏扎实的世界知识,仅凭“天津海河”四个字很难还原永乐桥摩天轮结构。目前 GPT 和 Gemini 等主流生图系统,都会在渲染前先做提示词改写(Prompt Engineering),理解用户真实意图并补充场景细节。这也从侧面反映出字节豆包基座模型的世界知识储备有所提升。
三、透明图编辑
近期我开发了一款开源录屏软件 Capwise,目标是替代年费 108 美元的 Screen Studio。项目开源后收到不少反馈,我打算重新打磨一下应用图标。旧版 Logo 是让 Codex 基于 Lucide 图标微调生成的,结果评论区有读者反映它和另一款软件撞了图标。
于是我上传原版 Logo 作为参考图,输入提示词:为我们录屏软件设计 10 种不同风格的 icon
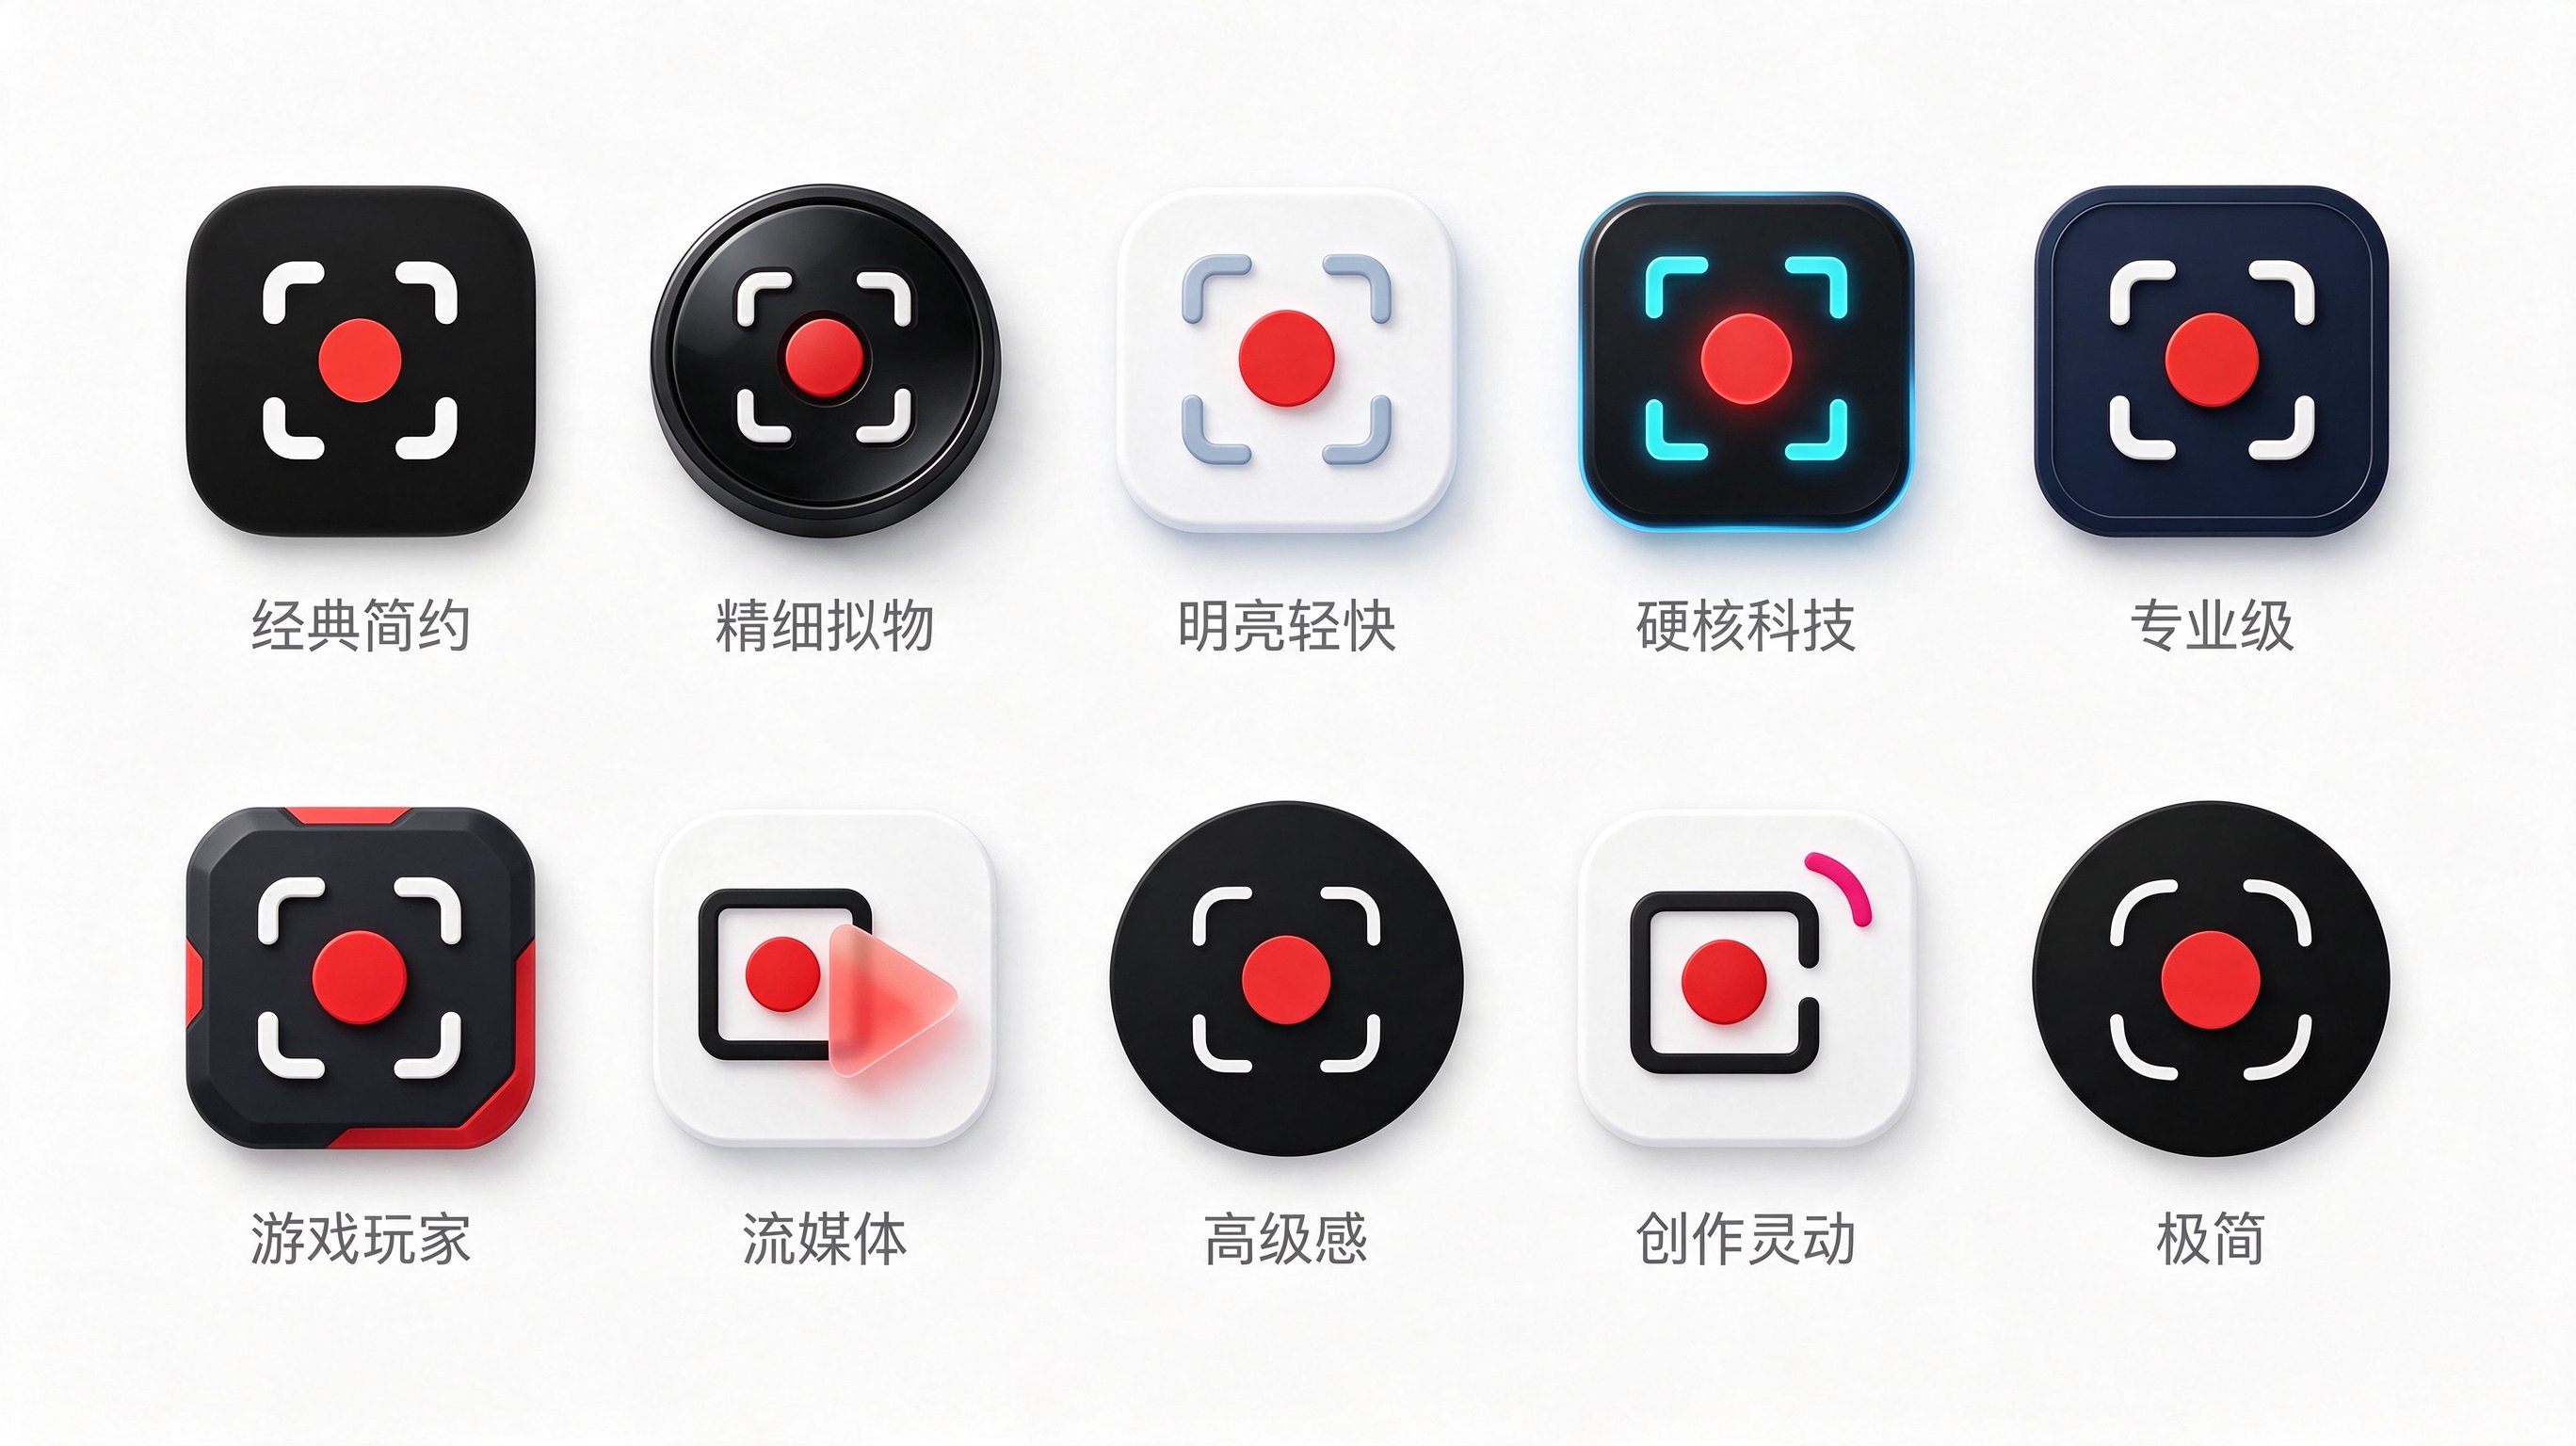
参考原图生成的方案里有几个可用,为了拓宽思路,我去掉参考图又直接生成了一组 10 合 1 图标:
Prompt · Capwise 10 种风格 Icon 方案为一款名叫 Capwise 的录屏软件设计 10 种不同风格的 icon,扁平风格,顶级水平
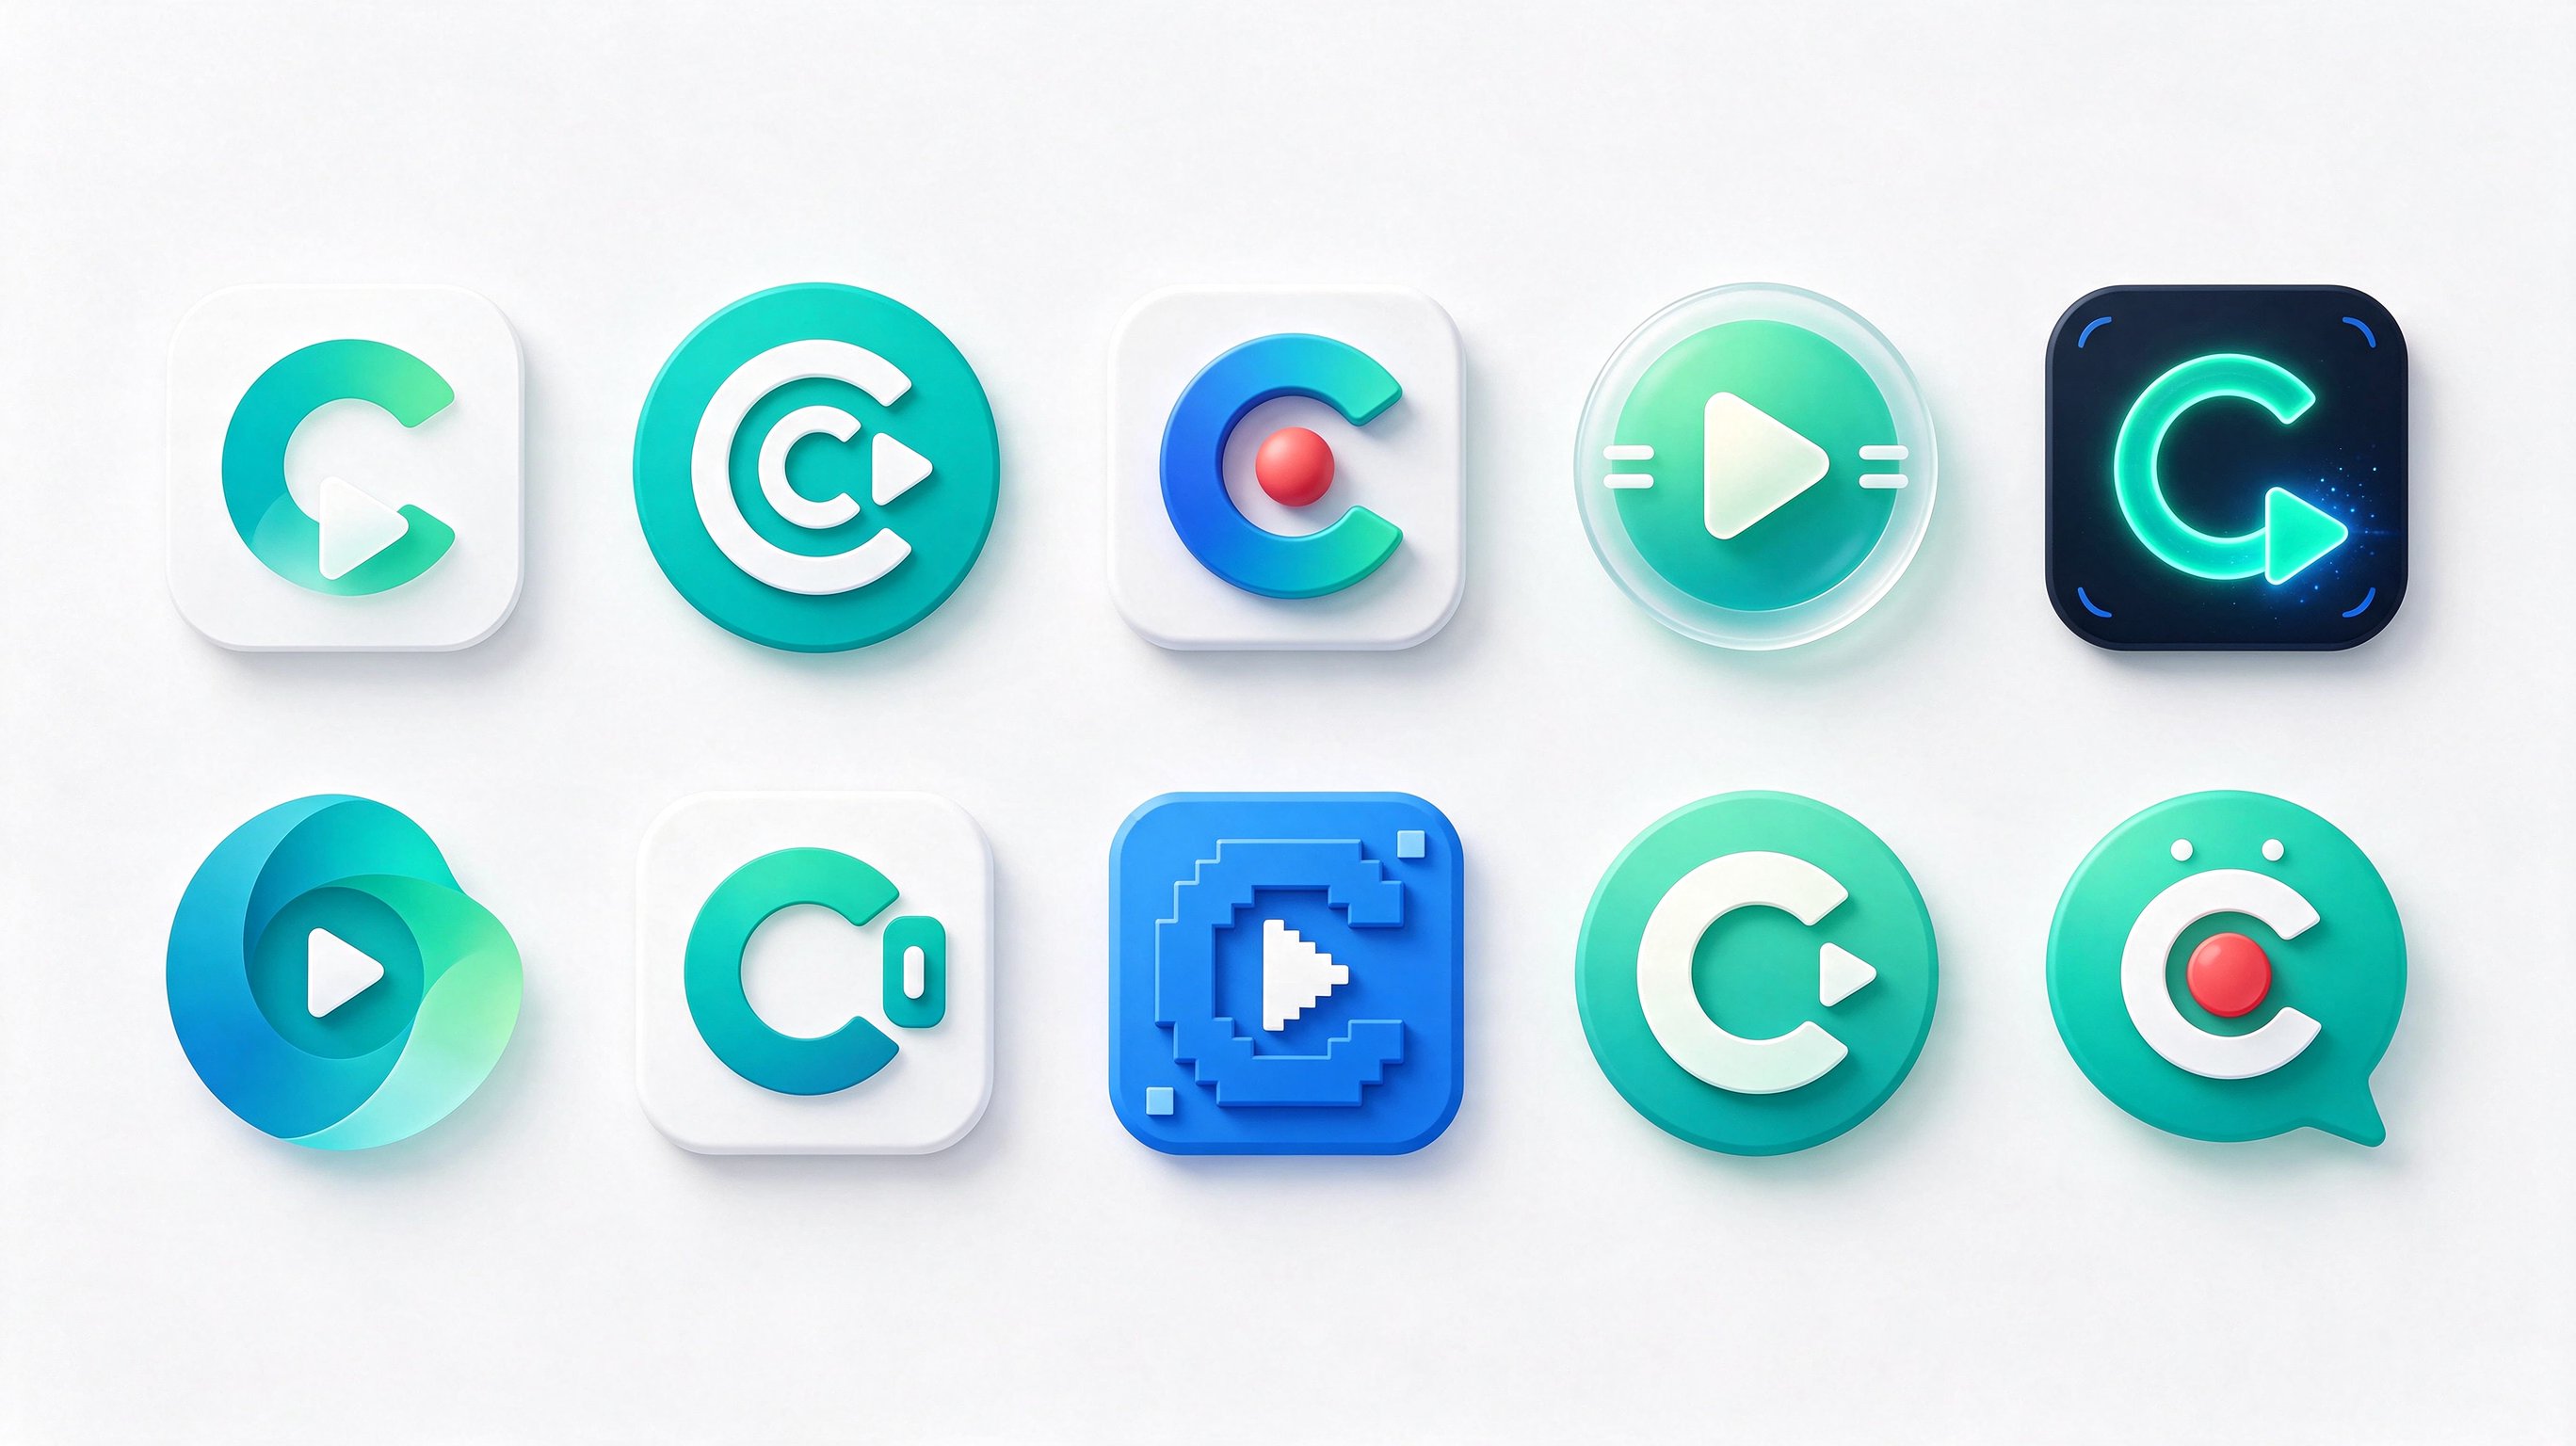
其中的像素风和半透明毛玻璃图标辨识度都不错。在即梦中调用 Seedream 5.5 时有两个实用功能:一是生成前勾选“透明背景”直出透明底图;二是对多图标合集点击“图层分离”,系统会把每个 Icon 自动拆成独立的透明图层,操作演示如下:
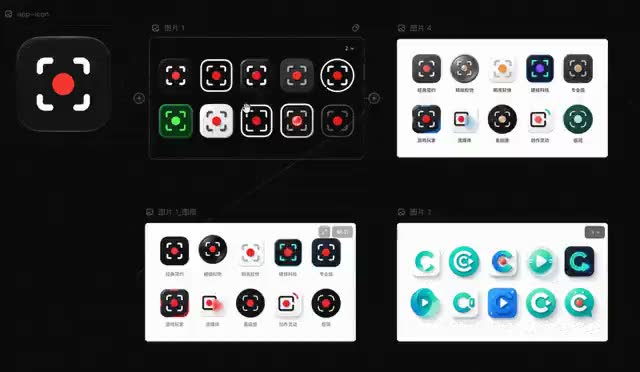
如果拆分后的单个图标分辨率偏低,再用画布自带的“扩图”功能放大即可。这套流程适合 UI 图标与贴纸设计:先单图批量生成 10 个候选方案做视觉比对,挑中方案后一键拆出透明图层,再导入 Photoshop 细调定稿。
四、参考图生成
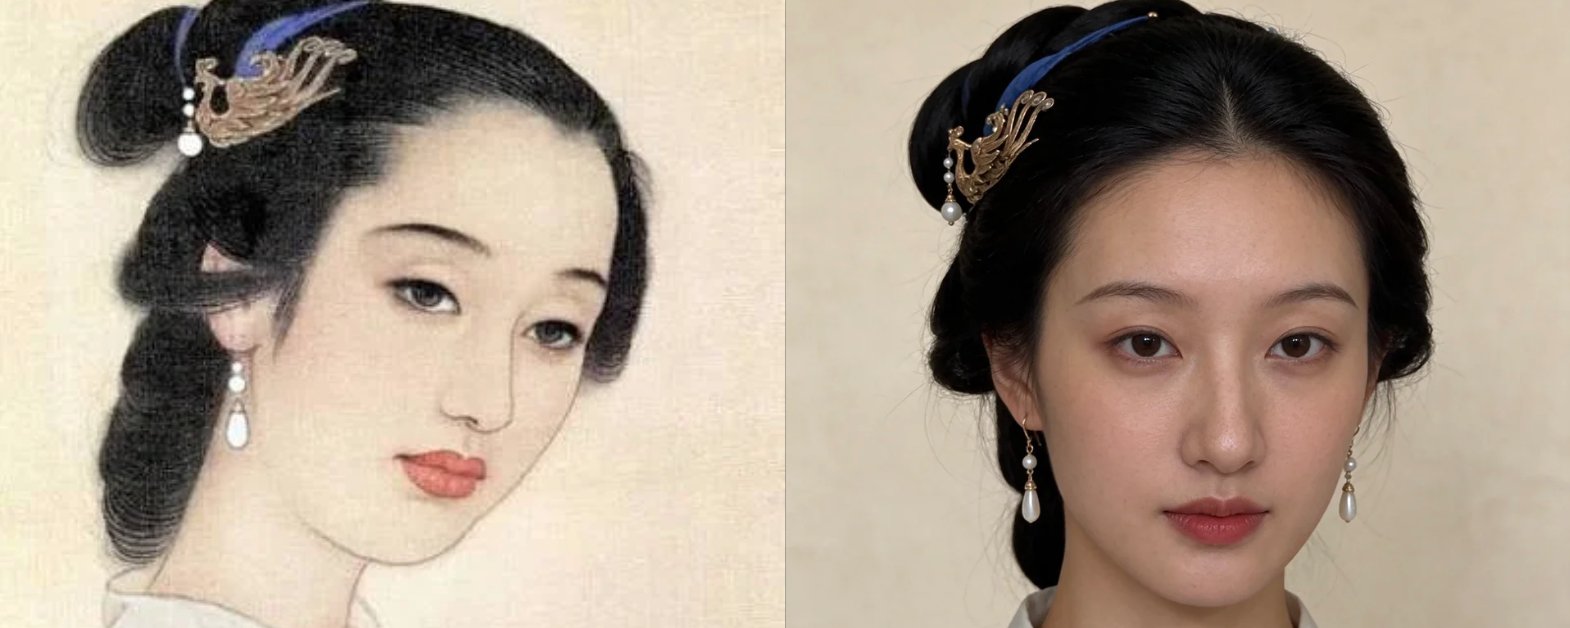
最近我在追 AI 短剧《持械入宋》,第四季 50 集之后的制作水准提升明显,剧中角色形象很有辨识度。例如剧中的“李清棠”一角,就是参考宋代词人李清照的传世画像加工设计的。我先找来了历史课本里常见的李清照画像原图:
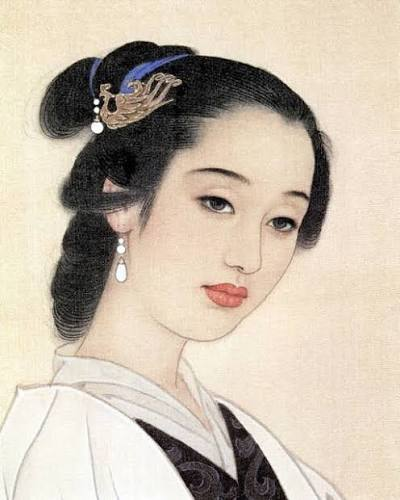
把这张古画上传为参考图,输入提示词:生成正面真人图
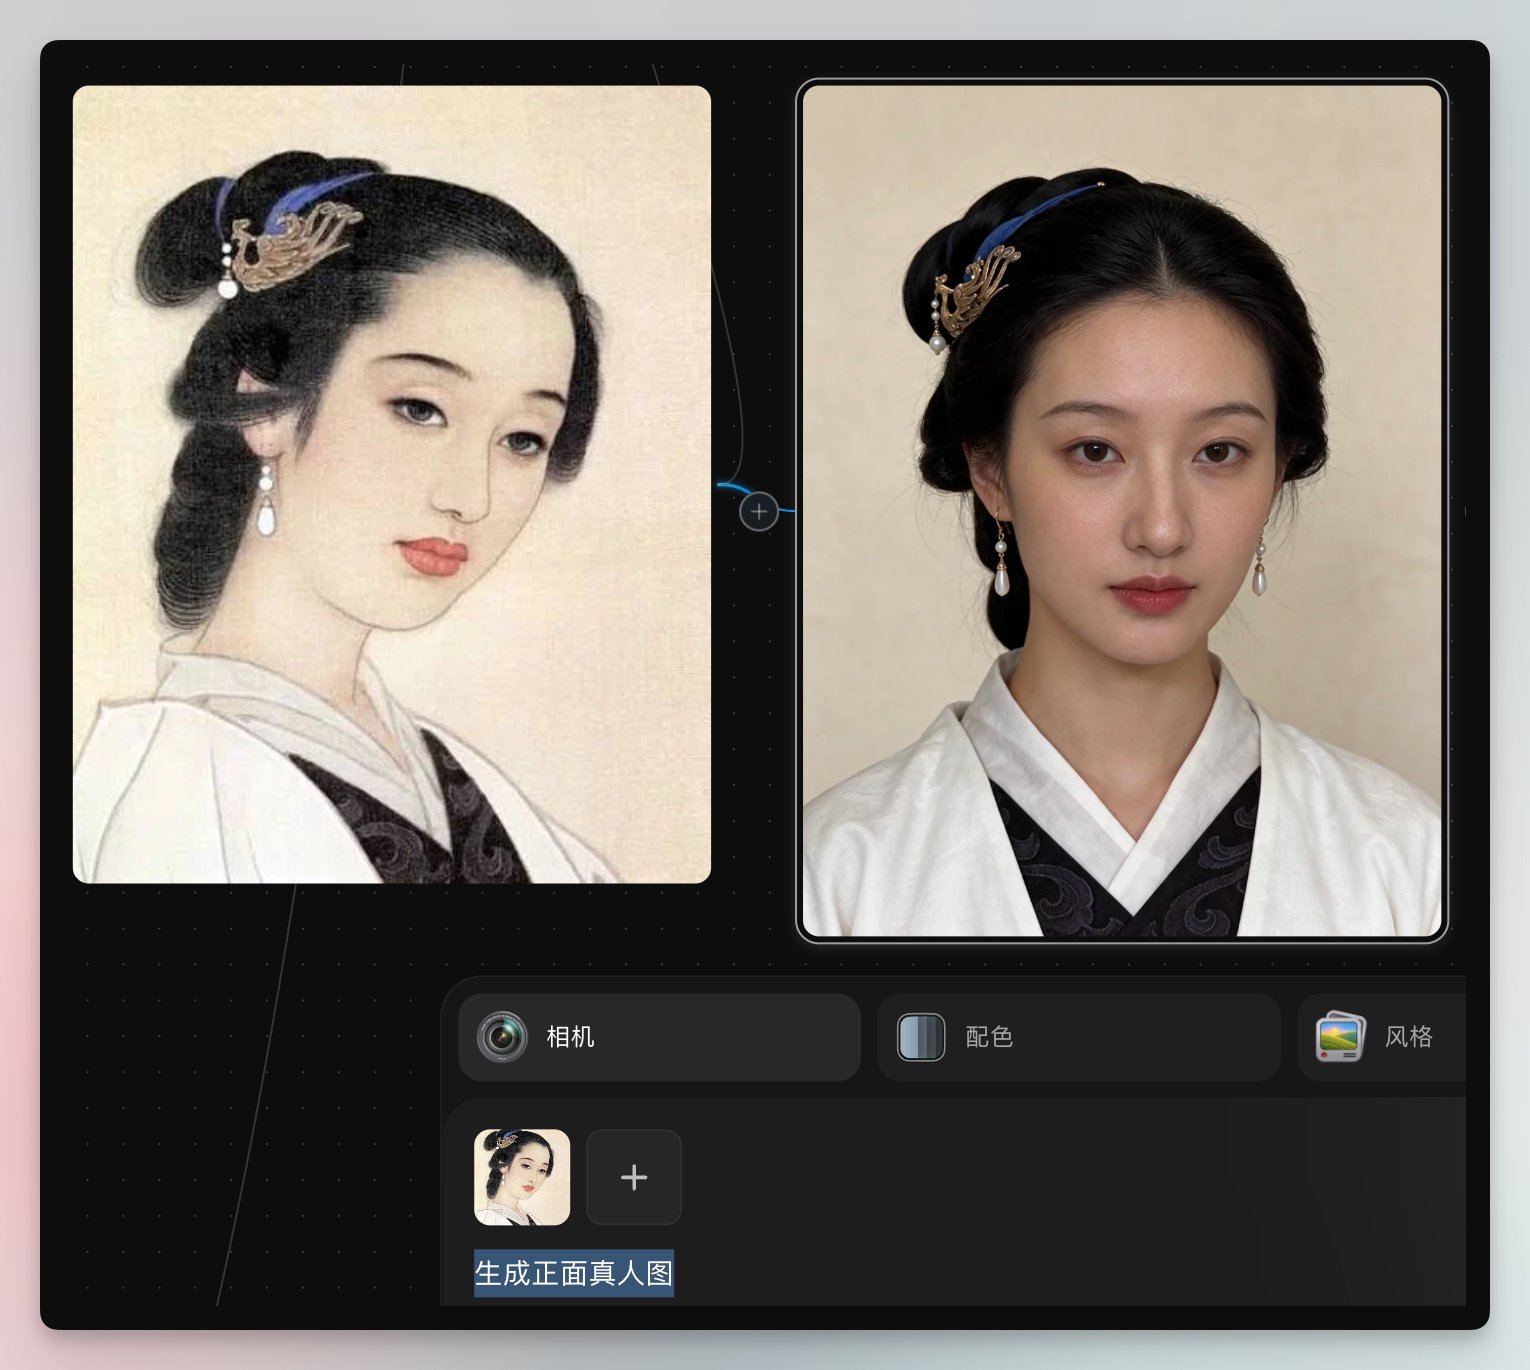
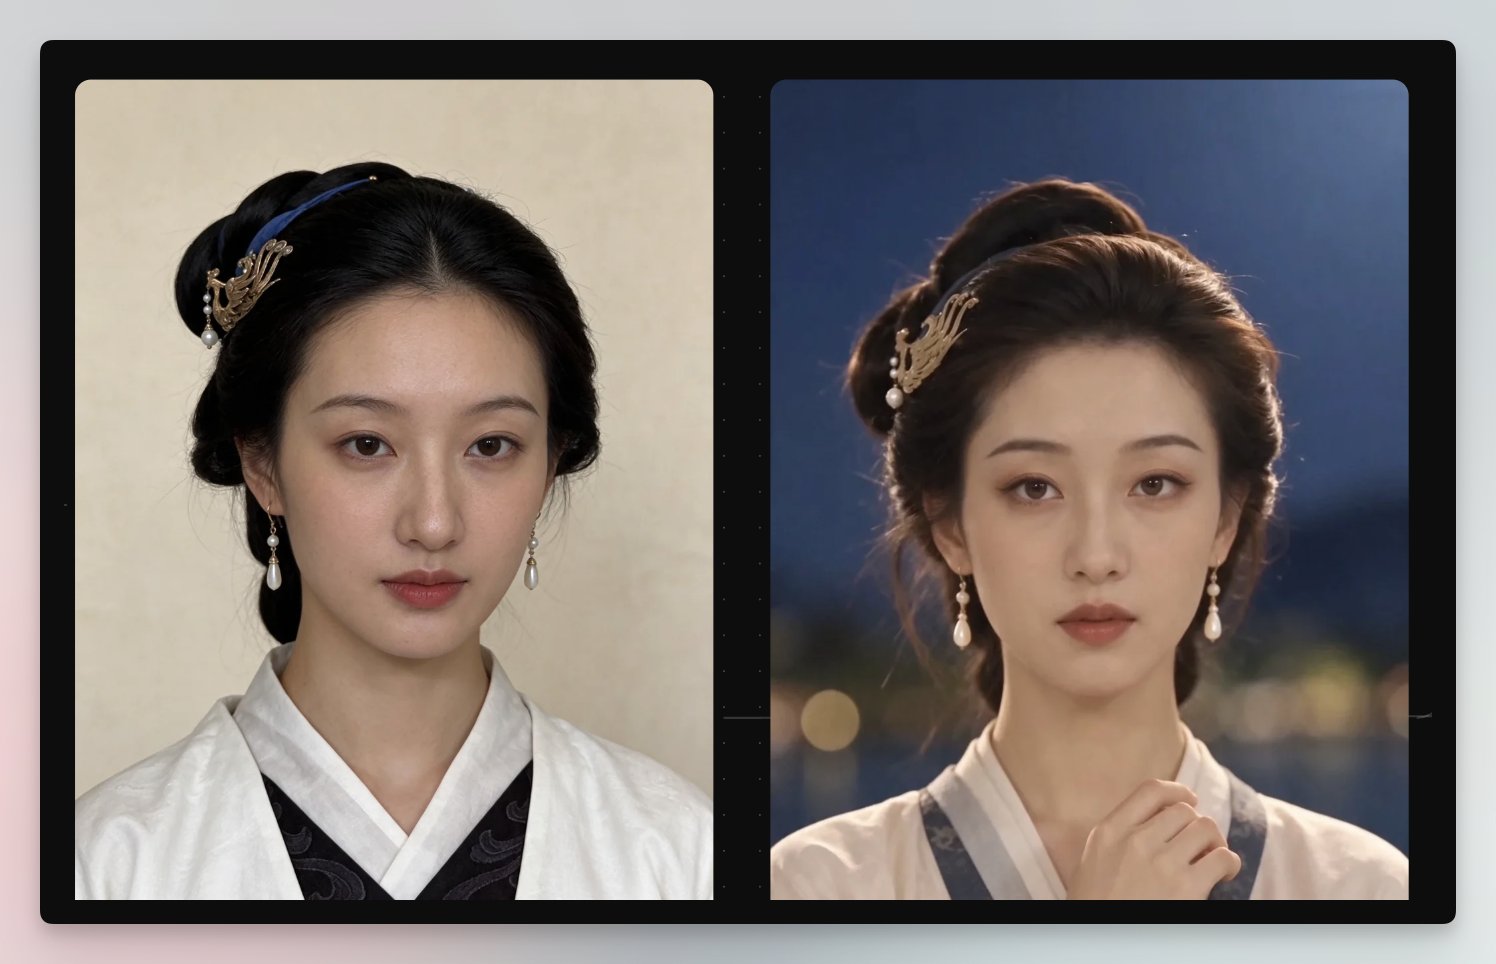
与《持械入宋》的官方剧照放在一起对比,五官轮廓与气质确实颇为接近:
接着提高测试难度:我收集了剧中多名角色的不同分辨率截图,再搭配一张动作参考图,让模型合成一张剧组杀青大合照。
生成的合照准确还原了参考姿势,但当同框角色数量增多时,部分人物的面部特征仍会出现轻微偏移。目前制作 AI 短剧时,建议尽量控制单镜头内的同框主角人数,避免在单张画面里堆叠过多参考人像。
五、文本渲染
好友玉伯提到,在他们的产品 Youmind 上,许多用户每周都会生成大量图片版 PPT 和信息图。起初团队以为大家是为了职场汇报,做完用户访谈才发现,多数人只是把长文转成信息图方便自己阅读。
生图排版文字的玩法最早由谷歌带火,但早期的 Nano Banana 1.5 只擅长英文,遇到中文常出现笔画错乱(俗称“画鬼符”)。随后 GPT Image 2.0 和 2.5 率先解决了中文渲染可用性,当时我和橘子、归藏还聊起过国产模型在这块反而落后了。这次 Seedream 5.5 补上了高密度中文渲染短板,连小字号汉字都能清晰成型,效果明显优于 Google Nano Banana 2.1,可与 GPT Image 2.6 的 Sunburst 版本正面对比。
提示词:生成一张高信息密度的中文信息图,介绍李清照
下面使用同一句提示词做实测对比,左图为 Seedream 5.5,右图为 GPT Image 2.6 Sunburst:
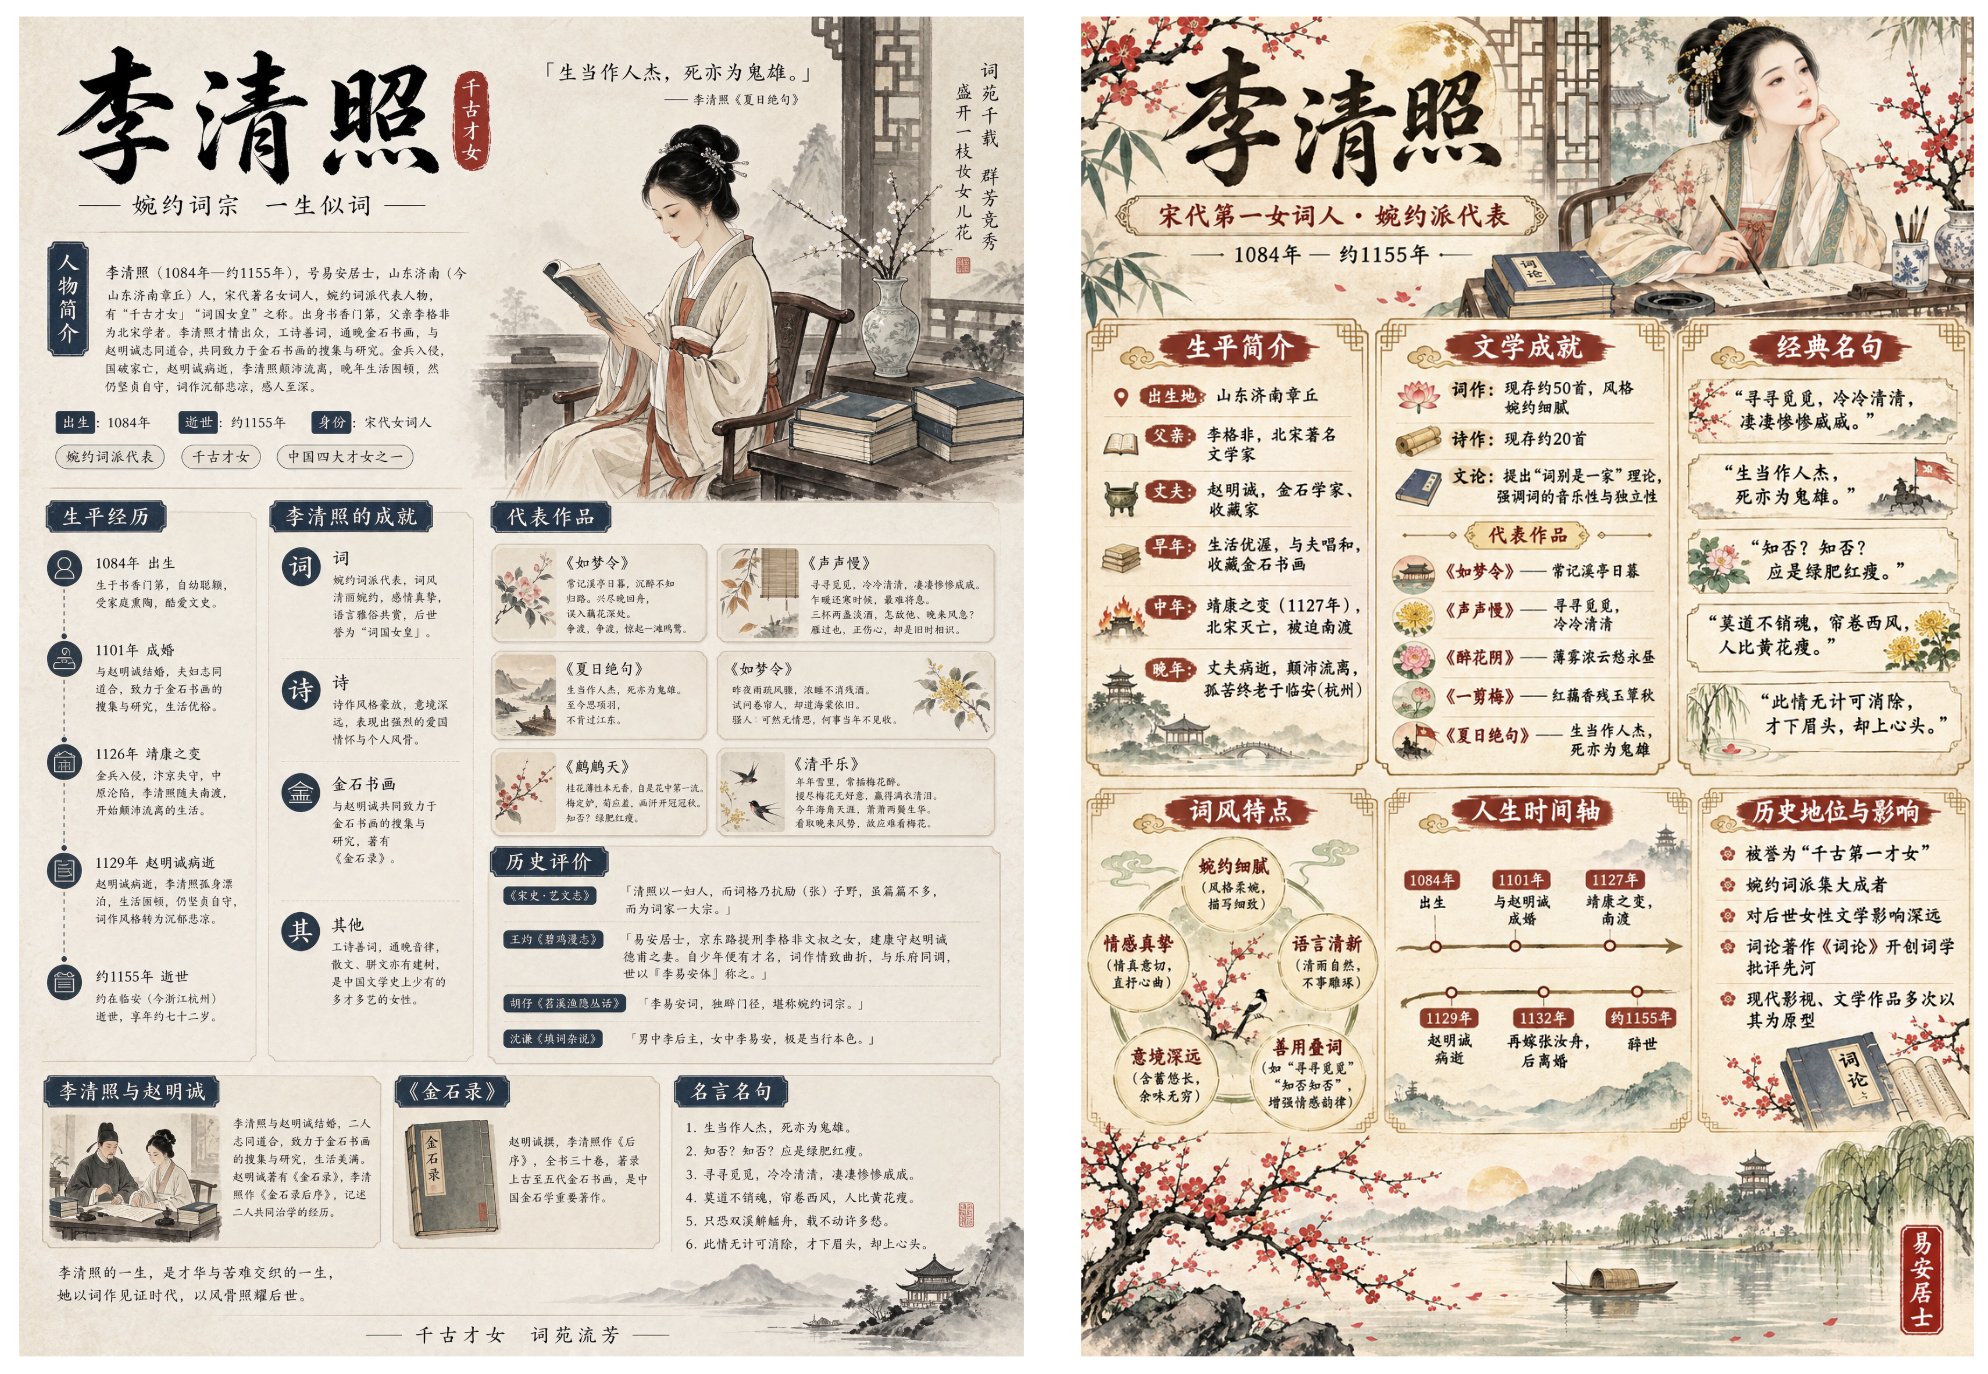
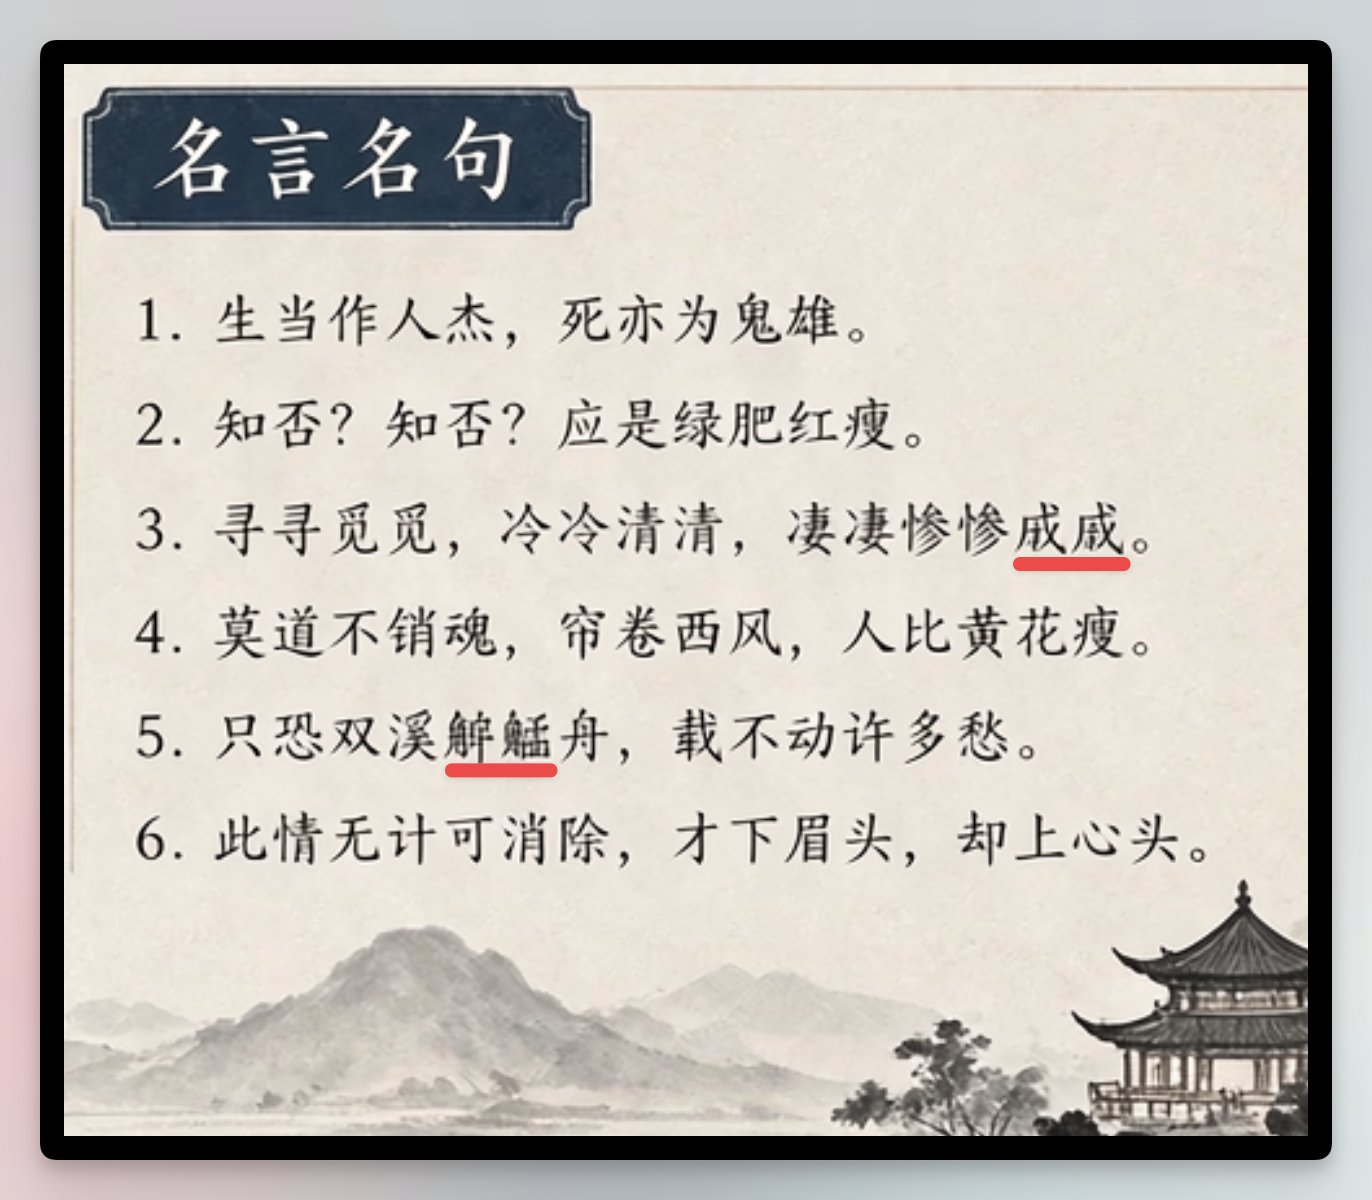
对比两张成图,Seedream 5.5 排入了更多有效信息,版式的模板感也更淡。GPT Image 2.6 Sunburst 因字号偏大占了优势,仅“凄凄惨惨戚戚”末尾的“戚戚”略显模糊。将 Seedream 5.5 放大 3 倍检查细节,除高笔画密度的“戚戚”和“只恐双溪舴艋舟”里的“舴艋”两词稍糊外,其余诗词与生平小字均能清晰辨认。
再与谷歌当前的生图模型做对比,左图是 Seedream 5.5,右图是 Google Nano Banana 2.1:
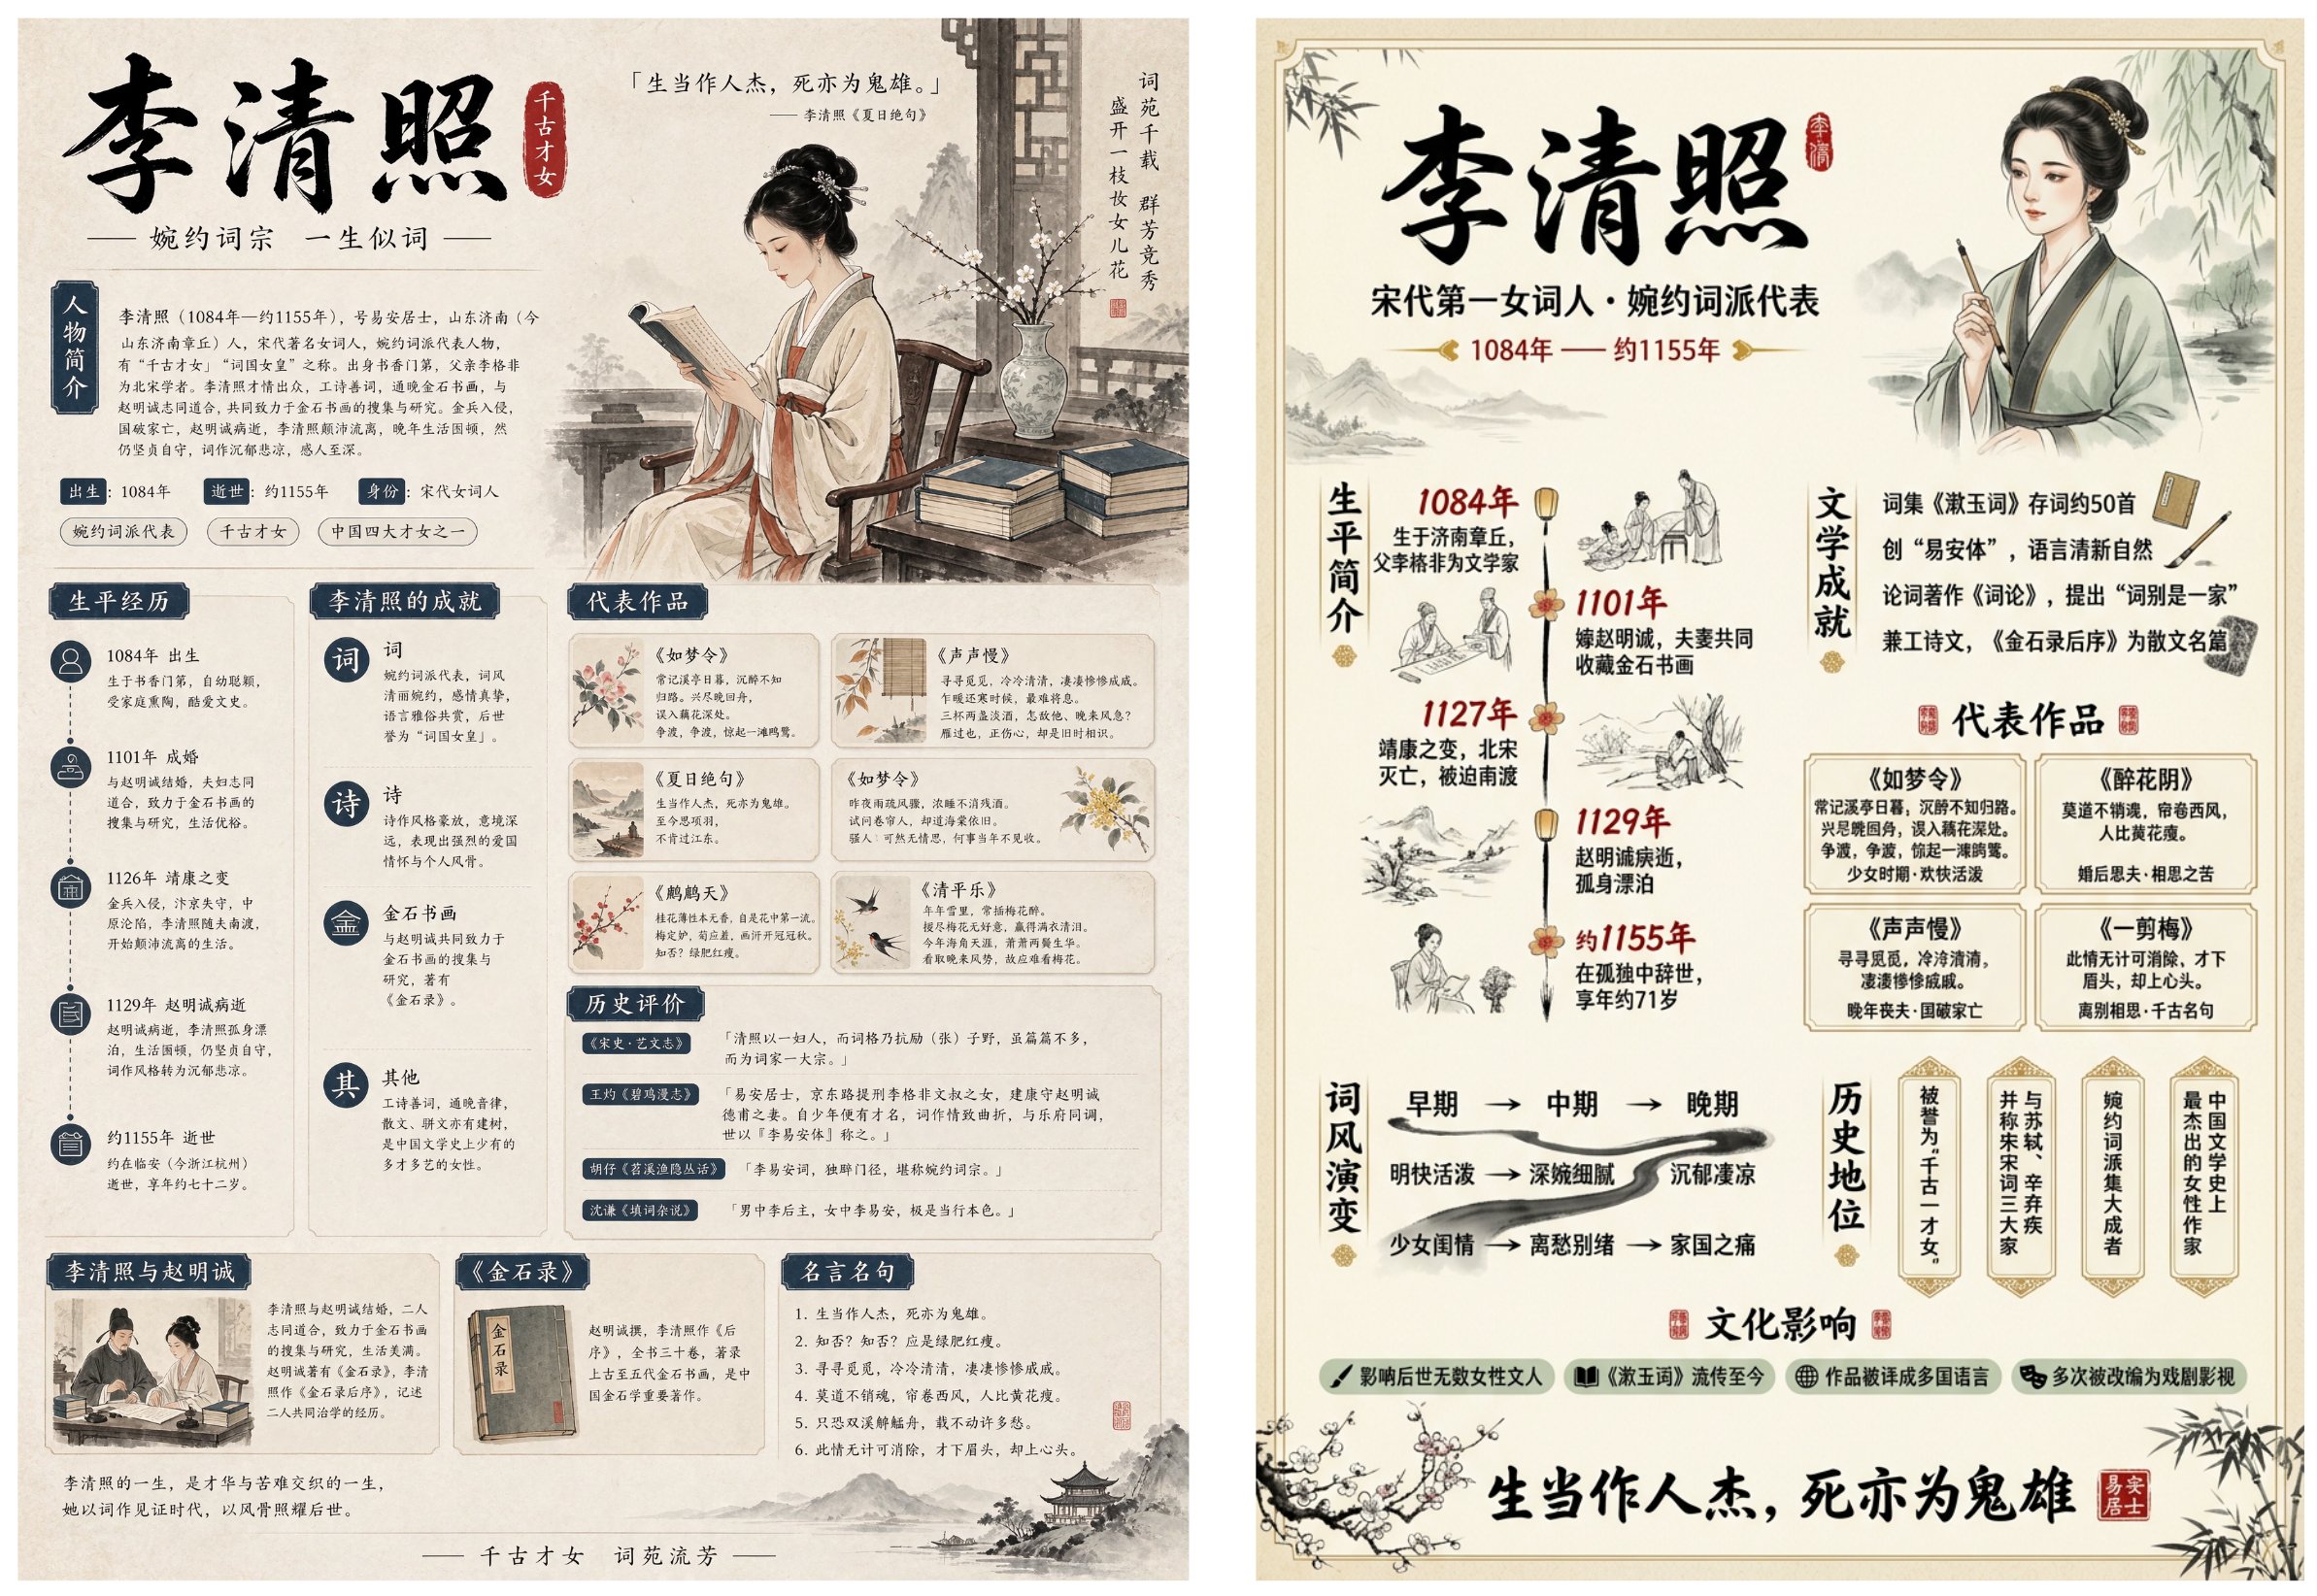
无需放大原图就能看出差距,Google Nano Banana 2.1 的中文区域出现了大面积笔画粘连与错字。接着把提示词改为生成英文信息图,左图依然是 Seedream 5.5,右图是 GPT Image 2.6 Sunburst:
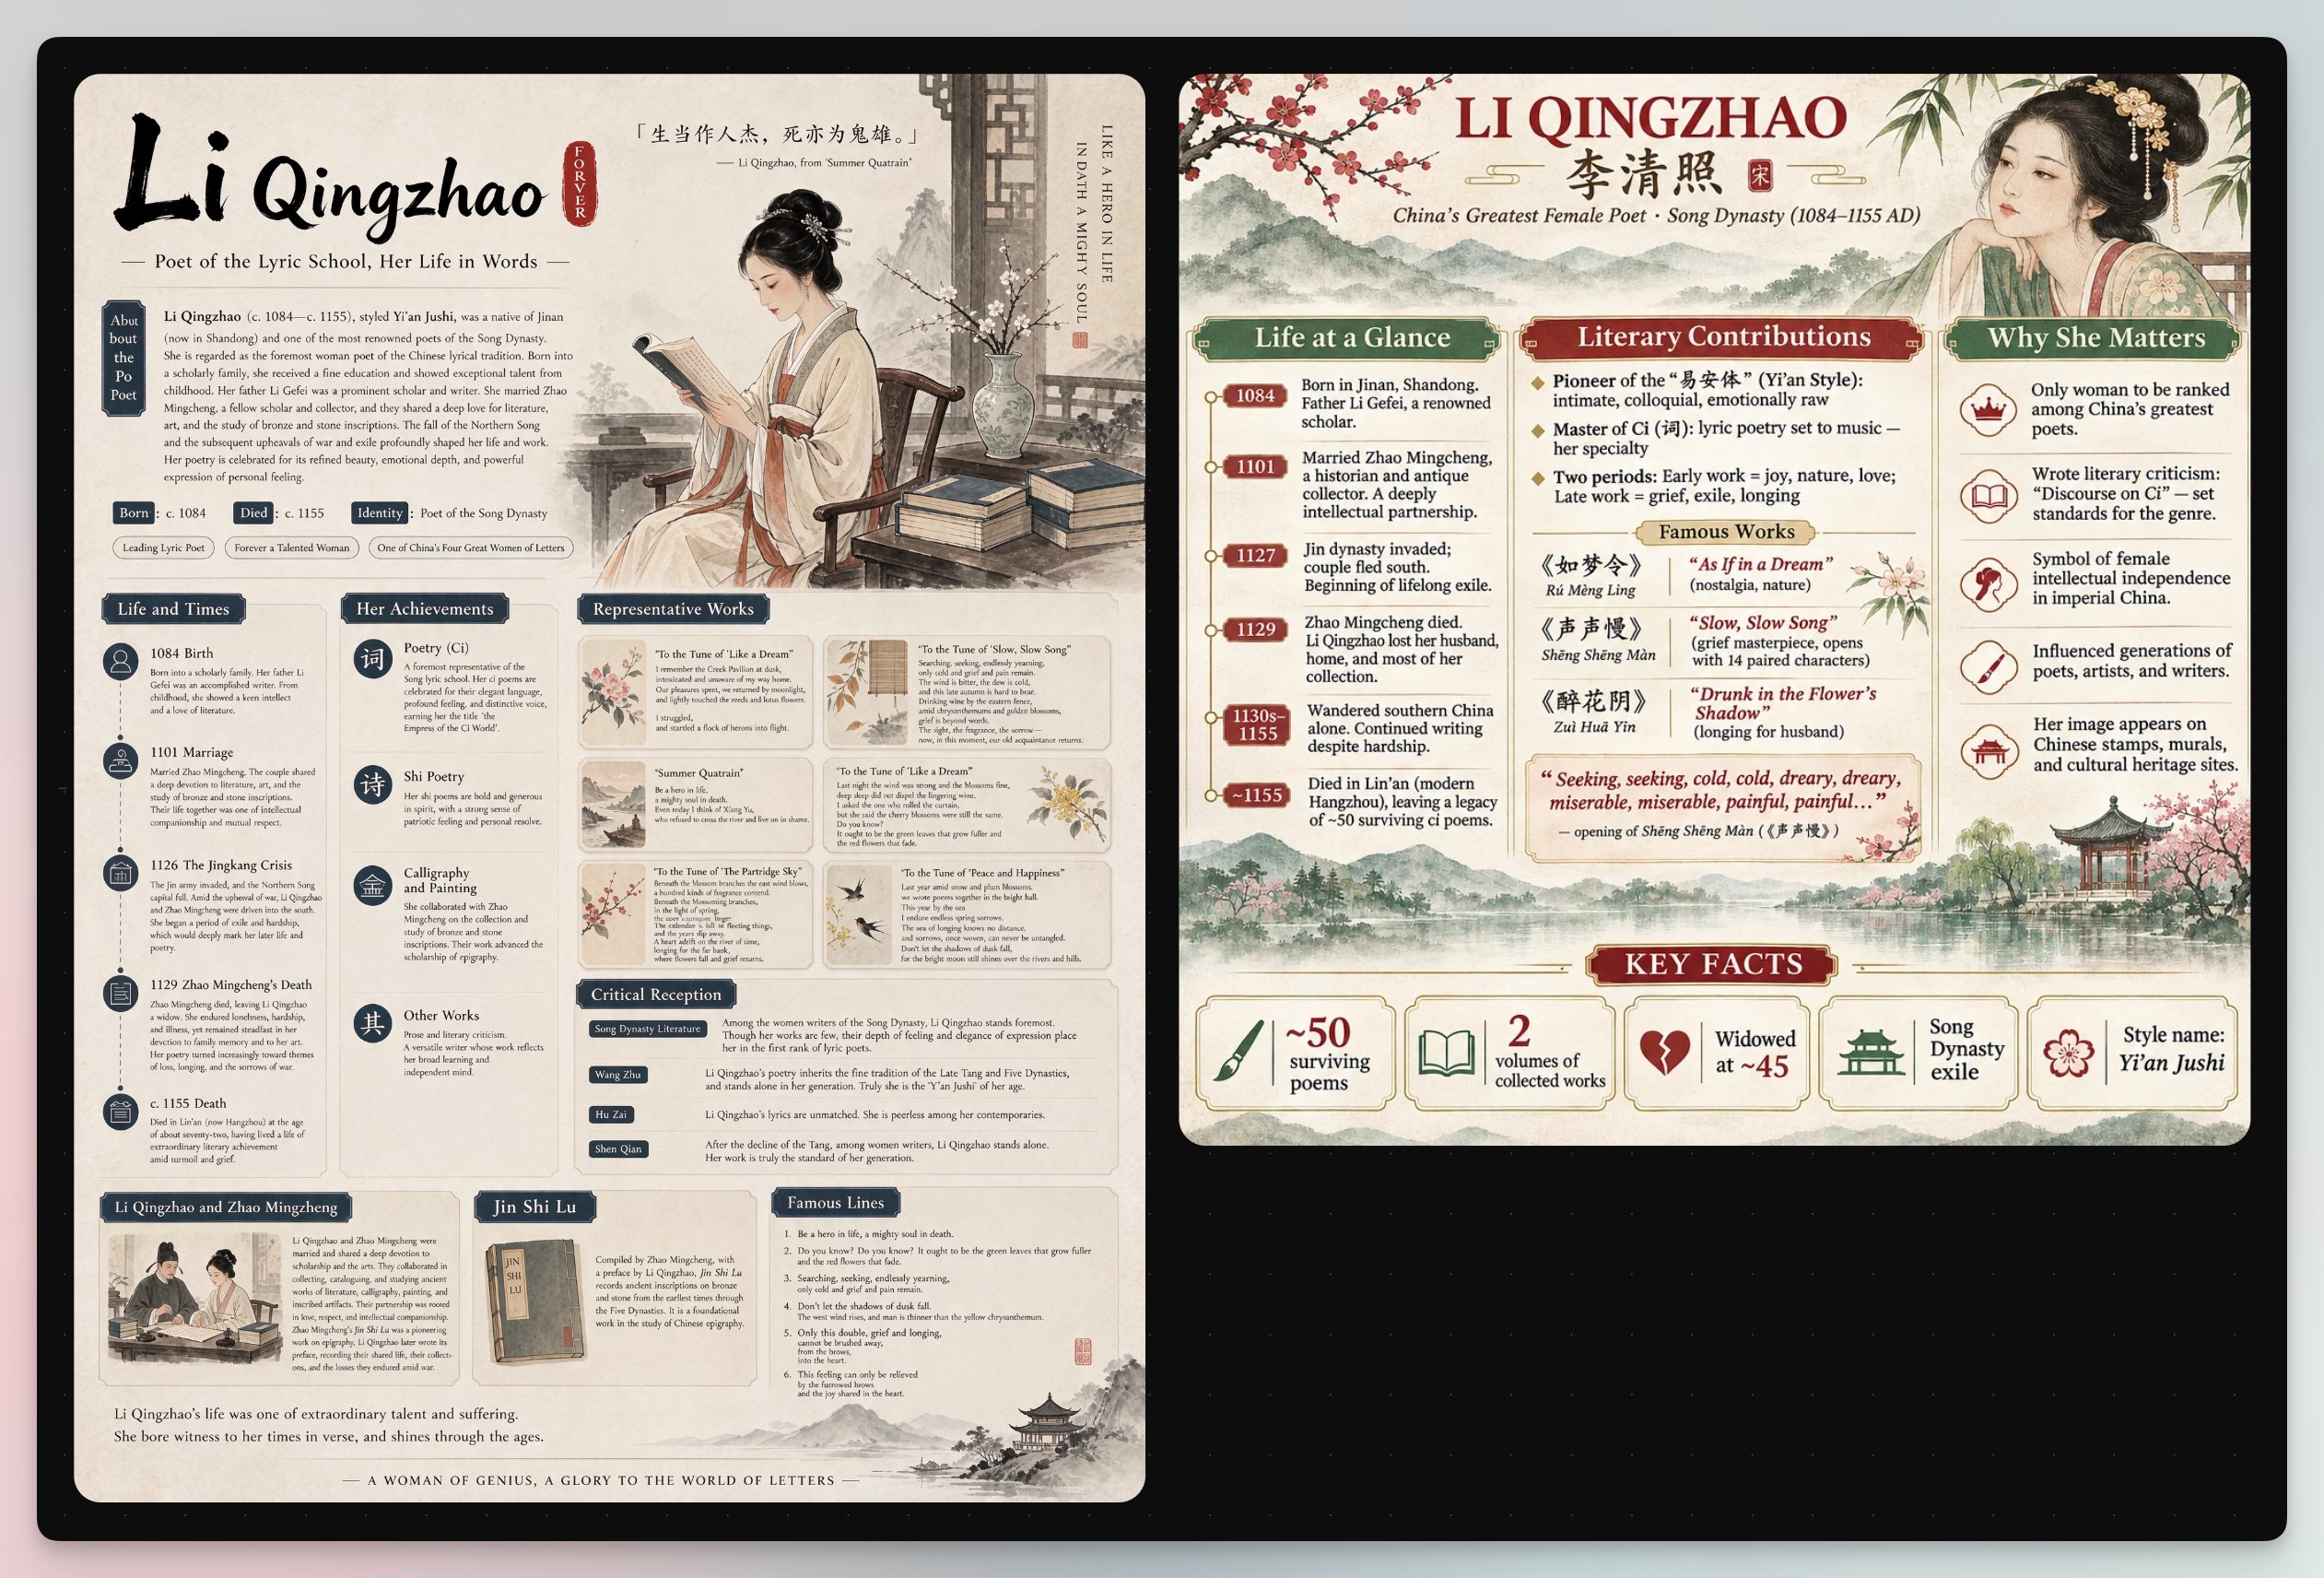
在这轮英文对比中,GPT Image 输出的文本条目反而变少了。放大查看 Seedream 5.5 的英文段落,可以看到它把李清照《夏日绝句》中的“生当为人杰,死亦为鬼雄”准确译为了 Be a hero in life, a mighty soul in death。
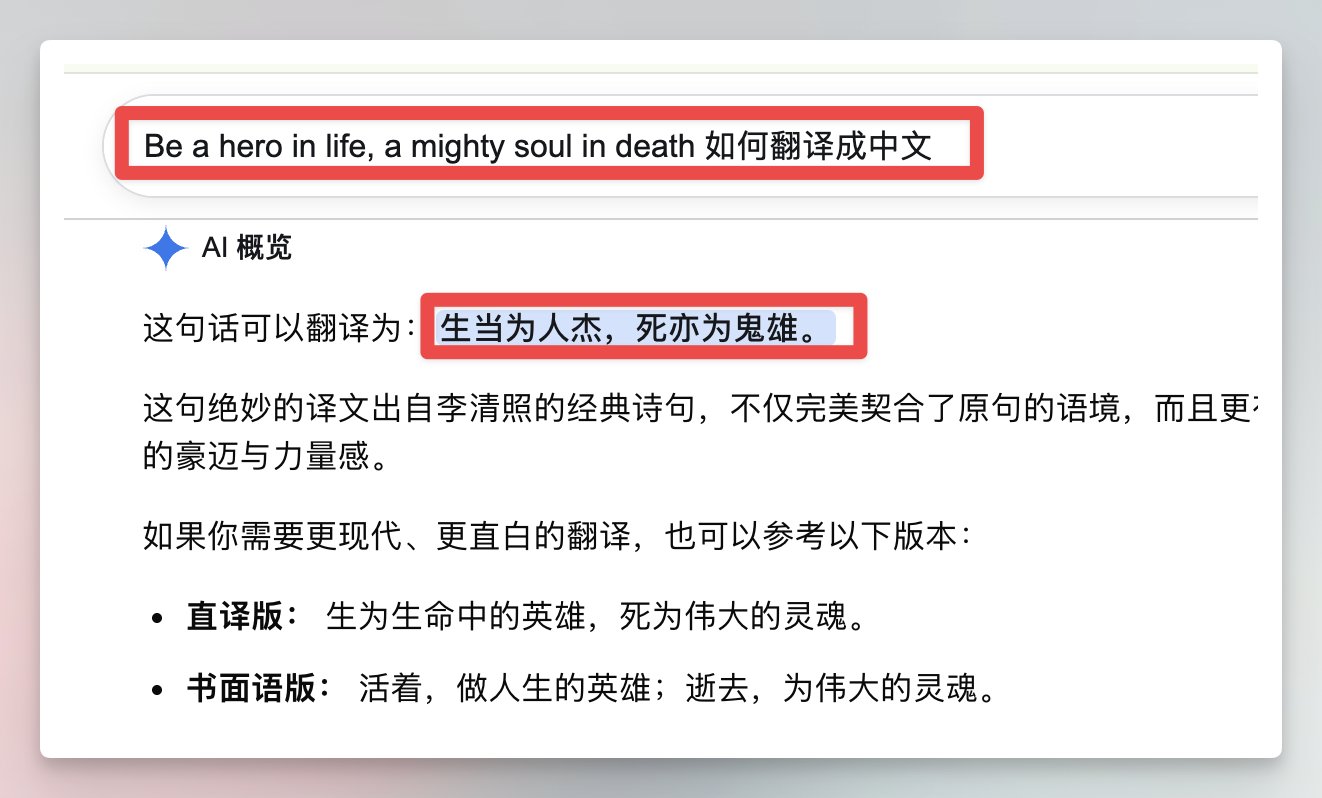
我手头暂时没有 GPT Image 2.5 Sunburst 的测试权限,不过综合小互和宝玉放出的对比样张来看,Seedream 5.5 在中文小字上的出错率同样更低。字节官方技术博客披露,Seedream 5.5 的严重文字错误率已从上一代的 2.8% 降至 0.4%,完整跨模型评测数据可查阅官方报告:
ByteDance Seed 官方技术博客https://seed.bytedance.com/zh/blog/more-realistic-images-more-stable-editing-across-100-rounds-introducing-seedream-5-5
六、体验渠道与接入计划
目前 Seedream 5.5 已全量上线,你在即梦、豆包和豆包工作区中都可以直接选用该模型。这次更新解决了多轮连续编辑容易走形劣化的难题。原生透明背景与图层分离省去了手动进 Photoshop 抠图的步骤,适合电商设计、游戏美术和短剧团队日常提效。
同时,0.4% 低错字率的文本渲染能力,也让长文转信息图成了顺手的读书笔记工具。接下来就等火山引擎开放 Seedream 5.5 的 API 接口,届时我会第一时间把它接入自己的 Obsidian 插件中。
七、交互工坊:Seedream 5.5 五大场景提示词与横向对比表
Seedream 5.5 实测提示词沙盒与跨模型对比表
| 对比项目 | 字节 Seedream 5.5 | GPT Image 2.5 / 2.6(Sunburst) | Google Nano Banana 2.1 |
|---|---|---|---|
| 100 轮连续编辑稳定性 | SOTA(仅秒针走动或服装变化,人脸与背景无劣化) | 约 10 轮后出现明显涂抹劣化、模特面部走形 | 多轮连续一致性较弱 |
| 世界知识与实拍真实感 | 表现突出(仅提“天津海河”即准确还原天津之眼结构) | 较强(具备大语言模型推理扩写能力) | 较强(依托 Gemini 知识库) |
| 透明背景与图层分离 | 原生支持透明直出,支持单图多 Icon 一键图层分离 | 支持透明背景生成,无画布一键多图标拆分 | 需借助外部抠图工具 |
| 高密度中英文信息图 | 严重文字错误率仅 0.4%(上一代为 2.8%),版式自然 | Sunburst 清晰度高,但字号偏大、英文信息量偶有缩减 | 英文可用,高密度中文小字易出现笔画粘连与乱码 |