
本文收录 AI 研发工程师刘老板(@leo_xiaolei)发布的实战长文,以古装安防监控喜剧《西梁国留婚 · 监控实录》为例,拆解单人调度 AI 剧组的完整流程。你只需在 Antigravity 中与 Gemini 4 对话,即可自动完成剧本审稿与跨镜头角色外貌固定,再通过 Chrome 9222 远程调试接管 Google Flow(Omni 1.2)批量生成视频。针对配音与后期,流程调用本地 VoxCPM2(48kHz MLX)与 Whisper 解决中文吞尾音和多音字误读,最后用不到 200 行 Python(PIL)与 ffmpeg 脚本逐帧绘制监控 HUD 并合成母带。
Omni 1.2 发布后,很多讨论集中在提示词写法和抽卡技巧上。实际做完几支成片就会发现,调用视频生成工具只是整个流程里最基础的一步。
真正耗费精力的是后续成片制作:把一句话创意扩展成有反转的剧本,保证五六个镜头里的人物外貌与服装一致,解决视频模型说中文吞尾音、读错多音字的问题,并用代码完成字幕、界面包装与混音。
前几天,我用 Gemini 4 配合 Omni 1.2 制作了一系列古装监控视角的西游记喜剧,包括《真假美猴王》和《西梁国留婚》。
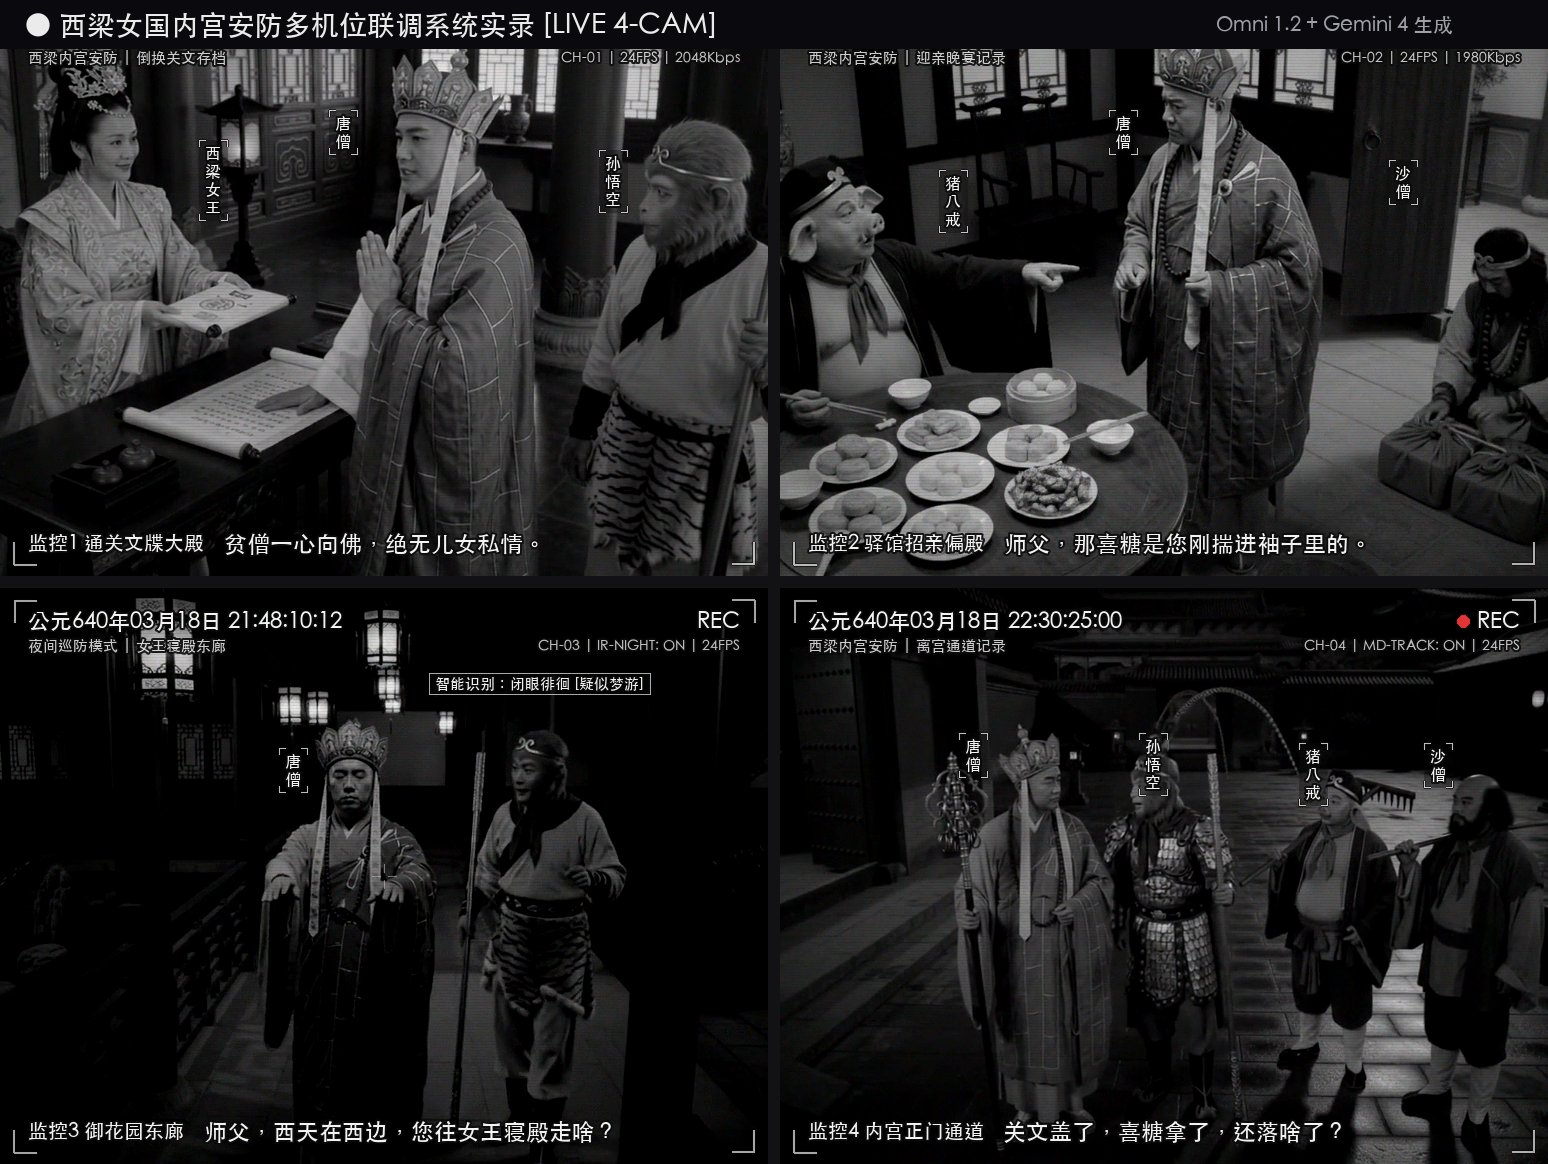
不少读者询问成片的制作细节,比如配音咬字不准如何修复,画面上的监控框和时间戳如何添加。下面按实际制作顺序拆解从创意到成片的 7 个步骤,每个环节都附带可直接复制的提示词。
一、核心工具清单与角色分工
制作一支成片共用到四款工具:
- Gemini 4(在 Antigravity 中使用):担任总导演兼程序员。如需了解 Gemini 4 的长程推理与工具编排机制,可参阅 《Google 官方 Gemini 4 Carbon 开发者实战指南》 与 《实测 Gemini 4 Argon》。
- Omni 1.2(在 Google Flow 中使用):担任摄影师兼演员。
- VoxCPM2 + Whisper(本地运行):担任配音师兼台词质检员。
- Python + ffmpeg:担任剪辑师兼后期特效师。
采用这套组合是为了避免在十几个网页和软件之间频繁切换。整个流程只需与 Gemini 4 对话,由它自动调度其余工具完成执行。四款工具的具体分工如下:
| 工具 | 扮演角色 | 具体职责 |
|---|---|---|
| Gemini 4 | 总导演 | 将创意扩写成剧本,拆解分镜,编写精确到秒的视频提示词。随后连接浏览器操作 Google Flow 生成视频,抽帧检查画面,调用本地语音模型重配台词,最后编写 Python 与 ffmpeg 脚本合成成片。 |
| Omni 1.2 | 摄影师 + 演员 | 接收分镜提示词,在浏览器中生成单段 8~12 秒的视频片段,呈现人物动作、表情与环境音。 |
| VoxCPM2 + Whisper | 配音 + 质检 | 视频模型直出的中文配音常有口音、吞尾字或多音字误读。VoxCPM2 按角色生成 48kHz 干音,Whisper 将每个字的时间戳定位到毫秒级,并核查漏字与错字。 |
| Python + ffmpeg | 后期剪辑 | 用代码逐帧绘制监控边框、动态时间码与底部字幕,为台词添加室内空间混响,并完成切镜音效与成片拼接。 |
在这套流程中,你无需手动向 Google Flow 逐条粘贴提示词,也不用打开剪辑软件手动校准十几条音轨。你只需审阅 Gemini 4 提交的阶段成果,给出修改意见即可。
二、全流程拆解:从初步创意到完整成片
2.1 从初步创意到完整剧本
制作 AI 视频时,跳过剧本直接写提示词生成画面,往往只能得到零散的空镜头。要将“用现代监控视角拍西游记女儿国留婚”这类初步想法转化为可拍摄的剧本,可遵循以下 5 条原则:
借鉴参考片的结构反差,不照搬台词老梗
遇到表现好的参考片,不要照搬台词和老梗,而是让 Gemini 4 拆解它的叙事结构。这类短片的喜剧效果,通常来自严肃的现代纪实画幅(如安防监控或执法记录仪)与古典人物关系的反差。保留这层反差结构,再填入原创剧情与包袱即可。
采用多机位片段式结构
当前视频模型难以在长镜头连续走位后精准衔接下一镜动作,最稳妥的做法是从剧本结构上直接规避。
例如设置 5 个固定监控机位,依次切换“迎宾大殿”、“后花园凉亭”、“偏殿耳房”、“夜间寝殿走廊”和“城门通关处”。每个镜头拥有独立机位与场景,各自完成一个喜剧包袱,镜头之间用切镜咔哒声衔接,无需强行匹配上一镜的肢体动作,生成成功率会明显提高。
单镜内部遵循“正经场面、动作穿帮、旁人点破”节奏
在 12 秒的单镜视频里,如果三个角色只是站着对话,画面会显得单调。喜剧镜头需要让角色嘴上说一套,手脚做相反的动作。
例如唐僧嘴上说“贫僧一心向佛,绝不留恋红尘”,左手单掌行礼,右手却死死按住桌上的通关文牒与婚书,指节用力发白。旁边的孙悟空凑近指着婚书调侃一句“师父,那你先把婚书松开呀”。用具体肢体动作戳穿台词,画面的戏剧张力会强得多。
剧本阶段提前规避视频模型短板
部分戏份写进剧本很容易,但视频模型生成时极易穿模,应在剧本阶段直接剔除:
- 不写多人打斗或肢体纠缠戏份:多人肢体交叠极易出现手脚穿模。
- 不写当面进食、倒水或吞咽动作:液体流动与吞咽细节容易失真。
- 单镜同框角色不超过 3 人:人数过多时模型难以区分说话人,容易把口型配到其他角色脸上。
- 同一时刻只允许 1 人开口说话:避免设计双人同时抢话的对白。
让 AI 切换审查视角给剧本挑刺
Gemini 4 写完初稿后,如果直接问它质量如何,它往往倾向于肯定自己的输出。此时应让它切换为喜剧导演兼技术总监视角,专门排查逻辑漏洞、包袱平淡或超出模型生成能力的动作设计。
编写剧本初稿的提示词如下,可直接复制发给 Gemini 4:
我想做一支 AI 视频,初步想法是:[填写你的想法,比如:用现代高清监控视角拍西游记女儿国留婚,共 5 个机位,总长约 60 秒]。
参考片亮点:[如有参考片,写明你想借鉴的节奏或反差感,要求学思路不抄袭剧情]。

请你先不要写分镜,先帮我打磨剧本大纲和分场剧情:
1. 故事结构:采用 5 个独立机位的片段式结构,每段 11-12 秒,段与段之间自然推进,最终在最后一镜完成大反转。
2. 戏剧反差:每一镜都要遵循“表面一本正经 → 手上小动作穿帮 → 旁人一句话点破”的喜剧节奏,用具体的肢体动作制造笑点,不要靠干聊。
3. 规避模型弱点:每镜画面不超过 3 人,同一时刻只有 1 人开口说话,不出现打斗缠抱、吃喝吞咽或复杂手指特写。
4. 台词要求:口语化、接地气、符合人物性格,每镜台词控制在 2-3 句(总字数 28-36 字以内),留出动作和反应时间。

请先输出 5 镜的剧情梗概、每镜核心包袱和台词初稿。
二次挑刺审查剧本的提示词:
现在请你忘掉刚才创作者的身份,扮演一个挑剔的喜剧导演兼 AI 视频技术总监,审视上面这份剧本:
1. 哪一镜的包袱太老套或者只靠嘴说、缺少可视化的动作反差?
2. 哪一句台词字数太多,放进 12 秒视频里会导致语速过快或结尾被截断?
3. 哪一镜的动作设计超出了当前视频模型的能力边界,容易出现穿模或乱动?
4. 角色每一镜的动机是否连贯?
请直接列出问题清单并给出修改后的剧本定稿。
2.2 分镜设计:固定机位、外貌描述与视觉节奏
剧本定稿后,下一步是拆解分镜表。分镜的核心任务有两项:一是确定机位构图,二是保证五段视频里的人物外貌一致。关于镜头方位与空间景别的描述词,可参考站内文章 《AI 设计词典(上篇)|怎么描述画面》。
优先使用固定机位代替复杂运镜
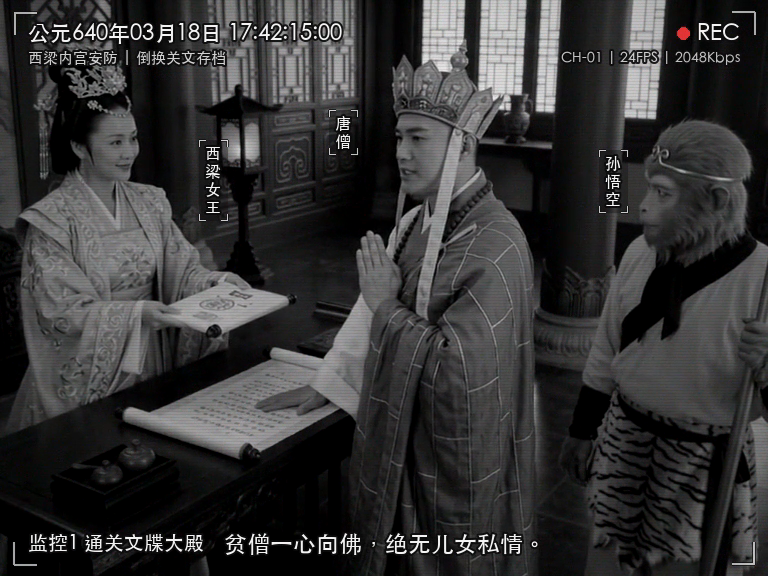
拍摄剧情喜剧或监控题材时,建议全程使用固定机位,例如天花板右上角 35 度斜俯拍广角镜头。若要求模型同时处理推拉摇移运镜与多人物微表情,画面边缘容易扭曲变形。固定高角度机位能让模型将算力集中在人物眼神、手部小动作与衣物褶皱上,成片稳定性更高。
用固定外貌词保证跨镜头人物一致
在不垫参考图、纯靠文生视频的条件下,要让第一镜和第五镜的唐僧保持同一长相,可以为每个角色编写一段 30 字左右的固定外貌与服装描述,在每一镜提示词中原样粘贴。
例如唐僧在所有镜头中统一写为:身披大红织金锦襕袈裟,内穿素白僧衣,头戴五佛宝冠,面容白净端庄但眼神慌乱的年轻唐僧。即使切换场景,只要这段描述一字不改,Omni 1.2 生成的人物辨识度就能保持统一。
穿插红外夜视黑白画面调节视觉节奏
如果五个镜头全是白天暖光宫殿,观众看到第三镜容易产生审美疲劳。我们将第四镜(夜间走廊偷塞御弟金印)设计为高对比度的黑白红外夜视监控画面,人物眼珠在红外补光下微泛反光,画面带轻微夜视噪点;第五镜城门送别再切回清晨明亮阳光。明暗交替能拉开全片的视觉层次。
生成分镜表的提示词如下:
剧本已经确认。现在请为这 5 个镜头编写详细的《分镜设计表》,用表格加分镜卡片的形式输出,每一镜必须包含:
1. 镜号与场景名称(含时间、地点、光照模式:白天常规彩色 / 夜间红外黑白)。
2. 机位与构图(固定高角度斜俯拍监控广角,明确画面左、中、右分别站着谁,前景和背景有什么核心道具)。
3. 角色外貌锁死词(为每个出场角色编写固定的服装、头饰和长相特征词,跨镜头保持完全一致)。
4. 动作时间轴:按 [00:00-00:04]、[00:04-00:08]、[00:08-00:12] 三段,写清每个角色的具体肢体动作(手放在哪、眼神看哪、身体往哪偏)。
5. 精确台词与开口顺序(标明谁先说、谁后说、说话时的微表情)。
2.3 编写视频提示词:按时间轴限定动作与台词
分镜表供创作者审阅,视频提示词则直接提交给 Omni 1.2。下表汇总了实测 Omni 1.2 时的常见异常原因与提示词解法:
| 常见异常现象 | 触发原因 | 提示词解法 |
|---|---|---|
| 最后一句话没说完视频就停了 | 12 秒视频若把台词排到第 11 秒,模型语速稍慢就会在结尾半秒被截断 | [00:08-00:12] 的台词必须在第 10 秒前说完,最后 1.5 秒明确写成“保持表情定格与眼神对视,不再开口说话” |
| 长句子中间吞掉半句 | 单句包含三四个分句时,模型容易跳过中间分句直接念结尾 | 单句台词拆短,中间多用句号断句,每段台词控制在 10~14 个字以内 |
| 多音字、现代词在古装戏里读错 | 古装画面里说“监控”易受语境影响读成“中宫”,说“为师”易读成四声“喂师” | 提示词里直接用同音单音字替换(如把“为师”写成发音唯一的“维师”),或留到后期用本地语音模型重配 |
| 画面上自行生成乱码字母 | 提示词写了“监控画面、带时间戳和字幕”,模型会自行绘制扭曲字符 | 提示词末尾固定写明:画面纯净,不带任何文字和水印,也没有字幕或监控边框(监控界面统一留到后期用代码绘制) |
| 没说话的角色嘴巴跟着乱动 | 未明确指定当前开口角色与闭嘴旁听角色 | 每次有人开口时写明:仅 A 开口说:“……”,B 与 C 全程紧闭双唇不说话,只做表情反应 |
结合上述约束,单镜视频提示词可归纳为以下固定结构:
以下是《西梁国留婚》第一镜实测使用的完整提示词:
固定高角度监控广角俯拍镜头,真实古装影视质感,86版西游记美术风格,光线明亮清晰。
场景为西梁女国金銮宝殿内部,红柱金砖,中央摆放一张雕花长案,案上放着明黄色的通关文牒与大红婚书。
画面左侧站着女王(头戴九凤朝阳金冠,身穿大红绣金凤袍,容貌端庄华贵)。画面中央坐着唐僧(头戴五佛宝冠,身披大红织金锦襕袈裟,内着白僧衣,面容白净)。画面右侧站着孙悟空(金冠金甲,毛脸雷公嘴,手持金箍棒)。

[00:00-00:04] 女王面带温柔笑意,双手捧起案上的大红婚书推向唐僧,仅女王一人开口用清晰标准普通话温柔说道:“御弟哥哥,留下成亲,这江山都是你的。”唐僧与孙悟空紧闭双唇不说话。
[00:04-00:08] 唐僧立刻脸色微红,左手竖在胸前单掌行礼,但右手却死死按住桌上的大红婚书往自己怀里拽,指节用力,仅唐僧一人开口用清晰标准普通话急促说道:“陛下使不得!贫僧刚才没说清楚!”女王与孙悟空闭嘴观看。
[00:08-00:12] 孙悟空往前凑近一步,低头盯着唐僧按住婚书的右手,伸手指着婚书,仅孙悟空一人开口用清脆标准普通话调侃道:“师父,那你手先松开呀!”说完后最后1.5秒三人保持动作定格与眼神交锋,不再开口说话。

环境音为安静的宫殿室内自然混响与衣料摩擦声,无背景音乐,画面纯净无任何文字,无字幕无水印,无监控UI边框。
让 Gemini 4 批量生成全部镜头视频提示词的模板:
请根据确认好的分镜表,为全部 5 个镜头编写可直接提交给 Omni 1.2 的中文视频提示词。
严格遵守以下 5 条铁律:
1. 结构按【画风与机位】【场景与人物位置外貌】【00:00-00:04】【00:04-00:08】【00:08-00:12】【声音与画面纯净度要求】分段。
2. 每个时间段内只允许 1 个角色开口说话,必须写明“仅X一人开口用清晰标准普通话说道:‘……’,其余人紧闭双唇不说话”。
3. 台词里的易错多音字直接替换成同音单音字(例如“为师”写为“维师”),单句不搞复杂长从句。
4. [00:08-00:12] 段落必须在第 10.5 秒前说完台词,最后 1.5 秒写明角色保持表情与动作反应,不再说话,防止尾音被切。
5. 结尾统一写明:无背景音乐,画面纯净无任何文字,无字幕无水印,无UI界面。
2.4 浏览器自动化生成:让 Gemini 4 接管 Google Flow
提示词就绪后,无需守在电脑前手动打开 Google Flow 逐条粘贴、等待渲染并点击下载。你可以为 Chrome 浏览器开启远程调试端口(如 9222 端口),让 Gemini 4 通过 Chrome DevTools 协议自动接管网页操作。
启动 Chrome 时加上远程调试参数并登录 Google Flow,随后将下方提示词发给 Gemini 4,它就会按顺序提交任务、下载原片并抽帧初检:
我的 Chrome 已经开启了远程调试端口,里面打开了 Google Flow 页面。
请你直接接管浏览器,帮我把这 5 个镜头的视频全部生成并下载回本地项目目录:
1. 先检查生成配置:确认模式设为 Video,单次生成数量设为 x1,模型选择 Omni 1.2(或当前可用的高质量视频模型),画幅设为 16:9 横屏。
2. 按顺序提交第 1 到第 5 镜的提示词,等待生成完成。
3. 每生成完一条,自动获取高清原片直链下载到本地,按 raw_scene_01.mp4 到 raw_scene_05.mp4 命名保存。如果需要重拍某一条,新文件按 _v2、_v3 递增命名,绝对不要覆盖旧文件。
4. 下载完成后,自动用 ffmpeg 对每段视频每秒抽 1 帧图片,并检查画面是否符合分镜要求、头尾有没有废帧。
这一环节有三条实操建议:
- 保留全部历史文件:有时重拍第 2 版后,会发现第 1 版前半段表情更自然、第 2 版后半段动作更稳,保留历史素材便于拼接优选。
- 局部瑕疵优先用代码裁剪:若只是开头半秒人物未站稳,或结尾半秒嘴型多动了一下,直接让 Gemini 4 用脚本裁掉对应帧即可,无需重新生成整段视频。
- 首尾留白不足用
tpad补齐:若模型在第 0.1 秒就开口说话,切镜会显得仓促。让 Gemini 4 调用 ffmpeg 的tpad滤镜,将首帧向前克隆静止 0.35 秒,末帧向后克隆静止 0.45 秒,留出自然的镜头停顿。
2.5 多角色配音重制:VoxCPM2 与 Whisper 本地流水线
使用视频模型直出中文台词时,常会遇到三类音频缺陷:
- 咬字含糊或带有异常口音:部分字词发音发飘,清晰度不足。
- 多音字与专有名词误读:例如把“监控”读成“中宫”,把“为师”读成“喂师”。
- 句尾音频提前截断:最后一个字刚发出一半声音即中断。
在监控俯拍、远景或中景镜头中,人物面部占画面比例较小。最稳妥的方案是保留原视频的动作与环境底噪,用本地语音模型重新生成全部角色台词。这种将语音生成与画面表现分离的做法,在数字人口播场景中同样适用,详见 《99% 的人没看出来的数字人口播实战攻略》。
我们在本地部署了 VoiceStudio 与 VoxCPM2(48kHz MLX 量化版),配合 DeepFilterNet3 降噪与 mlx-whisper 词级时间戳定位,搭建了自动化的多角色配音流水线。
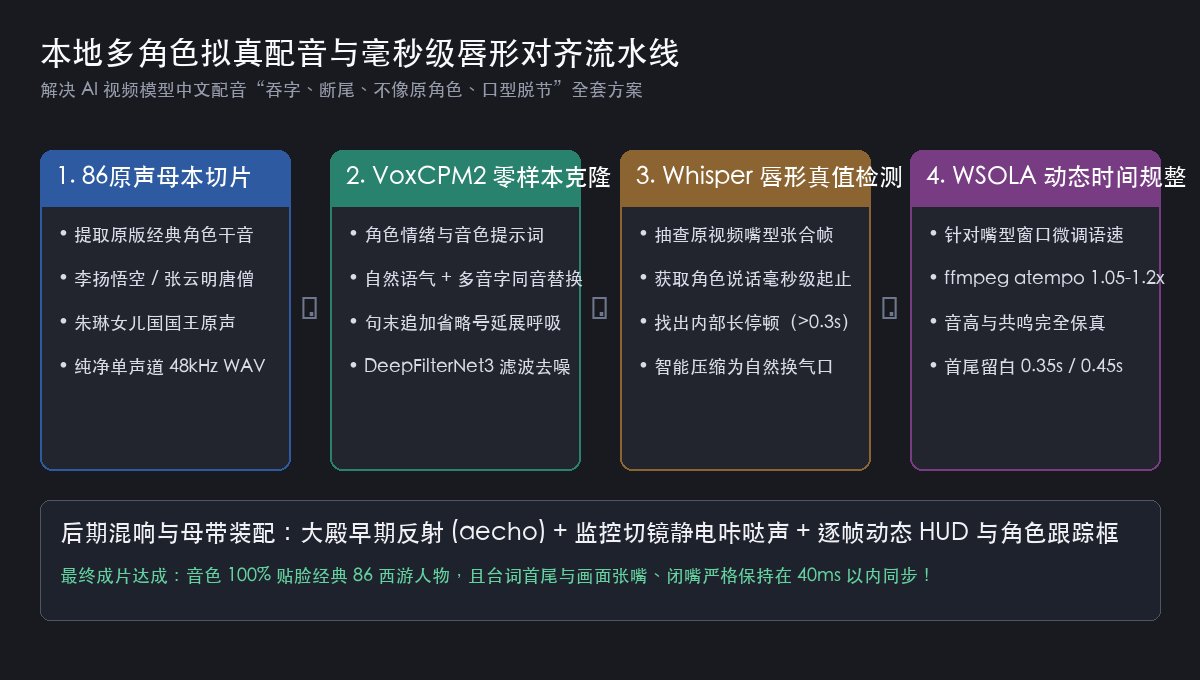
要让合成语音自然贴合画面,需处理好以下五个细节:
用自然语言设定角色音色基底与情绪
VoxCPM2 支持直接通过自然语言控制音色,无需参考音频克隆,还能随剧情分镜切换语气。以下是《西梁国留婚》四个角色的音色设定表:
| 角色 | 音色与年龄基底 | 随剧情变化的表演指令 |
|---|---|---|
| 女儿国女王 | 30 岁成熟尊贵古装女性,声线温婉磁性,普通话字正腔圆 | 第一镜温柔深情,略带笑意;第四镜压低声音威严质问;第五镜柔中带刚,干脆果断 |
| 唐僧 | 28 岁年轻俊朗古装书生僧人,嗓音温润清亮,吐字清晰 | 表面礼貌克制,语气心虚慌乱,语速偏快,急于辩解 |
| 孙悟空 | 机灵洒脱的青年男性声线,音色清脆明亮,富有穿透力 | 语气俏皮,一眼看穿真相,说话干脆利落,带看热闹的笑意 |
| 太师 / 猪八戒 | 45 岁精明干练女官 / 憨厚偏低沉男声 | 太师一板一眼冷面拆台;八戒慢半拍,憨直委屈 |
在台词末尾添加省略号防止吞尾音
语音生成模型遇到句号时常会提前收气,导致“清楚”的“楚”、“松开呀”的“呀”等句尾轻声字变弱甚至被截断。在送入模型的文本末尾加上 ……(例如 "贫僧刚才没说清楚……"),模型读完最后一个字后会自然留出 0.25 秒的气息衰减,保持尾音完整。
用 Whisper 双重质检并保护塞擦音
每生成一条配音,Gemini 4 都会自动调用 mlx-whisper 听写校验:
- 核查字词准确率:检查是否存在漏字、多字或多音字误读,发现异常立即换随机种子重新生成。
- 核查首尾时间边界(保护塞擦音闭塞段):中文里的
c / ch / q / x / s / sh(如“清楚”的“楚”)发音前存在约 50 毫秒的无声闭塞段。若按常规静音阈值直接裁剪,容易把最后一个字切掉。脚本需以 Whisper 识别出的末字结束时间为基准,向后保留 0.26 秒余音淡出。
叠加室内早期反射混响与环境底噪
语音模型直出的干音带有明显的近讲录音棚质感,直接合成到大殿监控画面里会像画外音。合成音轨时,可让 Gemini 4 调用 ffmpeg 添加轻微的室内早期反射混响(aecho=0.85:0.82:22|48:0.14|0.07),并在底层铺入压低音量的原片环境底噪,使人声融入空间环境。
毫秒级唇形同步与语速微调
配音贴回画面后若出现口型脱节,通常有两个原因:一是生成音频在分句间留下了超过 1 秒的静音停顿,拉长了整句时长;二是前句超时,挤占了后续角色的开口时间窗。
处理时先用 Whisper 提取原视频角色张嘴与闭嘴的时间节点,再用脚本将分句间大于 0.25 秒的空白压缩为 0.14 秒的自然换气停顿。若总时长仍偏长,可调用 ffmpeg 的 atempo 滤镜做 1.05~1.15 倍无损变速,在不改变音调的前提下让台词起止贴合人物唇动。
让 Gemini 4 自动执行全片重配音与时间轴同步的提示词:
原视频的画面已经就绪,但模型直出的中文配音有咬字不清和尾音截断问题。
请调用我本机的 VoxCPM2(或 VoiceStudio)+ DeepFilterNet3 + Whisper,编写脚本为全部 5 镜生成多角色配音并替换合成:
1. 角色音色设计:为每个角色设定固定的年龄、声线基底,并根据每句台词的剧情处境写入具体的情绪语气描述。
2. 多音字与防吞尾处理:把容易读错的多音字替换为同音单音字(如“为师”改为“维师”),每句送入模型的文本末尾加上“……”延长尾音呼吸,并在音频末尾拼接 0.45 秒静音缓冲。
3. Whisper 自动质检与防误切:每条语音生成后用 Whisper 识别校验字准,裁剪尾部静音时必须以 Whisper 最后一个词的结束时间为基准向后保留 0.26 秒自然衰减,严禁在塞擦音(如“清楚”的“楚”)前的闭塞段提前切断。
4. 时间轴对齐与空间混响:对照原视频角色开口的时间窗口,将配音精准落位(语速偏差超过 8% 时微调语速或延长镜头首尾静止帧),加入轻微的室内早期反射混响与监控频段滤波,与低音量环境底噪混合输出。
2.6 代码后期包装:绘制监控界面、补齐留白与合成母带
制作监控风格或特效包装时,如果直接在视频提示词里要求 AI 生成文字和边框,往往会出现字符扭曲和边框跳动。凡涉及文字字幕、监控边框与动态时间码的元素,统一交给 Gemini 4 编写 Python(PIL 图像库)与 ffmpeg 脚本逐帧绘制,可保证 100% 清晰稳定。
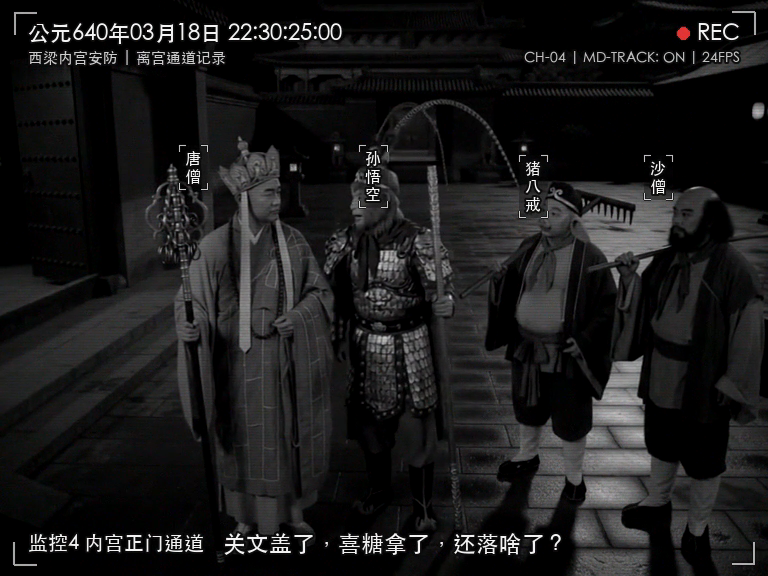
以《西梁国留婚 · 监控实录》为例,Gemini 4 用不到 200 行 Python 代码完成了以下全部后期包装:
- 监控四角边框与暗角:画面四周绘制半透明白色直角取景框,叠加轻微镜头暗角与扫描线。
- 左上角机位名与右上角动态时间码:左上角绘制闪烁红点
● REC | 西梁女国·金銮殿 [CAM-01],右上角按帧跳动日期与时间码。 - 画面内的人物状态识别框:在角色身上绘制半透明跟踪框,例如在唐僧头顶标注
[目标:御弟哥哥 | 心率:148 bpm | 状态:嘴硬手诚实],强化监控喜剧反差。 - 底部高对比度字幕:绘制深色半透明衬底条与带角色名的中文字幕,严格按 Whisper 提取的每句台词起止时间显示。
- 切镜静电咔哒声:在相邻监控镜头切换的 0.15 秒处合成静电咔哒音效,将 5 段独立视频衔接为完整成片。
让 Gemini 4 编写后期包装与母带合成脚本的提示词:
请用 Python(PIL / numpy)配合 ffmpeg 为这 5 段视频编写全自动后期包装与母带合成脚本:
1. 镜头首尾呼吸留白:检查每段视频第一句台词的开口时间与最后一句台词的结束时间,使用 tpad 滤镜克隆首尾帧,确保每镜开头至少有 0.35 秒环境铺垫、结尾至少有 0.45 秒表情定格余韵。
2. 逐帧绘制高清 UI 图层(1920x1080):
   - 左上角绘制闪烁红点 REC 与当前机位名称、画面模式(常规彩色 / 红外夜视)。
   - 右上角绘制按帧递增的实时监控时间戳与帧率标识。
   - 四角绘制监控取景直角线与轻微扫描线质感。
   - 画面底部绘制圆角半透明深色字幕条,严格按照每句配音的真实起止时间显示“角色名:台词内容”,无台词时段不显示空字幕条。
3. 切镜转场与成片拼接:在每两镜交界处加入 0.12 秒的监控切镜静电咔哒声,将 5 段单镜母带(master_cut_01.mp4 - 05.mp4)无损拼接为最终成片 final_master.mp4。
4. 完成后在成片的关键台词切点和转场处抽帧,检查字幕是否对齐、画面有无黑帧。
2.7 成片抽帧复核与经验归档
成片合成后先不要急于发布。制作过程中反复观看分镜容易产生视觉盲区,忽略局部穿帮或字幕时间偏移。此时可让 Gemini 4 切换为初次看片的观众视角,对最终成片执行全片抽帧与音画波形检查。
成片抽帧复核的提示词:
这是刚合成出来的最终成片:[成片路径]。请你当作第一次看到这支视频,对它做一次全面体检:
1. 从头到尾按每秒 2 帧抽图,并在每次切镜前后各取 3 帧,同时读取音频波形与字幕时间轴。
2. 逐镜核查:
   - 画面:有没有废帧、黑帧、人物脸部崩坏、多余的手指或画面边缘畸变?
   - 声音:有没有哪句台词结尾被切半截、音量忽大忽小、或者两句台词之间撞车重叠?
   - 字幕与UI:字幕出现的时间和人声开口时间是否严丝合缝?文字有没有错别字或压住人物关键动作?
3. 把发现的问题分为“必须修的硬伤”和“可优化的细节”,修完后再把这次做片子踩过的坑整理成一份经验文档存进项目目录。
三、“导演 + 质检”双角色协同工作流
单开一个长对话连续制作视频时,随着上下文拉长,模型容易遗忘最初约定的规则(例如画面禁出文字或特定角色的服装颜色)。关于多智能体职责隔离的架构设计,也可对照阅读 《卡兹克:折腾了整整 1 年的 Agent 自动化系统》。
使用 Gemini 4 制作短片时,建议采用“主创制作 + 独立质检”的分工模式。在定剧本、审提示词与查验音画成片等节点,让模型按以下四项职责分别执行:
| 职责角色 | 具体负责内容 |
|---|---|
| 总导演(主做) | 编写剧本和分镜,操控浏览器生成视频,编写脚本完成配音与后期合成 |
| 剧本与画面审核 | 只挑刺不改文件,提交生成前逐条核对提示词是否遗漏角色外貌描述或触碰模型短板 |
| 声音与字幕质检 | 用 Whisper 和音频能量分析检查配音是否存在吞尾音、多音字误读或字幕时间轴偏移 |
| 需求备忘监督 | 将全部创作约束(如“学思路不抄袭”与“保留所有历史版本”)整理成常驻清单,每阶段逐项核对 |
你可以将下方总控指令发给 Gemini 4,由它按这套规范统筹整支短片的交付:
这支视频我们按“主创制作 + 独立质检”的流程来跑,请你统筹完成,直到最终成片交付:

1. 需求清单常驻:先把我交代过的所有创作要求整理成一份《项目铁律清单》存在项目目录下,每推进一个阶段都对照核查一遍,防止遗忘。
2. 提交生成前必审:写好分镜和视频提示词后,先按审核标准自查一遍(人物外貌词是否统一、同一时间是否只有一人说话、结尾是否留出 1.5 秒定格、是否写明无字幕无UI),确认无误再去浏览器提交生成。
3. 声音字字过关:每一句后期配音生成后,必须跑一遍 Whisper 识别与尾音能量检测,确保没有错字、漏字和尾音截断,达标后才能进入合成。
4. 留存全部资产:生成的所有视频片段、配音干音、分镜稿和后期脚本全部按版本号归档保存在项目文件夹里,方便随时回退或微调。
AI 视频模型迭代很快,但叙事反差设计、固定机位分镜控制,以及用本地语音模型和 Python 脚本补齐生成短板的工程方法始终通用。你可以直接复制上方的提示词模板,或通过下方工作台生成定制参数开始测试。
四、交互工作台:AI 剧组开机参数生成与 ffmpeg 参数速查
我想做一支 AI 视频,初步想法是:[用现代高清安防监控视角拍 86 版西游记《西梁国留婚》,共 5 个固定机位,单镜 12 秒,总长约 60 秒]。
参考片亮点:[极其现代严肃的安防监控画面(带红外夜视切镜与心率识别框),装进古典端庄却嘴硬手诚实的人物关系,要求学反差思路不抄袭老梗]。

请你先不要写分镜,先帮我打磨剧本大纲和分场剧情:
1. 故事结构:采用 5 个独立固定机位的片段式结构(建议穿插 1 镜夜间红外黑白画面拉开视觉节奏),每段 12 秒,最终在最后一镜完成大反转。
2. 戏剧反差:每一镜都要遵循“表面一本正经 → 手上小动作穿帮 → 旁人一句话点破”的喜剧节奏,用具体的肢体动作制造笑点,不要靠干聊。
3. 规避模型弱点:每镜画面不超过 3 人,同一时刻只有 1 人开口说话,不出现多人打斗缠抱、吃喝吞咽或复杂手指特写。
4. 台词与防腰斩要求:口语化、接地气,每镜台词控制在 2-3 句(总字数 28-36 字以内),必须在第 10.5 秒前说完,最后 1.5 秒保持表情定格与眼神交锋,画面纯净无任何文字与 UI 边框。

请先输出 5 镜的剧情梗概、30 字角色固定外貌锁死词、每镜核心包袱和台词初稿。安全公司 AI 研发工程师、讲师,计算机硕士,发表多篇专利与 SCI 论文,专注 AI 工程落地、多模态工作流与开源项目分享。