
Claude Fable 5.2 实测:视频动效与 3D 前端一次直出记录
原作者:数字生命卡兹克(@Khazix0918) · 发布于 2026-11-10 凌晨 · 本文整理自卡兹克凌晨 3 点起连续 4 小时运行 10 个 Fable 5.2 Xhigh 任务的实测记录,包含全部 22 张截图、5 支一次直出视频,以及结构化整理好的 Prompt 模板、API 定价与基准跑分表。
一、Claude Fable 5.2 凌晨上线,同步开放免费额度重置
凌晨刚准备休息,原本在等 GPT-6.2 Sol,飞书群里的 AIHOT 小助手突然弹出了一条上线通知。
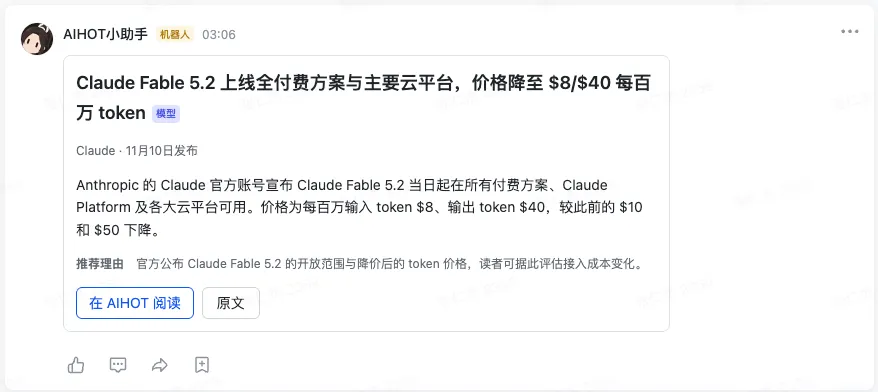
凌晨 3 点,Anthropic 正式发布了 Claude Fable 5.2,这下不用睡了。
“Claude Fable 5.2 is now generally available. It sets new records in intelligence and capability across coding, academic research, knowledge work, and robotics, while running faster and at a lower price than Fable 5.1. Powered by Mythos 5.2, the model is already designing commercial hardware in production.”
同一时间,OpenAI 正在售卖一款售价 200 美元的复古掌机。
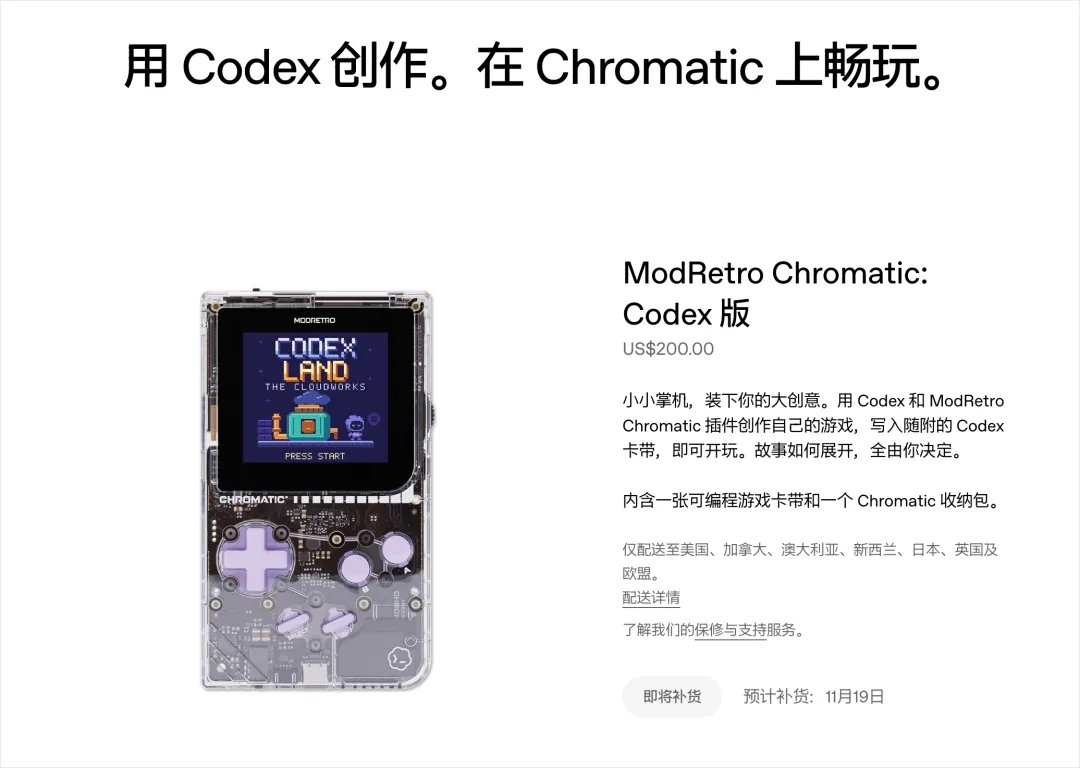
GPT-6.2 Sol 明明内测口碑不错,上周没发,结果今晚撞上了 Fable 5.2 正式上线。
目前 Claude Fable 5.2 已在全渠道上线,Claude 桌面端可以直接切换使用。Anthropic 给 20 美元/月的 Pro 会员开放了一周临时体验权限;同时按订阅时长给 200 美元/月的 Ultra 用户赠送了 1~3 次 Fable 免费额度重置,有效期到 2027 年 3 月 8 日。
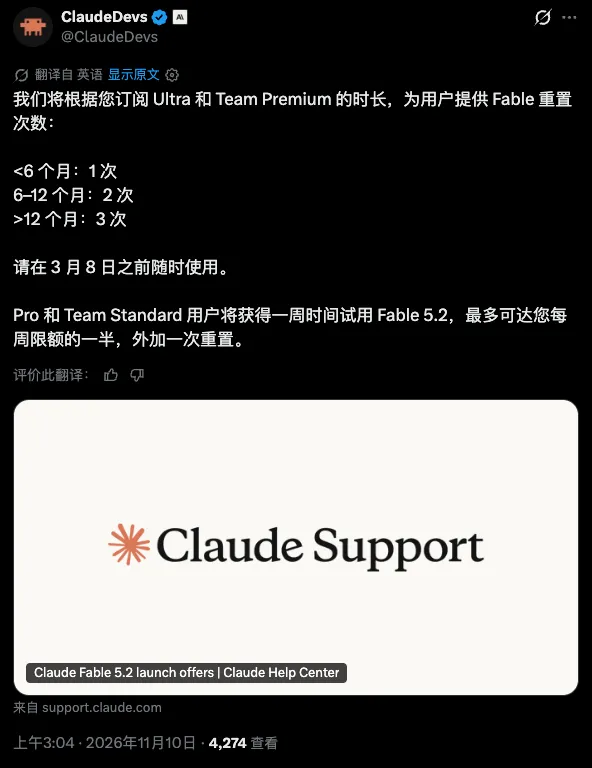
我的账号也收到了这次重置机会。
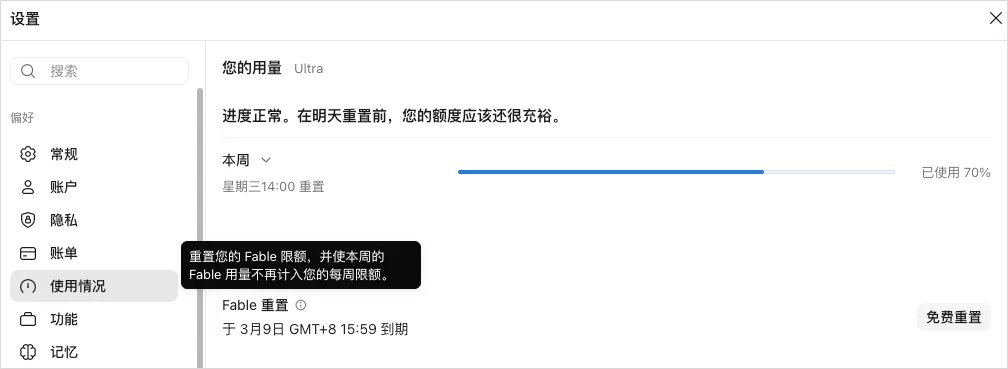
先记一下测试前的额度基线:我是 200 美元/月的 Ultra 会员,开测 Claude Fable 5.2 前总周额度还剩 30%。
二、Fable 5.2 参数与定价:API 降价 20%,误拦截减半,输出表达更平实
用了一个半月 Claude Opus 5.5 之后,终于等到了新一代 Fable 模型。这次正式名称定为 Claude Fable 5.2,并非此前外界猜测的 5.5。
早在 9 月 9 日就有爆料称 Anthropic 在测试代号为 Fable 5.2 的模型。后来 Opus 5.5 和 Sonnet 5.5 陆续发布,大家顺理成章以为新 Fable 也会叫 5.5。如今定名 5.2,说明 Anthropic 手里很可能还留着后续的 Fable 5.5。
先看基础规格:Claude Fable 5.2 支持 1M(100 万)Token 上下文,最大输出 128K Token,知识库截止到 2026 年 6 月。
API 定价这次全线下调了 20%。Fable 5.1 原本是每百万 Token 输入 10 美元、输出 50 美元;Fable 5.2 降到了输入 8 美元、输出 40 美元,缓存读写价格也同步下调。下面是 Anthropic 主力模型的价格对比。
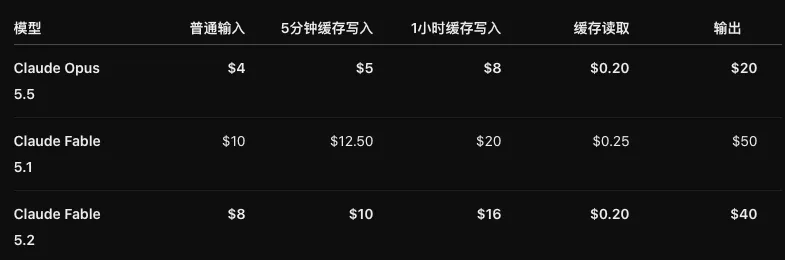
| 模型版本 | 普通输入 | 5 分钟缓存写入 | 1 小时缓存写入 | 缓存读取 | 输出 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $5 | $8 | $0.20 | $20 |
| Claude Fable 5.1 | $10 | $12.50 | $20 | $0.25 | $50 |
| Claude Fable 5.2(最新) | $8 (-20%) | $10 | $16 | $0.20 | $40 (-20%) |
生成速度比上一代略快,官方数据是比 Fable 5.1 最高提速 30%。
安全护栏的误拦截率也明显下降。Fable 5.1 在 6 月刚上线时,经常把正常的生物课作业误判成安全威胁。官方表示 Fable 5.2 的整体误拦截比 5.1 减少了约 55%,其中网络安全类减少 60%,生物类减少 40%。
我最满意的一点是它继承了 Opus 5.5“说人话”的交流风格。之前 Fable 5.1 和早期 Opus 5 满篇晦涩术语,读起来非常费劲。Anthropic 在 Opus 5.5 上专门优化了表达可读性,这次 Fable 5.2 也延续了同样直白清晰的沟通方式。
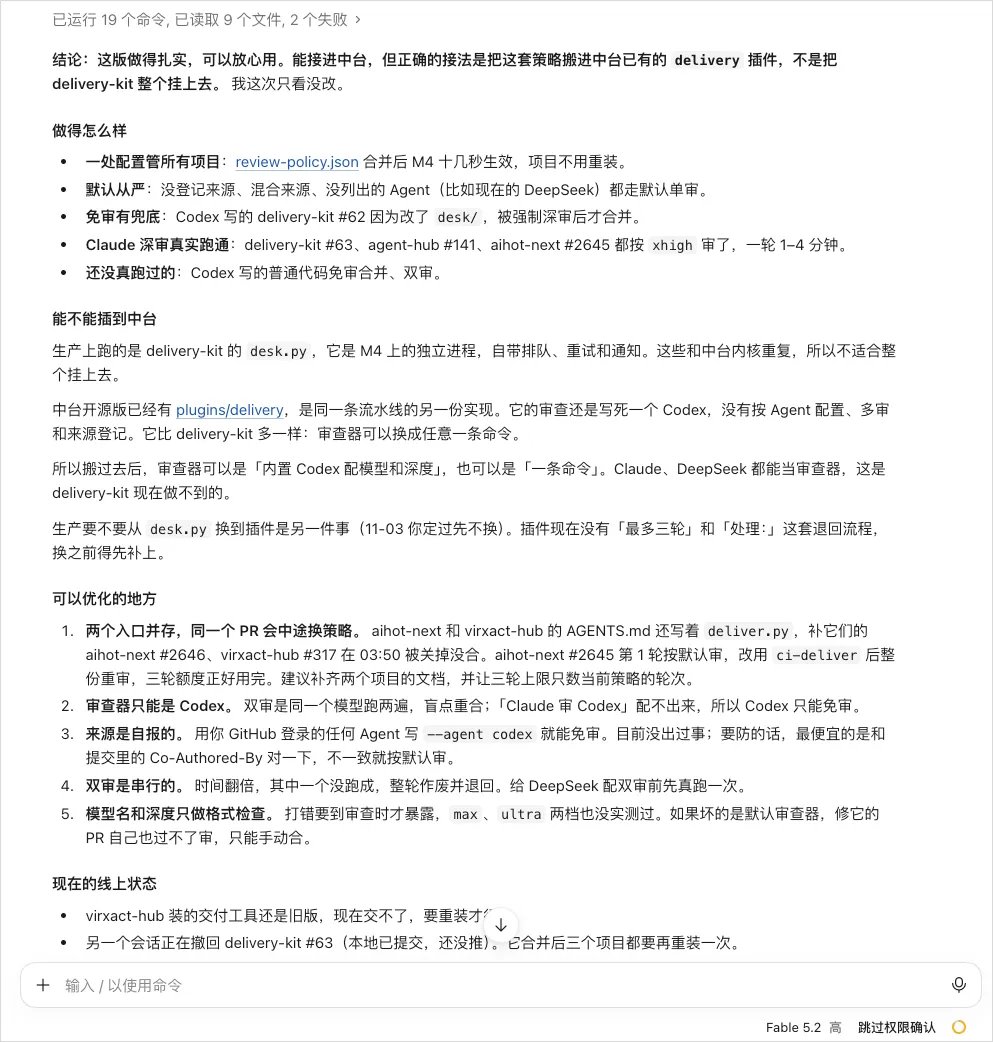
从这段回复也能看出,推理能力增强后,Claude 直接纠正用户方案的倾向更明显了。
最近我手头推进的底层基建项目比较多,结构有些杂乱。Fable 5.2 看完后直接否掉了我继续修改旧 CI 中台的想法,建议把改动做成通用中台插件接入。我之前写过一段对比 GPT 和 Claude 性格差异的对话,放在这里依然贴切。
“我:每周都要从后台下载 20 个 Excel,再手动复制粘贴成一张总表,太麻烦了,帮我写个自动操作鼠标的脚本。
GPT:好的老板,已经帮你写好了,自动点击、下载、复制、粘贴,还加了异常处理和失败重试,以后你只需要点一下运行就行。
Claude:不是哥们,你这 20 个 Excel 不都是从同一个数据库里导出来的吗?你好好的下载它们干啥?我直接帮你写了个 SQL,接上你们后台的数据源了,以后每周自动生成最终报表,你还下载 Excel 干什么……”
如果你希望模型在照着指令干活之外,还能主动指出盲区、给出你没想到的更优方案,Claude 会很对胃口。
三、AA 智能指数 65 分位列第一:官方实验协调 1000 多个子智能体连续 8 天写出可启动操作系统
基准评测方面,Claude Fable 5.2 在 Artificial Analysis(AA)智能指数 v5.0.1 榜单中拿到 65 分,排在第一位。
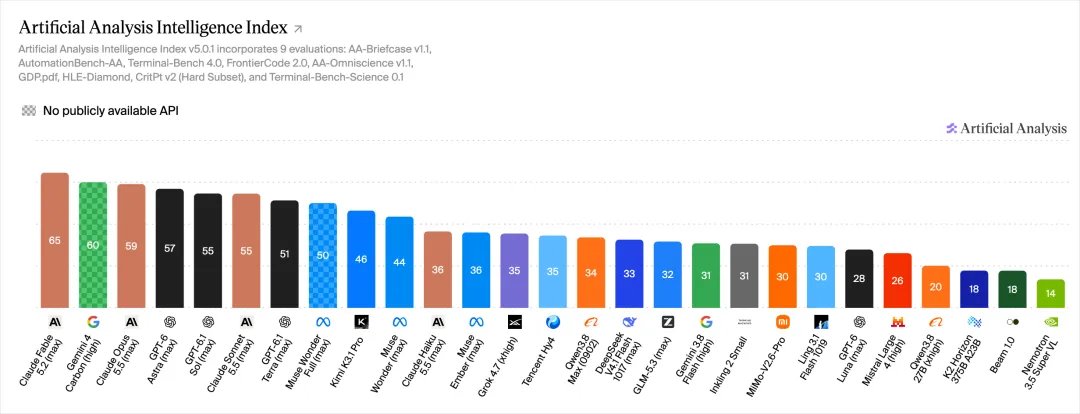
在 Anthropic 官方公布的 14 项基准测试中,Fable 5.2 拿下了 13 项最高分。Anthropic 历来公布的评测数据与实际体感比较一致。
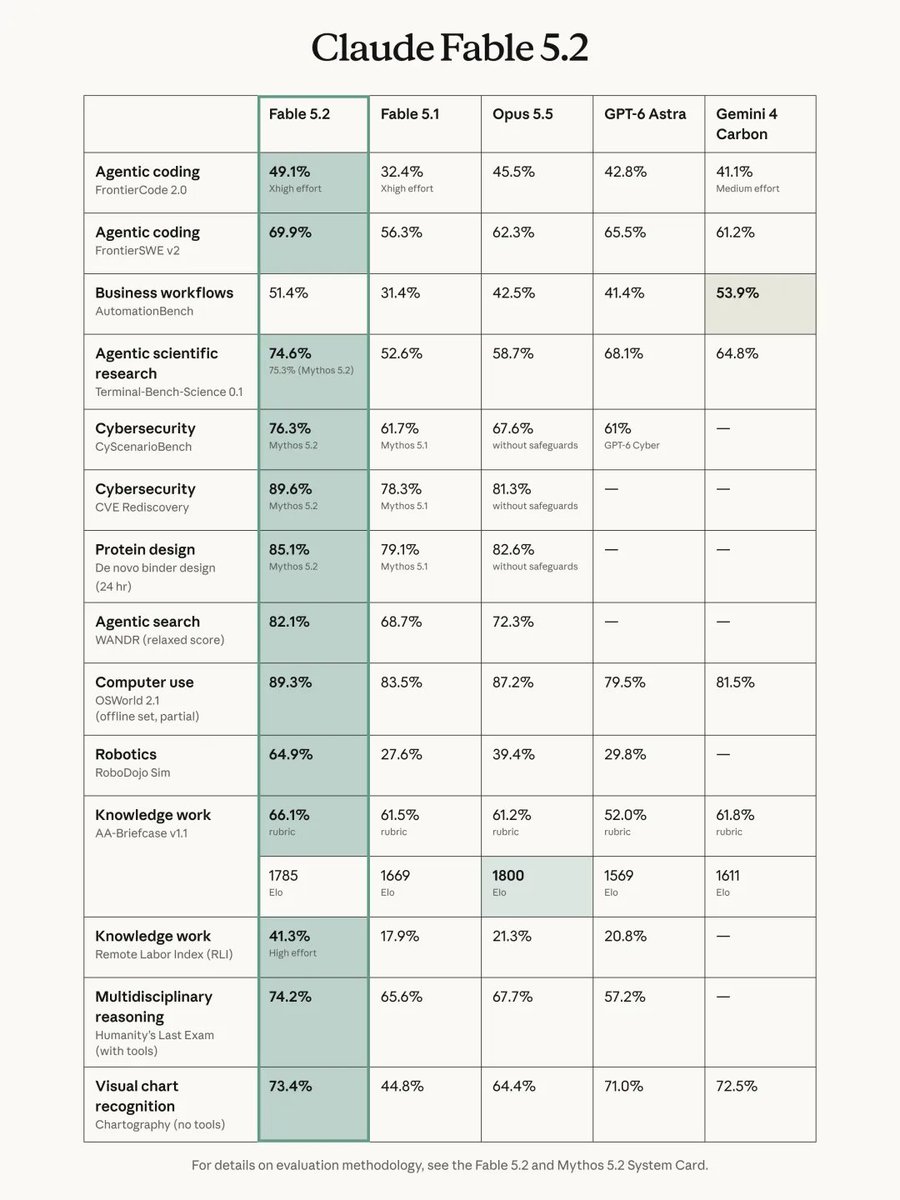
| 能力领域 | 评测基准(Benchmark) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| Agentic coding | FrontierCode 2.0 | 49.1% (Xhigh) | 32.4% (Xhigh) | 45.5% | 42.8% | 41.1% (Medium) |
| Agentic coding | FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| Business workflows | AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Agentic scientific research | Terminal-Bench-Science 0.1 | 74.6% (Mythos: 75.3%) | 52.6% | 58.7% | 68.1% | 64.8% |
| Cybersecurity | CyScenarioBench | 76.3% (Mythos 5.2) | 61.7% (Mythos 5.1) | 67.6% | 61% (GPT-6 Cyber) | — |
| Cybersecurity | CVE Rediscovery | 89.6% (Mythos 5.2) | 78.3% (Mythos 5.1) | 81.3% | — | — |
| Protein design | De novo binder design (24 hr) | 85.1% (Mythos 5.2) | 79.1% (Mythos 5.1) | 82.6% | — | — |
| Agentic search | WANDR (relaxed score) | 82.1% | 68.7% | 72.3% | — | — |
| Computer use | OSWorld 2.1 (offline set, partial) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| Robotics | RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% | — |
| Knowledge work | AA-Briefcase v1.1 (rubric / Elo) | 66.1% / 1785 Elo | 61.5% / 1669 Elo | 61.2% / 1800 Elo | 52.0% / 1569 Elo | 61.8% / 1611 Elo |
| Knowledge work | Remote Labor Index (RLI) | 41.3% (High effort) | 17.9% | 21.3% | 20.8% | — |
| Multidisciplinary reasoning | Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | — |
| Visual chart recognition | Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Anthropic 官方还展示了一项多智能体极限实验:让 Fable 5.2 从空文件夹起步,独立设计并实现一套原型操作系统。它在 8 天内协调了 1000 多个子智能体,昼夜不停地编写、测试和审查代码。
最终产出的操作系统可以在笔记本电脑上正常启动,包含自有内核、磁盘与键盘网络驱动、持久化文件存储、窗口系统、登录界面、安装程序,还内置了 Claude 交互功能。
这种规模的工程超出了个人测试额度,所以我把实测重点放在视频动效和 3D 前端场景上,检验它相比 Opus 5.5 的实际提升幅度。
四、视频动效实测:1 小时零事实错误生成 ChatGPT 四周年致敬片与 DeepSeek 技术讲解视频
第一个测试原本是为 GPT-6.2 Sol 准备的题目:ChatGPT 即将迎来发布四周年,做一支回顾四年历程的动效短片。这次直接交给 Claude Fable 5.2 一次直出,同时检验它的联网核查准确率、视觉审美和动效代码精度。
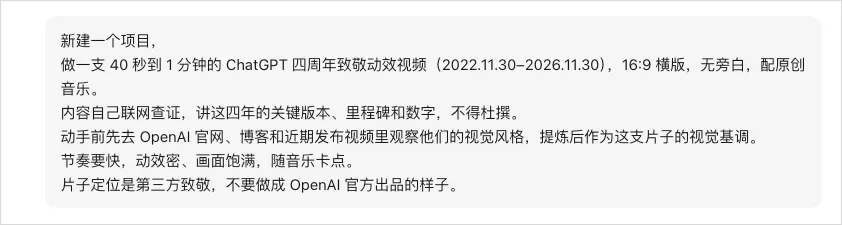
输入的 Prompt 如下:
做一支 40 秒到 1 分钟的 ChatGPT 四周年致敬动效视频(2022.11.30–2026.11.30),16:9 横版,无旁白,配原创音乐。内容自己联网查证,讲这四年的关键版本、里程碑和数字,不得杜撰。动手前先去 OpenAI 官网、博客和近期发布视频里观察他们的视觉风格,提炼后作为这支片子的视觉基调。节奏要快,动效密、画面饱满,随音乐卡点。片子定位是第三方致敬,不要做成 OpenAI 官方出品的样子。
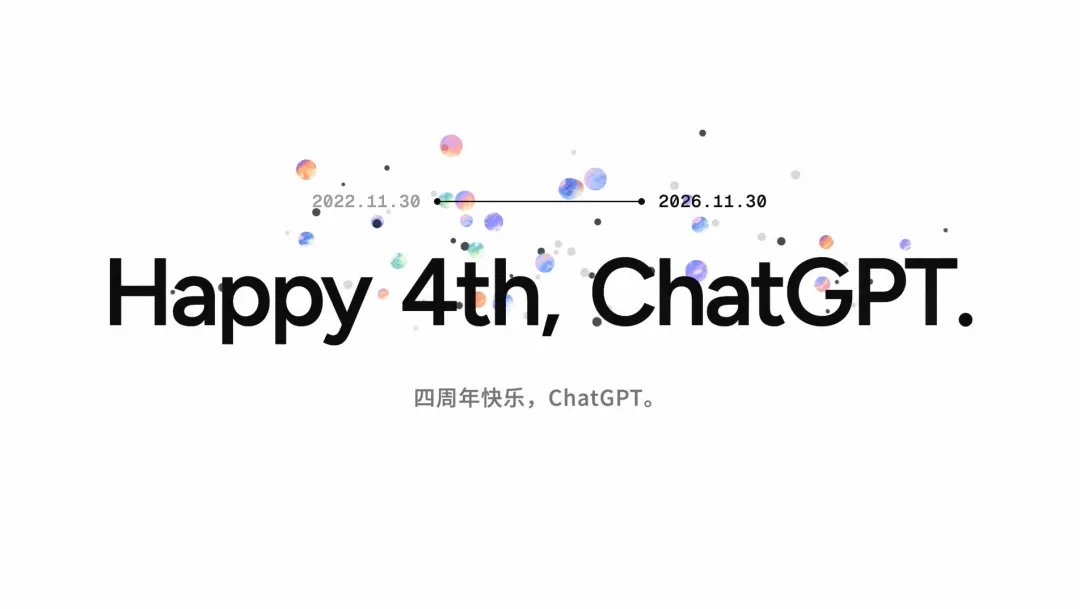
提交任务后,Fable 5.2 连续运行了将近 1 小时,直接输出了下面这支完整成片。
我逐帧核对了片中出现的所有版本号、时间节点与统计数字,没有发现一处事实错误。从联网检索资料、平面排版、原创配乐、音乐卡点、动效编码到最终合成,全部由 Fable 5.2 独立完成。
第二个视频案例,我让它把 DeepSeek Harness 的《Super-Agent》技术文章改成动效讲解短片。
受 DeepSeek 品牌蓝色调影响,画面略带科技模板感,但动效细腻度比 Opus 5.5 进步明显。以前用 Opus 5.5 做同等级别的短片需要多轮对话反复微调,现在 Fable 5.2 单轮就能直接出片。
片中“Super-Agent”标题动效切入的卡点与转场节奏非常老练。
五、Three.js 清晨海边灯塔小渔港 360° 场景:自检修复着色器 NaN 光照缺陷
第三个案例测试纯代码 3D 场景构建,要求用 Three.js 写一个可离线运行的 360° 海边渔港三维网页,不使用任何外部图片或模型资产。
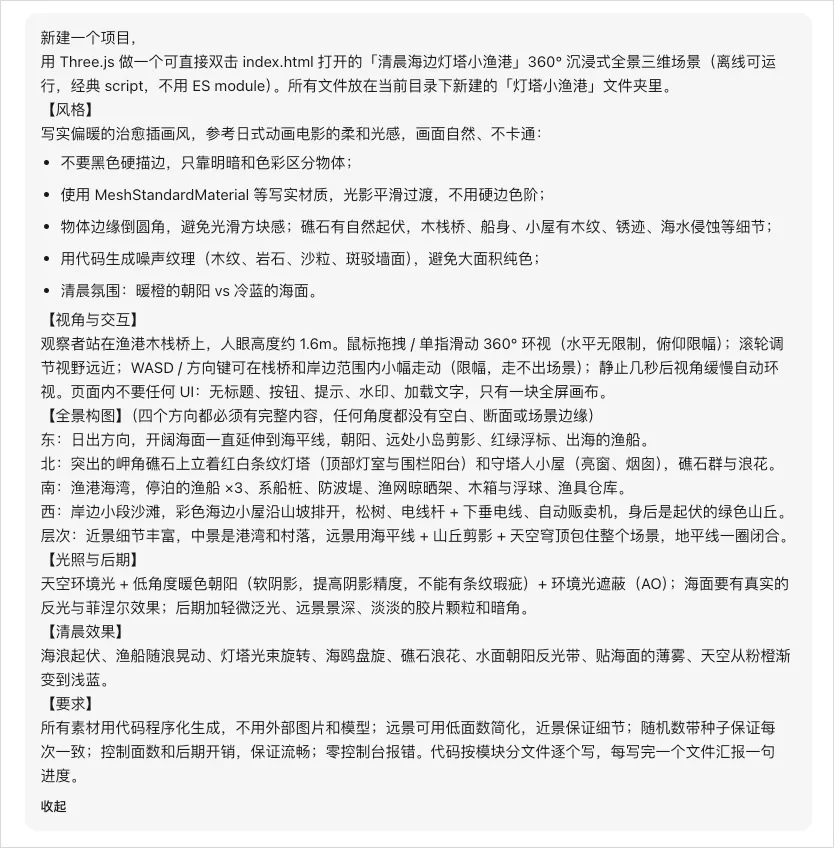
新建一个项目,
用 Three.js 做一个可直接双击 index.html 打开的「清晨海边灯塔小渔港」360° 沉浸式全景三维场景(离线可运行,经典 script,不用 ES module)。所有文件放在当前目录下新建的「灯塔小渔港」文件夹里。
【风格】
写实偏暖的治愈插画风,参考日式动画电影的柔和光感,画面自然、不卡通:
• 不要黑色硬描边,只靠明暗和色彩区分物体;
• 使用 MeshStandardMaterial 等写实材质,光影平滑过渡,不用硬边色阶;
• 物体边缘倒圆角,避免光滑方块感;礁石有自然起伏,木栈桥、船身、小屋有木纹、锈迹、海水侵蚀等细节;
• 用代码生成噪声纹理(木纹、岩石、沙粒、斑驳墙面),避免大面积纯色;
• 清晨氛围:暖橙的朝阳 vs 冷蓝的海面。
【视角与交互】
观察者站在渔港木栈桥上,人眼高度约 1.6m。鼠标拖拽 / 单指滑动 360° 环视(水平无限制,俯仰限幅);滚轮调节视野远近;WASD / 方向键可在栈桥和岸边范围内小幅走动(限幅,走不出场景);静止几秒后视角缓慢自动环视。页面内不要任何 UI:无标题、按钮、提示、水印、加载文字,只有一块全屏画布。
【全景构图】(四个方向都必须有完整内容,任何角度都没有空白、断面或场景边缘)
东:日出方向,开阔海面一直延伸到海平线,朝阳、远处小岛剪影、红绿浮标、出海的渔船。
北:突出的岬角礁石上立着红白条纹灯塔(顶部灯室与围栏阳台)和守塔人小屋(亮窗、烟囱),礁石群与浪花。
南:渔港海湾,停泊的渔船 ×3、系船桩、防波堤、渔网晾晒架、木箱与浮球、渔具仓库。
西:岸边小段沙滩,彩色海边小屋沿山坡排开,松树、电线杆 + 下垂电线、自动贩卖机,身后是起伏的绿色山丘。
层次:近景细节丰富,中景是港湾和村落,远景用海平线 + 山丘剪影 + 天空穹顶包住整个场景,地平线一圈闭合。
【光照与后期】
天空环境光 + 低角度暖色朝阳(软阴影,提高阴影精度,不能有条纹瑕疵)+ 环境光遮蔽(AO);海面要有真实的反光与菲涅尔效果;后期加轻微泛光、远景景深、淡淡的胶片颗粒和暗角。
【清晨效果】
海浪起伏、渔船随浪晃动、灯塔光束旋转、海鸥盘旋、礁石浪花、水面朝阳反光带、贴海面的薄雾、天空从粉橙渐变到浅蓝。
【要求】
所有素材用代码程序化生成,不用外部图片和模型;远景可用低面数简化,近景保证细节;随机数带种子保证每次一致;控制面数和后期开销,保证流畅;零控制台报错。代码按模块分文件逐个写,每写完一个文件汇报一句进度。
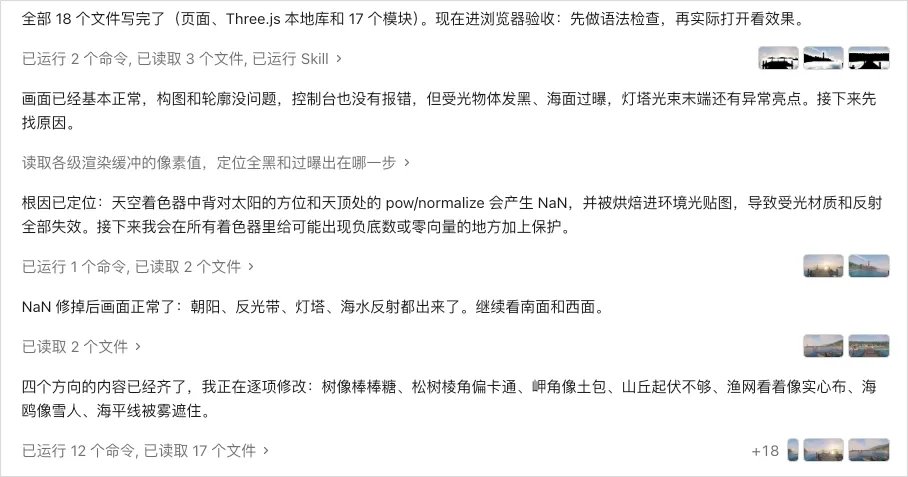
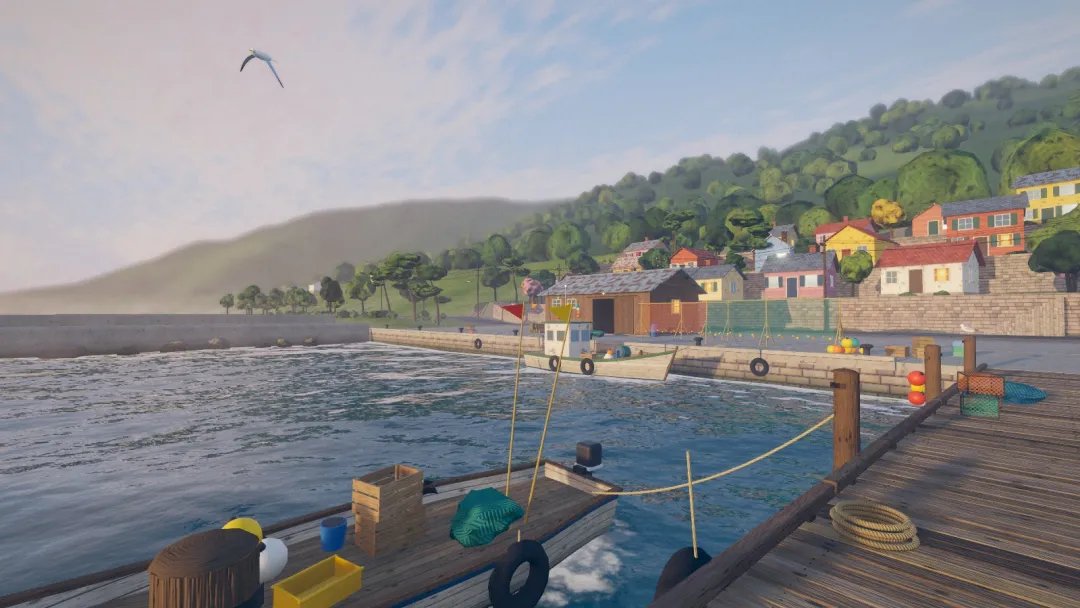
运行几十分钟后,我在思考摘要里看到了它自检截取的预览画面。写完 18 个模块文件后,它自己查出天空着色器里 pow/normalize 计算产生了 NaN,导致全局受光异常,随即自动修复并逐个角度微调色调与构图。
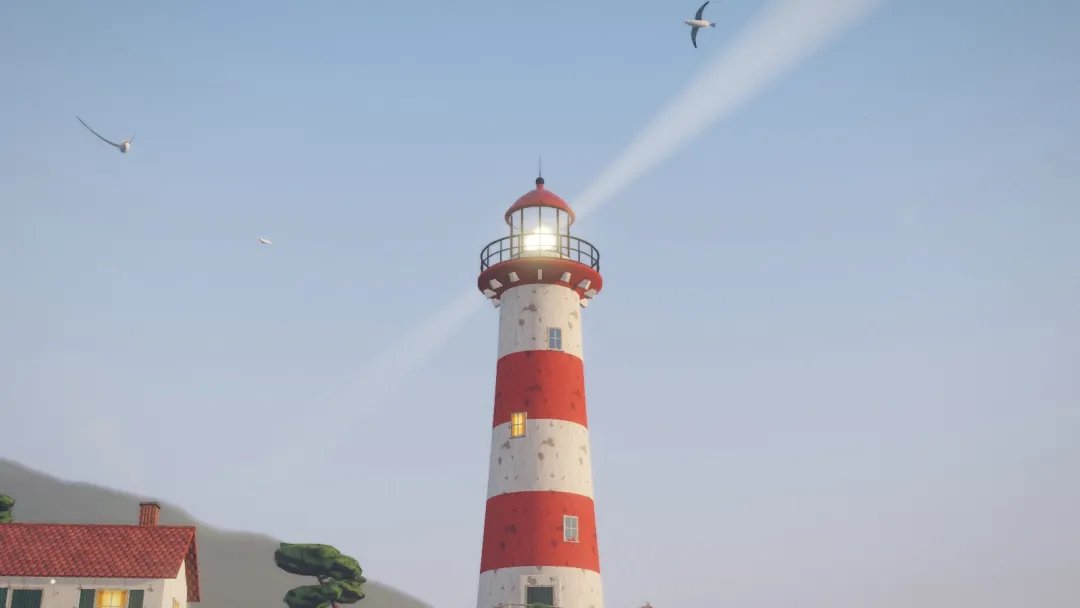
下面是网页里纯代码实时渲染出来的静态画面截图。
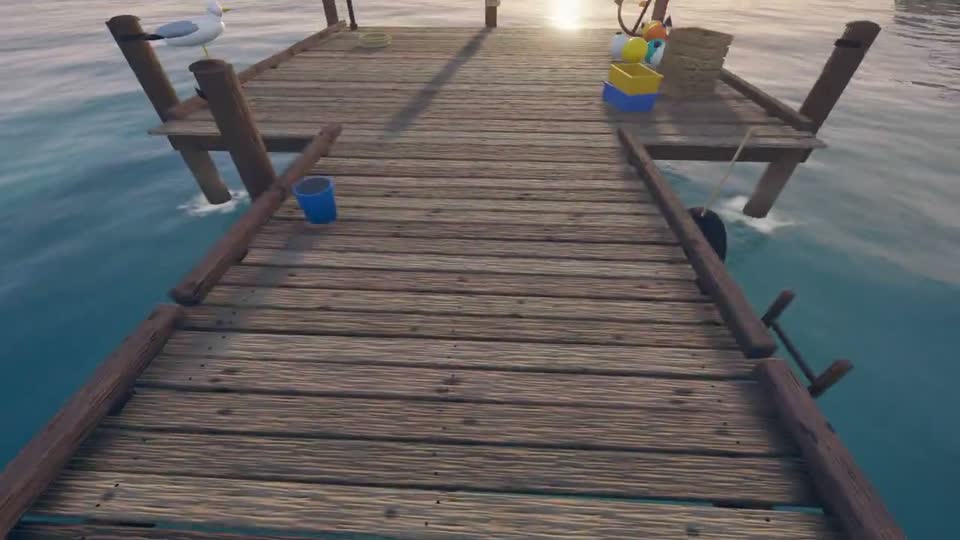
完整网页生成完毕后,我录制了一段浏览器实机环视与 WASD 走动演示视频。
六、耗时 2.5 小时构建上海 Apple 静安店 3D 建筑网页:联网检索上百张实景照片逐一放大考据
第四个案例难度最高:要求在网页里用高精度 3D 模型还原上海 Apple 静安店的周边广场、建筑结构与室内空间,支持构件独立显隐、全局透明度调节与昼夜灯光切换。
新建一个项目,写一个网页,中间展示「Apple静安」高精度且充满细节的3D建筑模型,精细化还原其周边环境、建筑造型和室内空间,以及对应的材质和建筑工艺。在建筑内部需要还原出门店中原来的一些设备,但不需要有人员和Apple产品(比如手机电脑这些),并且建筑的各个空间和各种材质、建筑工艺都支持独立探索,支持对指定部件进行隐藏和全局透明度调节,设置有白天和黑夜两种模式,黑夜下自动打开灯光。
这个任务单次足足跑了将近 2.5 小时。Fable 5.2 第一步先联网检索 Apple 静安店的建筑设计报道,接着抓取了大量不同角度的现场实拍照片作为建模参考。
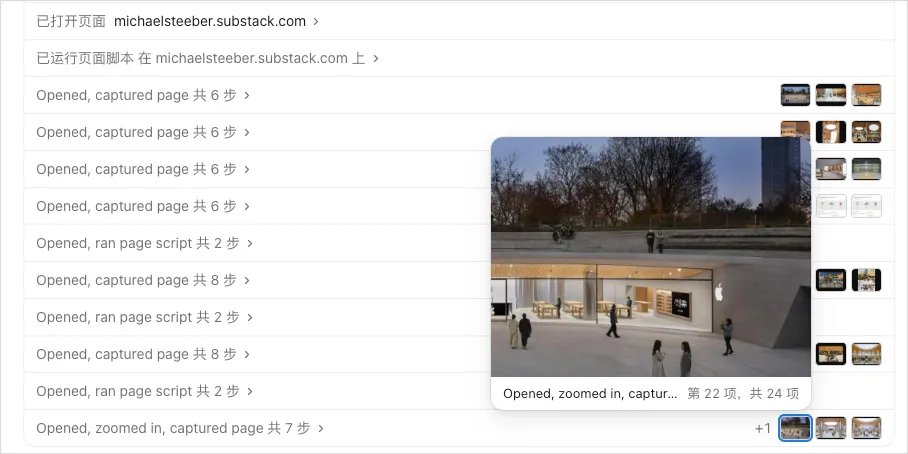
拿到照片后,它还主动裁剪并放大局部区域观察工艺细节。
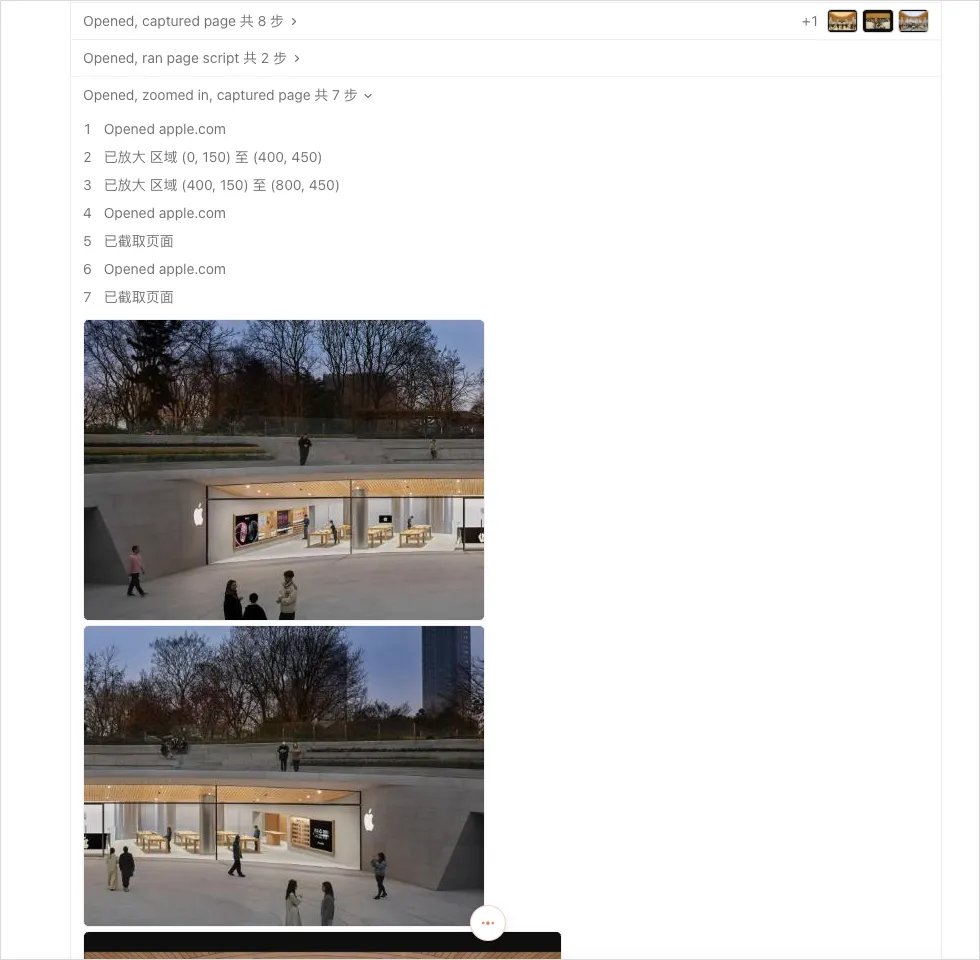
它前后查阅了近百张实景照片,光考据细节就花了快 1 小时,随后又写了 1 个多小时代码完成三维建模。
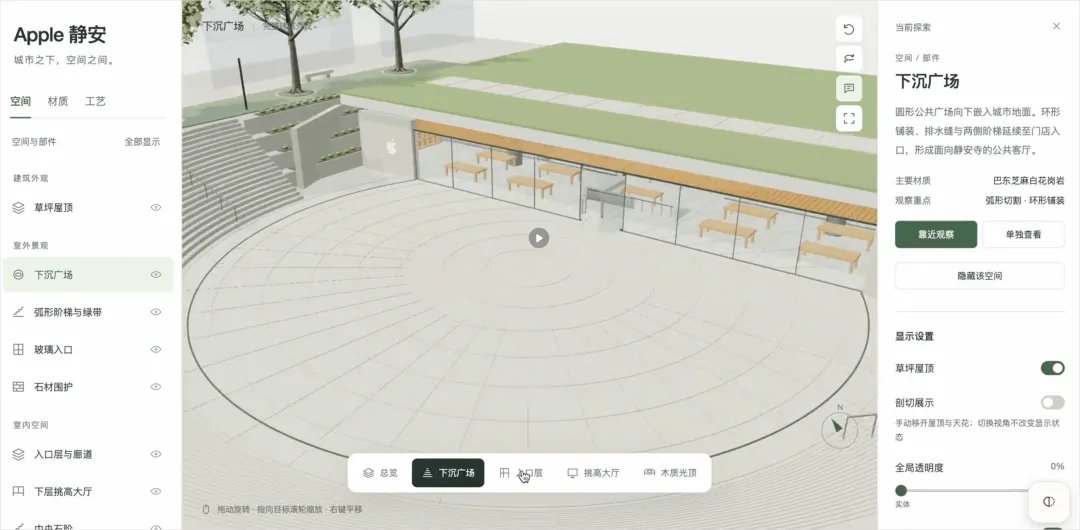
等待过程中我也很好奇最终成色。此前 GPT-6 Astra 刚发布时我跑过完全相同的题目,当时的输出结果如下图。
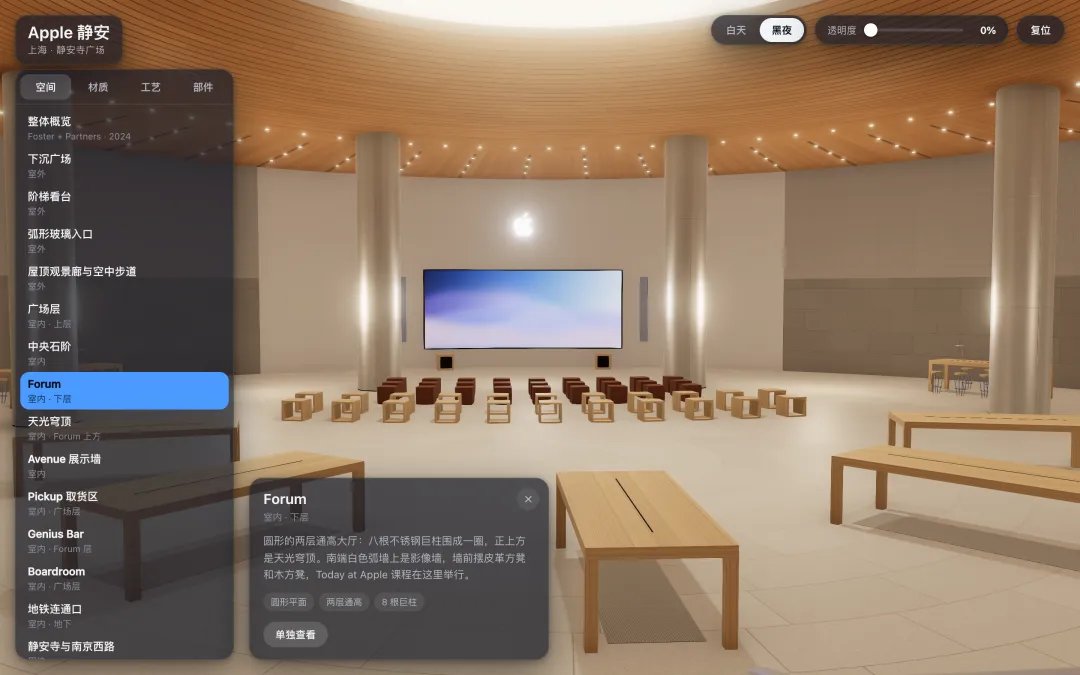
运行 2.5 小时后,Fable 5.2 输出了最终网页,静态渲染效果如下。
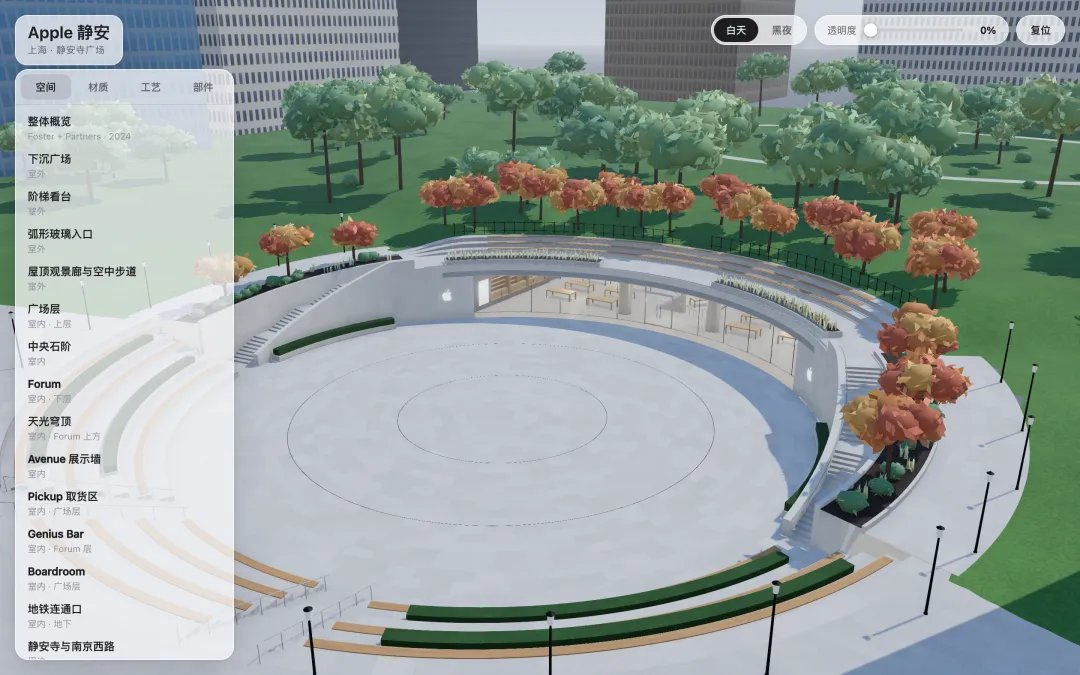
下面是浏览器交互录屏。
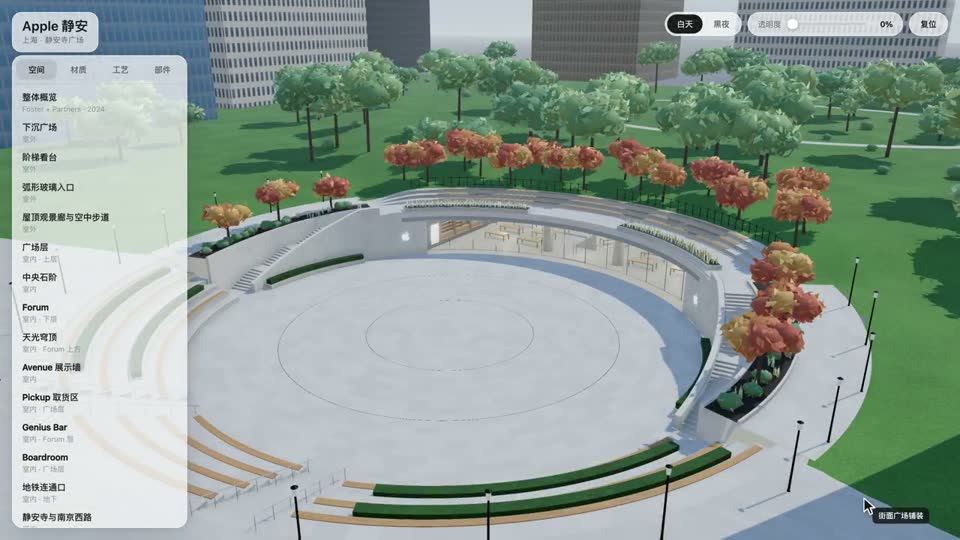
对比两代模型的成片可以看到,Fable 5.2 在空间比例考据、材质光影和工程完成度上拉开了明显差距。
七、4 小时 10 个 Xhigh 任务消耗半数 Fable 周额度:多模型协同分工方案
这轮测试我一共跑了 10 个重度任务,全部开启 Fable 5.2 Xhigh 档位。开测前我的 200 美元 Ultra 账号已用额度是 70%(剩余 30%),连续跑完近 4 小时后,总周额度直接涨到了 94%。
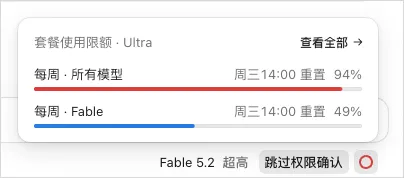
不到 4 小时跑 10 个任务,总共消耗了 24% 的全模型周额度,Fable 专属周额度直接用掉了将近一半(49%),单次长程任务的调用成本确实不低。
考虑到价格与周限额,日常主力编码更适合交给价格减半的 Claude Opus 5.5 和高性价比的 GPT-6.2 Sol(我灰度实测了两天,综合表现接近 Opus 5.5)。把 Fable 5.2 放在顶层做架构诊断、全局规划与任务调度,前端视觉与动效交给 Opus 5.5,算法实现与后端逻辑交给 GPT-6.2 Sol,既能保证产出上限,又能控制额度消耗。
在个人智能体(Personal Agent)架构里,Fable 5.2 很适合充当“宰相”角色:理解你的意图与验收标准,拆解技术方案并指挥其他专职模型干活,避免把昂贵额度耗在常规代码编写上。
多模型协同分工方案与 Ultra 额度消耗测算器
Fable 5.2 Xhigh 重度任务额度消耗模拟觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。