《第一次下载本地大模型,如何看懂 Hugging Face 上的各种参数?》
作者: 雪瑜 @xueyu1125
第一次在 Hugging Face 搜本地模型,很容易产生一种错觉:页面上每个词都认识,连在一起却完全不知道该下载哪个。
以 Qwen3.8-27B 为例,搜索结果里可能同时出现官方版、FP8、4bit、MLX、GGUF、AWQ。点进 GGUF 仓库,又会看到 Q4_K_M、IQ4_XS 等十几个文件。社区教程还会同时提到 Transformers、llama.cpp、Ollama、MLX、MLX-LM 和 MLX-VLM。
我一开始最大的困惑,是把这些词都放在同一个层级比较:GGUF 和 MLX 哪个更好?Ollama 和 llama.cpp 是不是两种格式?Dense 和 MoE 是不是两种精度? 后来才发现,这些问题本身就混了好几层概念。
🎯 本文目标:
这篇不写完整安装步骤,只解决第一次下载模型前最需要弄清楚的事:你的硬件有什么资源,模型本身是什么结构,权重用了什么精度和格式,以及什么工具能把它运行起来。看完之后,至少不会再凭文件名猜下载链接。
01|先把整条链路分成五层
理解本地大模型,最重要的不是记住所有缩写,而是先知道每个词属于哪一层:
硬件资源
Windows + NVIDIA:内存 RAM、显存 VRAM
Apple Silicon:统一内存 Unified Memory
        ↓
模型本身
Qwen3.8-27B、Dense / MoE、Base / Instruct、文本 / 多模态
        ↓
权重精度与量化
BF16、FP16、FP8、8bit、6bit、4bit、AWQ、GPTQ
        ↓
文件或仓库组织
Safetensors、GGUF、MLX 转换仓库、配置、Tokenizer、权重分片
        ↓
推理框架与上层工具
Transformers、llama.cpp、MLX、MLX-LM、MLX-VLM、Ollama、LM Studio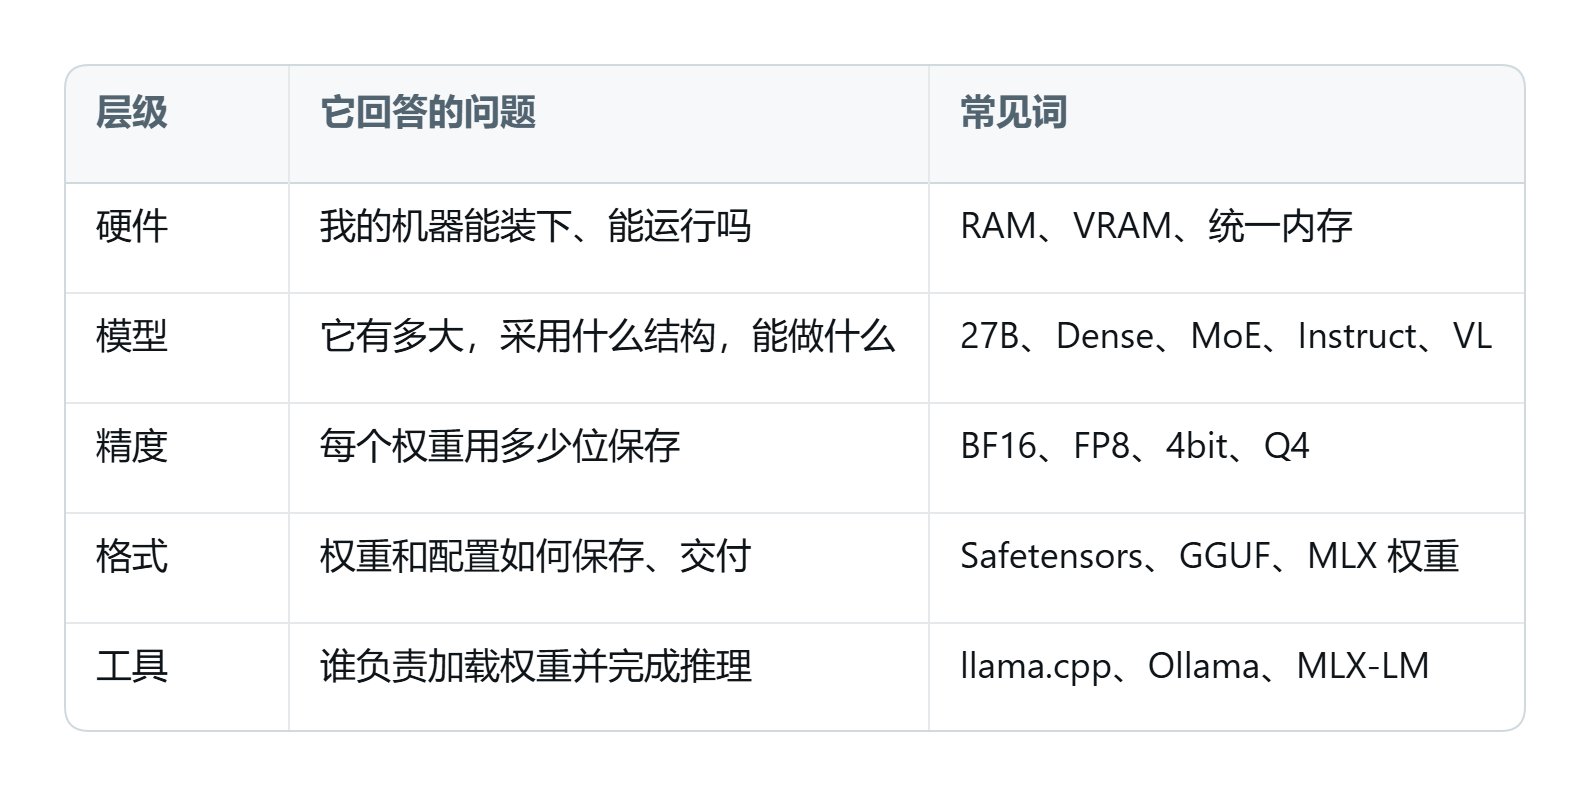
所以,Dense 和 MoE 不是精度,4bit 不是文件格式,GGUF 不是推理引擎,llama.cpp 也不是模型格式。Ollama 更不是一种量化算法。
如果后面又遇到一个陌生名词,先不要急着搜“哪个好”,先问它属于哪一层。大多数混乱到这里已经消失一半。
02|显卡、显存、内存和 Mac 统一内存有什么区别
“显卡”是一块计算设备,NVIDIA 的 RTX 5060、5070、5090 都是显卡型号。显存是显卡板载的高速内存,英文是 VRAM。Windows 任务管理器里看到的系统内存则是 RAM,由 CPU 和普通程序使用。
- Windows + NVIDIA:RAM 和 VRAM 是两块相对独立的资源。模型如果完全放进显存,通常能得到最好的速度;放不下时,部分推理工具可以把部分层留在系统内存中,由 CPU 参与计算(部分 GPU Offload 卸载)。它能让模型跑起来,但通常会比全显存运行慢得多。
- Apple Silicon (M 系列 Mac):使用统一内存 (Unified Memory),CPU 和 GPU 共享同一池内存,不需要在 RAM 与 VRAM 之间来回复制模型。48GB 统一内存不等于一张“48GB 独立显卡”,因为 macOS 系统和其他应用也要占用,但它确实允许 GPU 直接调取超大内存池。
03|27B 是什么,为什么参数量不等于文件大小
模型名里的 B 是 billion(十亿)。27B 通常表示模型大约有 270 亿个参数。参数可以先理解为训练后得到的大量浮点数字,权重文件保存的主要就是这些数字。
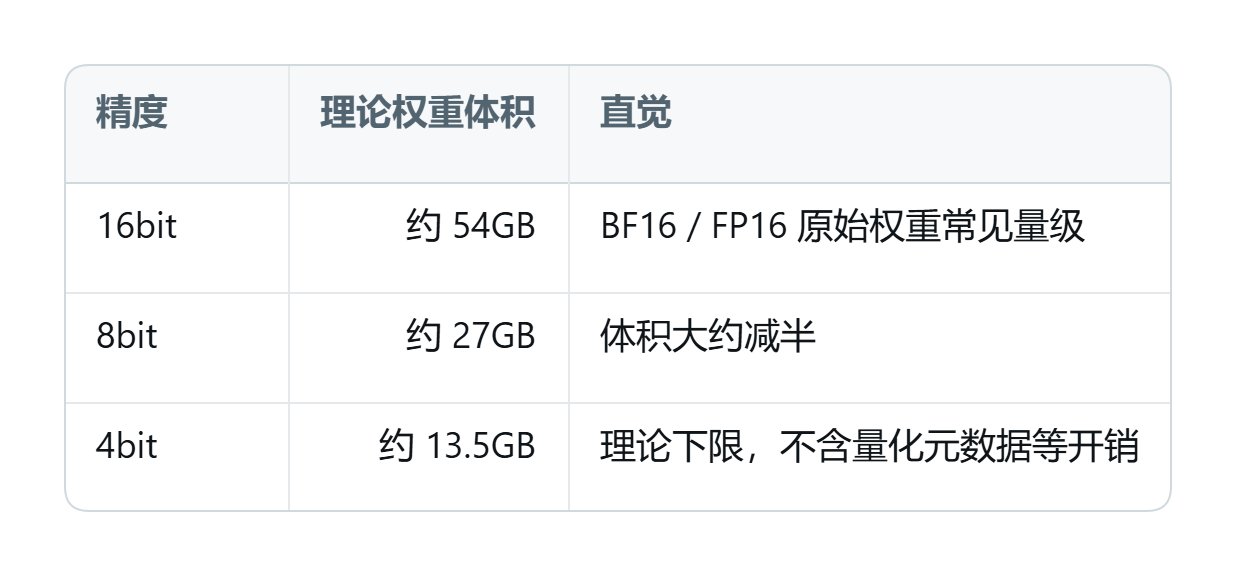
实际文件通常不会和公式完全一致。量化还需要保存比例因子、分组信息,有些敏感层会保留更高精度;多模态模型还可能包含视觉编码器。比如 Qwen3.8-27B 的社区 4bit 版本实际可能在 16GB 左右,而不是严格等于 13.5GB。
🧮 交互工坊:本地大模型显存开销与量化选型实时计算器
04|Dense 和 MoE 是架构,不是精度
Dense 是稠密模型。一次生成 token 时,模型的主要层都会参与计算。Qwen3.8-27B 就是一个 27B 级 Dense 模型,所有参数参与推理。
MoE 是 Mixture of Experts(混合专家模型)。它拥有多组专家网络,每次推理通过路由器只选择其中一部分参与计算。
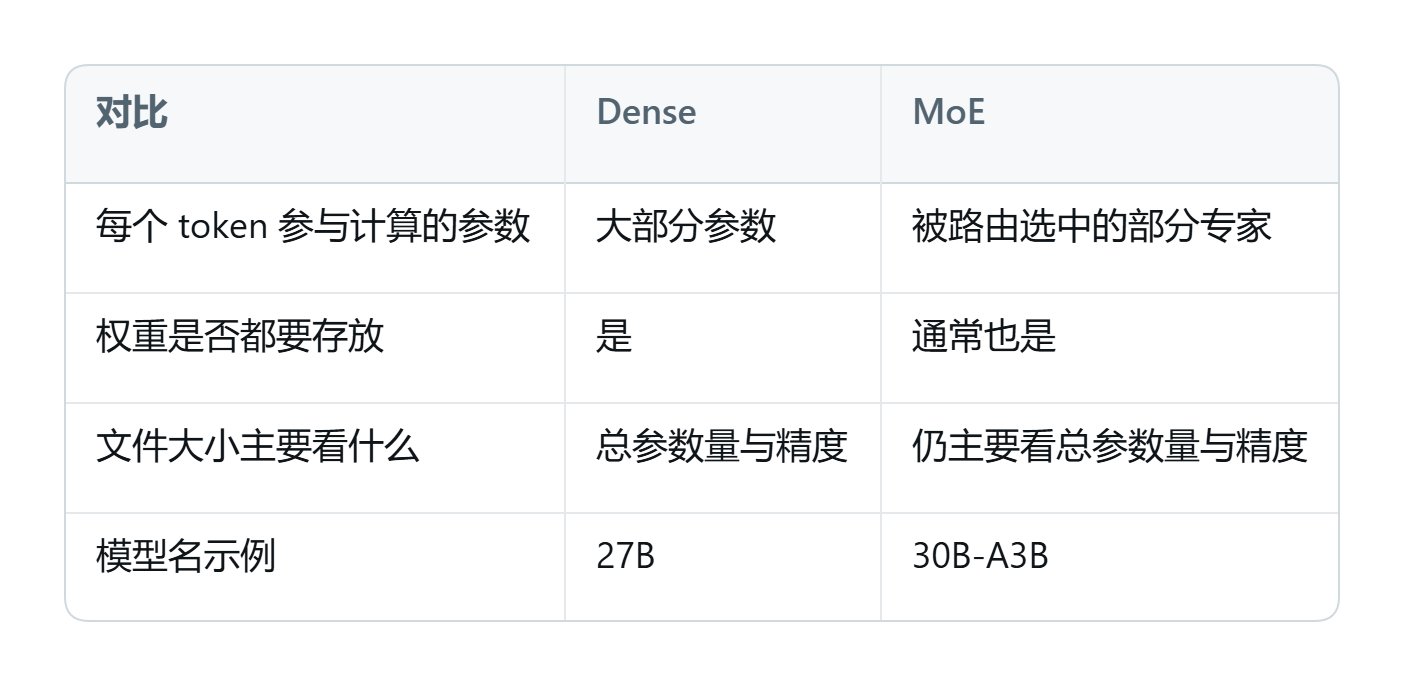
30B-A3B,计算量虽然只有 3B 级别,但要在本地运行,通常仍需要将全部 30B 专家权重完整加载进内存/显存! 存储需求依然是 30B 级别。05|Base、Instruct、Chat、Coder 和 VL 怎么选
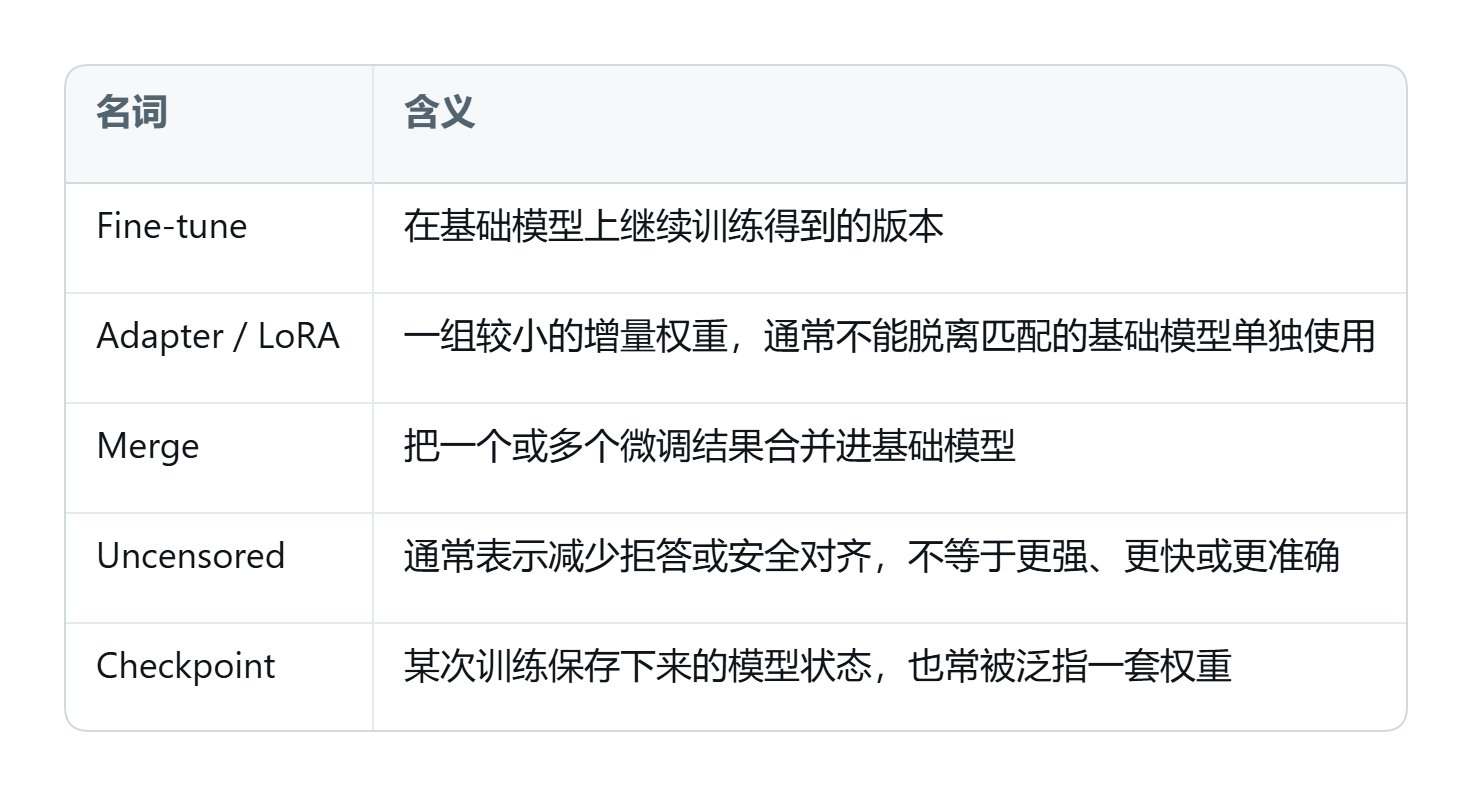
根据前文预测后文。适合算法研发继续微调,不是普通日常聊天的默认选项。
经过人类对齐训练,懂得回答问题、遵循系统指令。本地对话首选!
在代码生成、重构和 Debug 任务上经过专门加强。
支持传入图片等视觉输入。需要多模态框架支持并占用额外显存。
06 & 07|BF16、FP8、4bit 与 GGUF (Q4_K_M) 到底是什么
这些词描述模型权重里数字的表示精度:
- BF16 / FP16:16 位浮点,接近原始模型的高精度,文件和显存占用大;
- FP8:8 位浮点,需要硬件算力和框架支持;
- 8bit / 6bit / 4bit:量化后的低位权重。量化不是 ZIP 解压(ZIP 解压 100% 还原),量化是用更少位数近似原权重,存在一定信息损失。
GGUF 是 llama.cpp 生态专用的单文件模型格式。常见于 Ollama、LM Studio。仓库里的 Q4_K_M 是 K-quant 分块量化里的通用折中方案,是大众在本地运行的首选起点。
08|Safetensors、分片和配置文件分别干什么
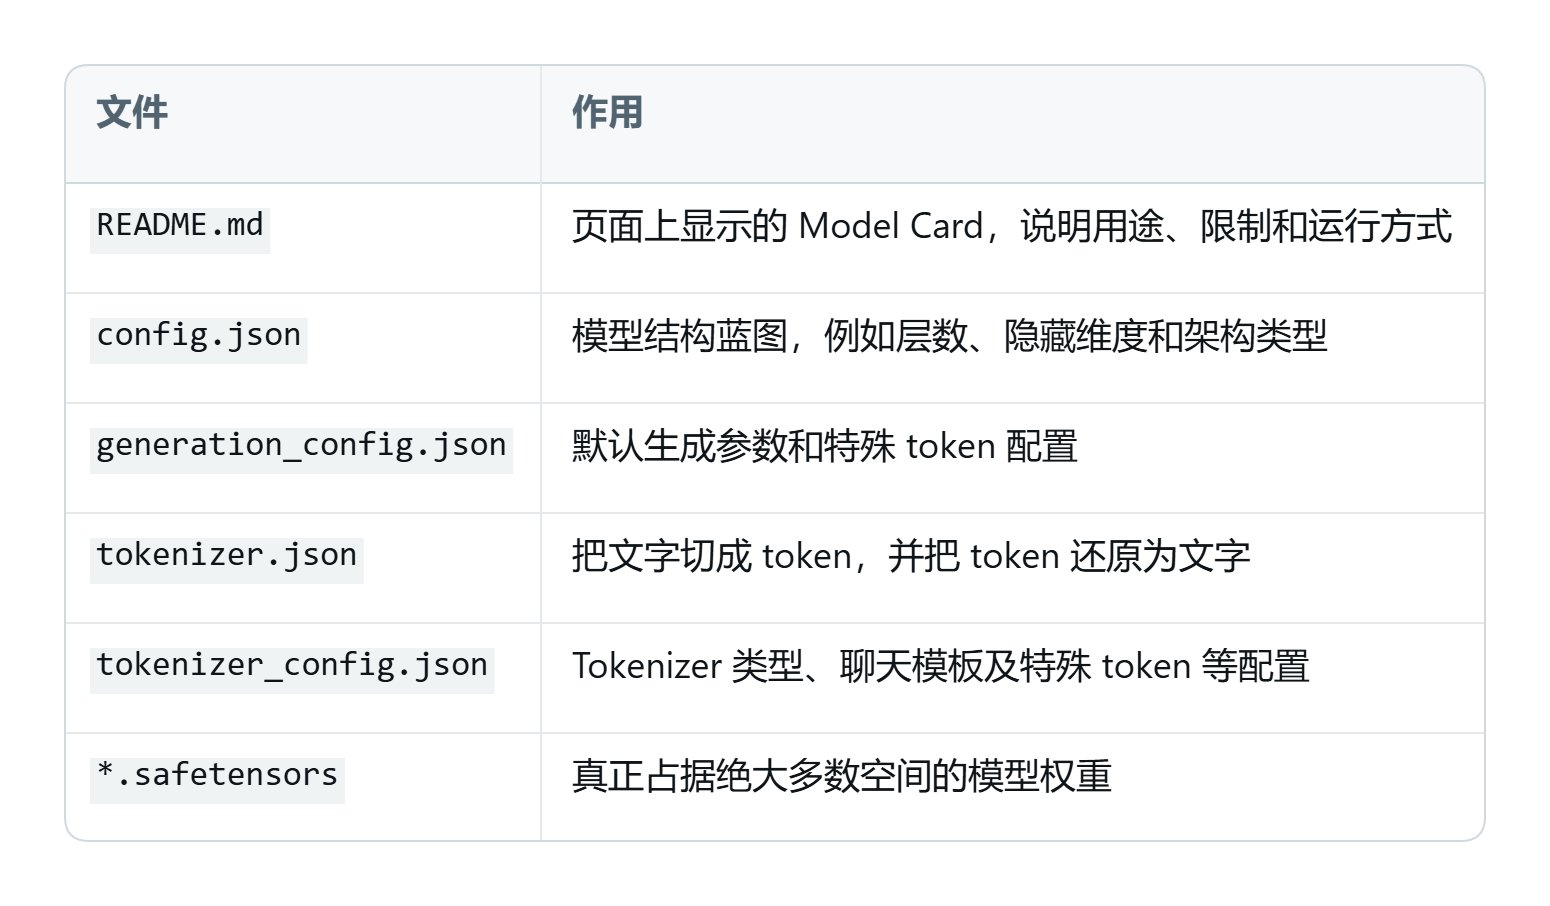
• model-00001-of-00018.safetensors:不是 18 个任选其一的模型,而是同一套大权重拆成了 18 个分片! 必须全部下载才能拼接加载。
• tokenizer.json / tokenizer_config.json:分词器配置,将文字转为 token ID。
• config.json / generation_config.json:定义模型层数、注意力头数与停止词。聊天模板配错可能导致模型答非所问或停不下来。
09|Hugging Face 页面应该先看哪里
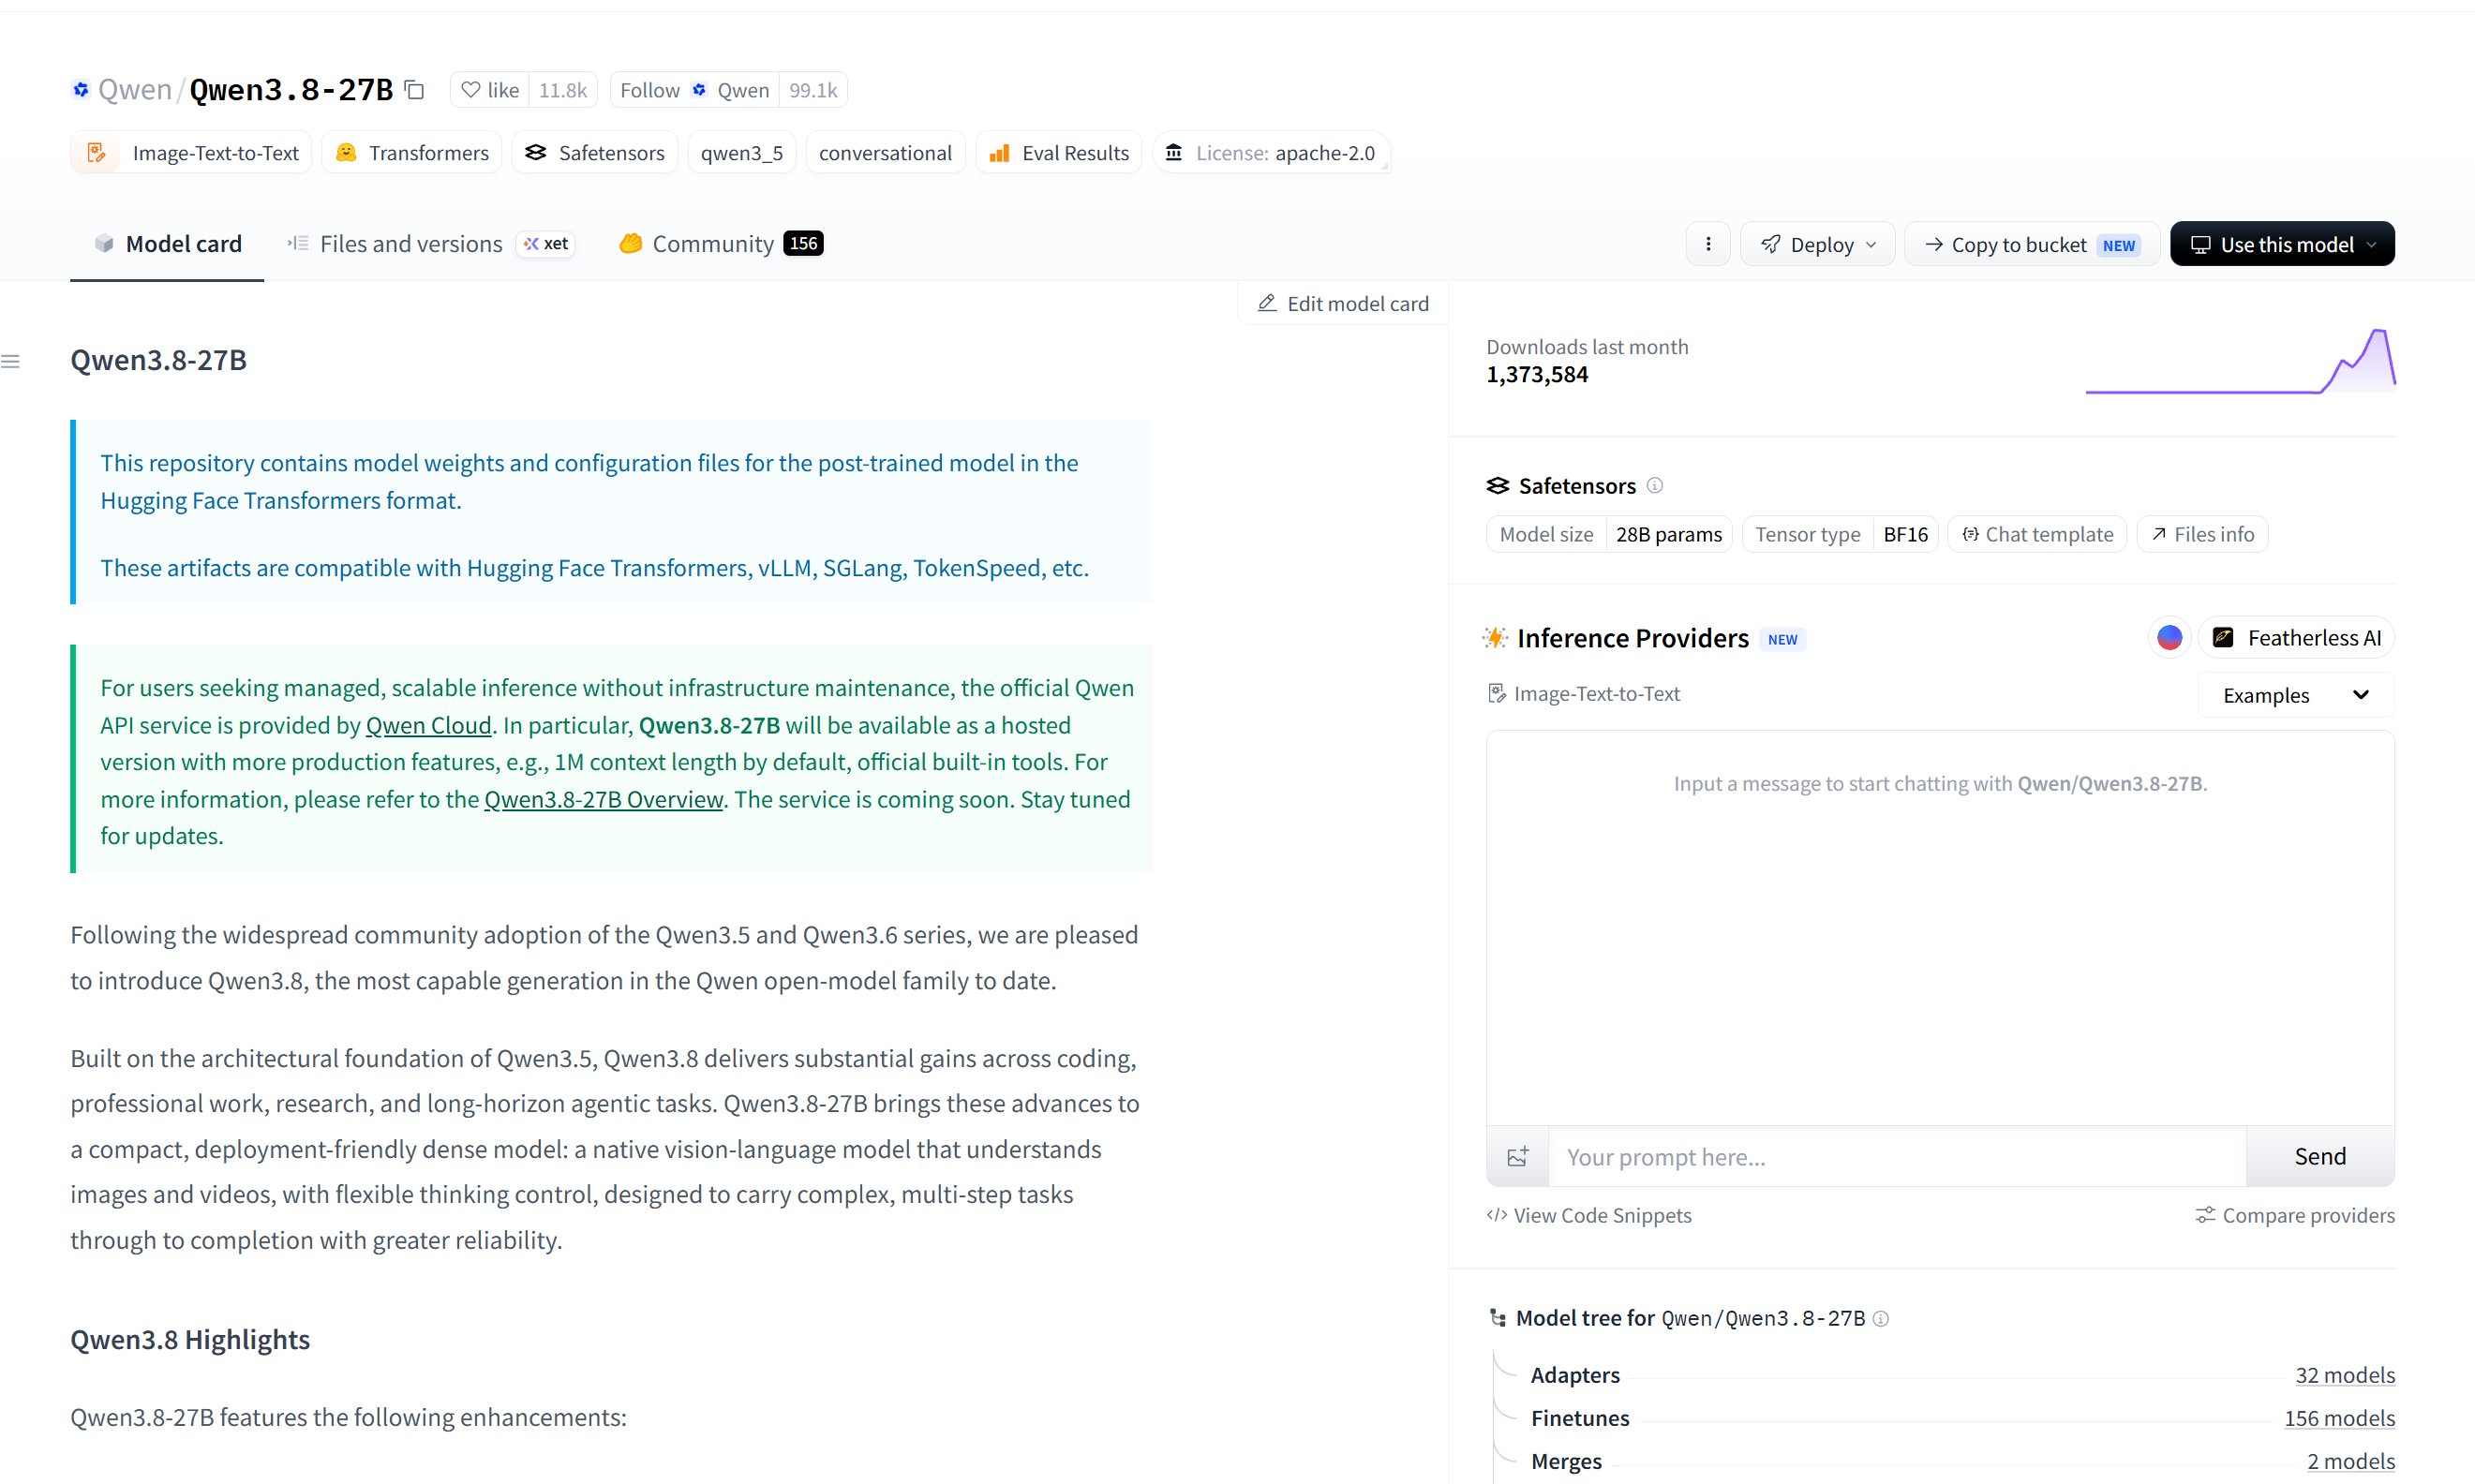
- 发布者:官方原作者(如 Qwen)还是知名社区转换者(如 mlx-community、bartowski);
- 模型名称:参数量、Base/Instruct、VL、量化标记;
- Model Card:用途、许可证、上下文限制与官方推荐运行工具;
- 标签与元数据:text-generation 或 image-text-to-text;
- Files and versions:文件总大小、分片数量与可选量化列表;
- 更新时间与社区讨论:排查是否存在最新兼容性 Bug。
10 & 11|生态分工:MLX、llama.cpp、Ollama 和 LM Studio
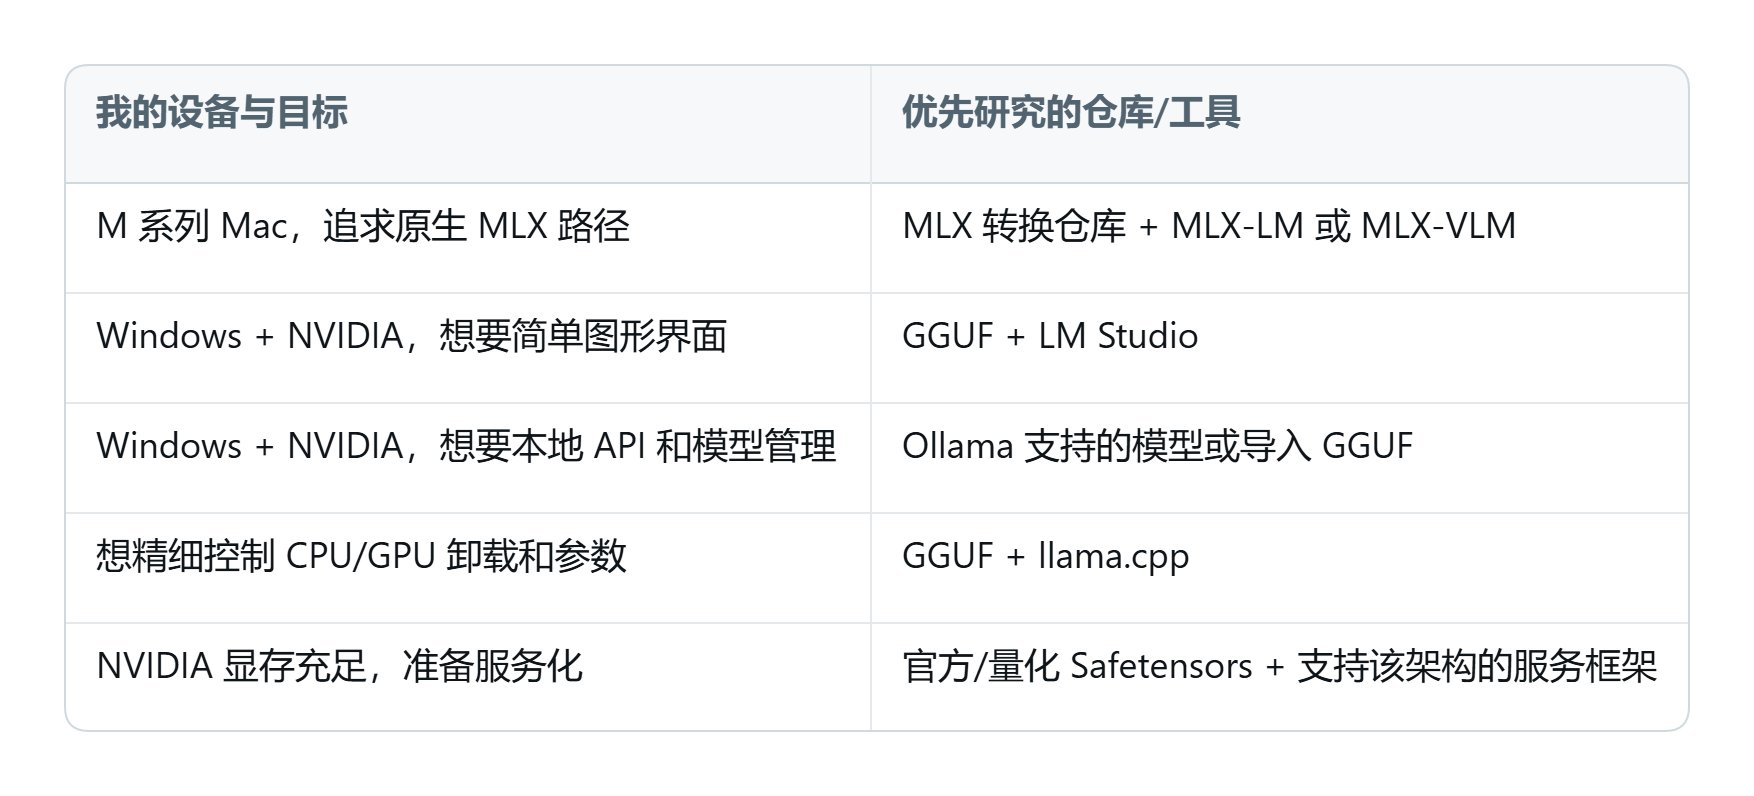
而在 Apple Silicon(Mac)上,MLX 是专属底层框架,MLX-LM 处理纯文本 LLM,MLX-VLM 处理视觉多模态模型。Windows 用户切勿盲目下载 MLX 权重。
12|实战复盘:用 Qwen3.8-27B 走一遍选择过程