
《万字长文|企业 AI 知识库从 0 到 1 真实交付指南:数据治理、权限、测试与验收》
作者: Hedy Zhang @xiaomanhedy
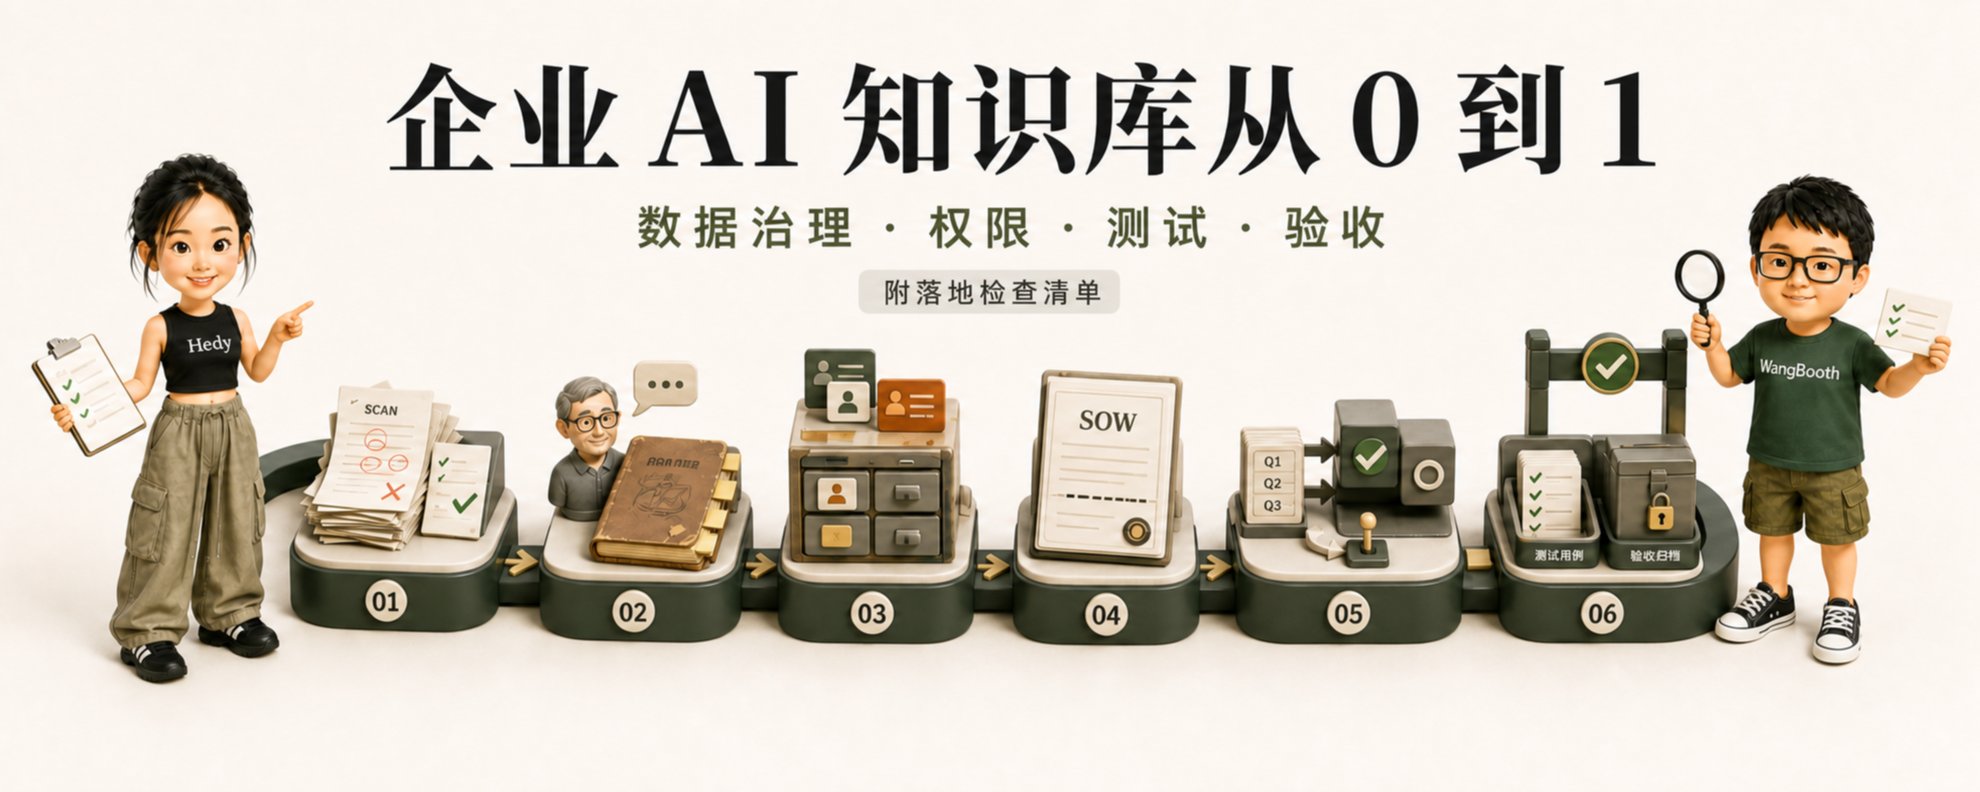
这篇文章主要讲清楚一件事:企业 AI 知识库从“能演示”走到“能交付”,难点不只在模型,而在资料、人员、权限、系统、边界和验收。
全文围绕六个核心问题展开:
- 为什么原始资料本身可能就是错的;
- 怎样找到只存在于老员工脑子里的知识;
- 为什么企业知识库很难直接卖一套标准产品;
- 复杂文档、旧系统和私有化部署应该怎样处理;
- 怎样通过工作范围说明(SOW)控制交付边界和需求变化;
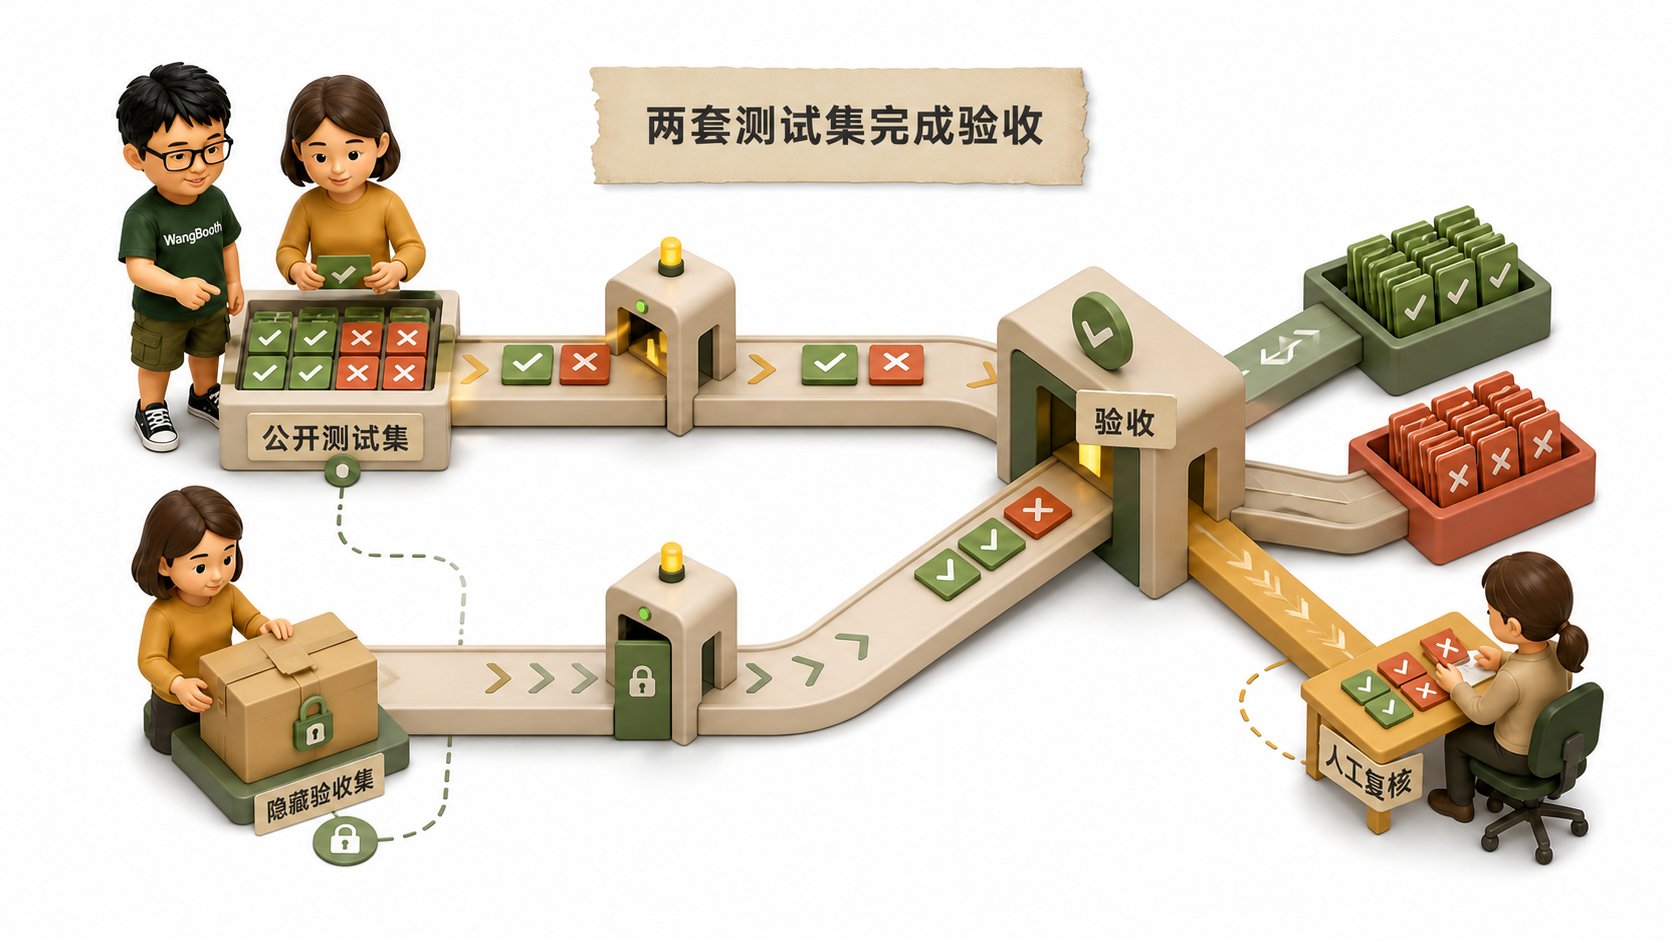
- 怎样用两套测试集完成测试与客户验收。
真实案例:当年打印就印错的纸,AI 是无法靠自己纠偏的
2023 年,我们给一个传统制造业公司做了个 AI 知识库。他们当时遇到的问题很具体:企业里的业务、销售、研发和售后之间,经常要通过电话或聊天反复确认产品问题。销售随时可能在群里提问,但研发和售后还有自己的工作,不可能一直守在群里回答。
所以,他们想做的不是一个对外客服,而是一个只给内部人员使用的知识库:销售或业务人员遇到常见问题时,先去知识库里问。能够从资料中确定的,系统直接回答;真正复杂的问题,再去找研发和售后。
但真正进场以后才发现:让 AI 根据产品资料回答问题,并不是整个项目里最难的部分。最难的是,那些准备交给 AI 的资料,本身并没有大家想象得那么可靠。
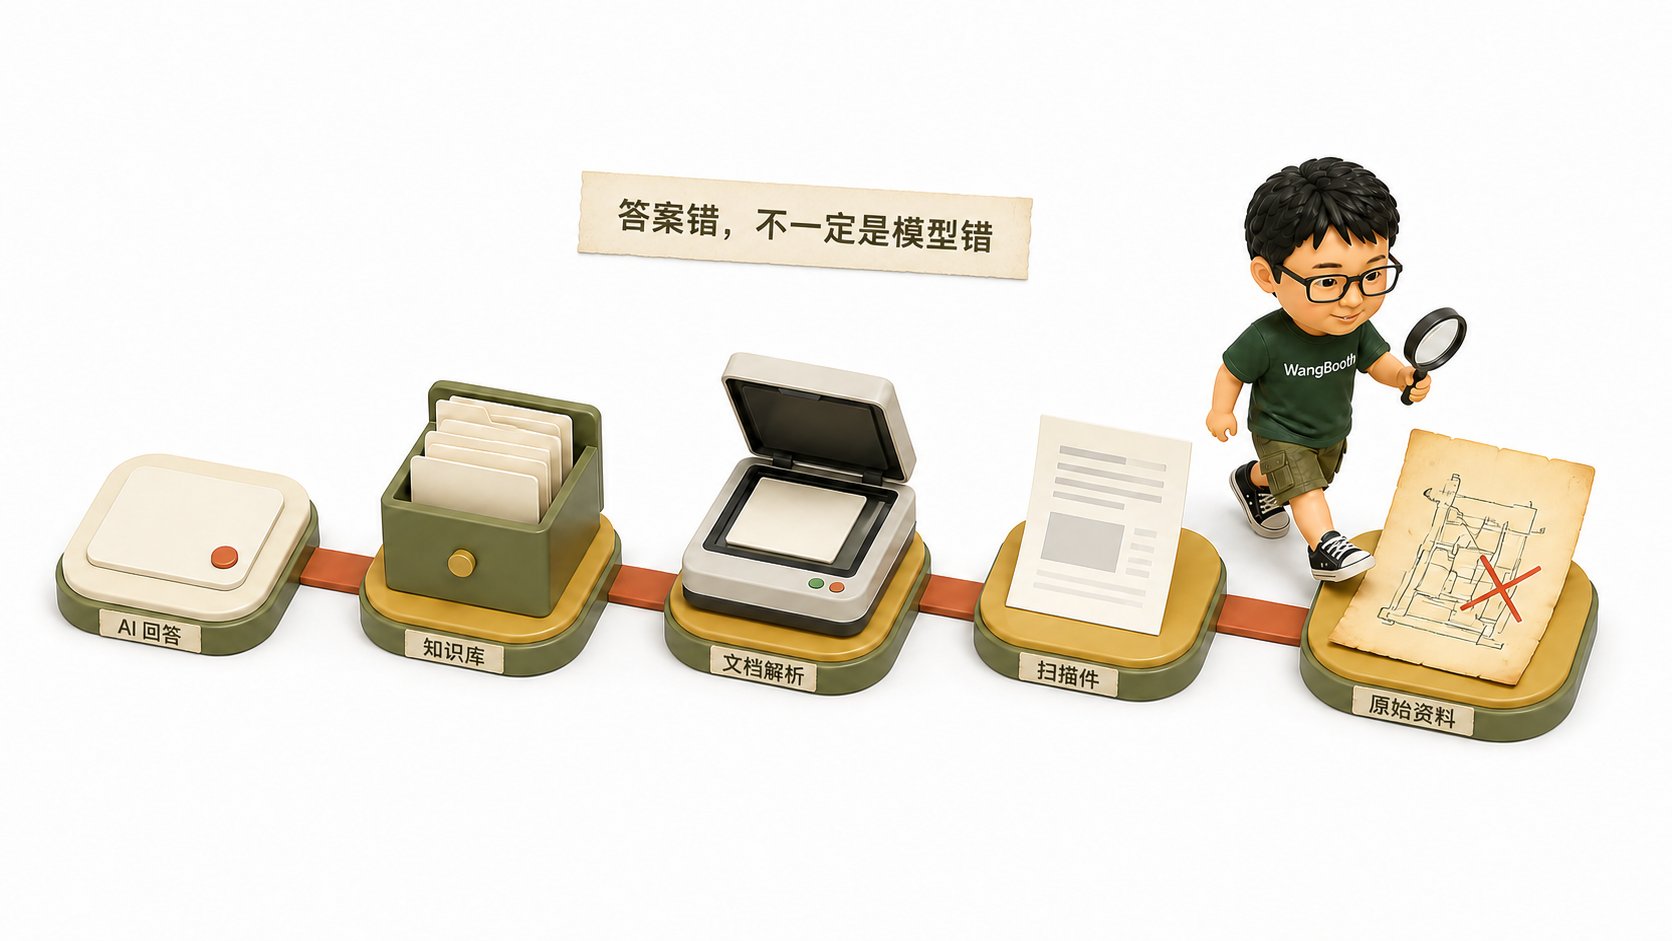
项目测试时,系统曾经回答错过一个问题。排查先从模型开始,又检查了知识库的检索结果,最后继续往前查文档解析。结果发现:模型引用了知识库里的内容,知识库也找到了对应资料,扫描后的文字和原始图片同样一致。从技术链路来看,每一步都没有问题。但答案就是错的。
继续追到最原始的纸质设计文档,才发现那份资料当年打印时就印错了。
企业里的老员工其实都知道那里是错的。他们平时不会按照纸上的内容工作,因为这个错误早就通过口口相传,变成了大家默认知道的背景信息。但没有人重新打印一份,也没有人把这条更正正式记录下来。
AI 可以准确地读取一份资料,也可以准确地引用一份资料,但它无法自动保证这份资料原本就是对的。
一、企业做知识库,通常不是因为“想拥有一个 AI”
这家企业想做内部知识库,背后真正要解决的是信息传递问题。同一个产品问题,销售会问,业务人员会问,客服会问。研发和售后掌握答案,但他们不可能一直重复回答。
如果这些高频问题能够从产品资料里找到确定答案,那么知识库就可以先承担内部客服的作用。它不是为了替代研发,更不是为了让企业从此不需要懂业务的人。它首先解决的是:不要让掌握专业知识的人,一天到晚被相同的问题打断。
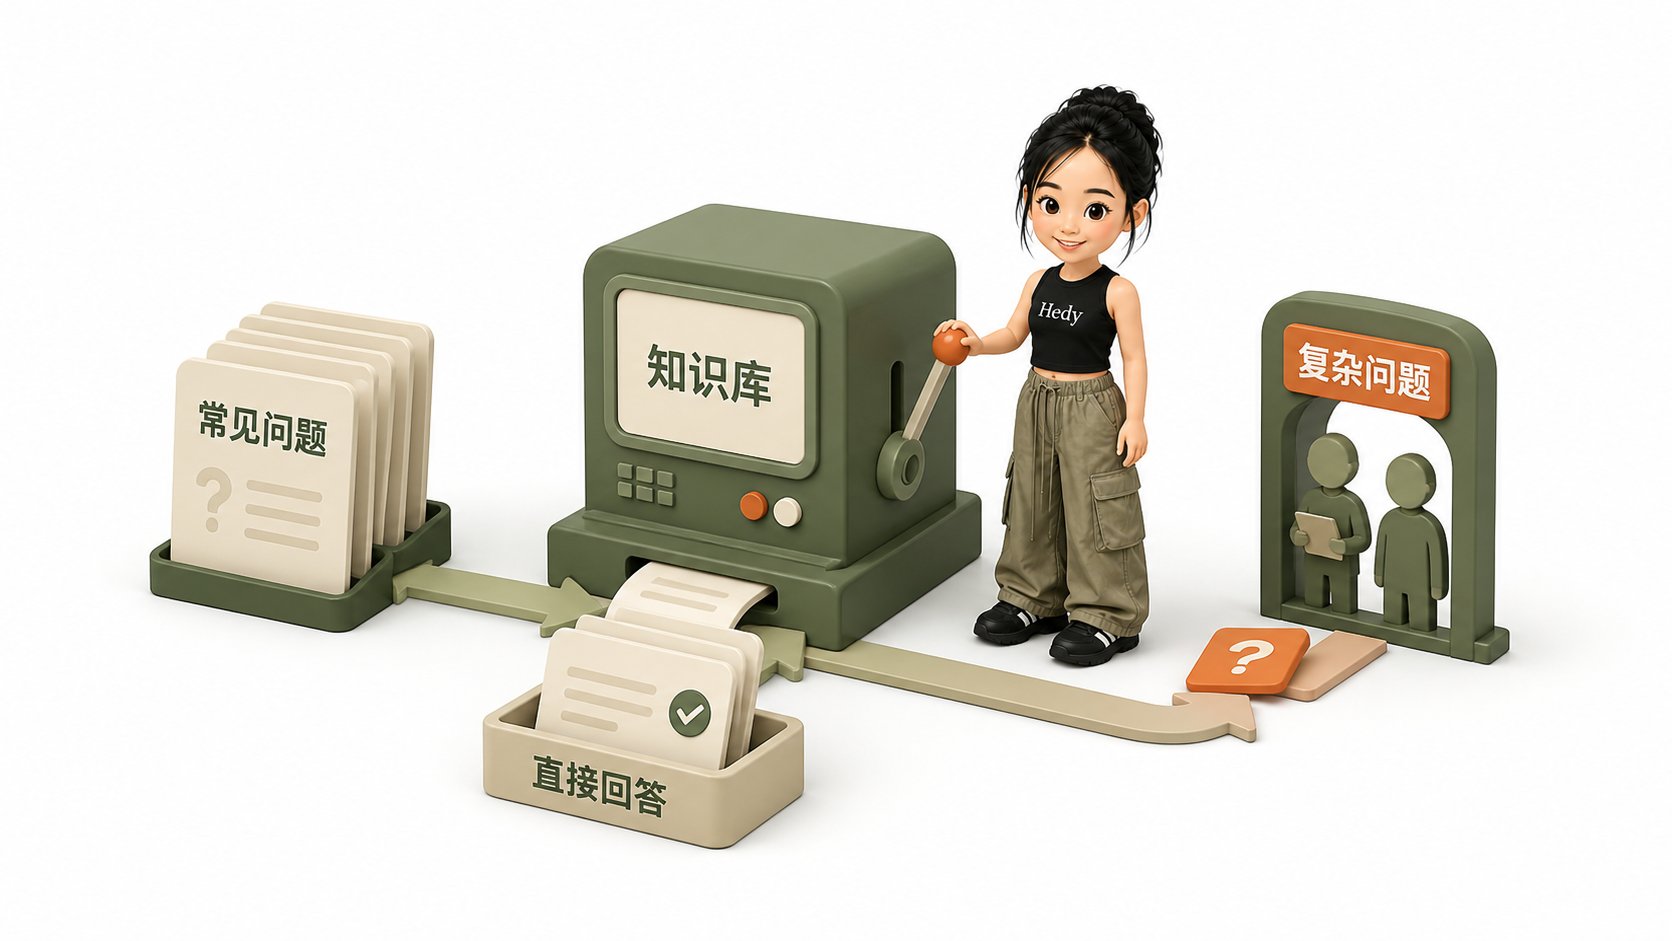
这也是为什么企业知识库看起来是一个非常通用的需求。但“需求通用”不等于“交付可以完全标准化”。企业真正需要的并不是一个可以上传文件的通用聊天窗口,而是一套能接进自己业务里的工具。资料在哪里,谁能看,旧资料怎样处理,系统接不接得进去,答案怎样判断正确——这些问题,每家企业都不一样。
二、企业的很多知识,根本不在文档里
企业存在的时间越长,历史遗留问题通常越多。特别是过去数字化基础没有建设好的企业,很多业务流程并没有进入系统:
- 有些流程是师傅带徒弟,嘴上说的;
- 有些规则是在群里说一次;
- 有些错误是大家用久了以后都知道,但从来没有正式改过;
- 有些资料看起来是公司的正式文件,真正干活的人却知道不能完全照着它做。
AI 看到什么,就处理什么。原始资料如果少了一条默认规则,它不会自己补出来;原始资料如果是错的,它也不会因为“老员工都知道”就自动改正。不能指望客户把一个文件夹交过来,导入系统,项目就算完成了。
三、做知识库不能站在员工对面,要先看他们怎么干活
外部团队进企业做 AI,员工很容易担心一件事:你是不是来替代我的?如果一进场就站得很高,告诉员工哪些工作可以自动化、哪些岗位可以减少,对方当然不会愿意把真实流程和经验交出来。
现场沟通时,交付团队采取的姿态更像是“半蹲下来”——先站在辅助他的位置上,听他讲工作里哪个环节最烦、哪个地方重复劳动最多、哪个环节最容易出错。
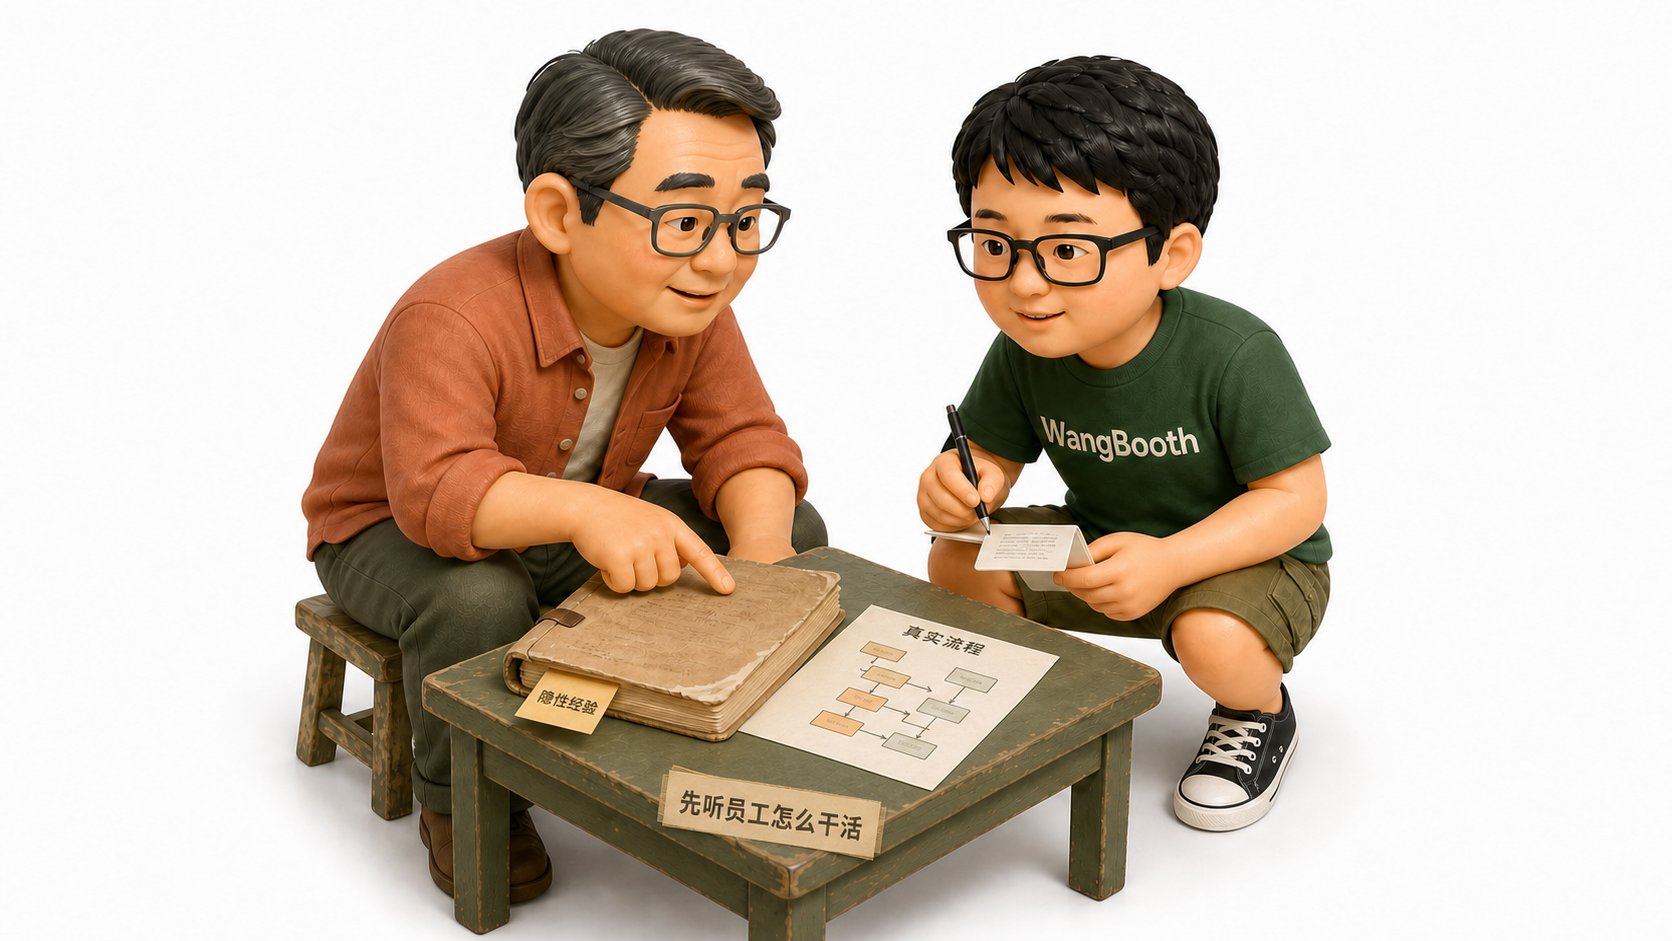
一个在行业里工作多年的人,知道哪些规则是现实条件逼出来的。遇到看起来不合理的需求,不要上来就反驳,先问它从哪里来、想解决什么问题、过去为什么这样解决。技术团队负责把资料接进系统、把问题查出来;业务人员负责告诉系统什么才是这个企业真正执行的知识。
四、只和老板聊,确定不了真正的交付边界
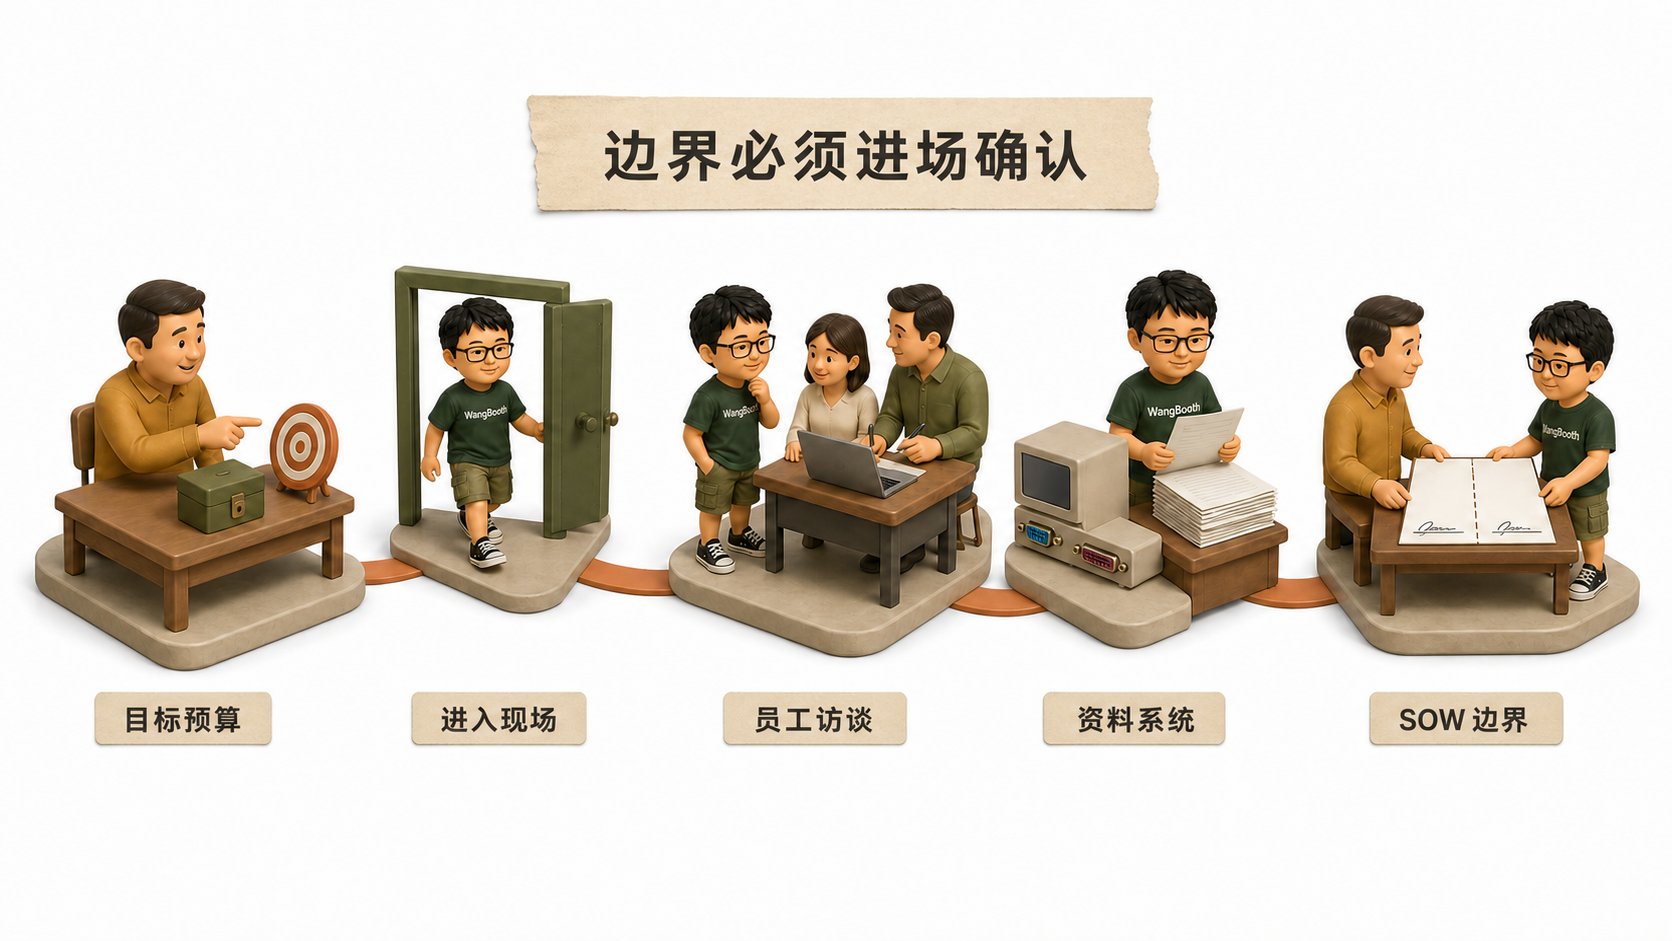
企业老板通常可以告诉你两件事:他想不想做,以及大概愿意花多少预算。但真正要签进合同的交付边界,必须进入客户的业务现场,和实际干活的人沟通数天甚至一周。
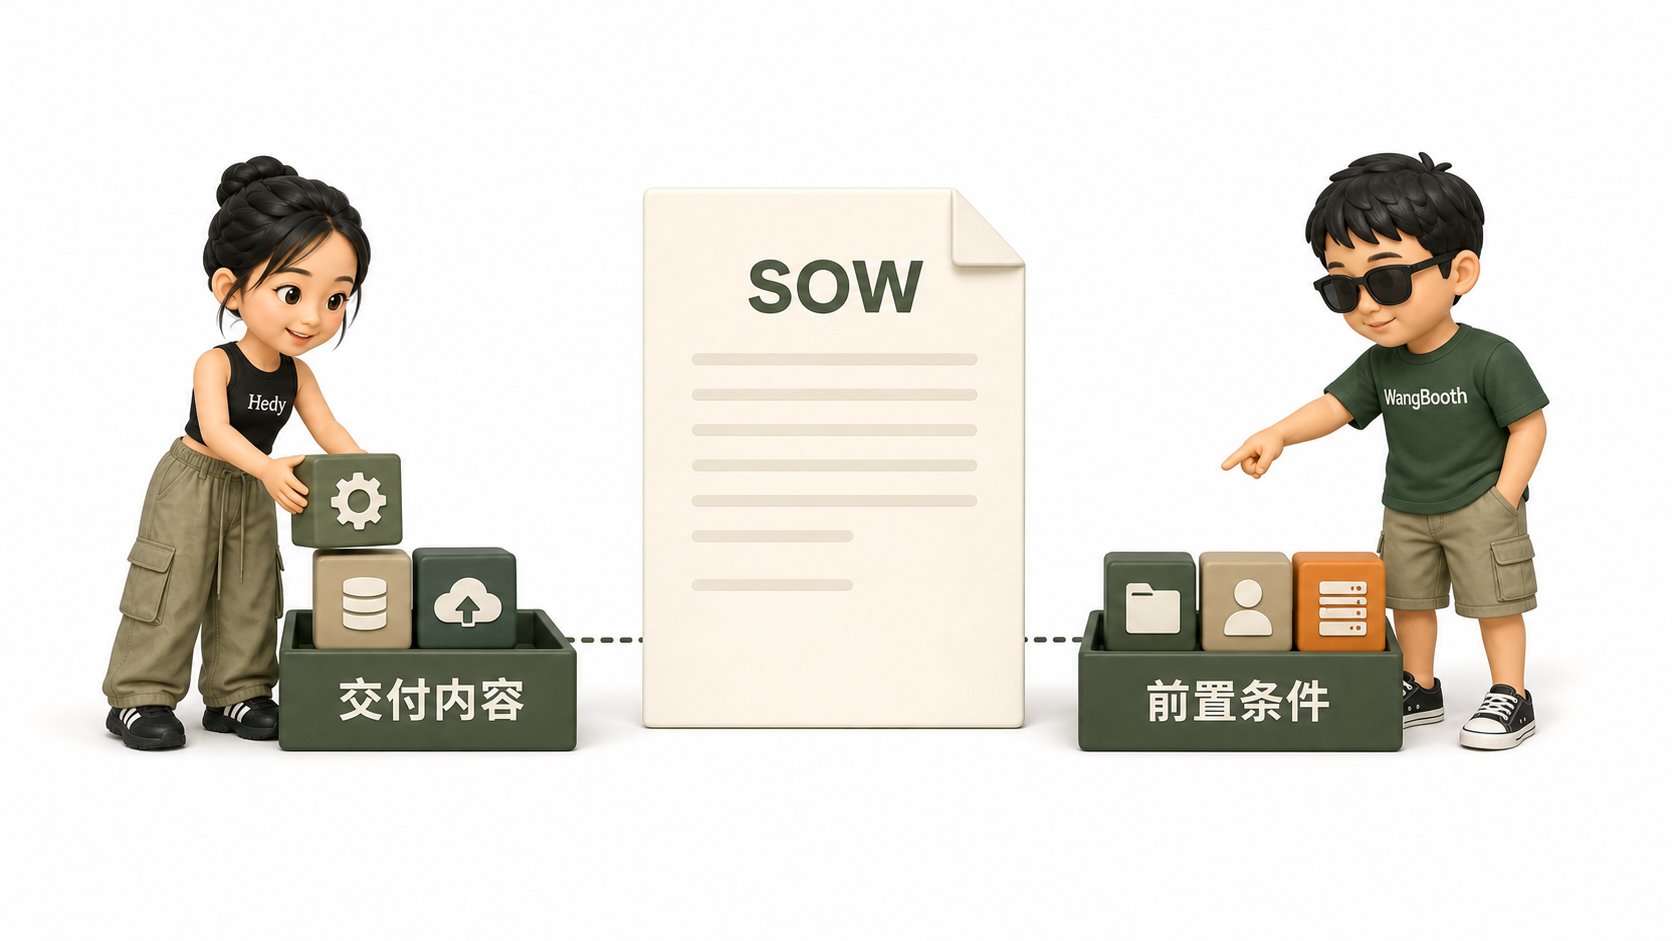
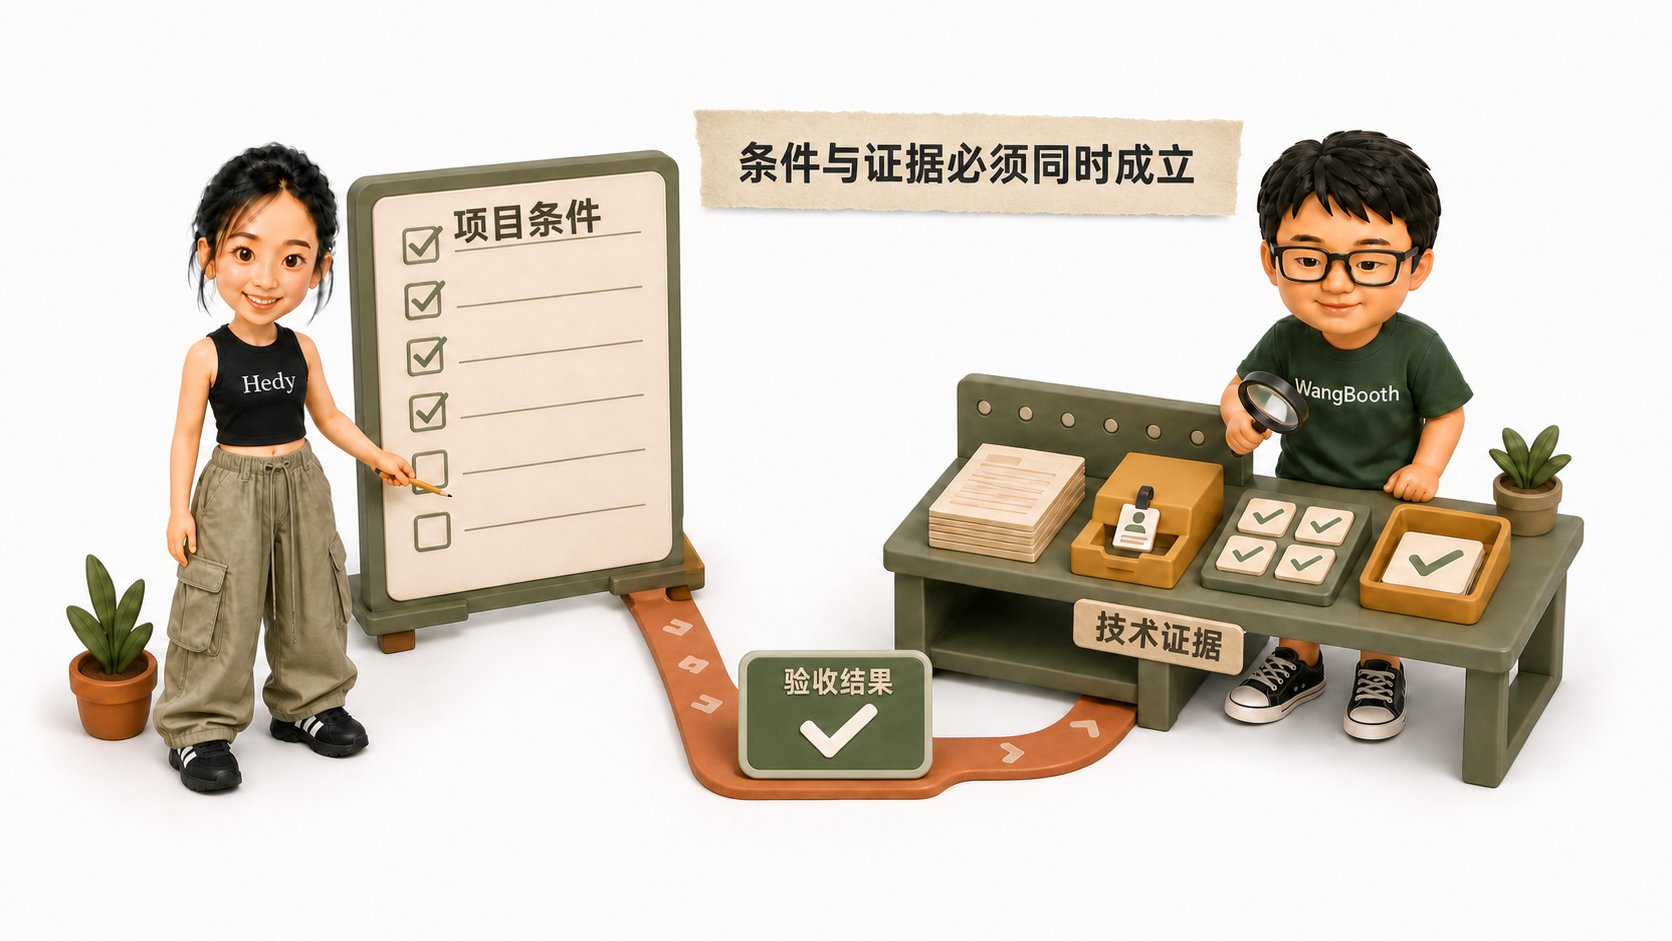
工作范围说明(SOW)必须明确两类内容:
知识库做到哪个具体业务场景、接入哪些范围的资料、包含哪些系统接口能力、以何种标准进入测试与验收。
哪些资料由客户提供并对真实性负责、客户指定谁配合确认口径、准备何种网络与服务器环境、缺失哪项条件时交付暂停。
五、知识库为什么一直没有“一统天下”的产品?
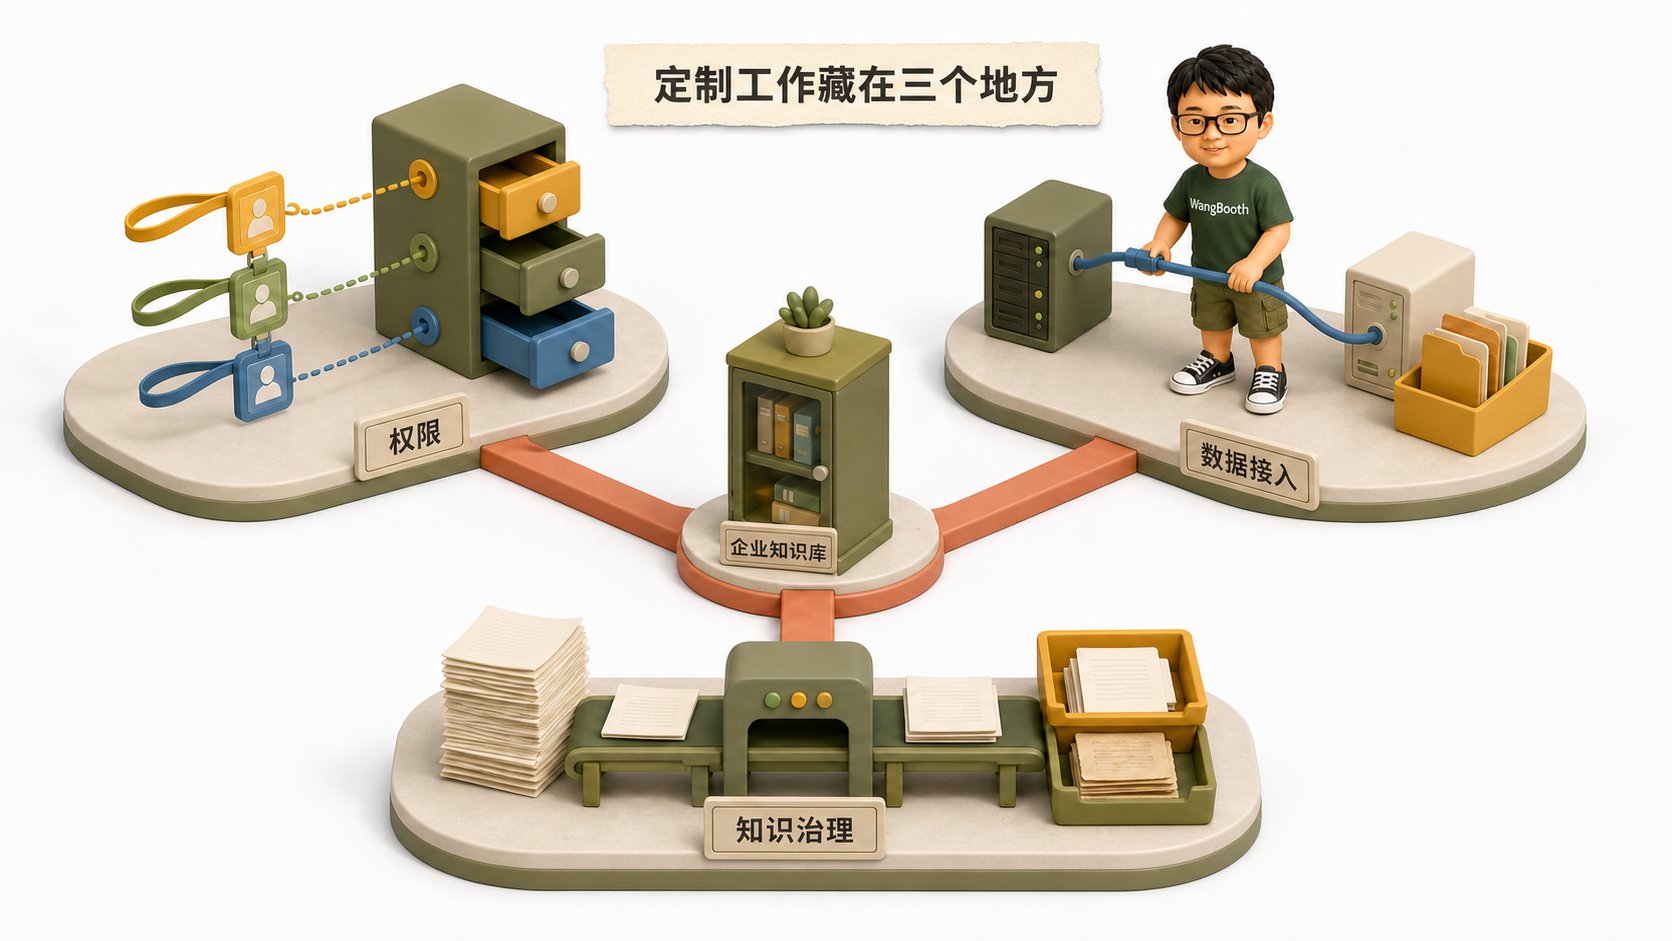
企业内部至少有三类问题无法被一个通用的聊天窗口直接抹平:
- 权限划分:哪个部门能看什么、不同角色能问到什么深度;
- 数据接入:分散在老旧系统、OA、聊天群与纸质扫描件中;
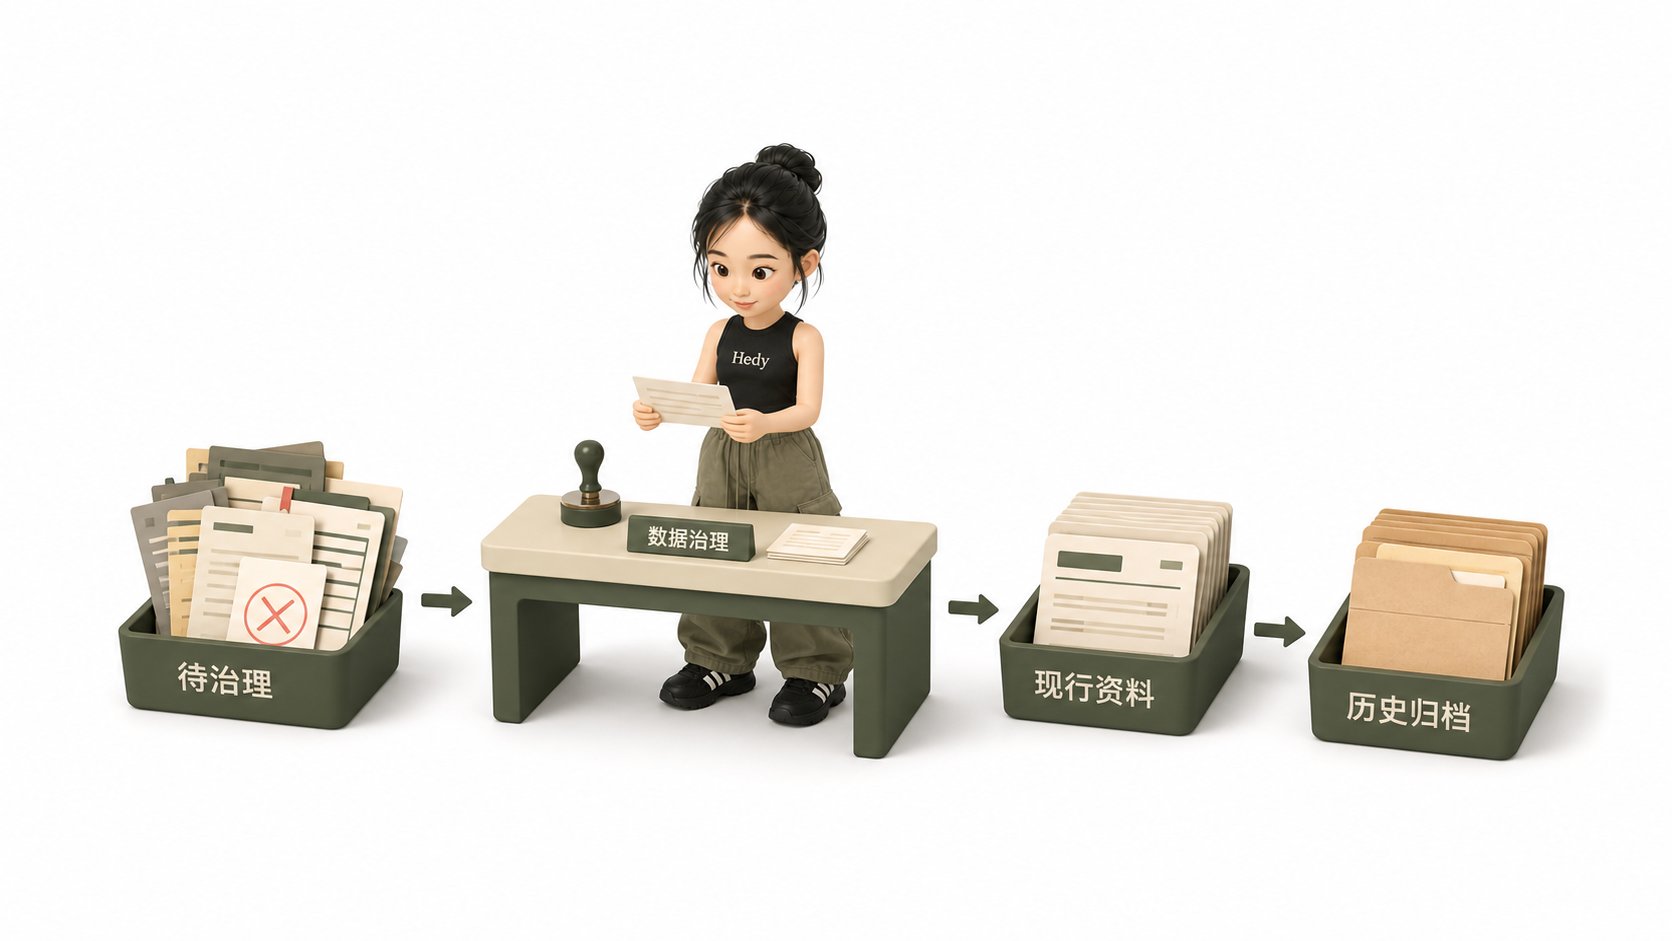
- 数据治理:面对数以万计的历史文档,哪些已作废、哪些冲突。
很多企业员工真正想要的不是再学一套写 Prompt 的复杂工具,而是“点点点”——打开原来的工作入口,选择要做的事情,输入必要信息,直接得到结果。产品不能把技术团队省下来的工作,重新变成业务人员的学习成本。
六至十、工程实战的五条硬核铁律
源头如果不治理,后面的模型和检索再好,也只是把不可靠的知识更方便地呈现给用户。
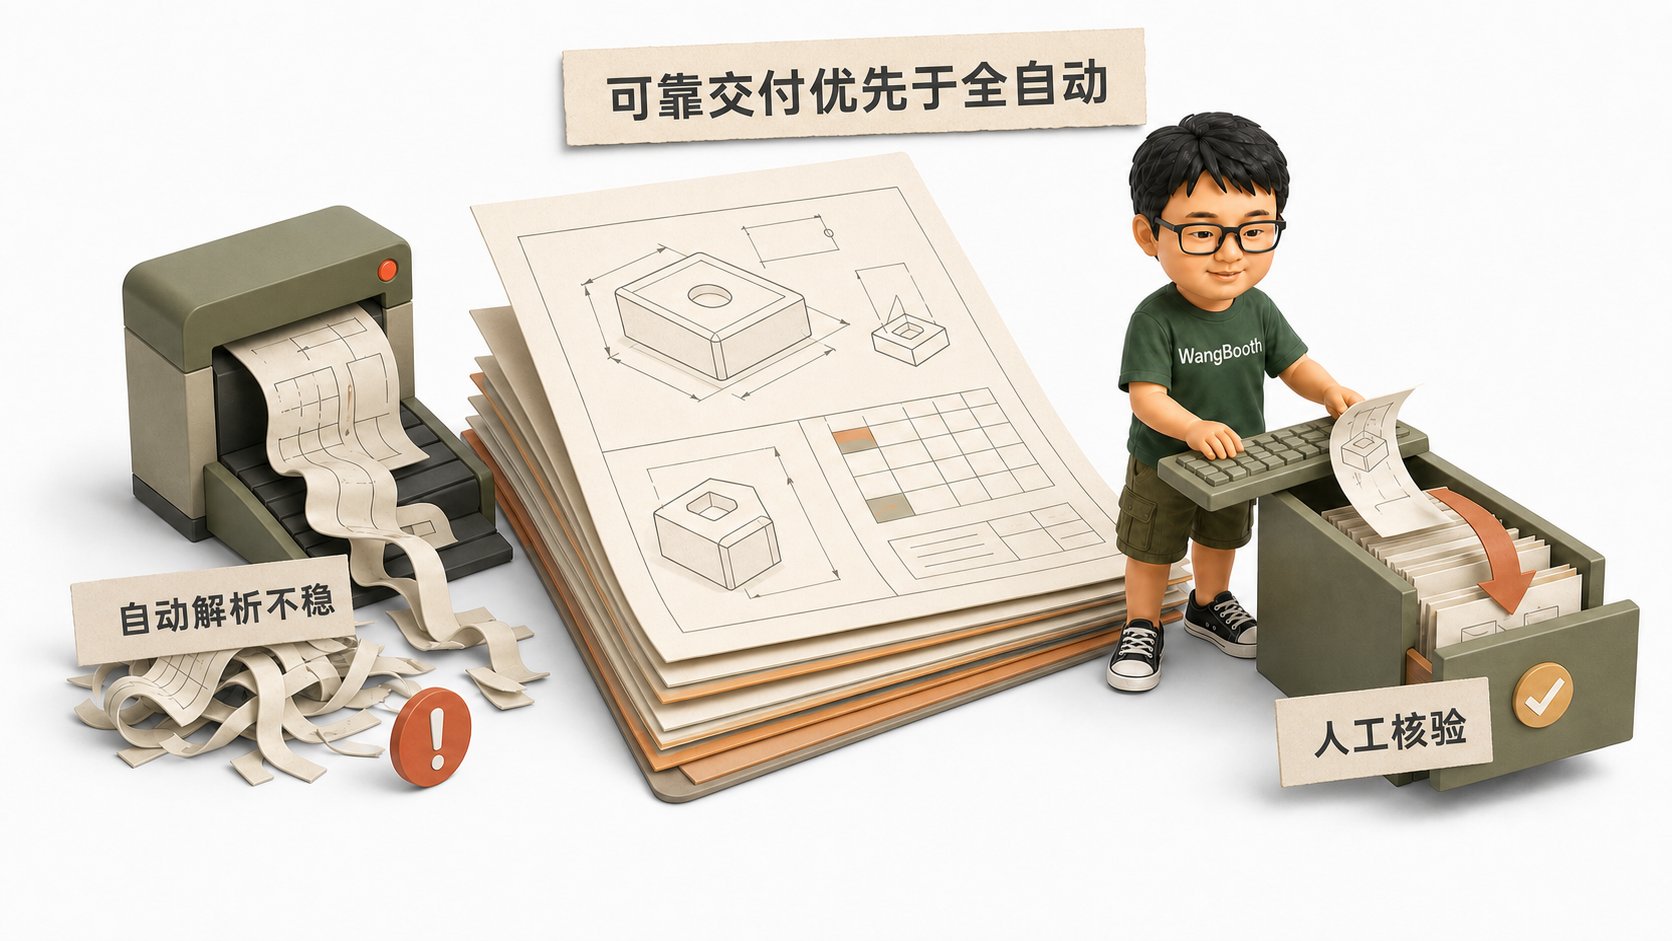
技术演示追求全自动,但交付首先要保证正确率。图纸、尺寸或表格只要错一个,自动化比例再高也没有意义。
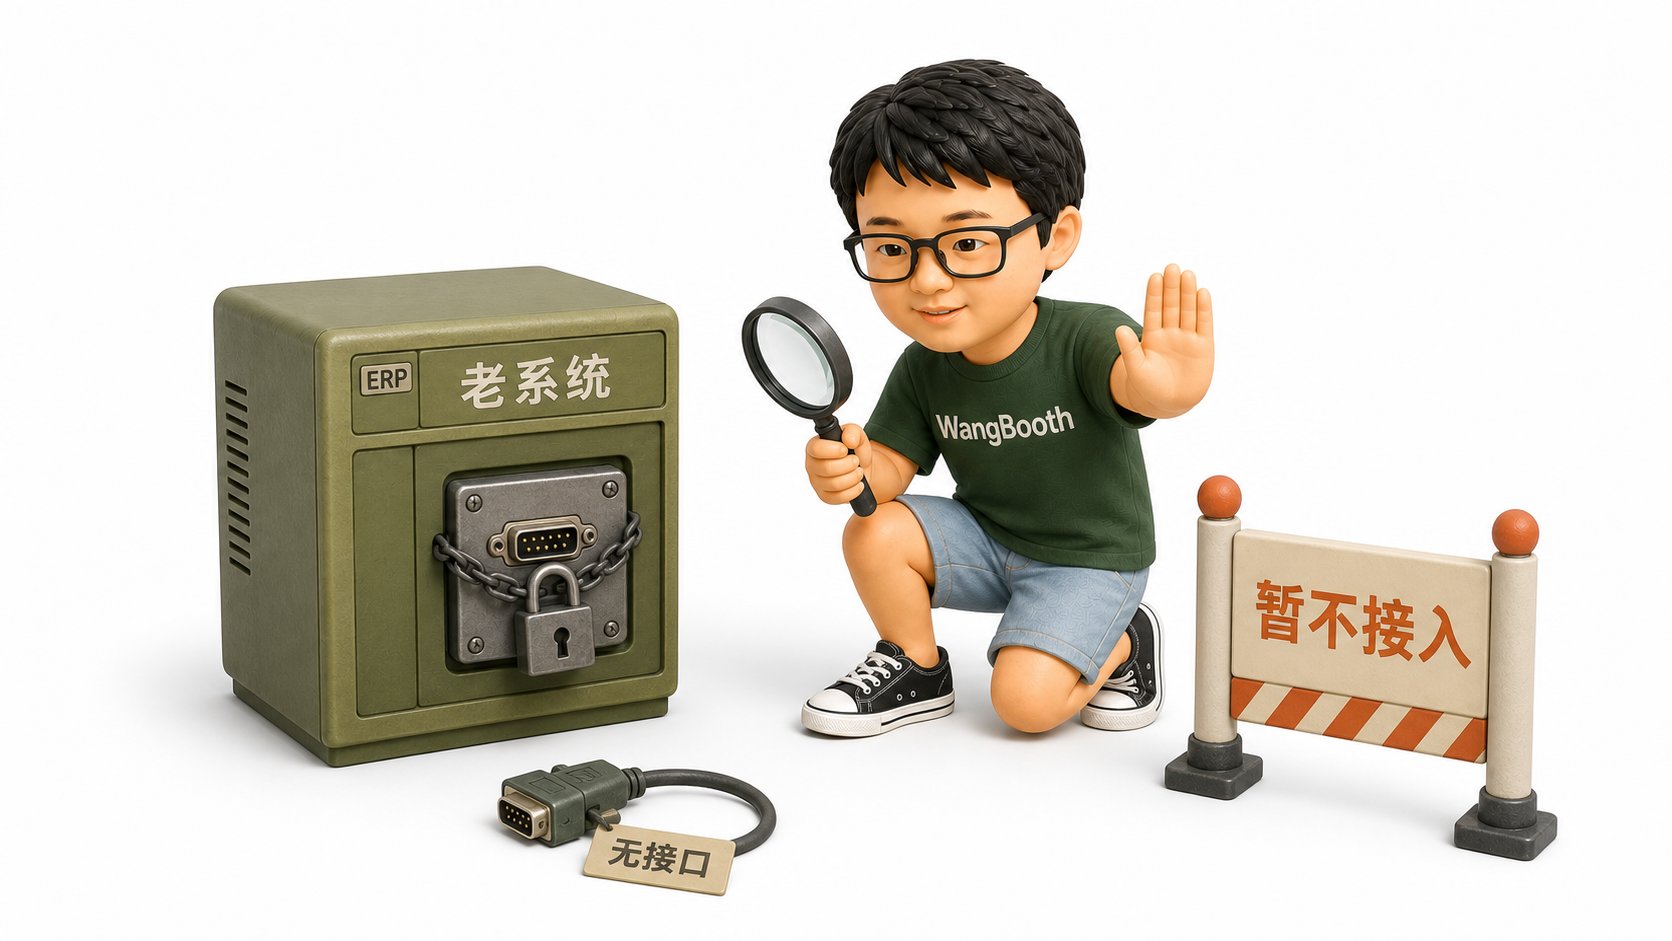
如果 ERP 不提供官方 API,这部分业务就坚决不做。强行改造遗留系统很容易把项目拖进无法交付的泥潭。
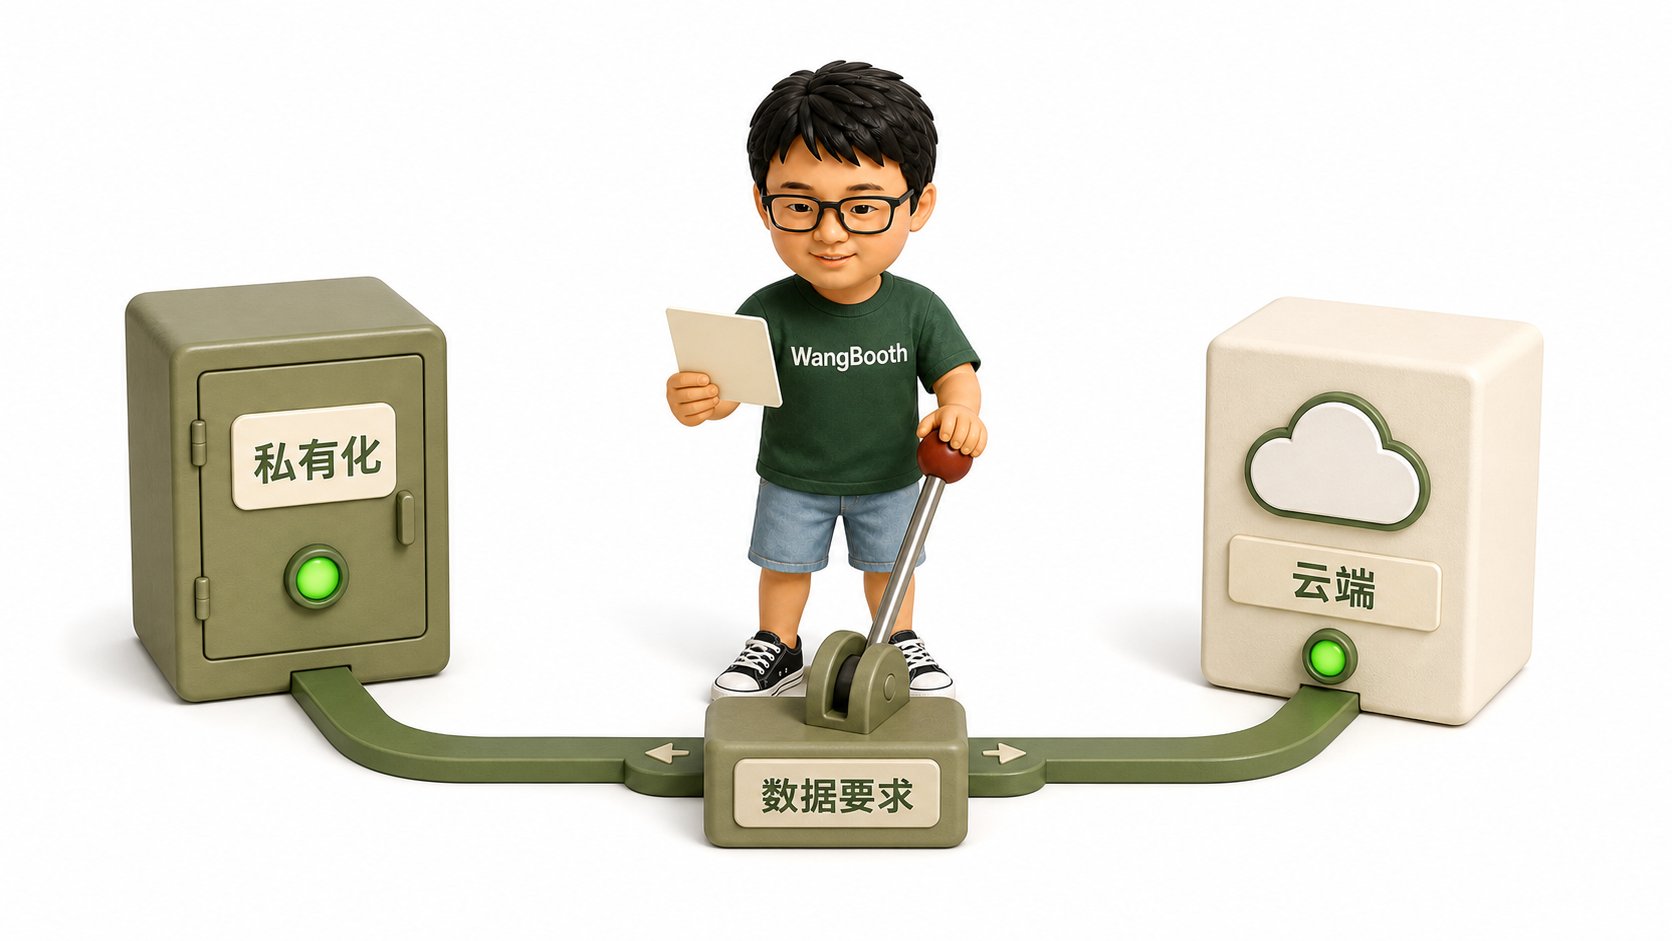
先证明在客户允许的环境里,能够部署的模型是否能达到业务要求。如果把顺序反过来先买机器,项目从一开始就失去验收基础。
固定一组典型业务问题反复实测,模型不达标就换;都不达标,就明确告诉客户当前做不了。
十一、双套测试集机制与 85% 确定性验收链路
企业项目不能靠演示时问对了几个问题就算完成。交付前后必须建立两套测试集:
覆盖产品各个需求点的正反用例,设计完成后提交给客户确认测试范围与口径,达到约定指标后移交。
题目不提前公开,由客户直接对系统进行独立盲测,只反馈“达标 / 不达标 / 差距多少”。
测试集中约 85% 的题目必须有确定答案(如认证参数、尺寸、型号指标),由机器直接自动判定;剩下 15% 开放性问答由人工专家评估。
📋 交互工坊:企业 AI 知识库 7 维落地就绪度自检评估台
根据您的项目实际现状在线勾选以下细则,系统将实时计算交付安全指数并预警潜在风险:
1. 使用场景
2. 现场与边界
3. 资料与历史知识
4. 权限与数据接入
5. 技术与模型
6. 测试与验收
7. 新问题与新范围
十二、项目留痕与数据治理二期衍生
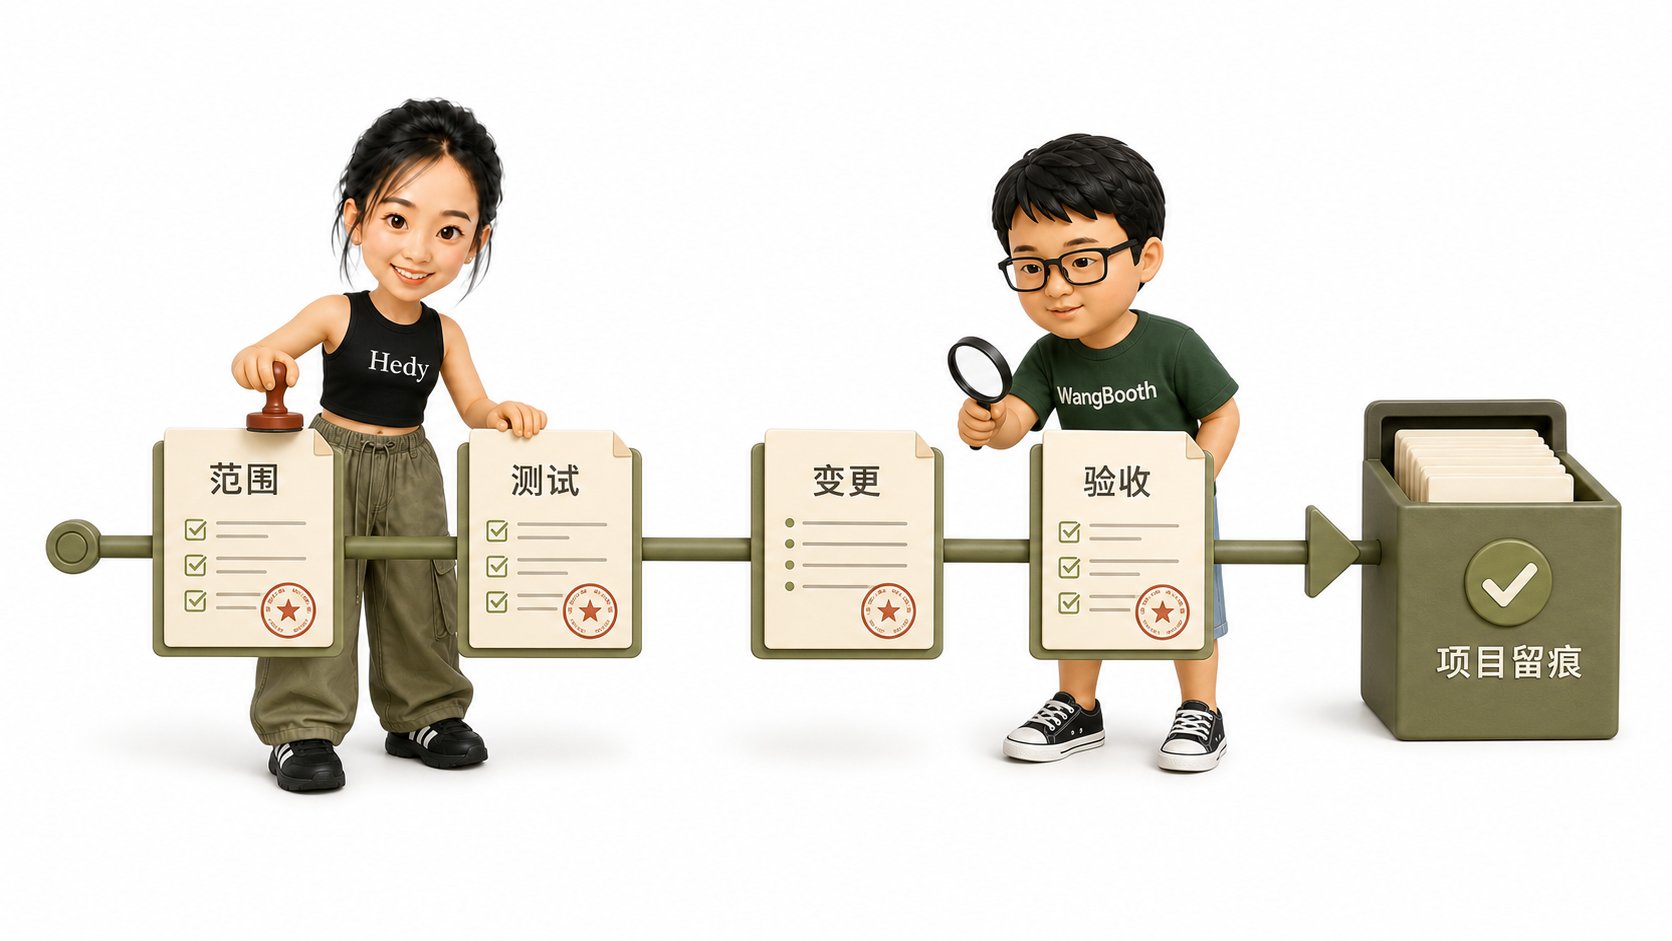
知识库交付过程中,暴露出的大量历史资料未数字化与规则口传问题,往往可以衍生出第二个独立的“数据治理项目”。但切记:不能把新需求偷偷塞回原项目,更不能做到一半再去扯皮。
企业 AI 交付的目标,不是证明 AI 什么都能做,而是把客户真正要用的东西,做到可以测试、可以验收,也能稳定运行。