
《99% 的人没看出来的数字人口播实战攻略》
作者: Rachel🥥 @Zesee
99% 的人没看出来的数字人口播实战攻略
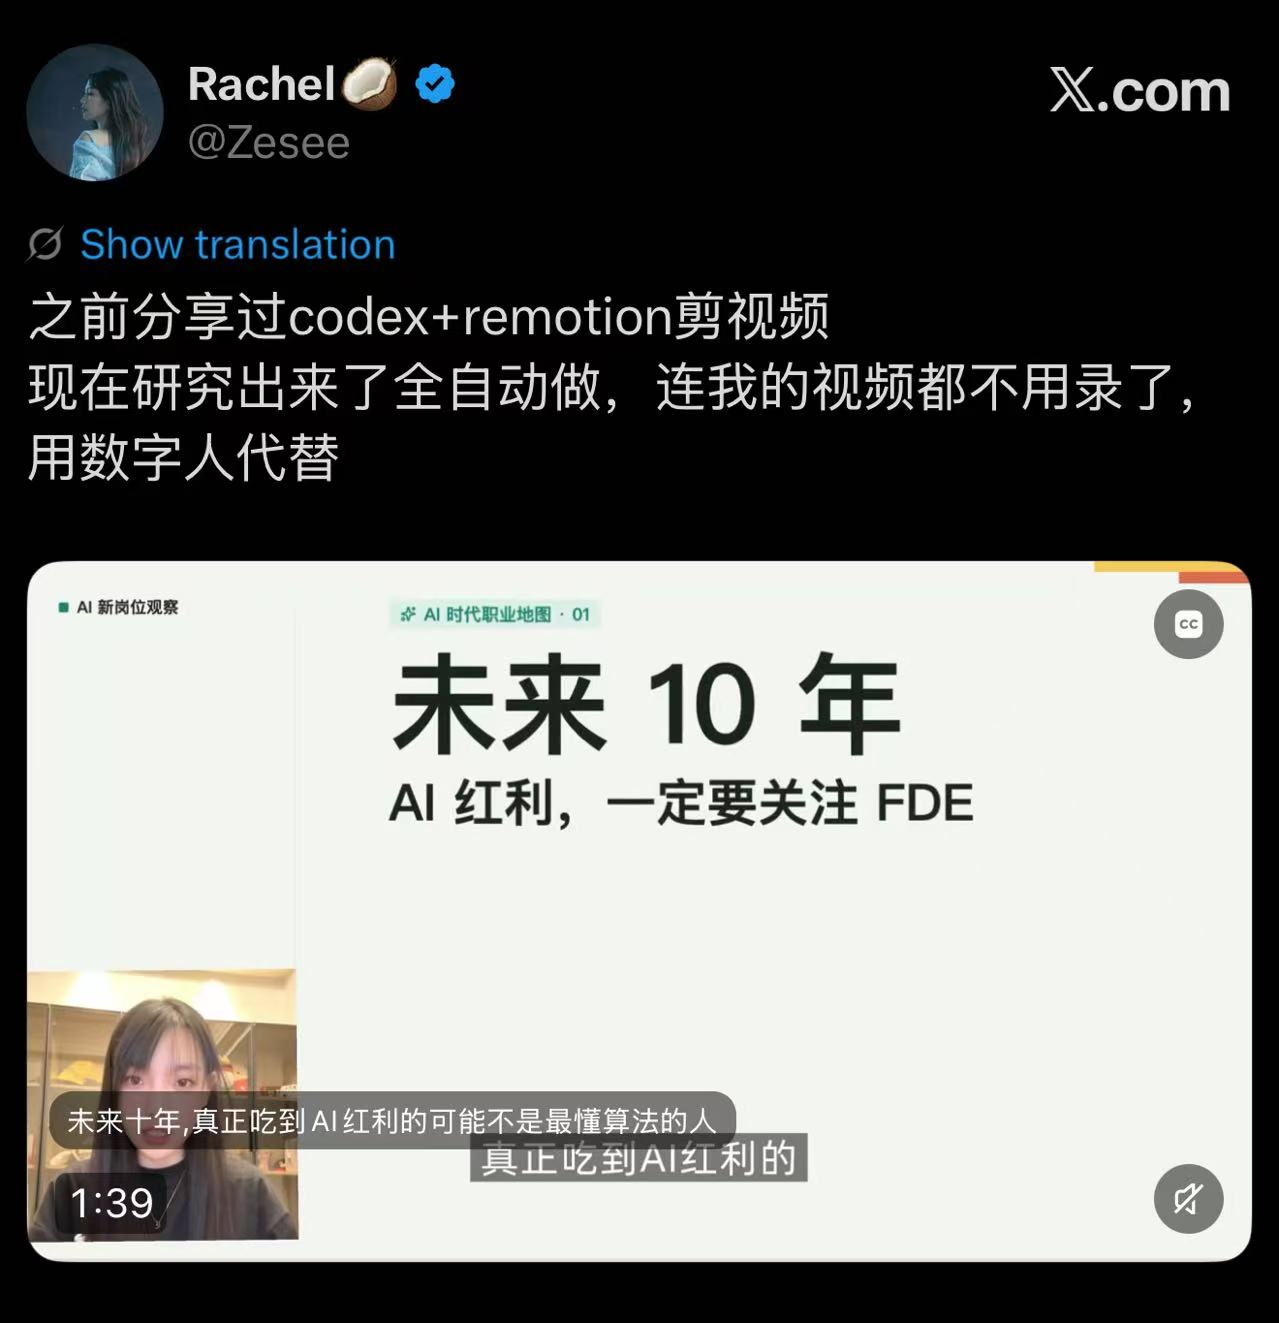
昨天发了一条数字人讲 FDE 的口播视频,很多人的第一反应不是问我用了哪个工具,而是根本不相信这真的是数字人。本文完整拆解如何把“声音克隆与画面驱动解耦”,并封装为可一键复用的 $rachel-digital-human-production Codex Skill。
昨天发了一条数字人讲 FDE 的口播视频,很多人的第一反应不是问我用了哪个工具,不相信这真的是数字人。我把整条数字人口播流程做成了一个可以复用的 Codex Skill。
GitHub 仓库:https://github.com/Jingyi-Wu-Richael/rachel-digital-human-production
这套方案适合知识口播、短视频批量生产、课程讲解、产品介绍、多语言内容和固定 IP 数字人账号。
01一、整条链路怎么分工
这套方案的核心,是把声音和画面拆开。
负责声音克隆和 TTS(生成高度还原本人语气与音色的 MP3)。
负责人像驱动、口型、表情和动作。
负责检查素材、调用流程、记录状态、控制风险。
完整链路是:
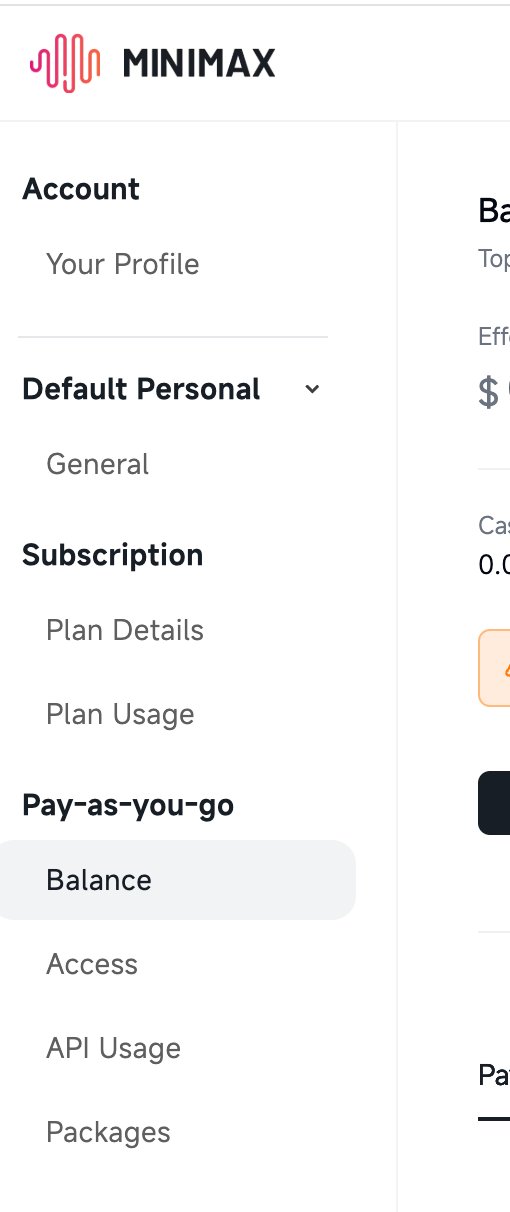
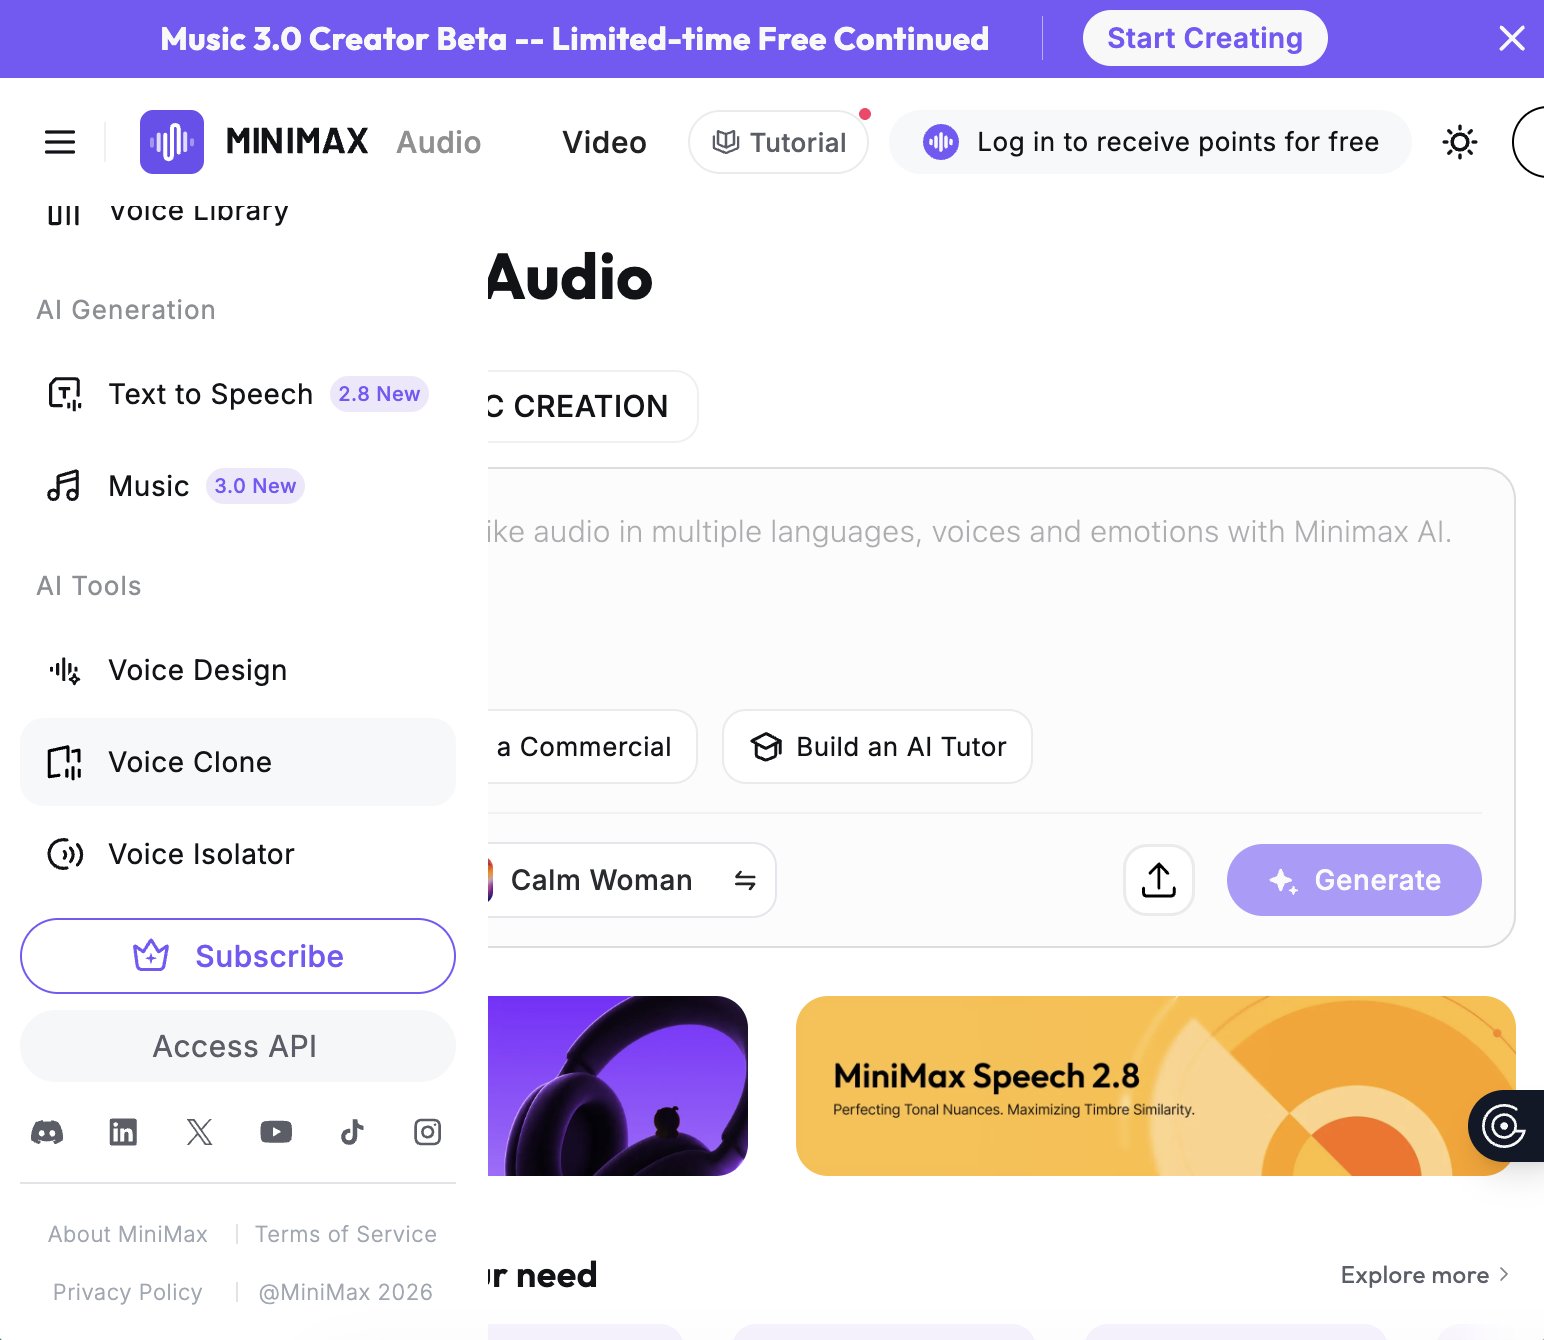
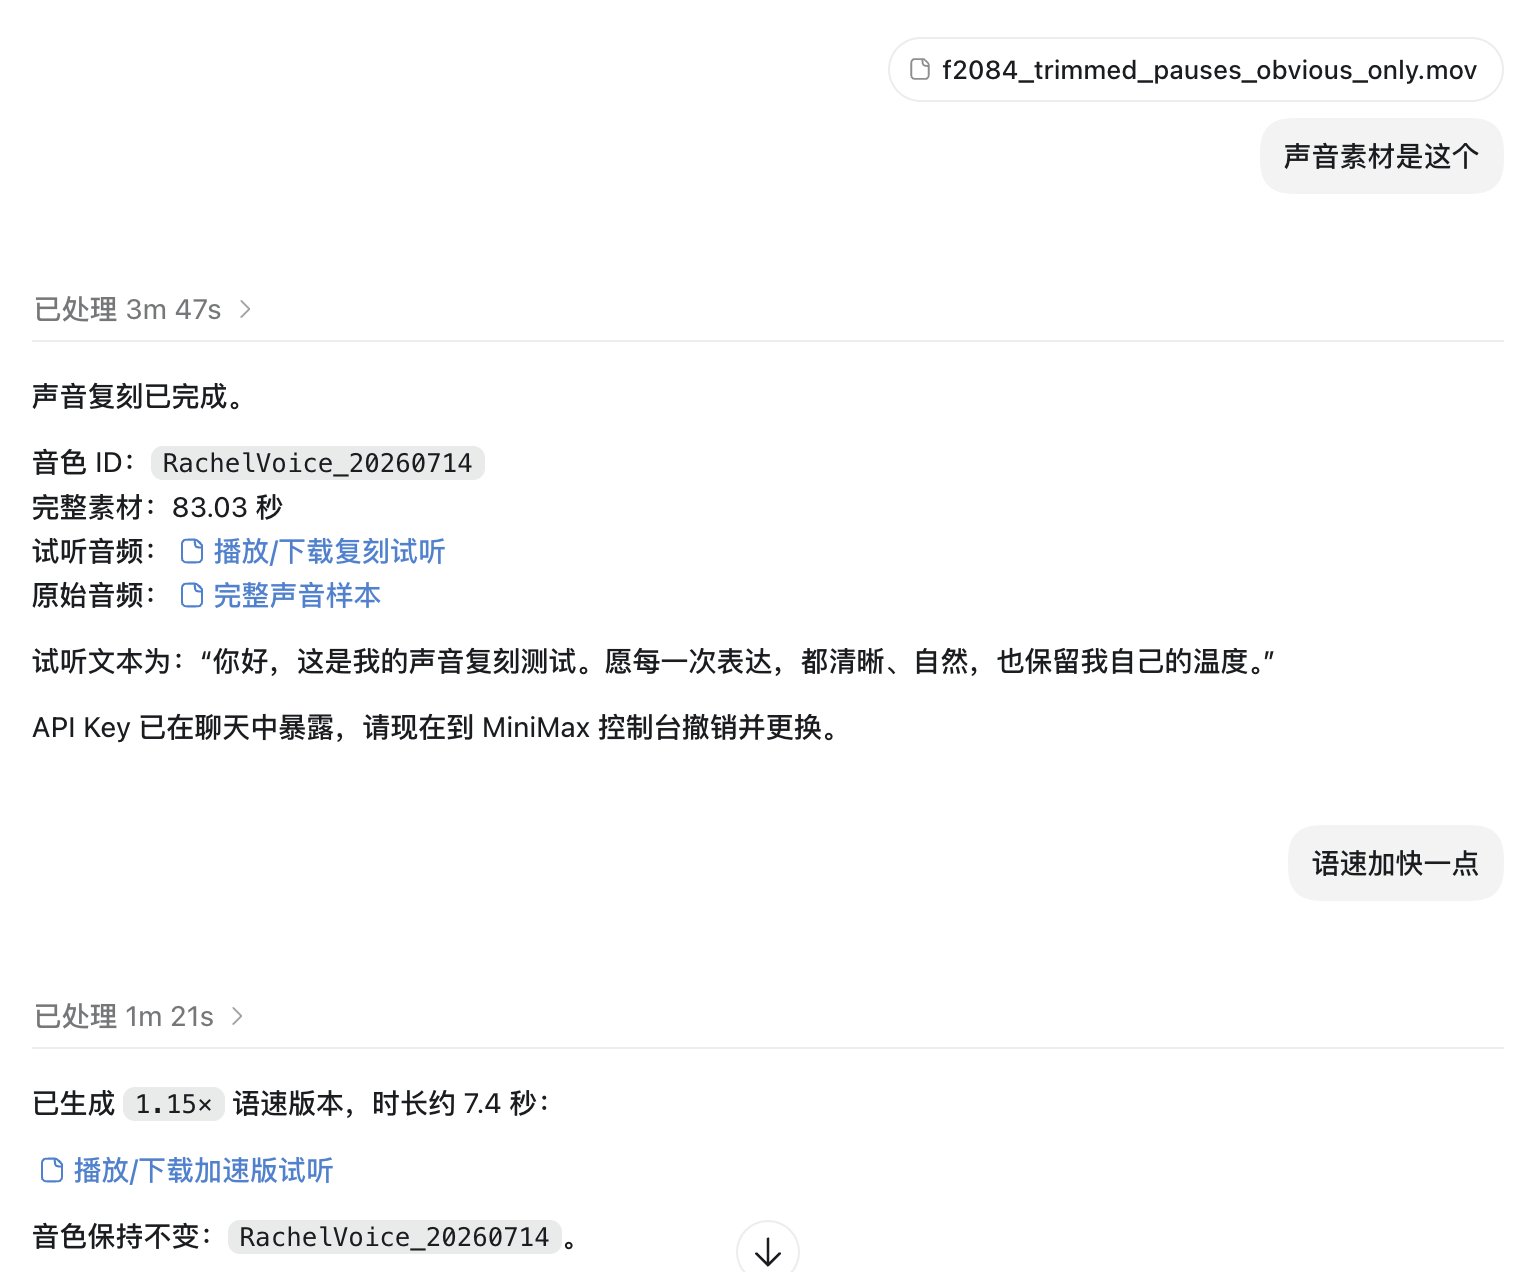
- 准备真人录音,用 MiniMax 海外版克隆声音。
- 把文案交给 MiniMax TTS,生成克隆音色的 MP3。
- 准备一张清晰正面人像。
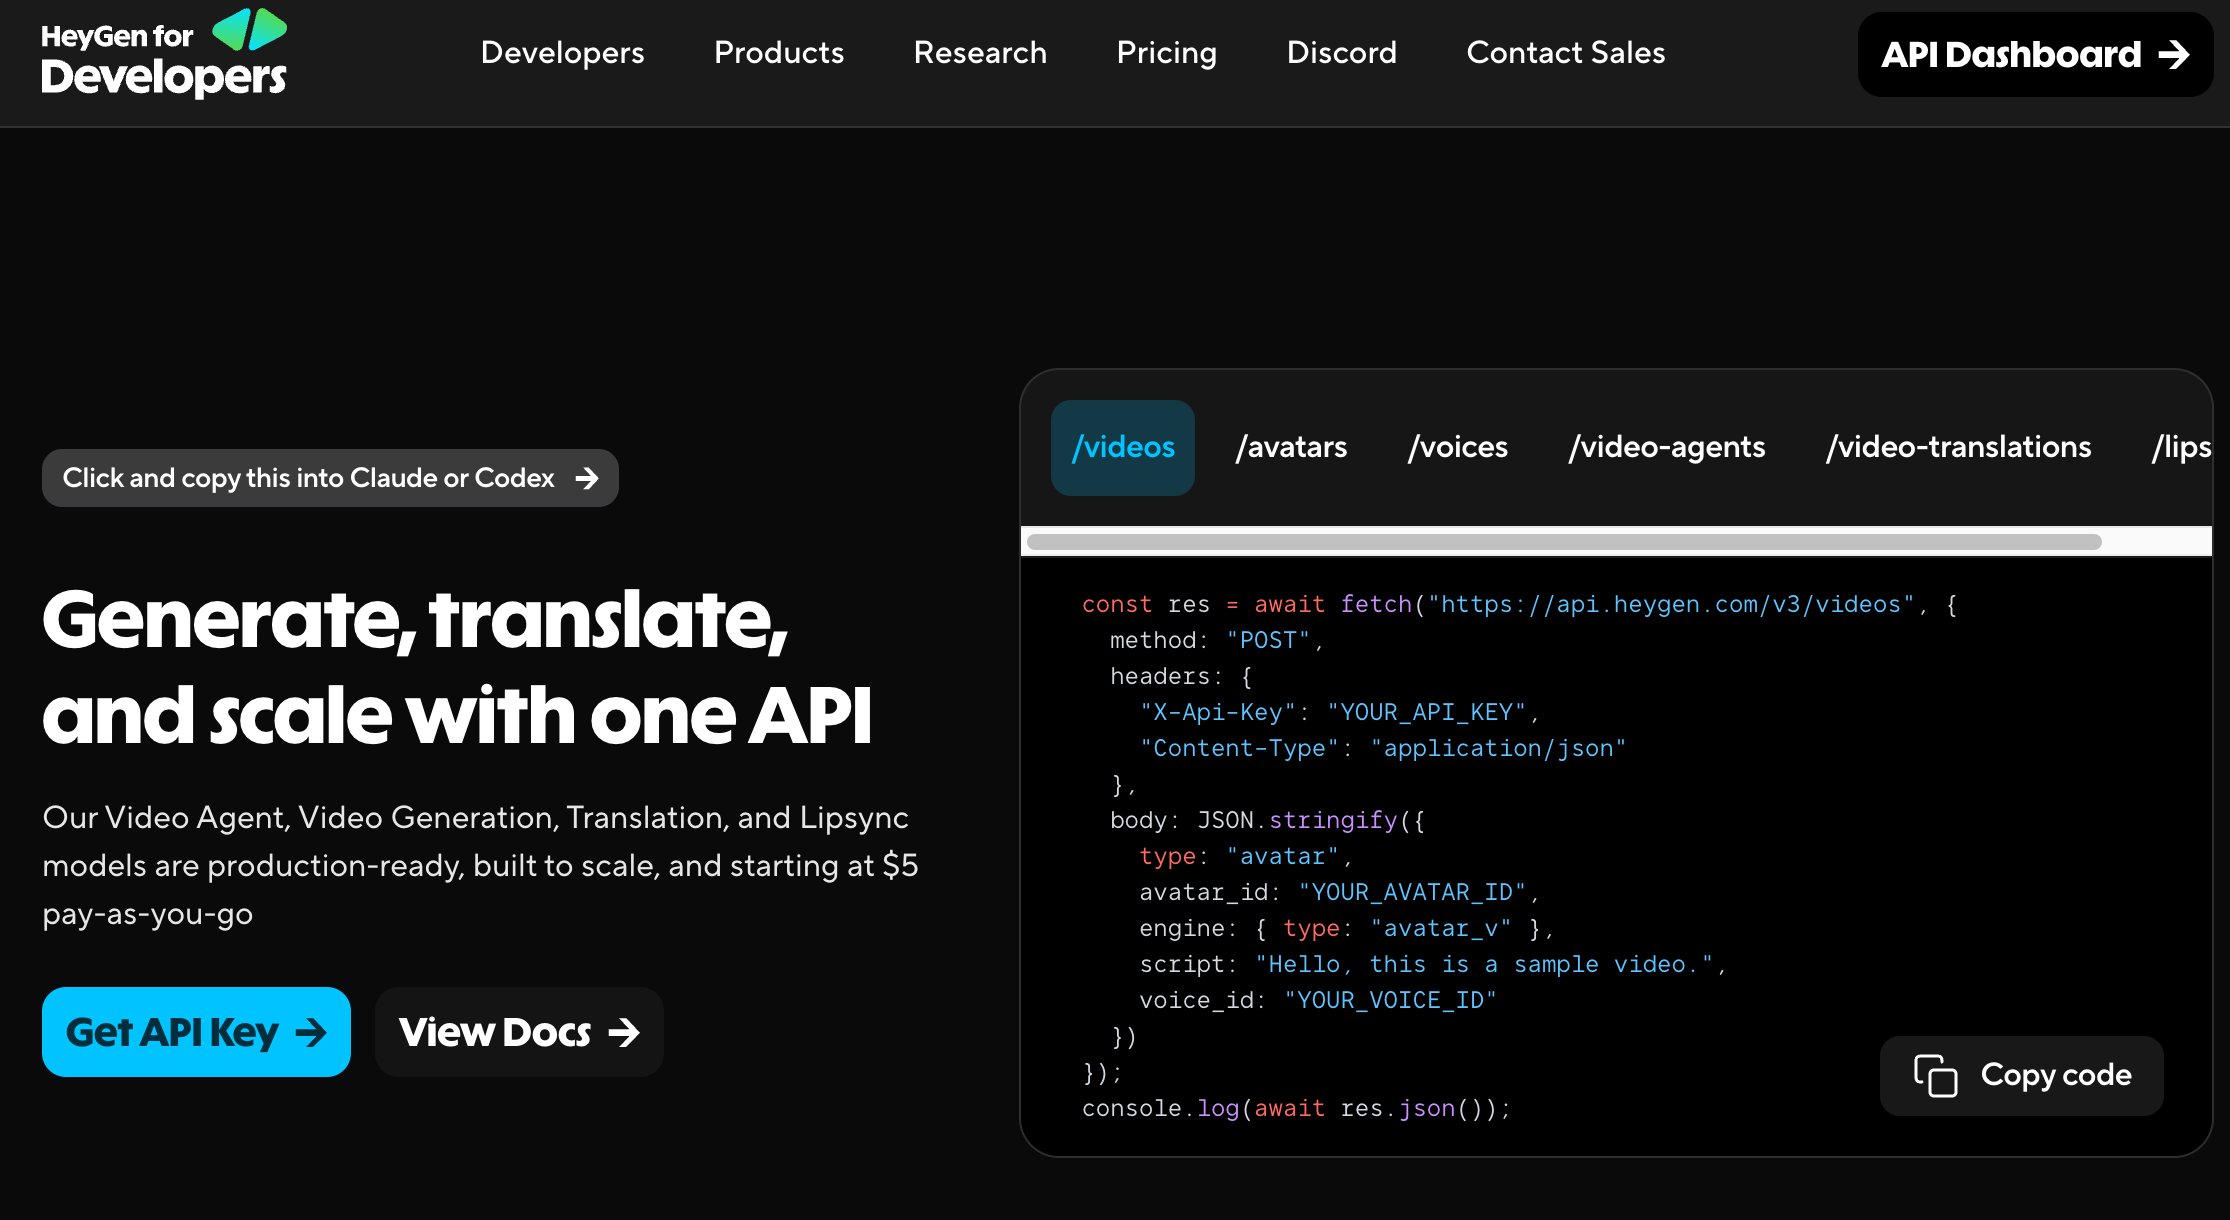
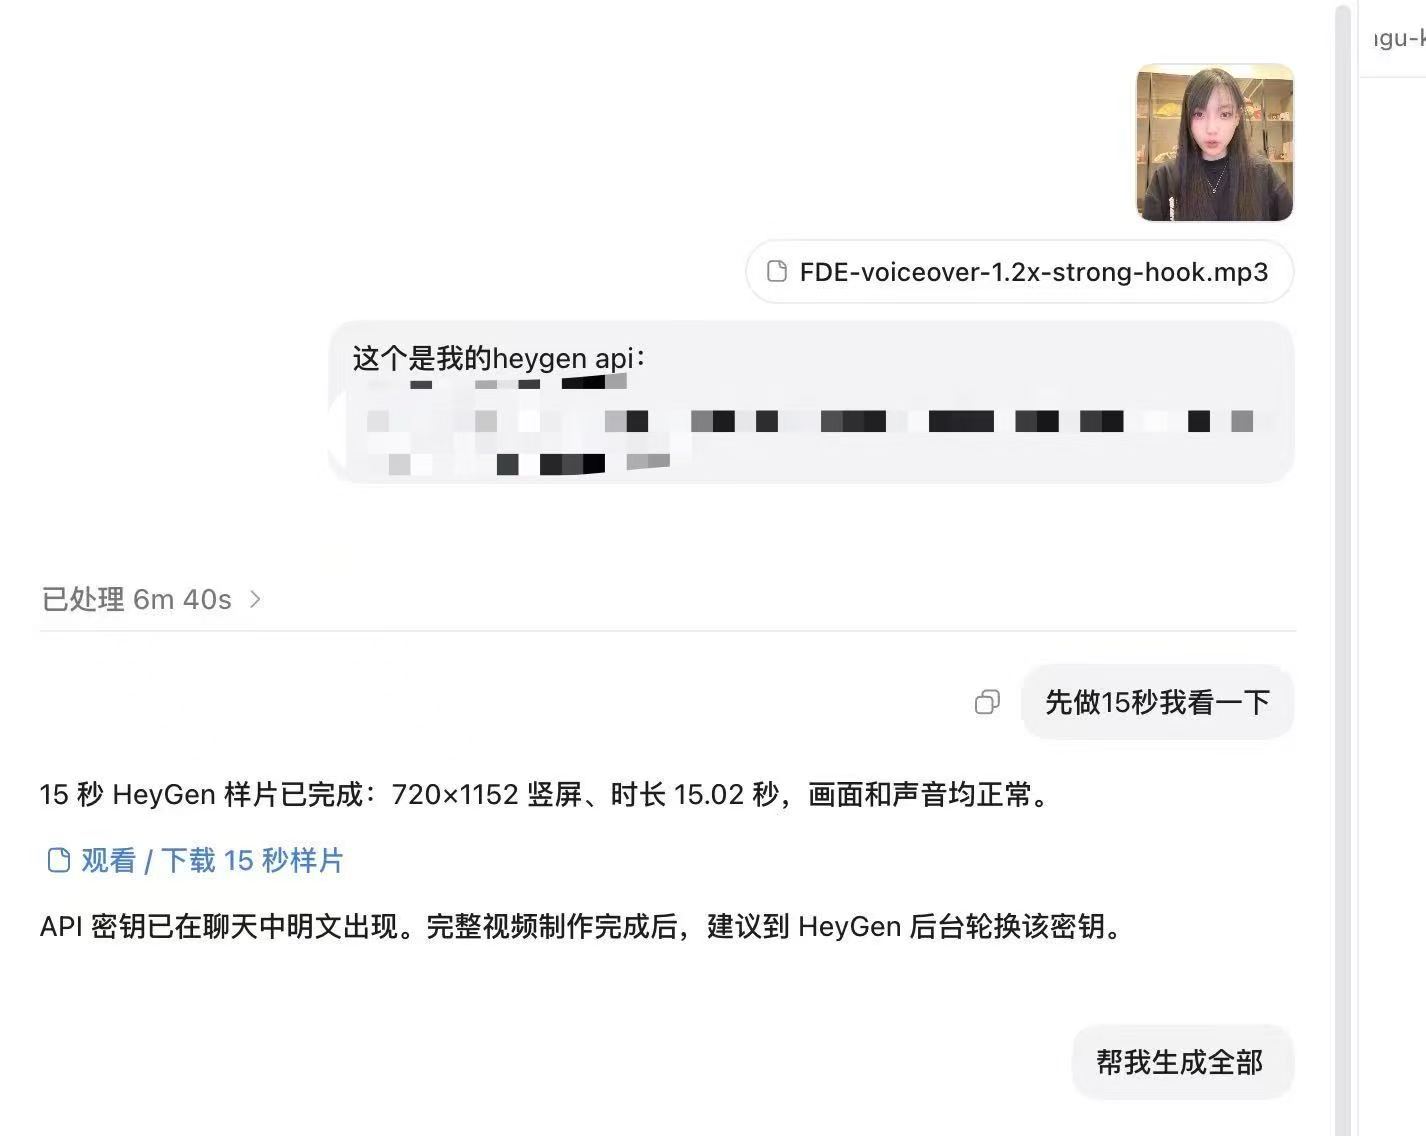
- 把人像和 MiniMax 生成的 MP3 上传到 HeyGen。
- 先生成 15 秒样片,确认后再生成完整视频。
如果目标是保留 MiniMax 的克隆音色,就应该把 MiniMax 生成的音频上传到 HeyGen,用这个音频驱动画面。不要切回 HeyGen 的 script + voice_id 方案,否则声音相似度会被覆盖。
02二、HeyGen 和 MiniMax 模式怎么选
第一次操作,建议直接用 Image-to-Video,调用 api key 即可,一次 2min 的视频大约消耗 2 刀。
它比较轻:不用一开始就训练 Avatar,只要上传一张人像和一段音频,就能快速看到口型、表情、脸部稳定性和构图是否可用。
HeyGen 模式建议
- 单条测试:先用
Image-to-Video。 - 固定账号长期生产:再做
Photo Avatar。 - 核心原则:没验证前不要急着训练 Avatar,测试阶段越轻越好。
MiniMax 模式建议
- 第一次测试:用海外版
Voice Clone克隆声音,再用 TTS 生成 MP3。 - 追求质量:优先选
speech-2.8-hd。 - 追求速度和批量预览:可以用
speech-2.8-turbo先跑测试。
03三、素材准备:不用复杂,但必须干净
声音克隆效果不好,很多时候不是模型不行,而是样本不干净。MiniMax 当前官方要求里,声音样本需要满足:
- 格式:MP3、M4A 或 WAV。
- 时长:至少 10 秒,最多 5 分钟。
- 文件大小:不超过 20 MB。
- 可选提示音频:少于 8 秒,并且要提供与音频完全对应的文字。
人像也一样,要干净:
- 正脸看镜头,五官无遮挡。
- 露出头、肩和上半身,人物占画面约 50% 到 70%。
- 嘴部清晰,不要被头发、手、滤镜遮挡。
- 竖屏短视频优先用 9:16 或接近 9:16 的图片。
- HeyGen Assets API 支持 PNG、JPEG 图片;普通素材上传单文件上限为 32 MB。
04四、怎么放进 Codex 执行
我会把每个数字人项目都按同一个目录结构放:
project/
├── inputs/
│   ├── portrait.jpg
│   ├── voice-source.mp3
│   └── script.md
├── work/
│   ├── voiceover-full.mp3
│   ├── preview-15s.mp3
│   └── job-state.json
└── outputs/
    ├── preview-15s.mp4
    └── final-1080p.mp4
然后对 Codex 说:
请用 MiniMax 海外版声音克隆和 HeyGen API 制作数字人口播。
输入:
- 文案:inputs/script.md
- 人像:inputs/portrait.jpg
- 声音样本:inputs/voice-source.mp3
- MiniMax 密钥来自环境变量 MINIMAX_API_KEY
- HeyGen 密钥来自环境变量 HEYGEN_API_KEY
流程:
1. 先检查素材。
2. 先生成 15 秒样片。
3. 样片确认后再生成完整版。
4. 所有任务 ID 写入 work/job-state.json。
5. 不要在日志、脚本或文档中显示完整密钥。你不需要相信自己每次都记得所有细节。你只需要把正确流程写进 Skill,让 Codex 每次按流程执行。
05五、这个 Skill 固定了什么
用 $rachel-digital-human-production 做这条视频,先只做 15 秒样片。06六、小 Tips 与官方参考文档
数字人视频最容易踩坑的地方,是成片不自然。
常见问题包括:声音不像本人、中文口型跟不上、脸部轻微变形、嘴角和下巴运动奇怪、眨眼和肩部动作不自然、构图不适合短视频平台。
所以我把“15 秒样片”写成强制步骤。先用 15 秒确认声音、口型、画面和构图。确认没问题,再跑完整视频。
数字人口播 Codex 指令定制器 & 15 秒样片质检清单
请调用 $rachel-digital-human-production(MiniMax 海外版声音克隆 + HeyGen API)制作数字人口播视频。
输入配置:
- 文案路径:inputs/script.md
- 人像底图:inputs/portrait.jpg(画面比例:9:16 (720×1152 竖屏短视频))
- 声音样本:inputs/voice-source.mp3(30~90s 干净干声)
- MiniMax 模型:speech-2.8-hd(语速倍率:1.15x)
- HeyGen 模式:Image-to-Video(严禁切回 script + voice_id,必须用 MiniMax 导出的 MP3 音频驱动画面)
- 密钥读取:环境变量 MINIMAX_API_KEY 与 HEYGEN_API_KEY

执行流程:
1. 先检查 inputs/ 下的文案、人像分辨率与声音样本合规性。
2. 使用 MiniMax 克隆音色并合成完整配音 work/voiceover-full.mp3,截取前 15 秒生成 work/preview-15s.mp3。
3. 先调用 HeyGen 生成 outputs/preview-15s.mp4 样片并暂停,等待我人工确认口型、眼神与构图后再生成 outputs/final-1080p.mp4。
4. 将 voice_id、asset_id、video_id 及任务状态实时记录至 work/job-state.json,失败不盲目重试。
5. 严禁在日志、脚本或状态文件中暴露 API Key、授权 Header 或临时下载链接。