💡 导读
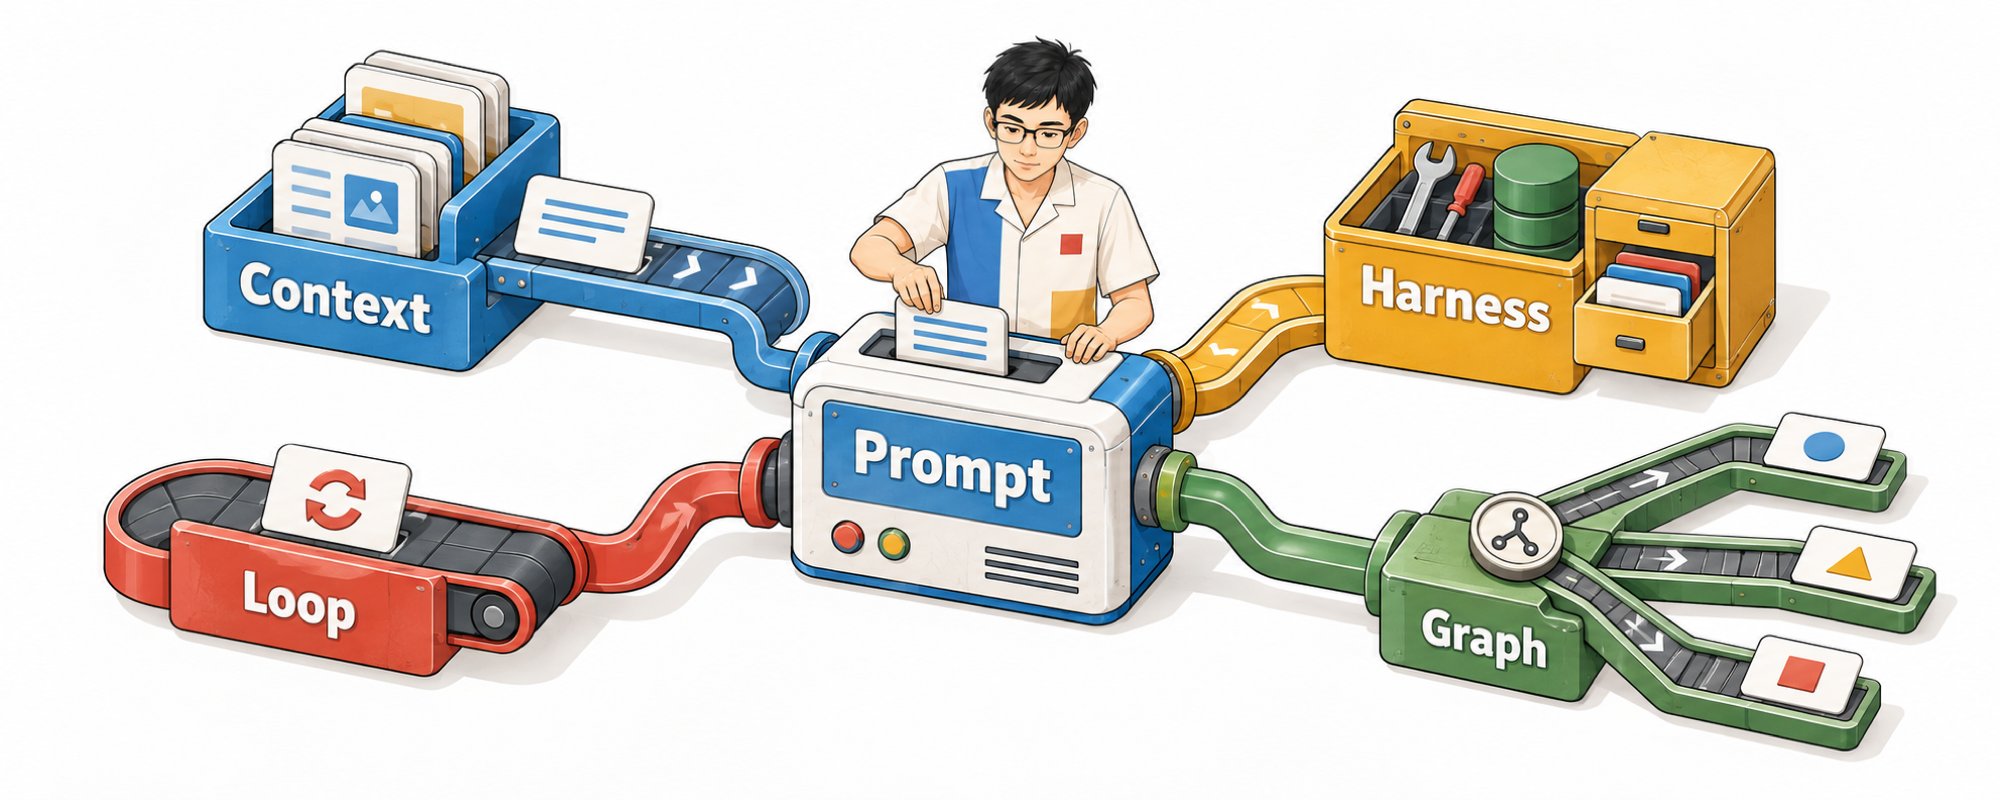
AI 圈最近两年造的新词太多了。Prompt Engineering 还没聊明白,后面又排起了长队:Context、Harness、Loop、Graph、Eval……看多了,确实容易晕。
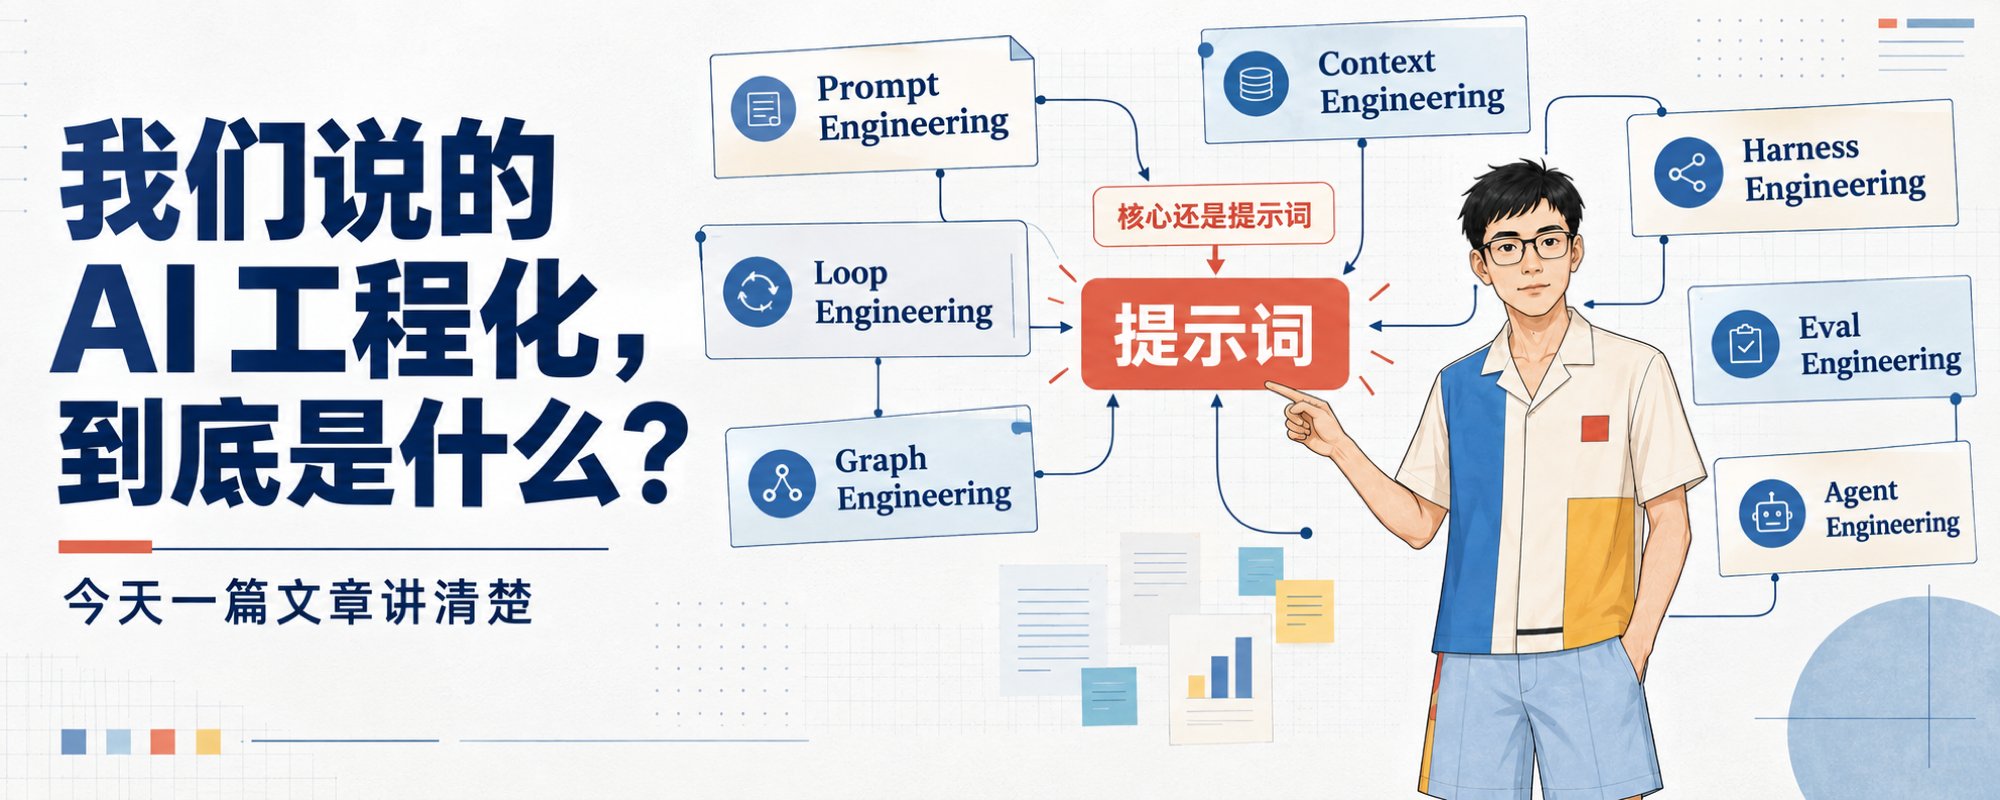
我先给出结论,后面慢慢说:从开发和工程落地的角度看,这些 Engineering 拆到最后,核心还是提示词。
只不过,今天说的提示词,不只是聊天框里那几句话。
它还包括系统给模型的规则、当前任务的资料、工具说明、历史结果、失败反馈和完成标准。只要模型能读到,并且会影响它下一步怎么判断,都属于提示词的一部分。
Agent 难在把事情做完
做一个能演示的 Agent 并不难。给它一个任务,再接几个工具,它就能自己搜索、读文件、调用接口,跑完以后还会告诉你任务已经完成。
真拿去做事,问题马上就来了。它可能重复做已经完成的步骤,调用了错误的工具,拿到一半结果就宣布结束,也可能在同一个错误上来回跑。
工程化要处理的,就是这些具体问题。模型这一步该看到什么,可以使用哪些工具,失败以后怎么改,什么情况算完成,走到哪里必须停下来交给人。
我们以前做 Agent 时,外层基本都离不开这套流程:
| 1 | 接收任务 |
| 2 | → 制定计划 |
| 3 | → 调用工具执行 |
| 4 | → 评估结果 |
| 5 | → 验证是否完成 |
| 6 | → 没通过就把原因送回去,再跑一轮 |
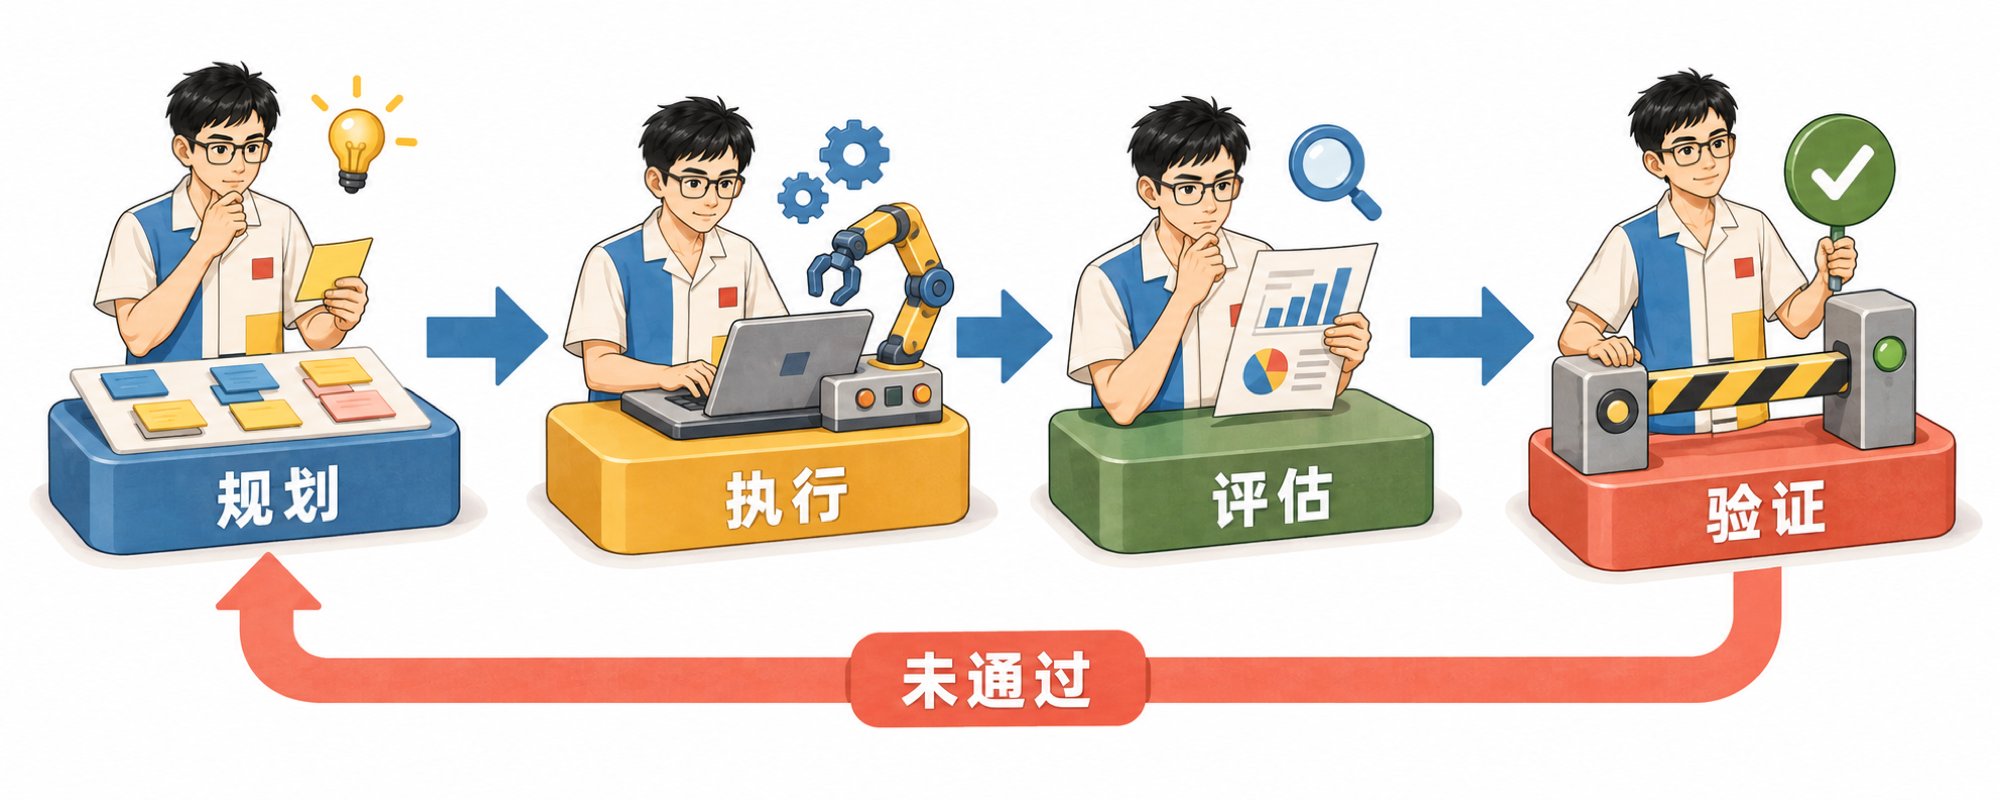
代码可以把这条路线搭起来,也能限制最大轮次。可每一步具体做什么、工具怎么选、结果够不够、失败以后补哪一块,还是要让模型根据提示词作判断。
提示词到了 Agent 里,早就超出了一次问答的范围,它会跟着任务不断变化。后面这些 Engineering,基本都在拆这套系统里的某一个问题。
🖼️ 深度技术架构解读 · 全景技术栈分层
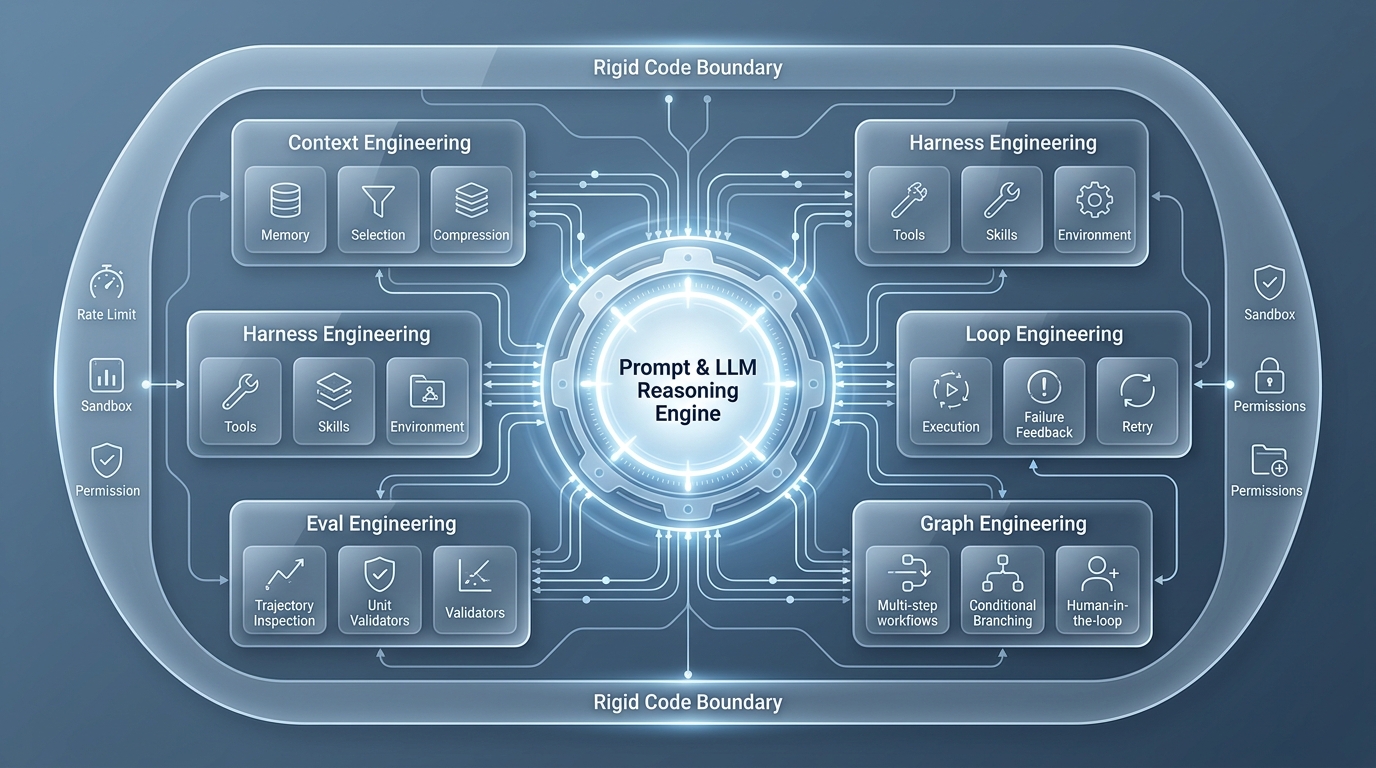
为了帮助读者从更高维度理解原作者提出的“五大 Engineering 拆到最后核心还是提示词”,下图梳理了从最底层的物理代码硬边界、到环绕外围的五大工程支柱、再到核心 LLM 动态 Prompt 组装的完整架构蓝图:
Context Engineering:这一轮到底给模型看什么
一次问答很简单,用户的问题和几份资料一起发给模型就行。可 Agent 连续工作几十步以后,历史记录、工具结果、中间文件、错误信息会越积越多,不可能每一轮都原样塞进去。
塞得少,模型不知道前面发生过什么;塞得多,旧资料和无关结果又会把它带偏。两头都不对。
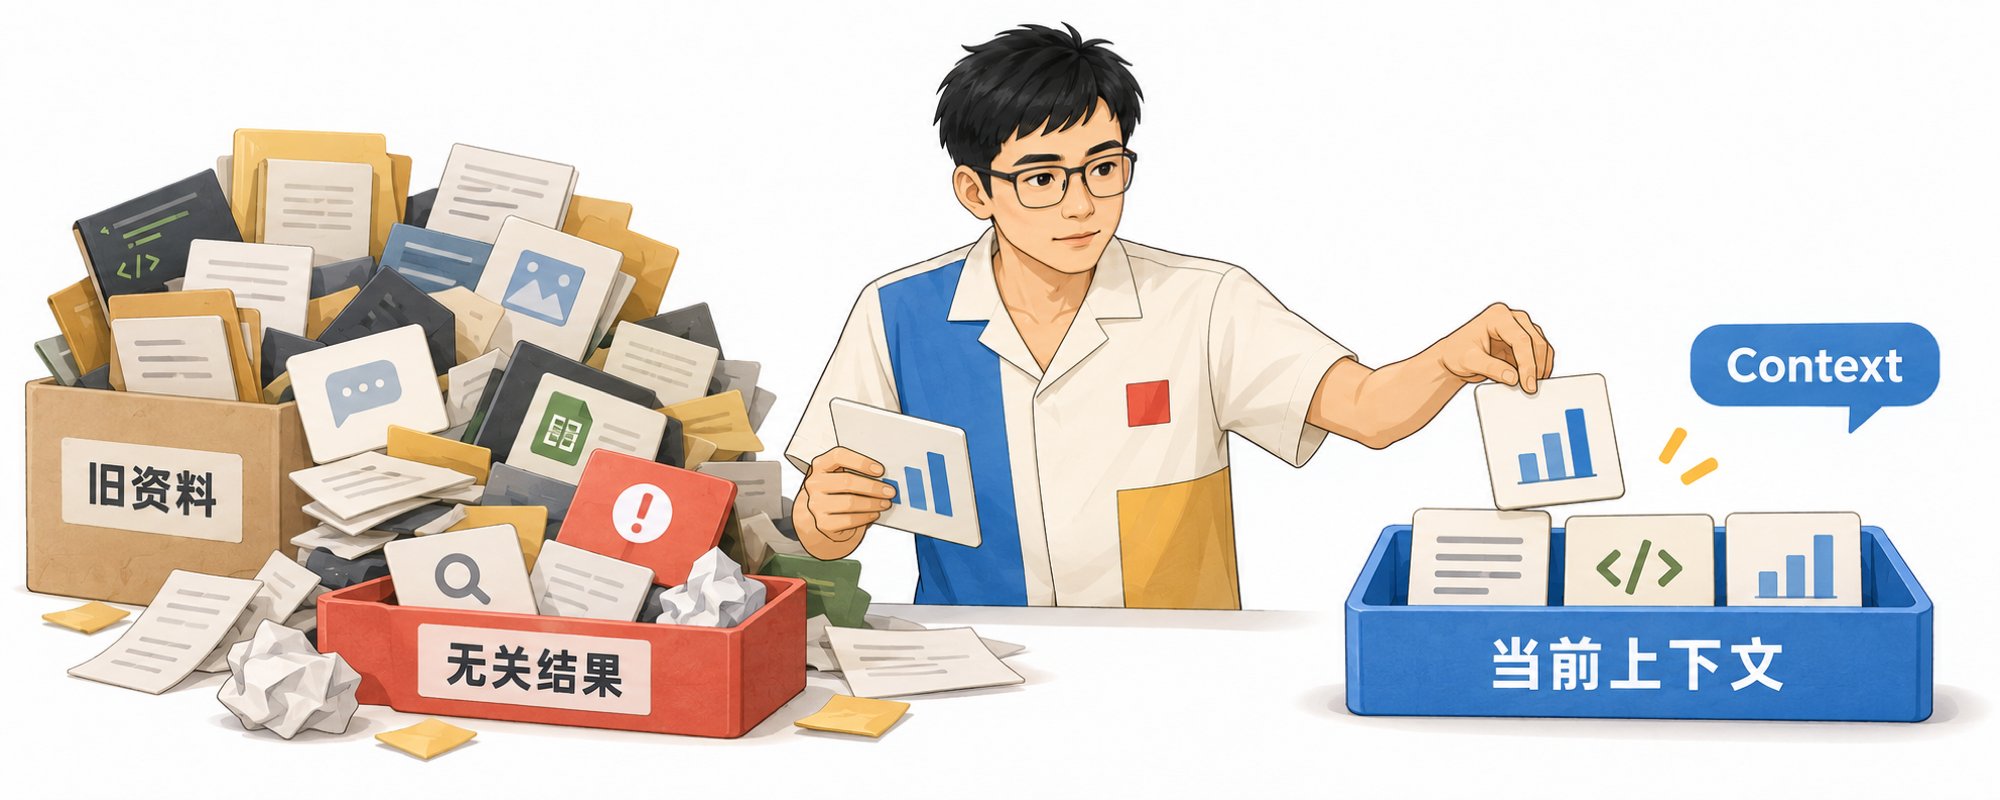
Context Engineering 处理的,就是这一轮该给模型看什么。第一次规划,需要的是用户目标、可用工具和限制条件;执行失败以后再规划,则要补上失败原因、已经做过的步骤和当前结果,不然它很容易把旧路再走一遍。
LangChain 把常见处理分成 Write、Select、Compress 和 Isolate。换成开发里的动作,就是先保存中间结果,需要时再挑出来;内容太长就压缩,不同任务分开处理,别让所有信息挤在同一个窗口里。做完这些,最后还是要组成模型下一次调用时看到的提示词。
Harness Engineering:把工具交给模型,也得把话说明白
模型本身只能生成内容。要让它搜索网页、读取文件、查询数据或者操作软件,就要在外面接上工具、Skills、记忆、中间件、权限和运行环境,这一圈东西现在常被叫作 Harness。
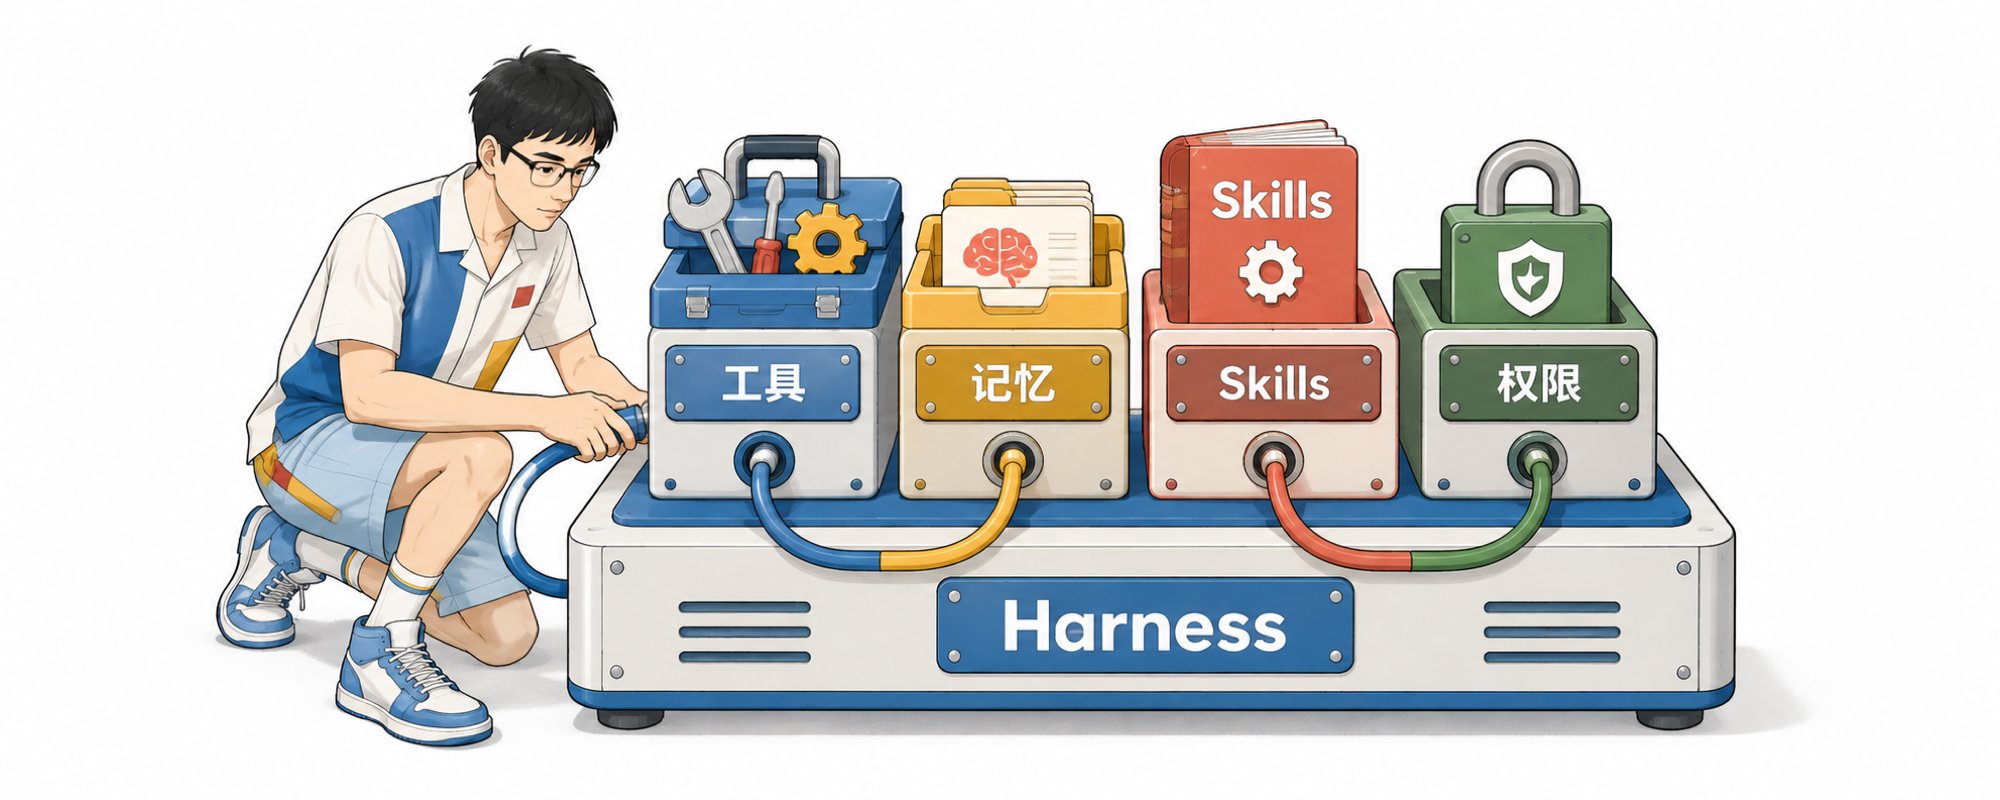
工具本身好不好用,是开发工具时要解决的问题。Agent 会不会用,则取决于工具说明有没有把话说清楚:它能做什么,需要哪些参数,返回结果怎么读,什么情况下别去碰。
工具名称很像,模型会选错;参数说明含糊,计划看着没问题,一执行却拿不到结果。记忆也是同样的道理,内容保存在硬盘里还不够,得在正确的时候取出来,放回当前上下文。
Skills 也是提示词。它把一类任务的做法提前整理好,需要时再把对应规则交给模型,不用每次从头解释。Harness 做的,就是把这些东西装到模型周围,并在合适的时候告诉它现在能用什么、该怎么用。
Loop Engineering:让它根据结果继续
Agent 和普通问答最大的区别,是它做完一步以后还会看结果。搜索没有找到答案就换关键词,工具调用失败就改参数,资料不完整就继续补,验证通过以后才结束。
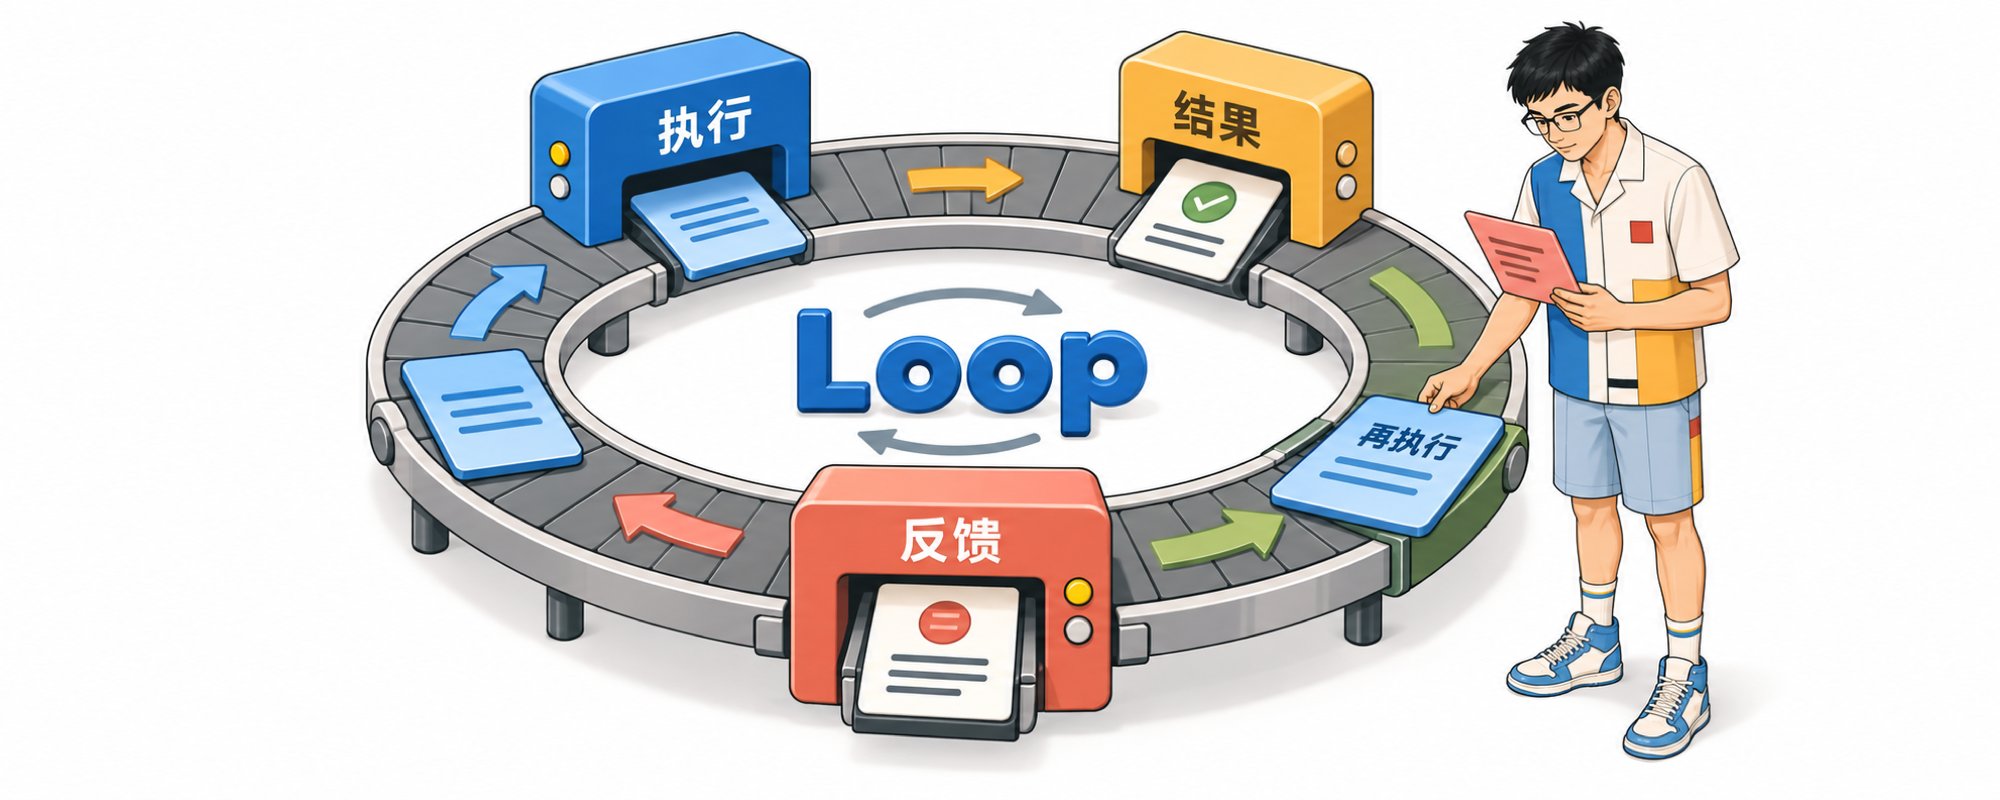
代码里的循环只能保证它再跑一轮,不能告诉它下一轮怎么改。下一轮会不会换个做法,要看上一轮的结果和失败原因有没有准确地送回模型。
如果反馈只有一句“失败了,请重试”,模型很可能原样再做一次。更有效的做法,是把没通过的项目写清楚:哪一步失败、缺什么、哪些步骤已经完成、下一轮允许调整什么。
最大轮次可以由代码写死,它相当于刹车。Loop 能不能越跑越接近目标,看的仍然是完成标准和失败反馈有没有说清楚。
Agent 循环机制与结构化反馈模拟器
“如果反馈只有一句‘失败了,请重试’,模型很可能原样再做一次。”
环境执行结果: 后端抛出 422: Invalid parameter type.
环境执行结果: 接口返回 200 OK: {"growth_rate": "+27.56%"}
Eval Engineering:别只看最后那句话
最近又有人开始讲 Eval Engineering。这个词背后的问题很实际:Agent 说“任务完成了”,不代表它真的把事情办完了。
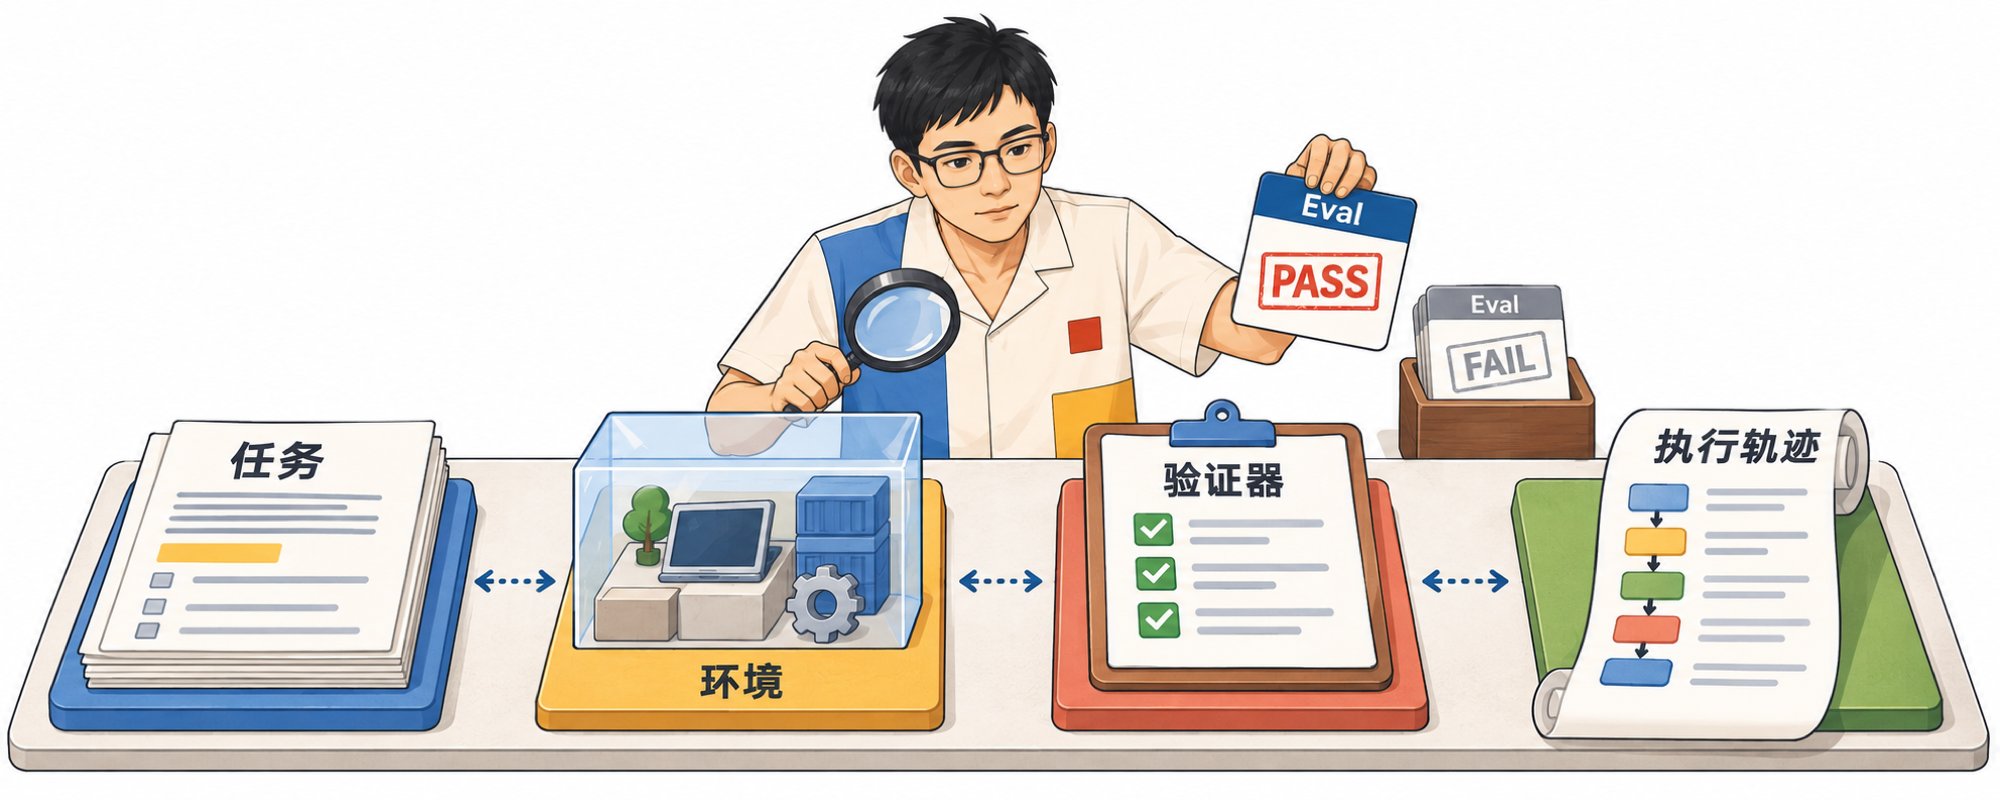
只看最后一段回答,很容易放过过程里的问题。它可能用错了工具、漏掉了关键步骤,也可能碰巧给出一个像样的结果,实际却没有满足原任务。
评估不能只盯着答案,还得看任务、运行环境、验证器和执行轨迹。更麻烦的是,验证规则本身也可能写错;标准含糊,Agent 就会钻空子,拿到高分却没把事情做好。
LangChain 最近提到一种做法:从真实运行记录里找失败,把它还原成可以重复执行的任务,再比较修改提示词、工具或流程以后有没有改善。评估可以放在运行中,也可以放在运行后;只要还需要模型判断“够不够好”,完成标准就得先写清楚。
Graph Engineering:路线可以固定,判断不能全写死
任务复杂以后,一条直线不够用了。验证通过就进入下一步,资料不足就回到搜索,碰到高风险操作就暂停等待人工确认,不同任务也可以并行执行。
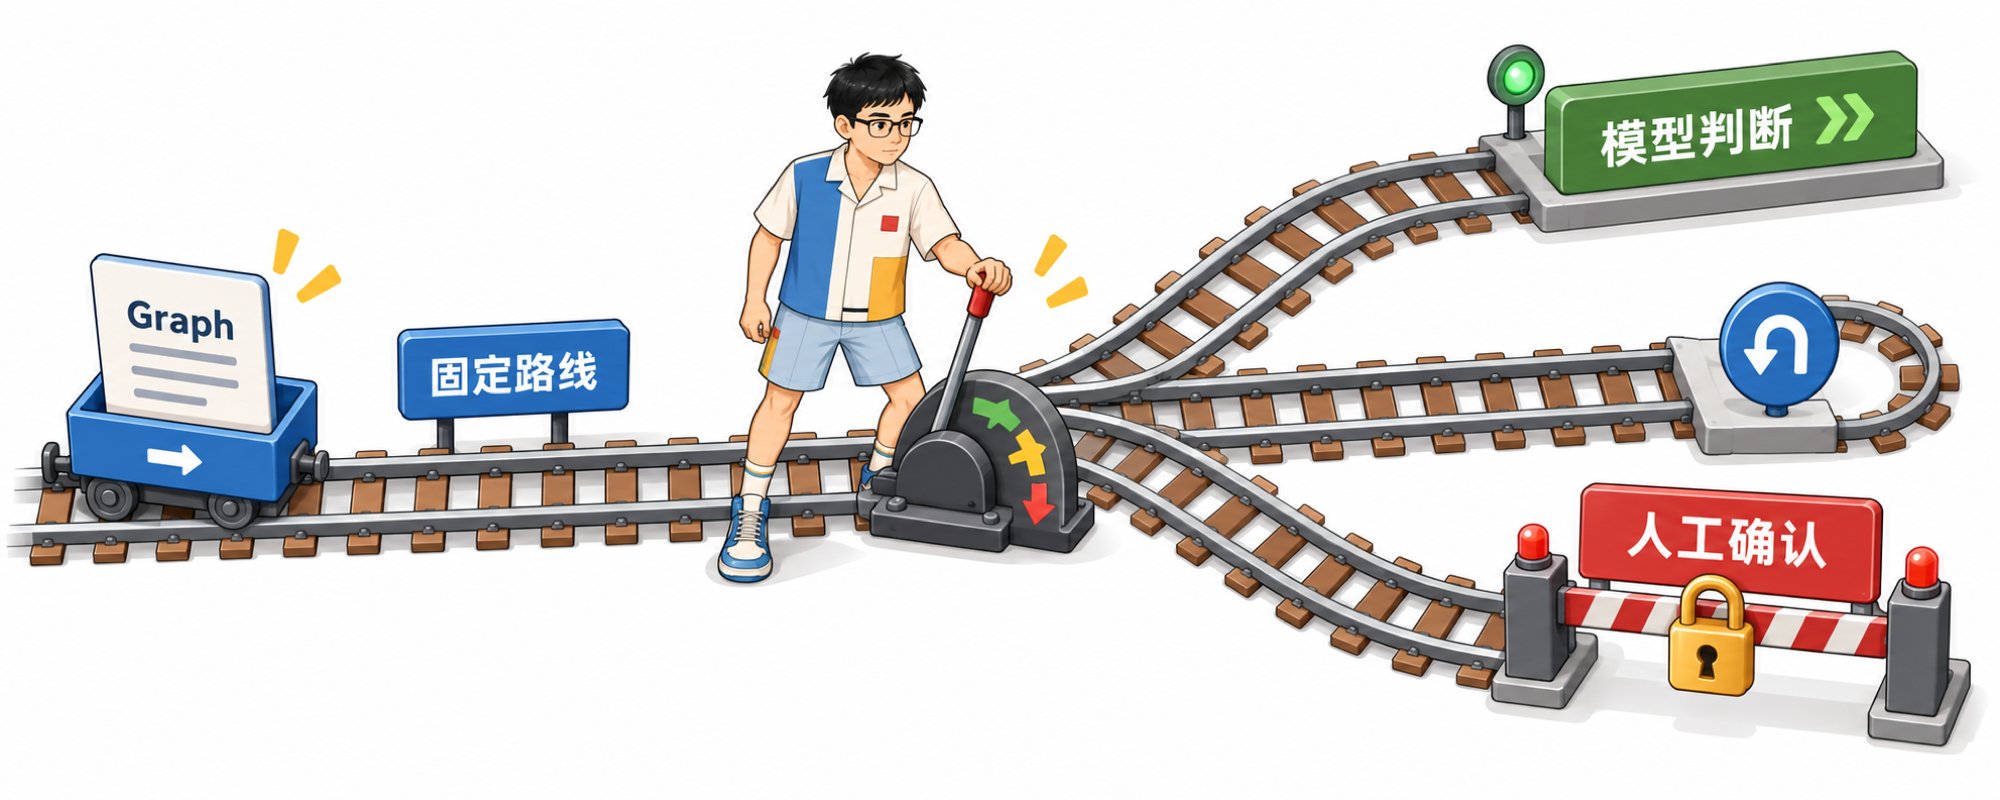
这些节点和路线连在一起,就是 Graph。代码可以规定哪个节点先跑、哪条边不能绕过、什么地方必须停。
但节点里面只要还有 Agent,模型就需要一份当前节点的提示词。它要看到任务、上一步结果、可用工具和通过条件,再决定这一段怎么做,以及把什么结果交给下一个节点。如果每一步、每个输入和每个结果都由代码写死,那就是普通工作流软件,用不上 Agent。
Graph 决定模型下一步去哪里,Prompt 决定它到了那里以后怎么做。
AI 工程化解构沙盘 & 动态 Prompt 透视台
Interactive Studio“这些 Engineering 拆到最后,核心还是提示词——只是不仅是聊天框里那句话。”
这一轮到底给模型看什么?塞得少失忆,塞得多迷失
持久化会话快照、检索相关切片、计算当前剩余 Token 预算、敏感数据物理脱敏
基于当前任务目标,引导模型在有限视窗内聚焦核心变量,忽略历史杂音
// [Context Engineering 动态装配示例]
<system_rules>
当前任务阶段: 阶段2-数据提取
已消耗 Token: 2,410 / 8,000 上限
可用上下文: [仅保留近 2 轮核心决策 + 3 条结构化工具结果]
历史任务摘要: 用户已确认查询 2026 年 Q1 财报,已成功定位 PDF 索引。
</system_rules>
代码管边界,提示词管判断
说提示词是核心,不等于所有东西都要写进提示词。最大运行次数、文件权限、付款审批、数据访问范围,这些应该由代码和系统权限直接控制。
提示词负责的是边界里面的判断。任务怎么理解,工具怎么选,结果怎么评,失败以后补什么,这些地方才需要模型。
没有代码兜底,Agent 可能越界或者一直跑;没有提示词,Graph 里只剩一堆空节点,工具摆得再多,模型也不知道该怎么用。工程化要做的是分清边界:该写死的写死,交给模型判断的部分,把上下文、工具说明、判断标准和反馈讲清楚。
🖼️ 架构蓝图 · 边界与职责划分全景图
牢记 SRE 与 Agent 架构设计的铁律:物理硬边界属于确定性逻辑,软推理属于概率性语义决策。
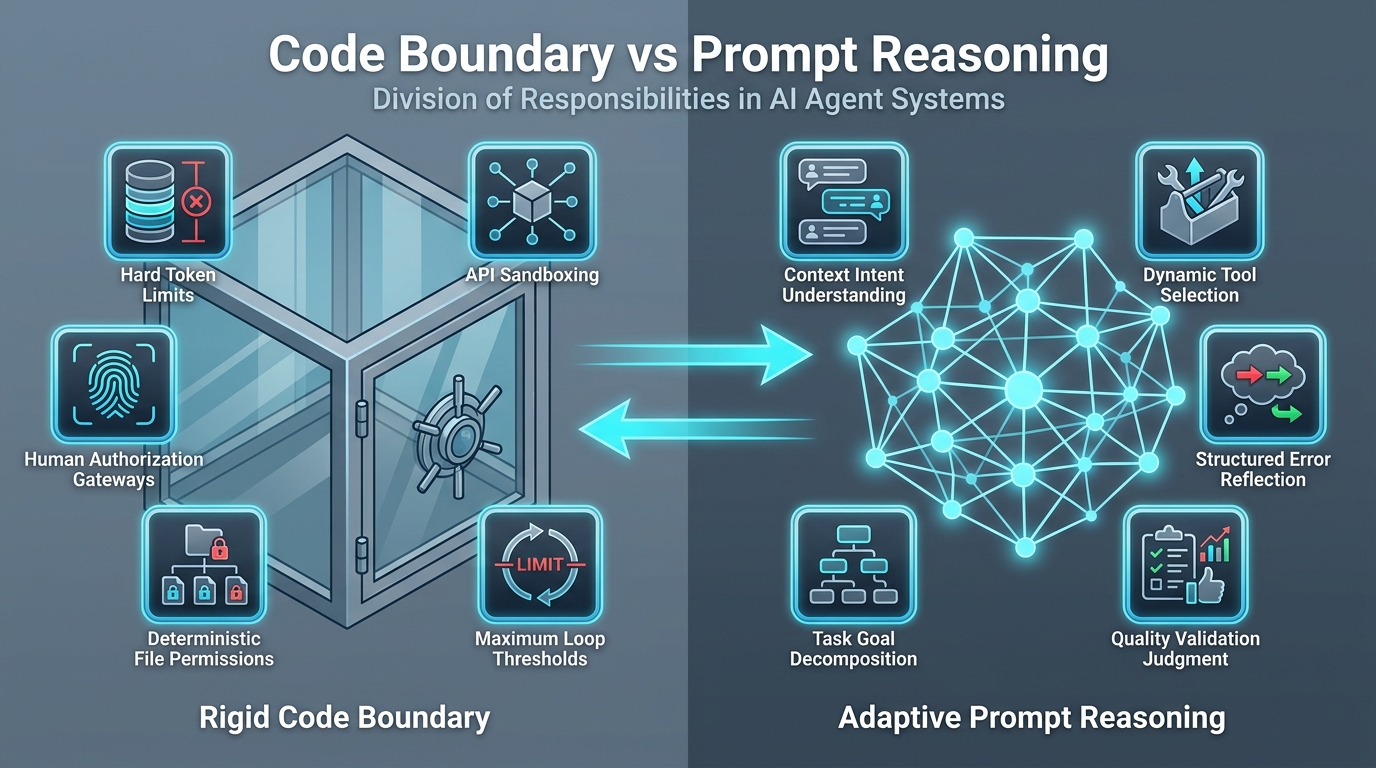
代码管边界 vs 提示词管判断:工程职责判定矩阵
“没有代码兜底,Agent 会越界狂奔;没有提示词,Graph 只剩一堆空节点。”
限制 Agent 最多连续调用外部工具 10 轮,达到阈值必须硬终止。
从用户的自然语言“帮我挑一台适合大学生剪视频的轻薄本,预算6000”中提取核心参数。
拦截任何 DROP TABLE、TRUNCATE、DELETE 缺少 WHERE 条件的高危写操作。
拿到搜索回来的 5 篇网页摘要后,综合判断当前信息是否足够写一份研报。
保管 OpenAI API Key、Stripe 支付密钥,确保在任何日志和输出中不外泄。
根据企业既有前端规范,在 Vue 3 和 React 之间选择更符合老系统的技术栈并编写组件。
这些 Engineering 到底新不新
这些问题并不新,我们以前做 Agent 时已经在处理。工具怎么交给模型、结果怎么回到下一轮、流程哪里要固定,一样都不能少。
Agent 做的任务越来越长,提示词也从一句话变成了一个运行中的系统。以前只关心一次回答,现在还要处理每一步的上下文、工具、反馈、评估、流程和退出条件,于是每一部分都有了自己的名字。
所以我看这些新词,不会先去背定义。我会先看模型这一刻收到了什么,失败结果怎么回去,哪一步由代码锁死,哪一步还需要模型判断。
在我看来,Context、Harness、Loop、Eval、Graph 解决的是提示词放在哪里、什么时候更新、怎样和工具及流程配合,以及评估拿什么作标准。名字变多了,模型每一步收到的,还是任务、资料、工具说明、判断标准和反馈。
我叫 Miles,我用了一个月做到 2 万粉,一周写出三篇百万曝光长文,其中两篇超过 200 万。我把以前做 Agent 的过程重新翻出来,就是想把这件事讲清楚。