
参考图迁移 · 提示词框架# 参考图迁移•8 分钟•作者: 南鸢 nuyoah @nanyuan0412
如何玩转参考图?我总结出了这句短提示词:风格迁移与 17 个视觉维度实战拆解
玩转参考图不用写几十行玄学描述!提炼出“一句话短提示词骨架”,深度拆解光影、色彩、景深、机位、运动、锐度等 17 个独立视觉维度,附 17 维交互提示词生成工坊与 LUT 级风格叠加实测。
南鸢 nuyoah (@nanyuan0412) 原创实战复盘 · 17 个视觉维度真实对照试验与短提示词方法论
痛点直击:为什么传统参考图提示词又臭又长,还总翻车?
在做影视分镜、电商视觉或多风格设计时,我们经常需要把一张图片(参考图)中的某些感觉迁移到另一张图片(底图)上。 但过去常见的做法通常是让 AI 或自己手动写出极度冗长繁琐的描述:分析是金色侧逆光、几十毫米镜头、光圈多大、景深多少、透视畸变多少……
实测结果发现: 这么复杂的提示词不仅极其累人,而且生图模型往往在过多技术参数中迷失,引入很多不需要的多余细节。经过大量对比实测,“把提示词写短,直接利用模型本身的图像语义对齐能力”,反而能够极快地拿到高质量的方向稿!
核心公式:一句话搞定参考图风格迁移的短提示词
这套提示词模板的核心逻辑极其简单利落——明确告诉大模型:从参考图提取什么维度,并严格锁死底图的主体与核心内容。
INTERACTIVE SHORT PROMPT BUILDER
17 维迁移提示词交互积木工坊
第一步:勾选你希望从图一借取的视觉维度(可多选组合):
光线与调色
成像与质感
摄影与空间
造型与媒介
第二步:选择对图二(底图)的约束程度:
生成的短提示词:
将图一的【光线氛围与明暗关系、色彩倾向与色彩分级】迁移到图二,保持图二的主体身份与主要内容。
💡 使用建议:在 Midjourney、Flux、GPT-Image 2.5 或 Qwen-Image 2.1 中,将参考图作为图一(Image 1),底图作为图二(Image 2),直接输入此短提示词即可。
一、震撼实测:同一张底图的 17 个视觉维度拆解总览
为了严谨验证“短提示词”的边界,南鸢选用了一张高难度的女孩窗边阅读照片作为标准底图,固定单变量逐一测试了 17 种不同维度的风格迁移效果:
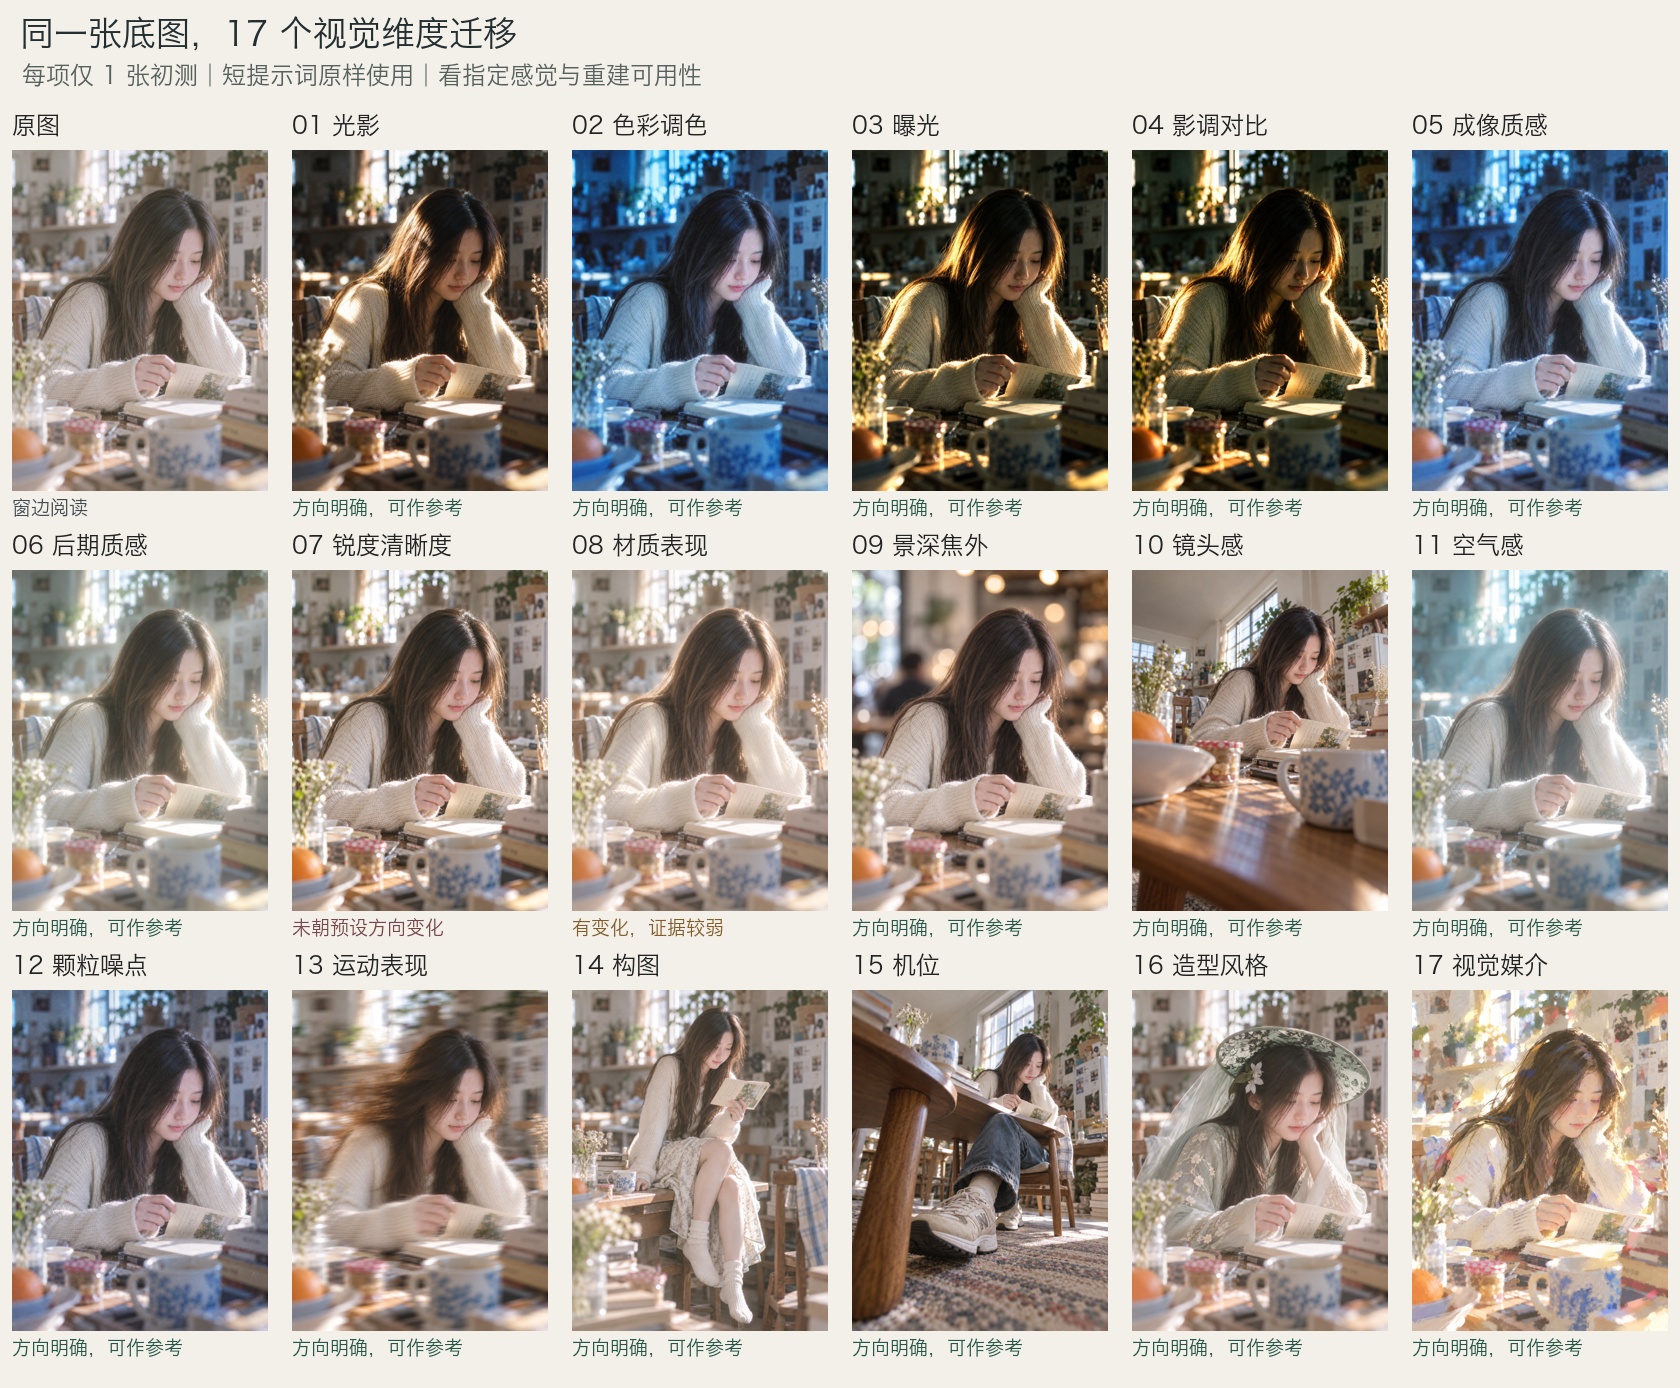
图 1:左上角为窗边阅读原底图,其余 17 格为单变量独立测试结果(点击放大高保真图)
| 分类大项 | 细分视觉维度 | 测试效果归纳 | 短提示词调用关键词 |
|---|---|---|---|
| 光线与调色 (4项) | 光影、色彩调色、曝光、影调对比 | 方向极其明确,快速改变整幅画面基调 | 光线氛围与明暗关系、色彩倾向与色彩分级 |
| 成像与质感 (6项) | 成像质感、后期质感、锐度清晰度、材质、空气感、颗粒噪点 | 空气感与后期质感明显;锐度与材质表现证据较弱 | 后期处理质感、空气透视、胶片颗粒 |
| 摄影与空间 (5项) | 景深焦外、镜头感、运动表现、构图、机位 | 涉及空间重构!容易脑补背景、下半身或全画幅拖影 | 景深与焦外特征、摄影机机位、构图方式 |
| 造型与媒介 (2项) | 人物造型风格、视觉媒介 | 适合探索新方向,会直接换服装配件或改插画风格 | 人物造型风格、媒介与笔触绘制方式 |
二、深度复盘:哪些感觉容易借,哪些容易把“代价”带过来?
只看单张出图,画面变好看了很容易被误判为“迁移成功”。但在真实生产中,我们必须把【参考图】、【底图】与【生成图】三张图放在一起严格对照, 回答两个致命问题:第一,原先想借的特征有没有借到?第二,为了得到这个变化,结果把什么不需要的东西也一起带过来了?
实测 1:光影与色彩迁移(氛围快速到位的典范)推荐优先使用
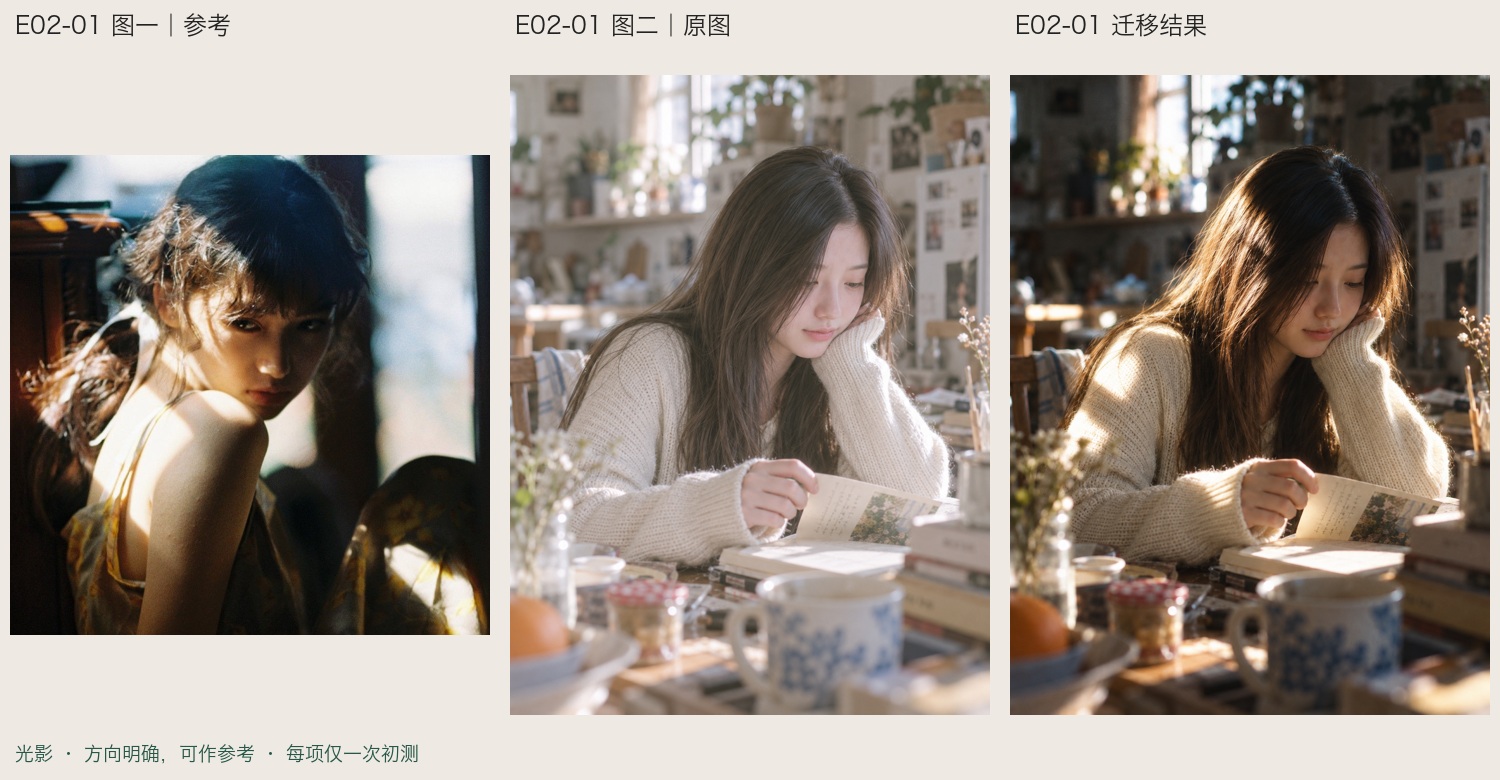
🔍 实验发现: 只看光影时,就能明显感受到画面氛围的质变。色彩迁移将环境推向参考图的蓝青冷色调,但人物面部肤色仍保留了一丝暖色,避免了死白或偏色。
⚠️ 连带代价: 词分成了 17 项,不代表模型是 17 个互不影响的独立旋钮。比如“曝光”和“影调对比”两项几乎都走向了金色高光、深暗部与偏绿阴影,而“成像质感”顺手改为了蓝青色调。
实测 2:质感、空气感与景深焦外(细分词条的巨大微差)高阶质感控制
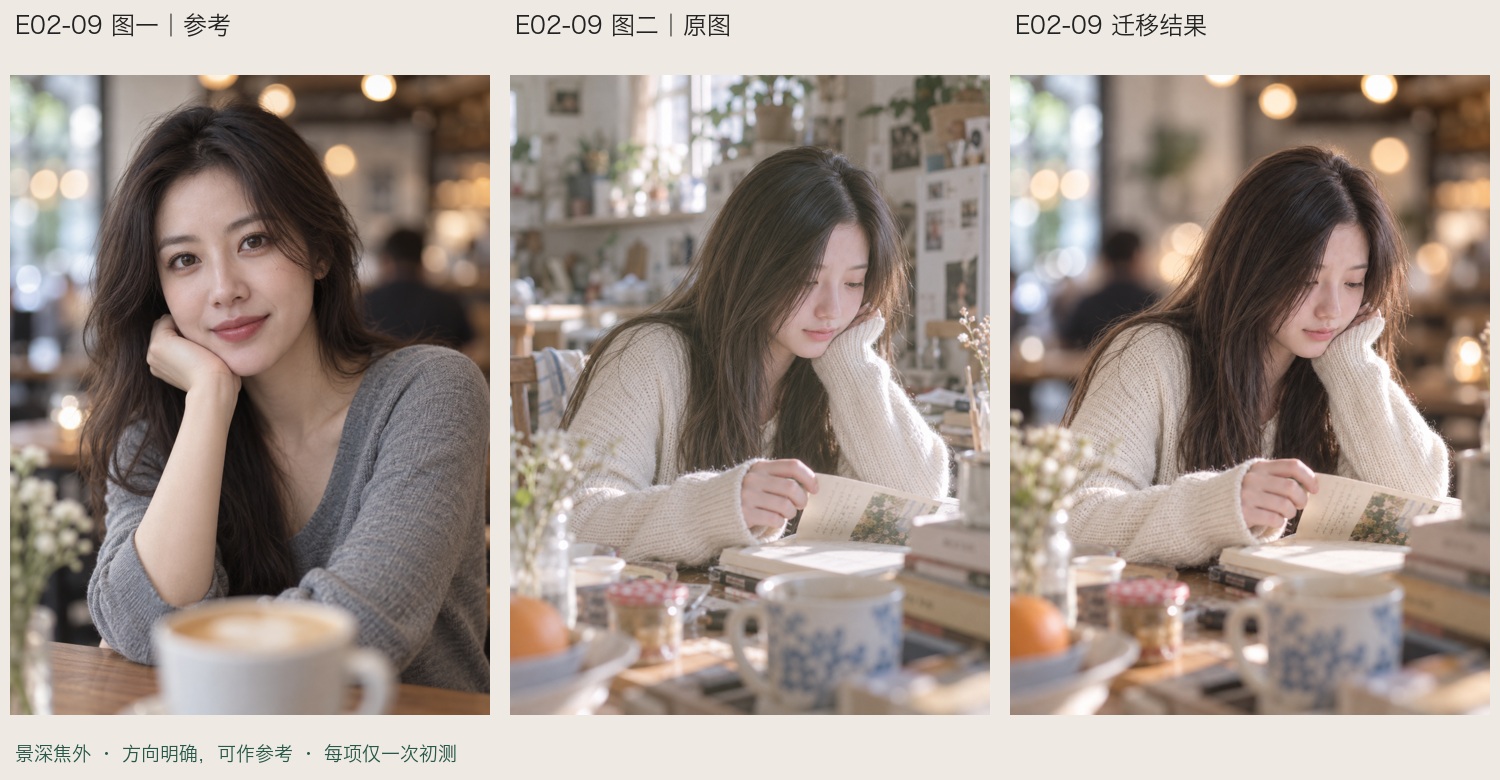
🔍 实验发现: “后期质感”借来的是高光泛开与一层灰雾;而“空气感”则把背景推成了青白色的朦胧空间,甚至直接激发出斜向的丁达尔光束!两张虽然都让人感觉“柔”,但一个偏滤镜式扩散,一个偏环境散射。
⚠️ 警惕脑补: 在“景深”迁移结果里,人物主体清晰、背景出现大片散景;然而参考图里的室内暖色吊灯和一个模糊的背景人影,也被模型“顺手”照搬进了新画面的窗外!
实测 3:机位与镜头感(一旦动镜头,模型就在重新搭场景)空间重绘 · 需严格约束
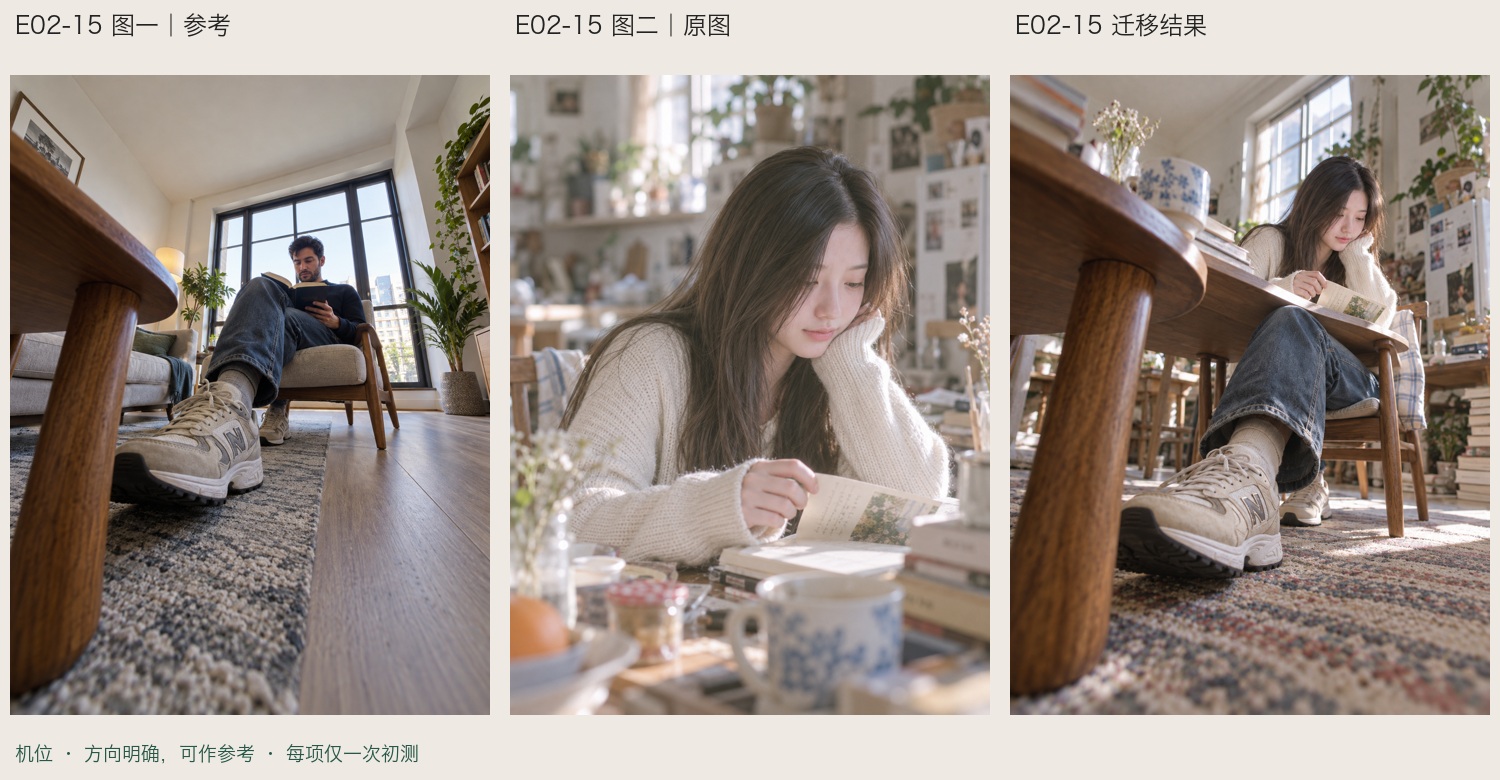
🔍 实验发现: 参考图是贴近地面的超低角度仰拍,生成结果确实将视角降到了桌子下方:桌腿被放大,人物退到画面深处。
⚠️ 严重翻车点: 原始底图只有半身,而低仰拍机位必然需要显示人物下半身。模型便顺理成章地“脑补”出了牛仔裤和运动鞋——而且下装款式几乎直接照抄了参考图!这启示我们:做连续剧集或角色资产时,绝不能只靠半身图就期望模型机位自动推算正确。
实测 4:快门与运动模糊(难以区分动静的全局摇摄)动态范围
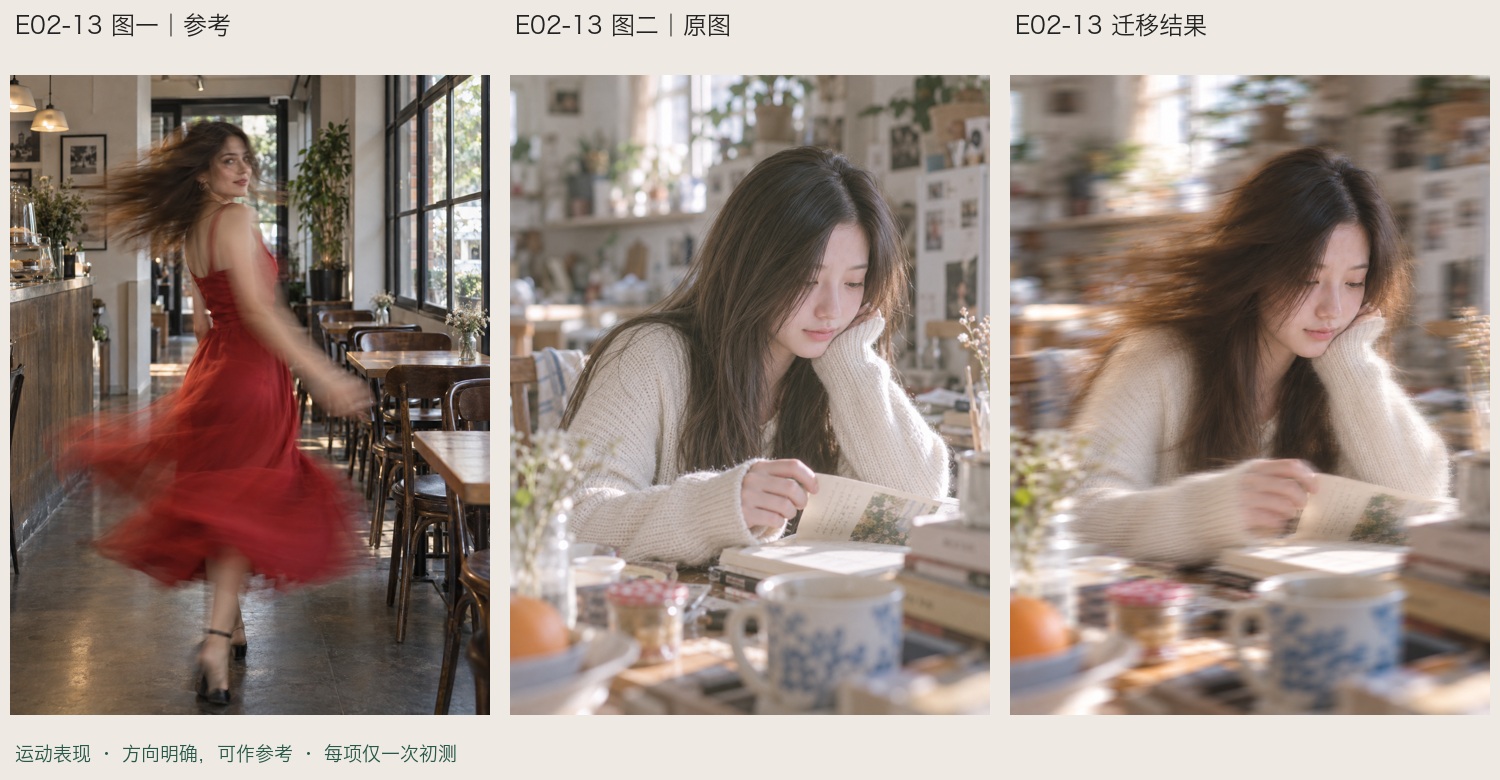
🔍 实验发现: 头发和手臂带有漂亮的横向拖影,极富动态张力。但仔细比对发现,背景原本静止的窗户和书架也被拖成了摇摄模糊。
⚠️ 启示: 生成模型捕获到了“画面要有运动感”,但无法自发分清“谁在动、谁静止”。做动态视觉方向稿非常适合,但直接作为交付成品仍需局部涂抹(Inpainting)修复背景。
实测 5:锐度清晰度(反直觉的迁移失效)
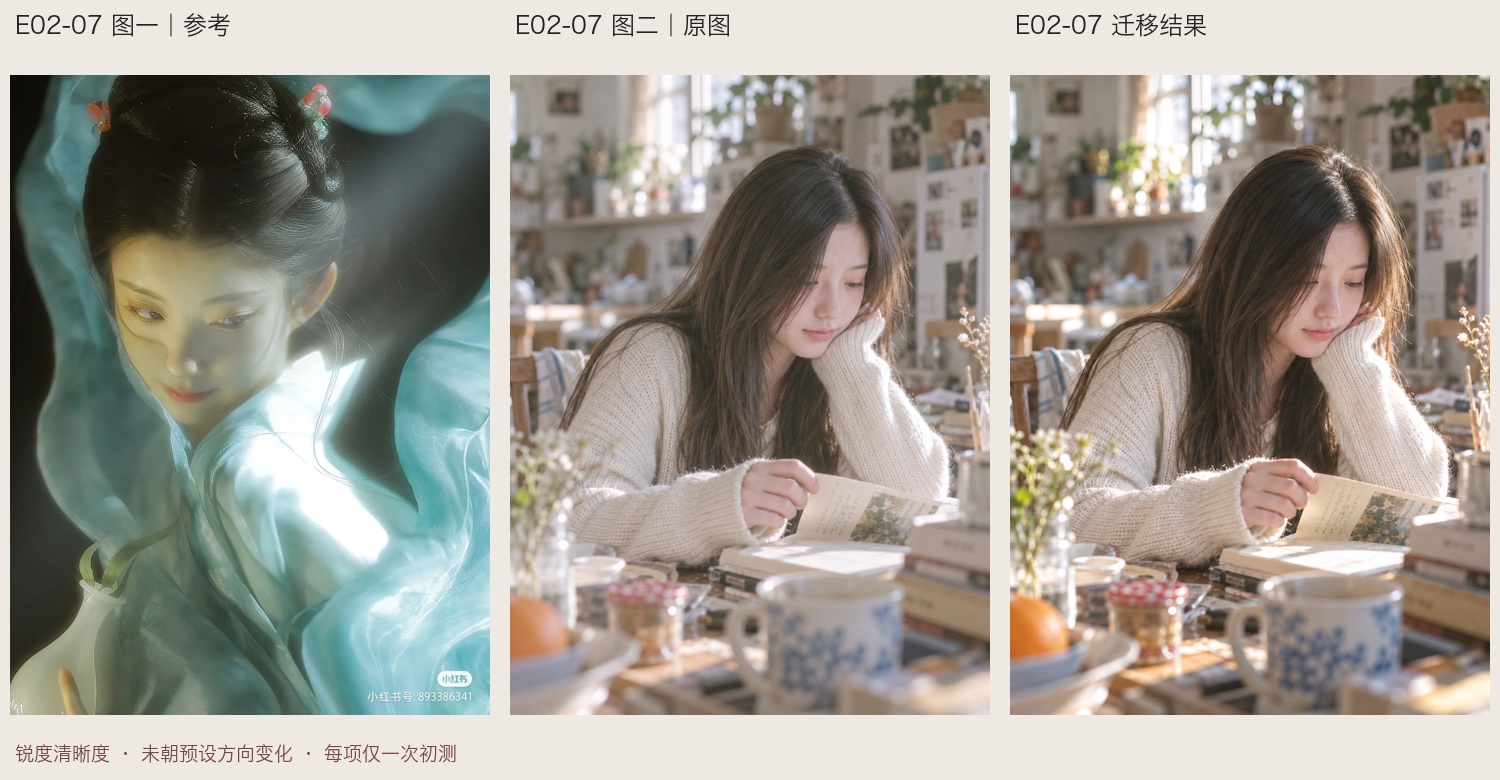
预设希望弱化细节让画面变得柔和,但生成图里的发丝、面部毛孔和毛衣针织纹理反而更清晰。“出图了”绝不等于“迁移成功了”,单靠“锐度”词很难让模型做单纯的减法。
实测 6:材质与高光(泛光与质感的边界模糊)
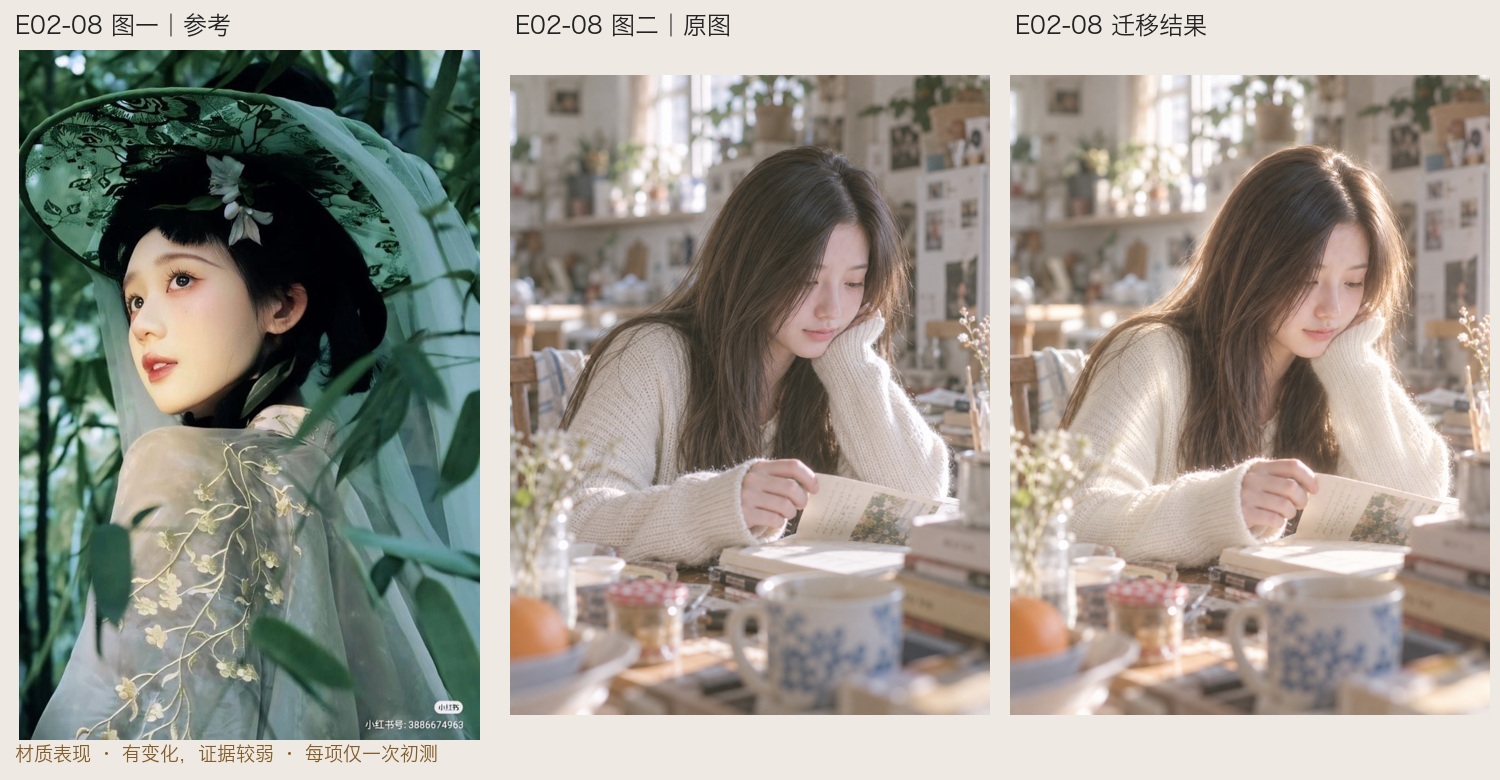
皮肤高光稍微柔润了一些,但毛衣依然是原先的针织质感。眼前的微弱变化更接近泛光柔化,无法确凿证明模型真正借到了参考图特有的表面材质反射。
三、进阶实战:多维度混合叠加(模拟电影级 LUT 调色迁移)
短提示词公式中的【维度】不仅可以填单一词条,还可以将几个相互关联的维度进行组合叠加。 例如在做电影调色质感迁移(LUT 迁移)时,单写“调色”可能改变不够彻底,把“光线氛围”、“明暗关系”、“色彩倾向”与“后期调色质感”串联起来,效果将产生质的飞跃:
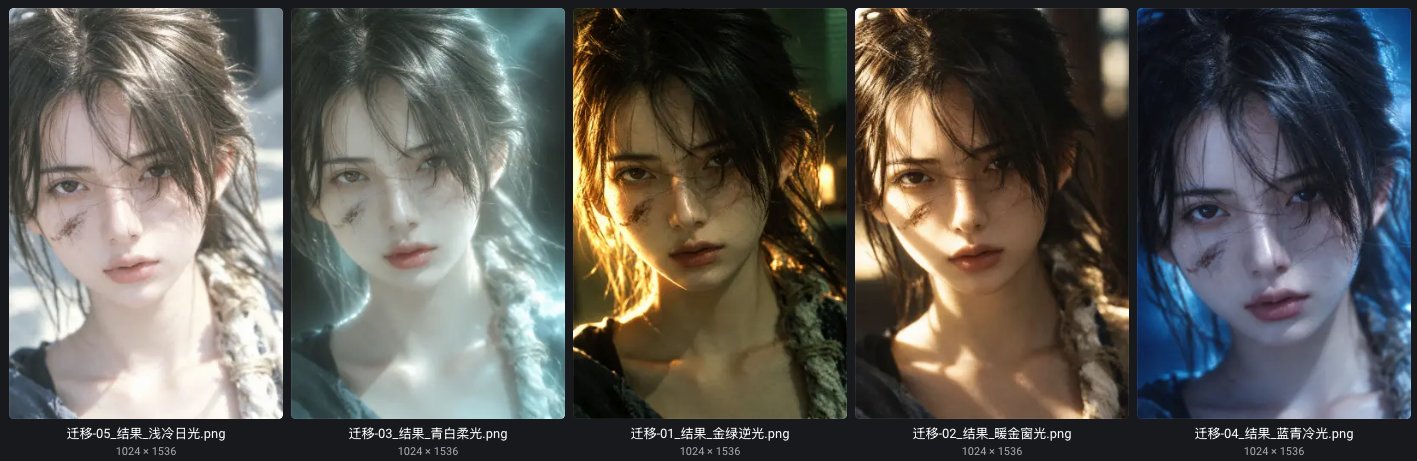
进阶多维叠加实战短提示词:
将图一的【光线氛围、明暗关系、色彩倾向和后期调色质感】迁移到图二,保持图二的主体、构图和内容不变。
💡 效果点评: 叠加后的成图不仅准确借到了参考图的高级胶片色调与光影反差,而且因为后半句严格限定了“保持构图和内容不变”,原本容易发生漂移的室内桌椅摆放和女孩姿态都得到了完整保持!
四、前期弯路:为什么“直接迁移”与“调色对比图”不够稳定?
在摸索出短提示词之前,南鸢曾尝试过两套方案:直接用目标图和原图进行迁移,或者先做一张前后调色对比图再让模型学习。这两套方案的实际出图效果均不如预期:
弯路尝试 1:直接两图暴力迁移
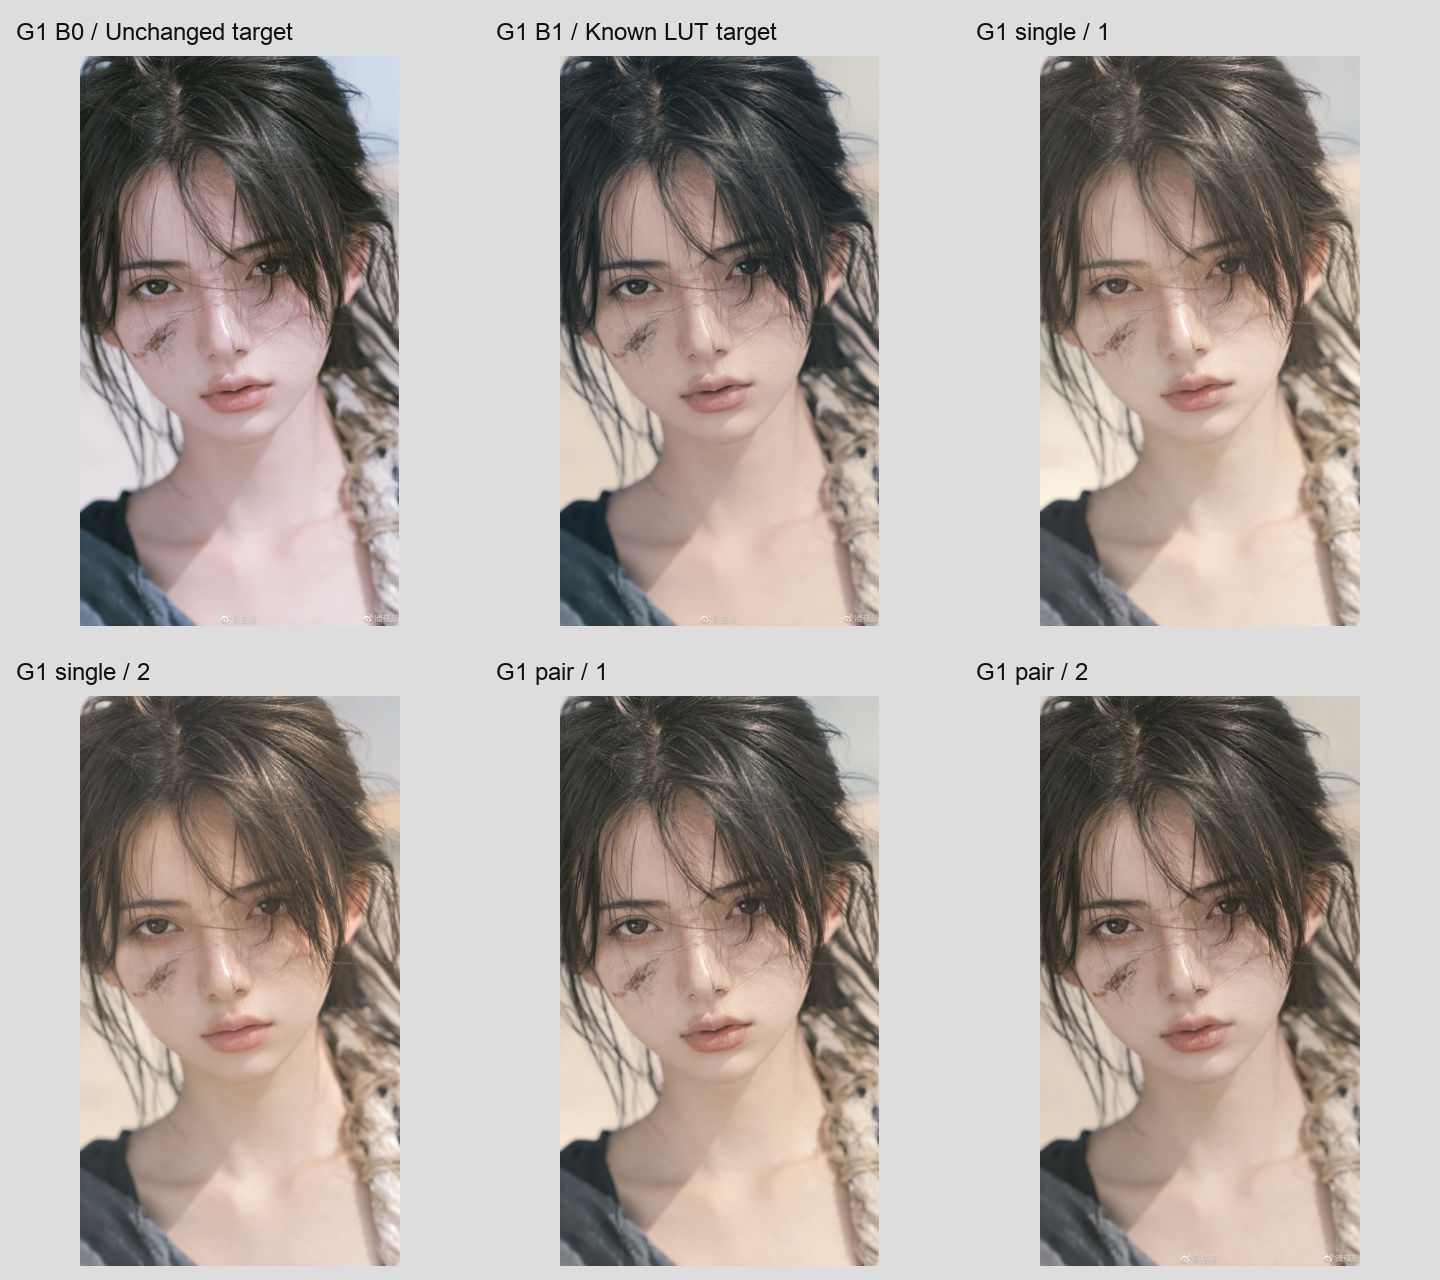
两张图直接迁移缺乏清晰的维度指引,模型往往在“复制构图”还是“复制调色”之间摇摆不定,容易造成局部变色、脸部失真的非预期结果。
弯路尝试 2:生成调色前后对比图
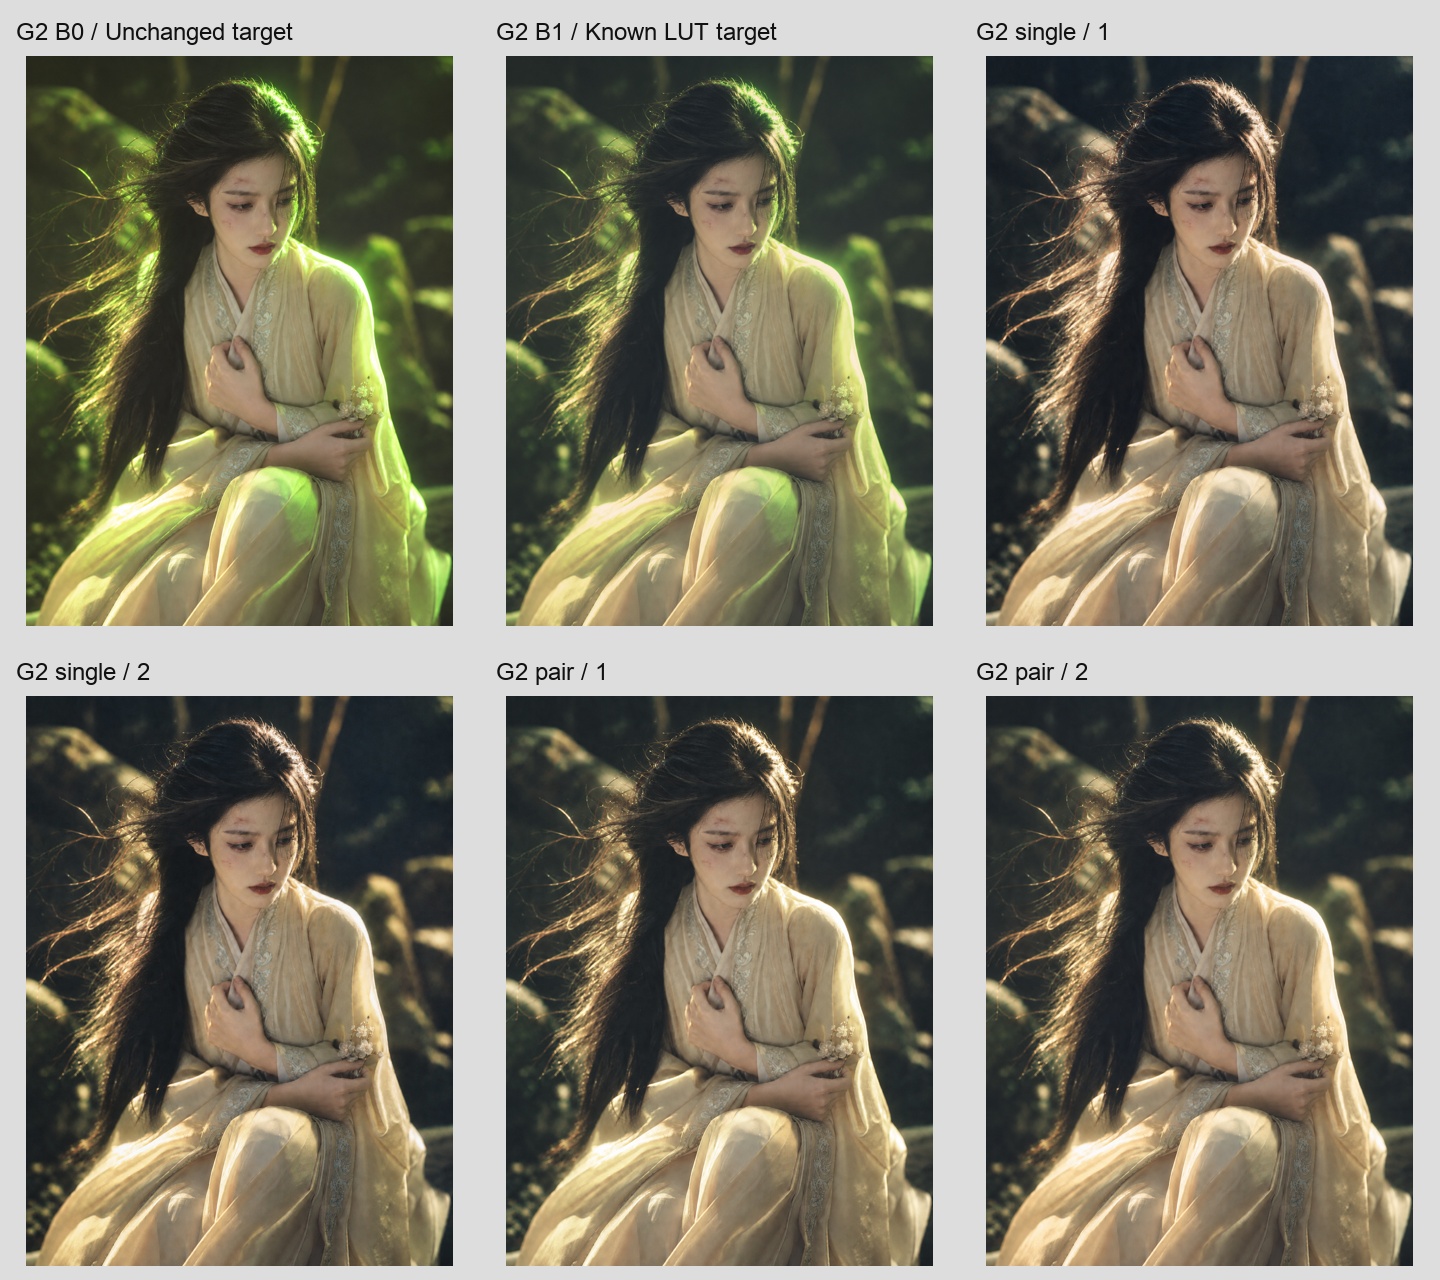
试图让模型先理解对比图调了什么再进行迁移。虽然数值上更接近调色目标,但在画面整体审美和连贯性上依然无法达到直接使用的标准。
五、总结:实战作业清单与 3 轮迭代法则
1
先定单一目标,切忌贪大求全
先想好你到底想要什么:是逆光光感、冷暖色调、空间散景,还是造型服装?一次只借 1 到 2 个核心特征,命中率最高。
2
用短词跑出第一轮方向稿
直接使用“将图一的【XX】迁移到图二,保持图二的主体身份与主要内容”,快速生成第一版。肉眼看大方向是否到位。
3
发现跑偏再追加针对性约束
若出现机位变动导致下半身被脑补、背景虚化带入了额外人影,第二轮再针对性加上“保持背景不变”、“保持原有服装不变”等具体补丁。两三轮迭代即可稳定交付!
关于作者: 南鸢 nuyoah(@nanyuan0412),AI 视觉创作与生图实战探索者,专注于真实可落地的 AI 工具与方法论。
探索更多生图实战
返回专栏大厅
开源重磅新星 · 深度实测
开源生图最强黑马!Qwen-Image-2.1 全景深度实测:7B 轻量化架构、原生透明 RGBA 生成与多图统一编辑
参数仅 7B 却以小博大!深度拆解 32 层单流 DiT、混合粒度注意力与 KV Cache 加速,业内首创原生透明 RGBA 图层直出与改字、最多 10 张参考图融合,附 5 大交互工坊与 48 组高清样张库。
Qwen Team & evaoo Research
生图前沿实测
GPT-Image 2.5 实测:普通人最容易上手,效果最好的生图模型
含 26 张原图全量 Prompt OCR 文字转录、双引擎架构图与 3 大专属交互工坊:四轮连续修改沙盒、Flare vs Sunburst 决策矩阵及海报生成器。
Adrian Punk @AdrianPunk115

商业电商实战
Image2.5 玩法全公开,从个人到电商(附提示词教程)
从个人头像弹跳 GIF、九宫格专属表情包,到电商商品慢扫光、换款不动模板、虚拟试穿、香水透光折射、手模受力与 3D 包装样机折叠全流程落地。
Adrian Punk @AdrianPunk115
需要探索智能体系统?
了解多智能体协同、RAG 知识库与本地模型部署。