
《实测 Gemini 4 Argon - Google 这跌跌撞撞的背水一战》
作者: 数字生命卡兹克 @Khazix0918
自费 100 美刀升级 Google Ultra 会员深度实测数小时后:Gemini 4 Argon 依然很难撼动 Claude Opus 5.5 与 GPT-6 Astra 的 T0 统治地位。其能力长板集中在金融、法律、税务等专业知识工作(Vals Index 68.9% 综合第一),但在电脑操控(CUA-bench 4.83% 倒数第二)、Antigravity 额度消耗速度与中文原生写作质感上存在明显短板。
就在今晚,Gemini 4 Argon,终于全面开放了。
今天,Gemini 4 Argon 正式推出。(Today, Gemini 4 Argon is officially rolling out.)
其实这玩意,10月1号就已经官宣过一次了,就在 OpenAI 开完 DevDay 的第二天。但是那一次,基本上就是纯官宣,没啥人能用上,只给一个叫 Fairwind 的网络安全计划开放,基本都是政府、关键基础设施、安全公司啊这些做防守的人。
终于在憋了两周之后,Google 选在今天官宣了。这一个多月,基本上新的大模型就是轮番轰炸,我简单顺了一下节奏:
- 09-04GPT-6 Astra 发布
- 09-22Grok 4.7 发布
- 09-23Claude Opus 5.5、GPT-6 Sol 和 Luna,一夜三连发
- 09-30OpenAI DevDay,GPT-6.1 Sol 发布
- 10-01Gemini 4 Argon 首次官宣(仅限 Fairwind 安全计划)
- 10-13Meta 的第一个前沿模型,Muse Wonder 发布
- 10-14Gemini 4 Argon 全面开放
基本上海外的几个巨头都到齐了,不过在模型层面,目前 Anthropic 还是无可争议的 T0 梯队,然后是 OpenAI 紧随其后,Meta 和 Google 奋力追赶,Grok 还在玩泥巴中。
我已经很久没有给 Gemini 付过费了,今晚又给他们贡献了 100 美刀,升级了一下 Ultra 会员,来体验一下 Gemini 4 Argon。
最终几个小时体验下来,我个人觉得,还是很难冲击 Claude Opus 5.5 和 GPT-6 Astra 的地位。一个一个说吧。
一. Google 这大半年
在聊 Argon 之前,我觉得得先聊聊谷歌这大半年。大家才能更加对这个模型的使命有一些理解。。。
时间拨回去年 11 月,Gemini 3 Pro 发布,那个时候,它可以说是全世界最好的模型之一。然后,谷歌就开始了一段非常魔幻的日子。
2月份发了个 Gemini 3.1 Pro,然后在 5 月的 I/O 上,承诺一个月内发 Gemini 3.5 Pro。结果一拖再拖,说 3.5 Pro 的进度落后了好几个月,其中一个原因,是代码能力没达到内部目标,没办法,Anthropic 和 OpenAI 给的压力太大了。结果最后拖着拖着,内部直接砍掉了。。。
然后 8 月 5 号,谷歌 AI 这边,直接大换血。哈萨比斯(Demis Hassabis)卸任 Google DeepMind 的 CEO,改当 DeepMind 董事长兼 Alphabet 首席科学家,然后由科雷(Koray Kavukcuoglu)接手。
同一天,在谷歌干了 27 年的传奇 Jeff Dean,也就是大家口中的“姐夫”,宣布离职,出去创业。姐夫是 1999 年加入谷歌的,那时候谷歌还是个小公司。后来撑起整个谷歌的那些底层技术,MapReduce、BigTable、Spanner,都有他的名字,基本是他跟老搭档桑杰(Sanjay Ghemawat),两个人坐在一台电脑前结对写出来的。
2011 年,他和吴恩达等人一起创立了 Google Brain,后来又带队做出了 TensorFlow。再后来 Google Brain 和 DeepMind 合并,他当上了 Google DeepMind 的首席科学家,也是 Gemini 的技术负责人之一。谷歌后来专门为他和桑杰两个人,设了一个新的最高职级,11 级(Level 11)。
程序员圈子里甚至有个流传了快 20 年的梗,叫 Jeff Dean Facts,专门编段子吹他。比如:“编译器从来不给 Jeff 报警告,是 Jeff 给编译器报警告。”、“光在真空里的速度原来只有每小时 35 英里,后来 Jeff Dean 花了一个周末,优化了一下物理学。”之类的。。。就是这么一个神一样的人,走了。跟他一起走的,还有桑杰。
两天后,SemiAnalysis 直接发了一篇文章,标题叫:Gemini is Cooked but GCP is Cooking(翻译过来就是:Gemini 凉透了,但谷歌云正在起飞)。因为谷歌把大把的 TPU 算力,卖给了 Anthropic 这些对手,自家模型拉完了,但是卖铲子的生意反而越做越大。
这大半年里,谷歌基本就是靠 Flash 系列在续命,从 3.5 Flash 一路发到 9 月 2 号的 3.8 Flash,这大概就是 OpenAI 再也掏不出来 Astra 了,天天发 Luna,Anthropic 也做不出来 Fable 了,天天发 Haiku。你就说魔幻不魔幻吧。。。
所以 Argon 对谷歌来说,真的不是一次普通的模型发布。这是谷歌的,背水一战。
二. 基本信息:会员割裂、伪百万输出与缓存价格
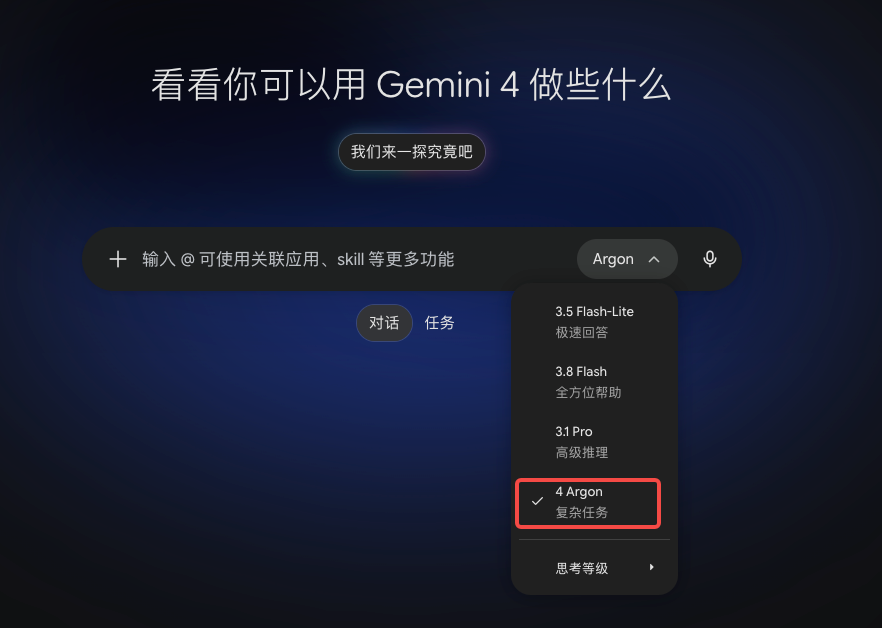
惯例先总结一下基本信息。目前 Gemini 4 Argon 已经上线,20 刀的 Pro 会员可以在 Gemini APP 里面用。
但是呢,如果你想在 Antigravity(也就是 Google 家的 Claude Code、Codex)里面去用,你必须要开 100 刀的 Ultra 会员才能用。这一点非常的蛋疼。。。然后,果不其然的就被喷了。
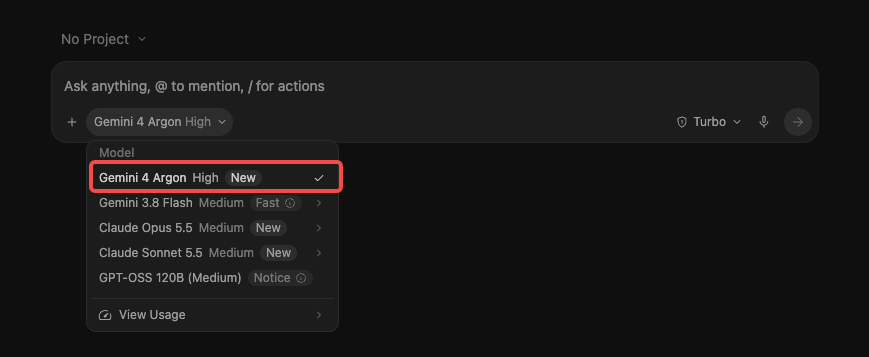
“这对谷歌来说非常令人失望。Gemini 4 Argon 仅限 Antigravity 中的 Ultra 用户使用,而 Pro 用户只能在 Gemini 应用中访问它。所以谷歌期望 $20 Pro 计划的开发者使用聊天机器人来进行编码,而不是 Antigravity?即使是 OpenAI 和 Claude 也在 $20 档位开放了 IDE 工具……”
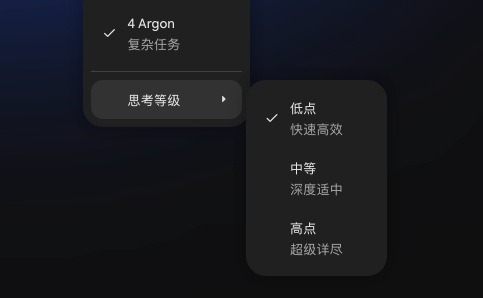
推理强度有三档,低中高,虽然他们这个翻译让我觉得团队里没有任何一个懂中文的人了。
模型上,Gemini 一贯的传统,是个多模态的模型,支持视频、声音、图片、文字等几乎全模态的输入。知识截止日期是 2026 年 3 月,比 GPT-6 Astra 和 Claude Opus 5.5 都要旧一点。
1. 上下文与“续写协议(Continuation Protocol)”真相
上下文这块,有个小细节。9 月 30 号官宣的时候,谷歌的说法是,输出上限从上一代的 6.4 万 Token,直接拉到 100 万。但是今天的说法,变成了“输入输出合计 100 万”,也就是你的输入、思考、输出共享了,还配了一个所谓的续写协议,continuation protocol。
这玩意的意思就是,Argon 一次请求,最多还是只能吐 6.4 万 Token 左右,跟上一代差不多;写到上限了,它不会直接断掉,会返回一个加密的续写令牌,里面记着它前面写到了哪,然后开发者再拿着这个令牌,把原来的请求原封不动再发一遍,它就接着往下写。就这么一段一段接下去,最多能接到 100 万。。。而 GPT-6 Astra 原生单次最高输出甚至是 128K,比 Gemini 4 Argon 还高点。。。
2. API 价格与 Agent 缓存成本横向对比
然后是价格。现在是优惠期,2 美刀/百万输入、10 美刀/百万输出,跟 GPT-6.1 Sol、Claude Sonnet 5.5,是同一个价。但是优惠期是 11 月 30 号到期,优惠期一过,就变成 4 美刀/输入、20 美刀/输出,就跟 Claude Opus 5.5 一模一样了。
但是对 Agent 来说,真正的大头,其实是缓存(Prompt Caching),对比一下:
| 模型名称 | 输入单价 (每百万 Token) | 输出单价 (每百万 Token) | 缓存命中单价 (Cache Read) |
|---|---|---|---|
| Gemini 4 Argon | $2.0(12月1日起 $4.0) | $10.0(12月1日起 $20.0) | $0.10(12月1日起 $0.20) |
| GPT-6.1 Sol | $2.0 | $10.0 | $0.10 |
| Claude Sonnet 5.5 | $2.0 | $10.0 | $0.10(10月7日刚从 $0.2 降价) |
| Claude Opus 5.5 | $4.0 | $20.0 | $0.20 |
| GPT-6 Astra | 旗舰档 | 旗舰档 | $1.00 |
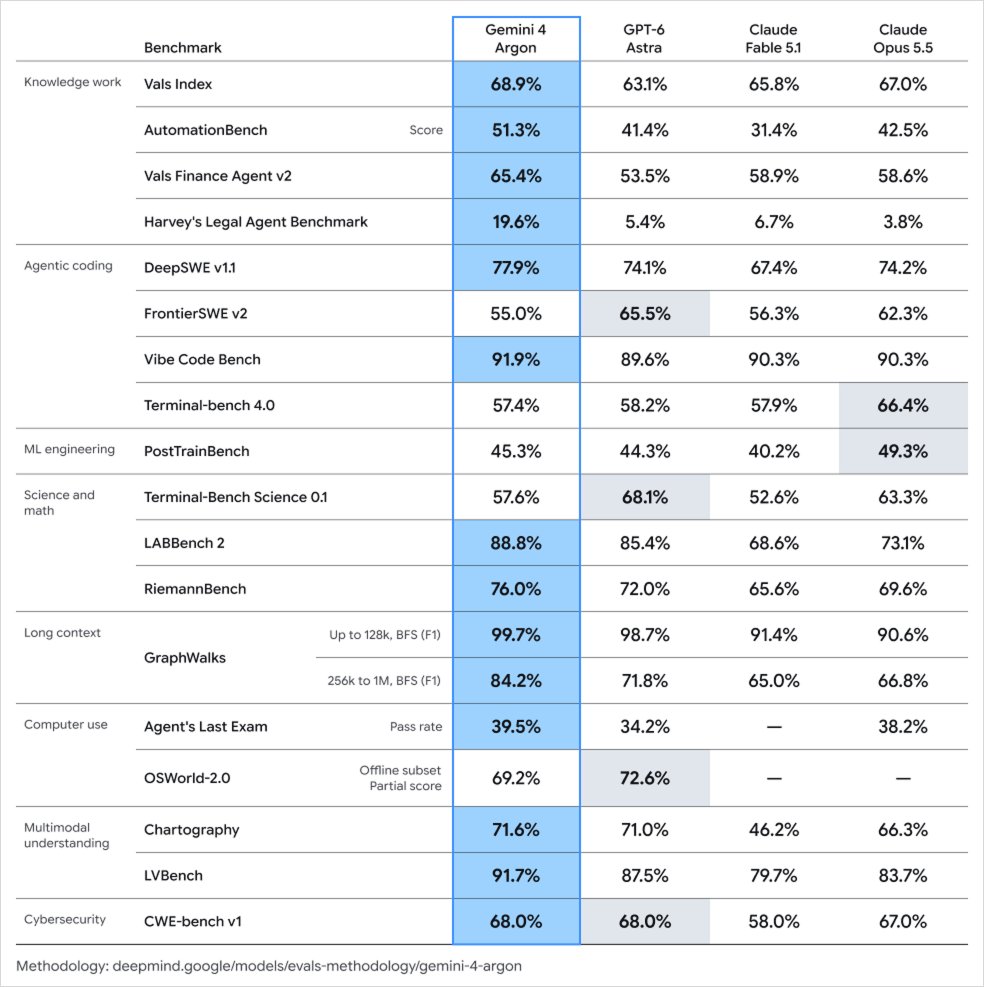
然后是跑分,先看看他们自己的跑分吧,我觉得...简单看一眼就得了。基本的信息大概就是这样了。
三. 为知识类工作而生:AA 与 Vals 第三方硬核评测
自己的赢学之外,三方的评测,很多时候我还是觉得更客观一点。首先还是看 AA(Artificial Analysis) 吧,总分 53,跟 GPT-6 Astra 打平。
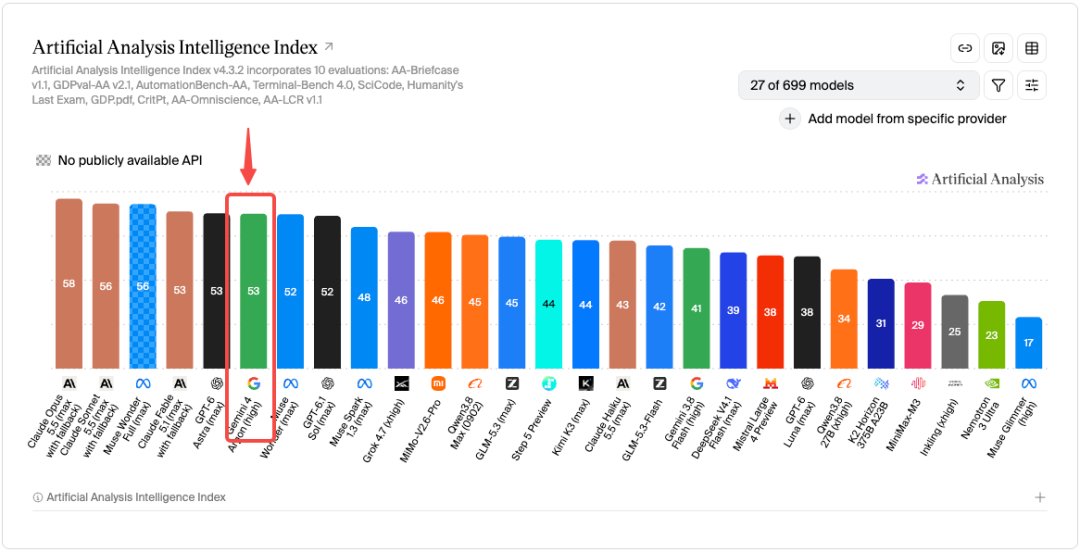
AA 的跑分里面,编程和 Agent 的权重还是挺大的,Claude Opus 5.5 依然是稳如泰山的第一名,第二名是 Claude Sonnet 5.5。
这里还有一个特别值得注意的细节:在 AA 的综合测试里,Argon 平均每个任务花费大约 1.99 美元,而 GPT-6.1 Sol Max 只有 0.72 美元。
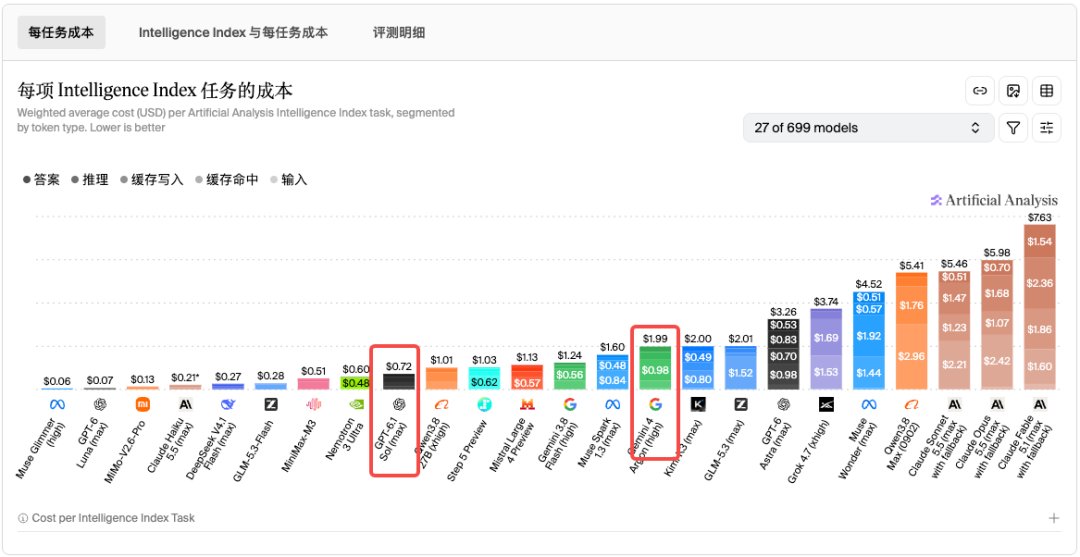
两者现在的 API 单价明明都是 2 美元输入、10 美元输出。核心还是相比 GPT-6.1 Sol,Argon 还是太能思考,太能输出了,不过相比 Claude 家那几个喜欢雷霆思考的,还是好一点。但是人 Claude 模型是喜欢雷霆思考,但是人出来的任务质量就是高到离谱,你这也完全没办法。
然后另一个三方评测,是很有意思的,叫 Vals。Vals 你可以理解成一家专门考“行业专业能力”的第三方评测公司,金融、法律、税务、医疗、编程这些,题目都尽量贴近真实工作。这次他们一共拿 Argon 跑了 26 个测试。
综合分 Vals Index,就是金融、法律、税务啊之类的,Argon 直接站在了帕累托前沿的最顶端,拿到了 68.9%,综合第一!
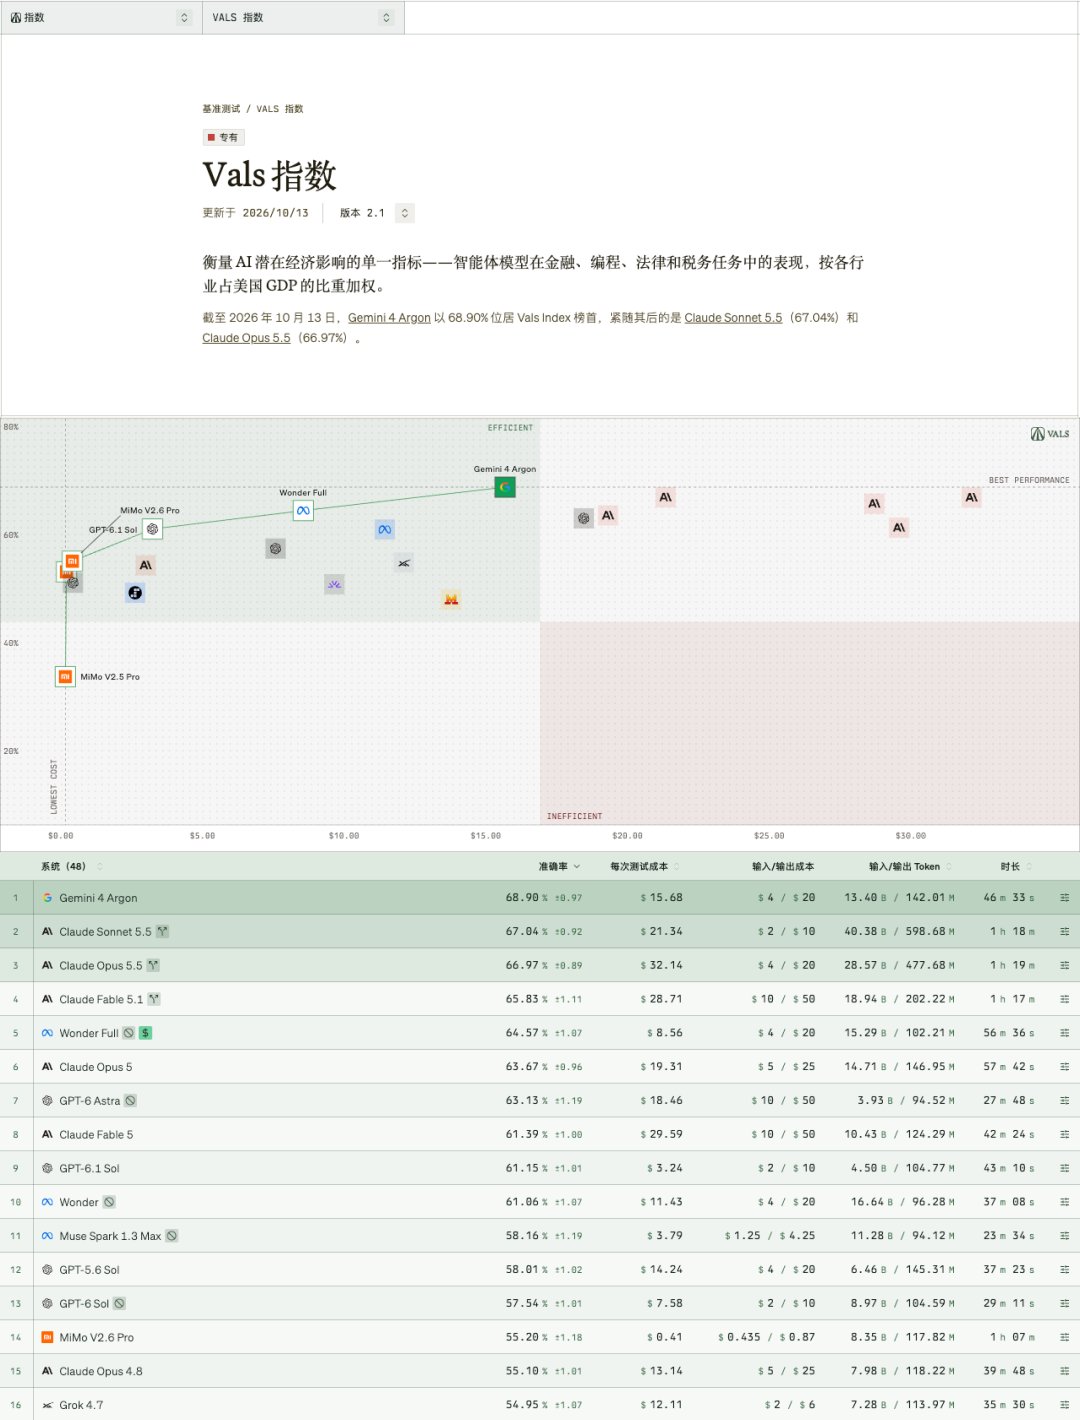
对比来看:Sonnet 5.5 是 67.04%,Opus 5.5 是 66.97%,Fable 5.1 是 65.83%。而且 Vals 还算了每跑一次的成本:Argon 是 15.68 美元,Sonnet 5.5 是 21.34 美元,Fable 5.1 是 28.71 美元,Opus 5.5 是 32.14 美元。又强,又便宜,比 Opus 5.5 便宜了一半还多。拆细节看,真正拿第一的是金融,然后法律、税务、医疗、编程,基本都在前几名。
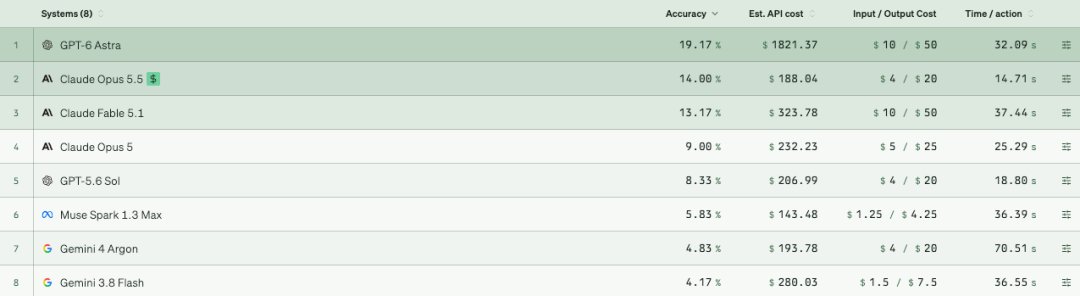
然后有一块拉完了:Vals 上测操作电脑的 CUA-bench,Argon 只有 4.83%,8 个模型里排倒数第二,倒数第一是 Gemini 3.8 Flash。而 GPT-6 Astra 是第一(19.17%),Claude Opus 5.5 第二(14.00%)。这个短板差的还是挺多的。
四. 糟糕的使用体验:Antigravity 额度黑洞、前端对比与中文“神仙山头”
模型聊完,来聊聊使用体验吧。Gemini 的网页版我就不提了,用过的都知道工具调用和思考有多糟糕。直接说说 Antigravity 吧,这个 Google 对标 Codex 和 Claude 桌面版的产品。
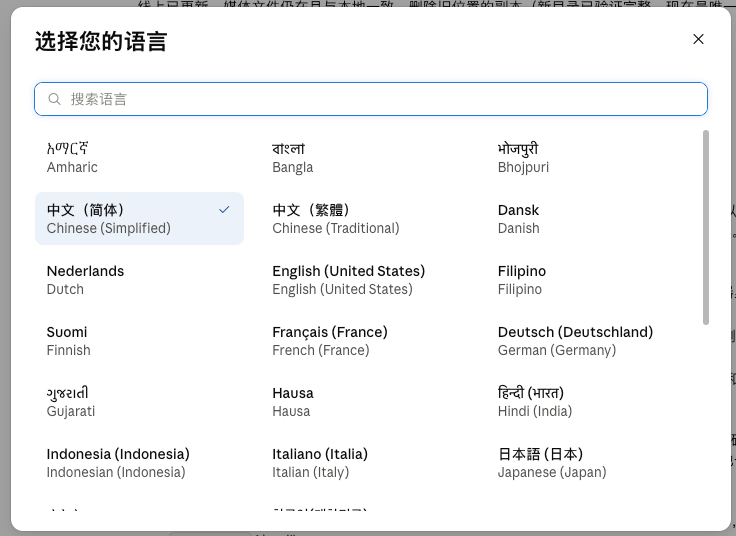
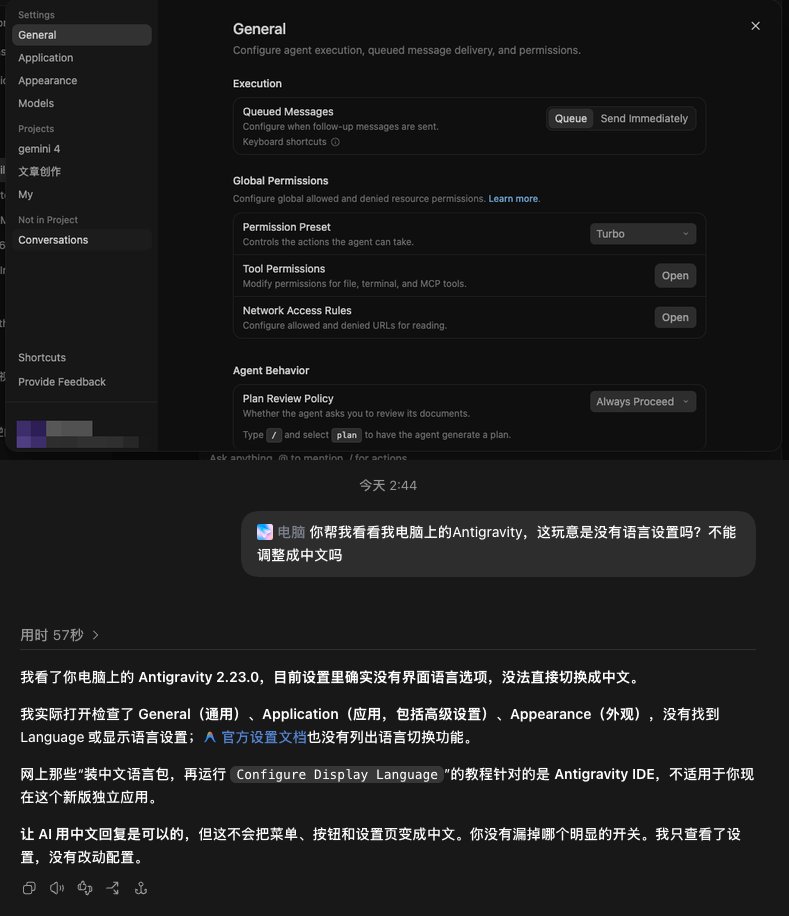
1. 上线一年仍无中文语言设置
首先还是这个语言问题,Codex 上线的第一天,就支持了汉化,连 Claude 这种黑心鬼,都在 Claude 里支持了中文(别说钓鱼啥的,我用一周了,用的好好的)。
2. 离谱的额度消耗:不到 10 个任务清空 $100 Ultra 的 5 小时额度
然后就是离谱的额度消耗。Gemini 3 Pro 最开始闻名于世界,几乎就是以他们领先于世代的前端能力。我到现在还记得当年给我惊艳的瞬间,真的很强。但是到了今天,用代码做前端已经被玩出花了,无论是 GPT-6 Astra 超强的空间与 3D 能力,还是 Claude Opus 5.5 的无敌审美和动效节奏,都几乎压了 Gemini 一头。
我本来也打算今晚去跑我自己特意整理的社区比较火的 20 个多维度的审美测试的。
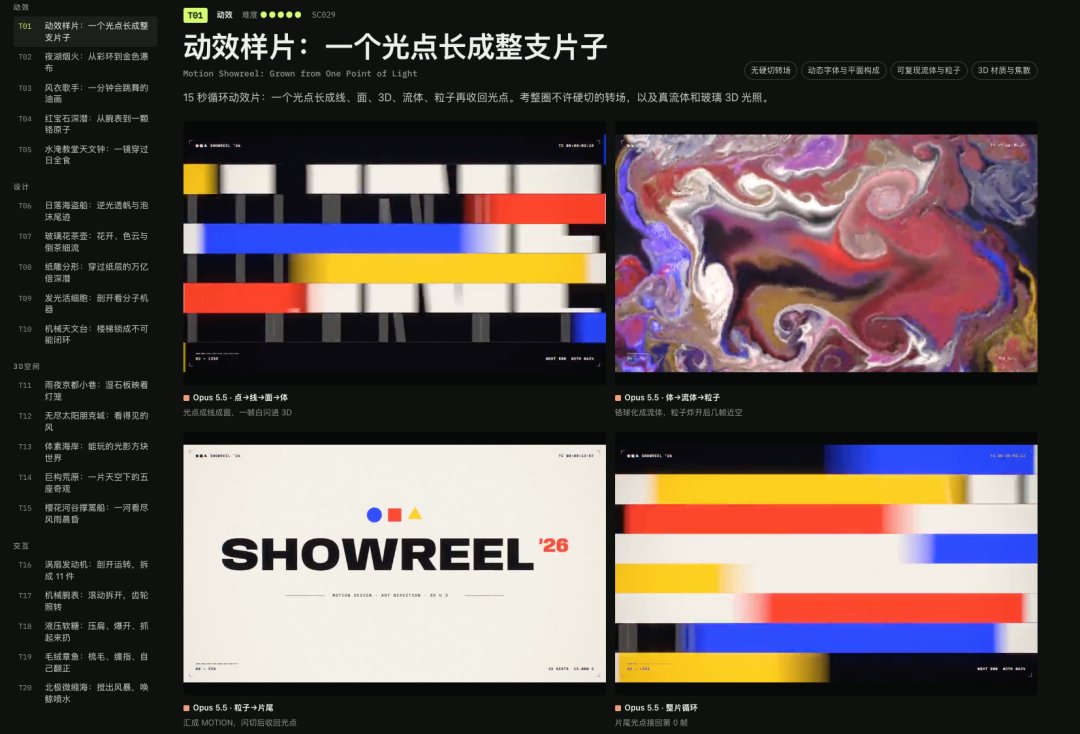
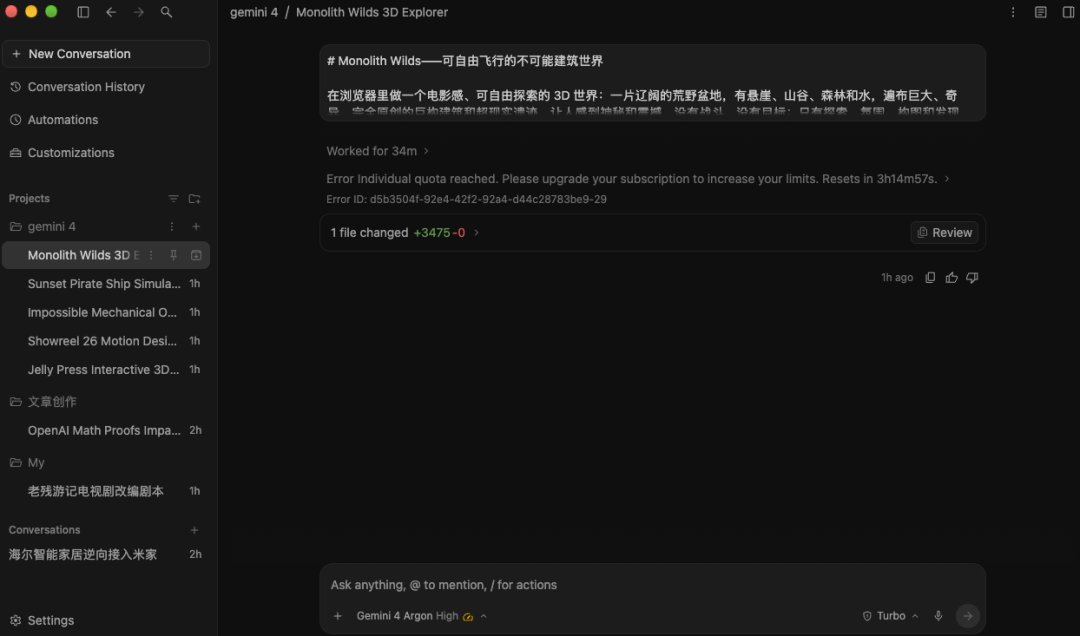
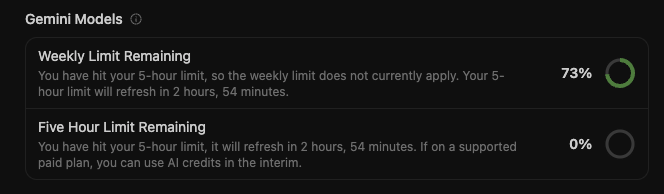
结果,我根本就没做几个任务,我的额度,就空了。。。天地良心,我好歹也是 100 刀的会员,我一共做了不到 10 个任务(5 个前端测试,3 个内容创作测试,1 个逆向测试)。而且这些任务,根本也不是啥那种多 Agent 并行的大活,我的 5 小时额度就全空了,周额度直接干没了 27%。相信我,你用 100 刀的 GPT-6.1 Sol,消耗都不会这么离谱的。
3. 前端交付体验与 3D 精细度被 GPT-6 Astra 吊打
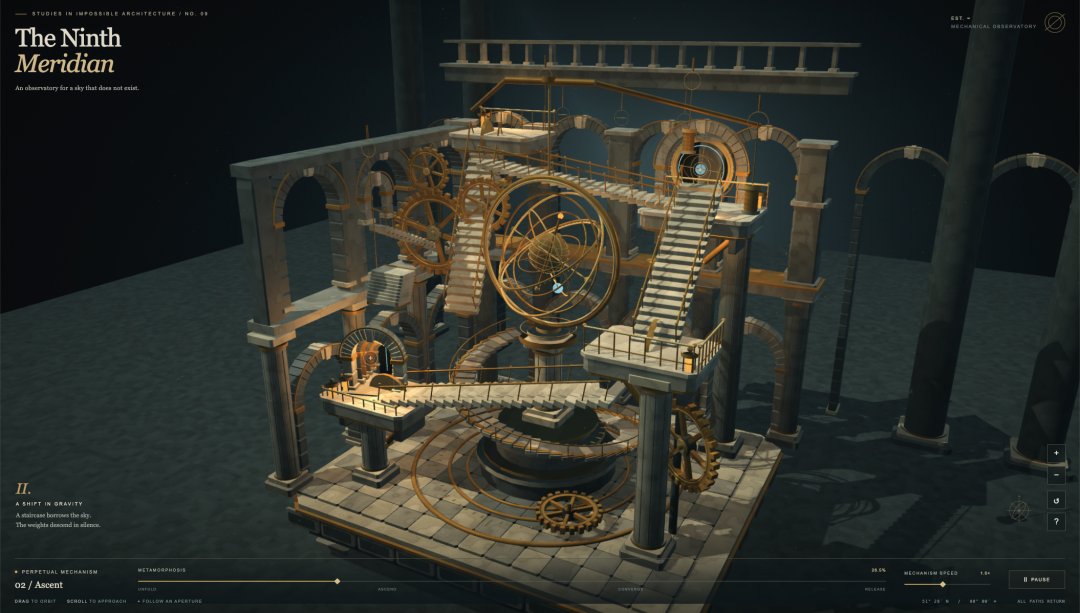
然后,跑出来的前端的 case,我是不敢相信,2026 年 10 月了,给我输出的 HTML 文件,是直接给我一个展开的 HTML 文件,让我自己复制的???结尾一句多余的话都不给我。就真的给了我一个 HTML 啊。最后,是我点了 Review,然后选择从文件夹里打开,手动双击运行,才在网页上看到效果。
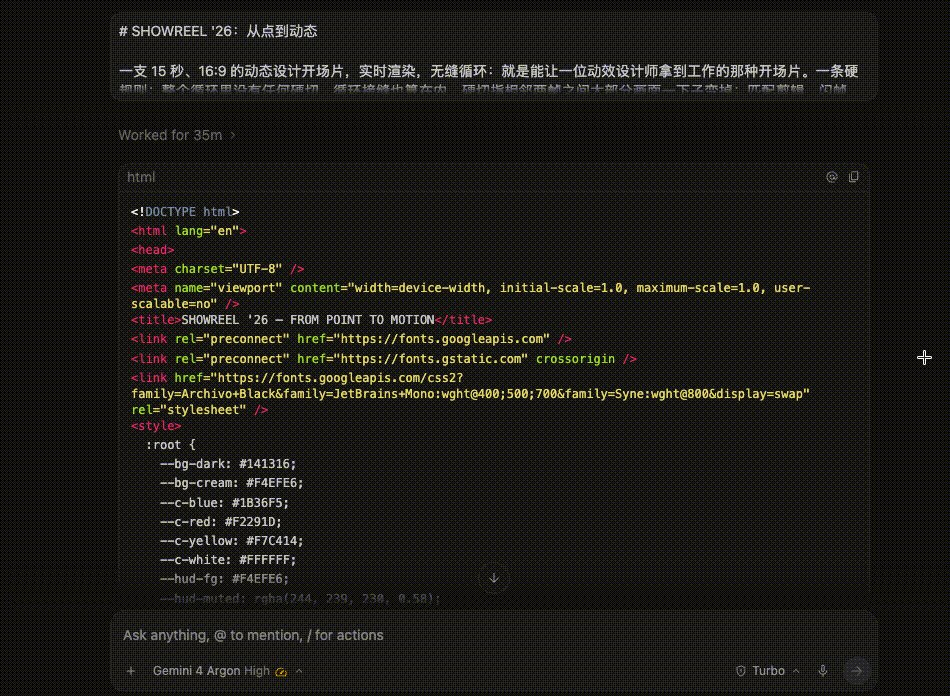
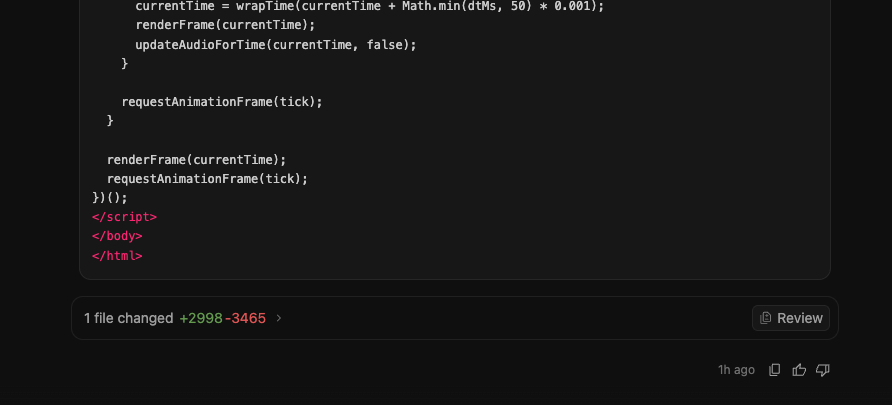
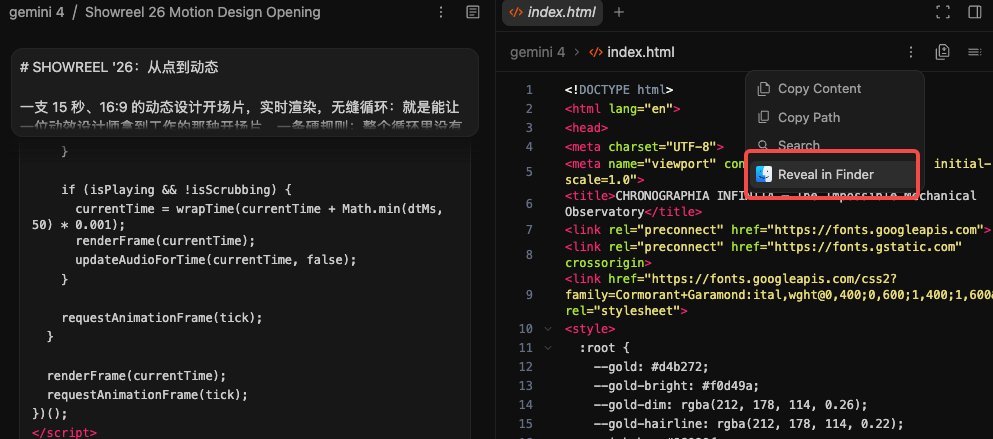
至于这个出来的前端效果吧,不对比还好,一对比的话。。。左边是 Gemini 4 Argon 的效果,单看好像还是挺不错的 3D 动态对吧?但让我们来看看右边 GPT-6 Astra 的——在精细度上,就是纯粹的吊打。。。
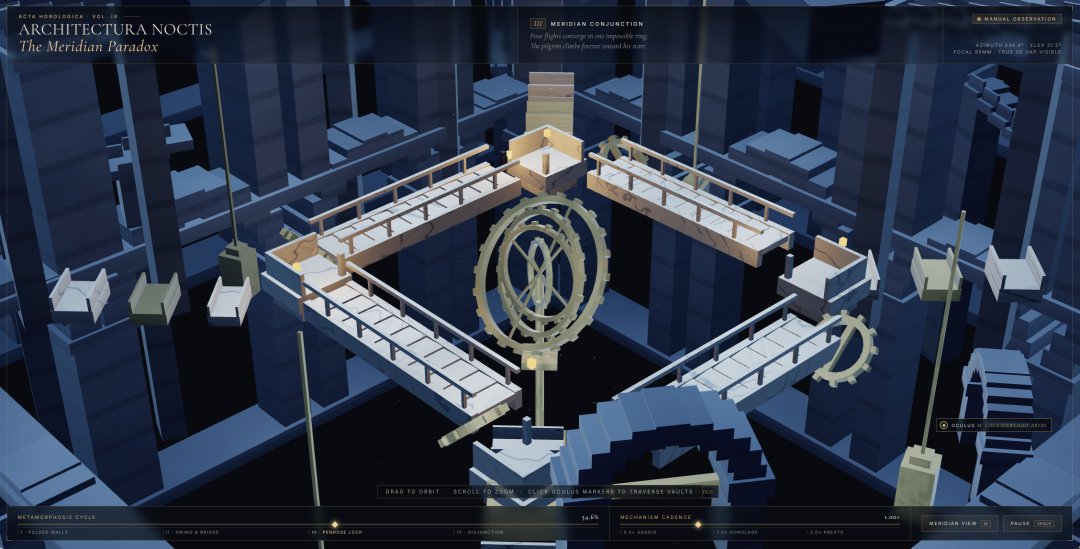
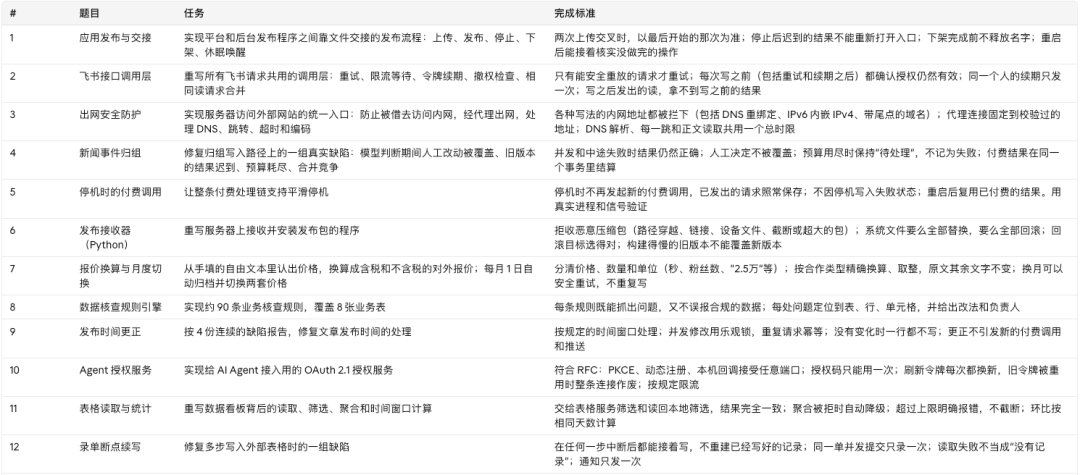
而后端任务,我准备了,但是因为额度限制,完全没有测成。这些任务都来自我自己的线上项目,是真实出现过 BUG,而且反复返工过很多次的案例,最后我把它们整理成了一套包含几十个任务的小型评测集。可惜没额度了。
4. 内容写作:英文盲测第一,但中文“AI 味”与雷霆比喻惨不忍睹
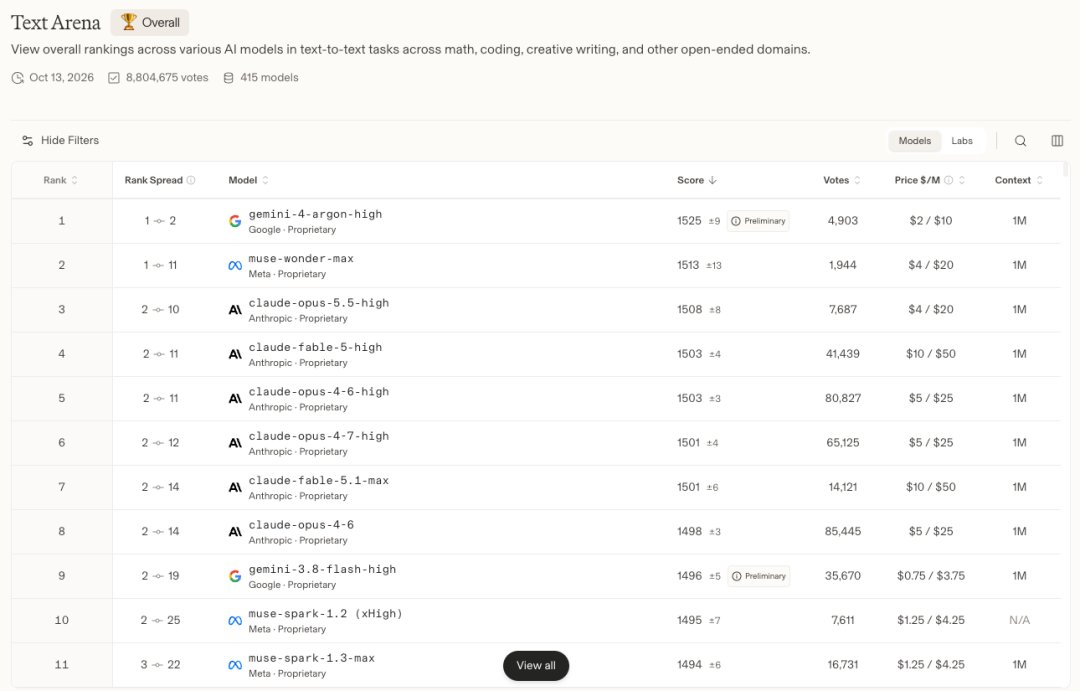
而在内容写作上,Gemini 4 Argon 拿到了 Arena 盲测的第一名。但是大家一定要注意,这个语言其实是英文的。
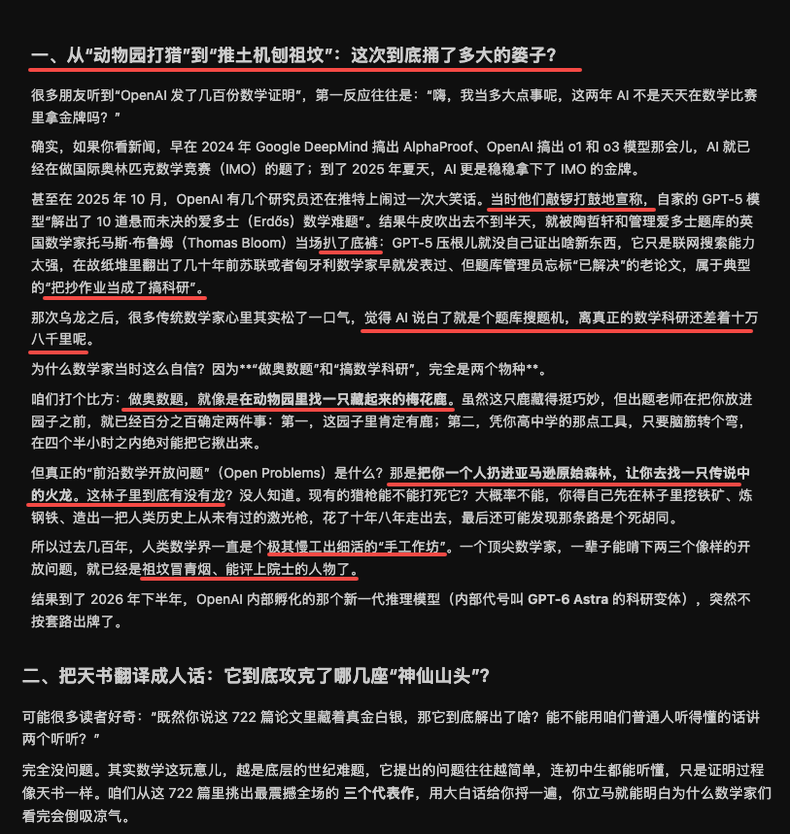
而在中文写作上,坦率的讲,我觉得味道太重了。就比如我把我前几天写的 OpenAI 发数学那个事,蒸馏成了一个 prompt。大纲、框架,以及我的核心观点,都给 Gemini 4 Argon 了,我刻意没有给我过去的文风参考,其实主要就是看看模型在基础框架上面的内容直出能力。
但,这个写出来的内容,我已经不想用不尽如人意来形容了,简直就是惨不忍睹,Gemini 3 所遗留下来的奇怪的雷霆比喻、喜欢双引号的怪癖,全都在,大家自己看吧。特别是下面这个标题。。。《攻克了哪几座“神仙山头”》,我看到的时候,真的有那么一下子没有绷住。。。
坦率地讲,这个模型肯定还有很多其他的优点,比如在专业办公领域,但那些领域是我不懂也无法去评判的。可在我能看懂的这些领域,还有最核心的产品的用户体验上,整个组合起来的感受,我可以非常明确的说,我今晚几个小时的体验是极其糟糕的。
写在最后:每月 6000+ 元的个人主力 AI 订阅体系全公开
在看完了这篇文章以后,如果你是跟我大部分任务比较相同的用户,我并不是很推荐你去定 Ultra 会员,如果真的想尝鲜,先订阅 20 刀的 Pro 就行。最后,我也分享一下我自己目前每个月的主要的订阅会员,给大家做个参考:
GPT-6 Astra 刚出来的时候,我是 200 刀的会员,那时候还在重构 AIHOT,基本一天 1 个 200 刀账号,所以我还临时开了 2 个 200 刀的会员,配上重置才勉强够用。现在因为 Claude Opus 5.5 在产品构建上实在太强了,所以对 ChatGPT 会员进行了降级,100 刀配上补偿的 62500 还有重置卡,感觉也够用了。
核心使用场景:自己和公司项目的反馈和 PR 自动化开发、项目运维监控的自动化等等(GPT-6.1 Sol 在 BUG 优化和修复上确实还是很不错的);同时对后端、还有一些硬件进行定向优化或者协议破解,比如今晚就让它在优化新公司的网关和 AP 设置,提升大家的网络稳定性。对于大众用户来说,ChatGPT 还是最水桶的,聊天免费、有生图额度,开发小东西 GPT-6.1 Sol 也够了。
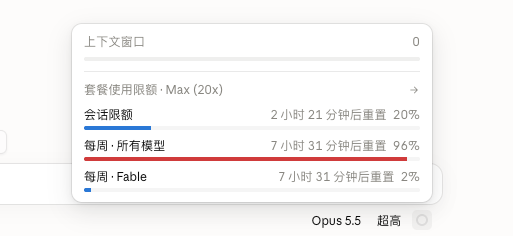
没啥可说的,Claude Opus 5.5 基本上是现在的版本真神,GPT-6.1 Sol 和 GPT-6 Astra 除了在一些后端、硬件的优化还有浏览器操控上,很难跟 Opus 5.5 去打。并且我自己整体额度体感大概是 Codex 的 5 倍,高强度开发 + 设计 + 做动效做了一周了,今天下午重置,我周额度只用到了 96%,还没用完。我整体消耗都是 Claude Opus 5.5,Fable 5.1 基本不咋用。
马斯克的全新会员体系,今天刚刚上线,直接把 Grok、Grok Bot、Cursor 和 X 合并掉了。Grok 4.7 比较拉,但我依然愿意买,纯粹就是冲着 Grok Bot 去的——相比 ChatGPT 的 Dots 目前好用很多,后端模型还给你用 Claude Opus 5.5。而且老马给的额度很足,200 刀的 Ultra 直接给了 50x 的额度(Claude 和 Codex 都是 10x)。
Suno Pro:独一档做音乐的,偶尔刚需,包年与视频团队共用。
LibTV 至尊版:主要给视频团队高频跑视频使用,非视频方向没必要定,目前视频 AI 依然贵得肉疼。
杂七杂八的会员费加上 API 费用,我每个月在 AI 上大概花 6000 多块。很贵,我也想只订阅一个平台,所以这么看,ChatGPT 还是最全面的水桶,对所有人都友好的。而至于这次 Gemini 4 Argon,基于如今的模型和产品表现,我目前不会把它纳入我的订阅体系里,我不觉得我会为它再付一笔钱。
大概就是这样,希望对大家有用~谢谢你看我的文章,我们,下次再见。