
AI 工程化拆解:外层执行流程、五大工程分工与架构边界
 AI 工程化拆解:外层执行流程、五大工程分工与架构边界
导读
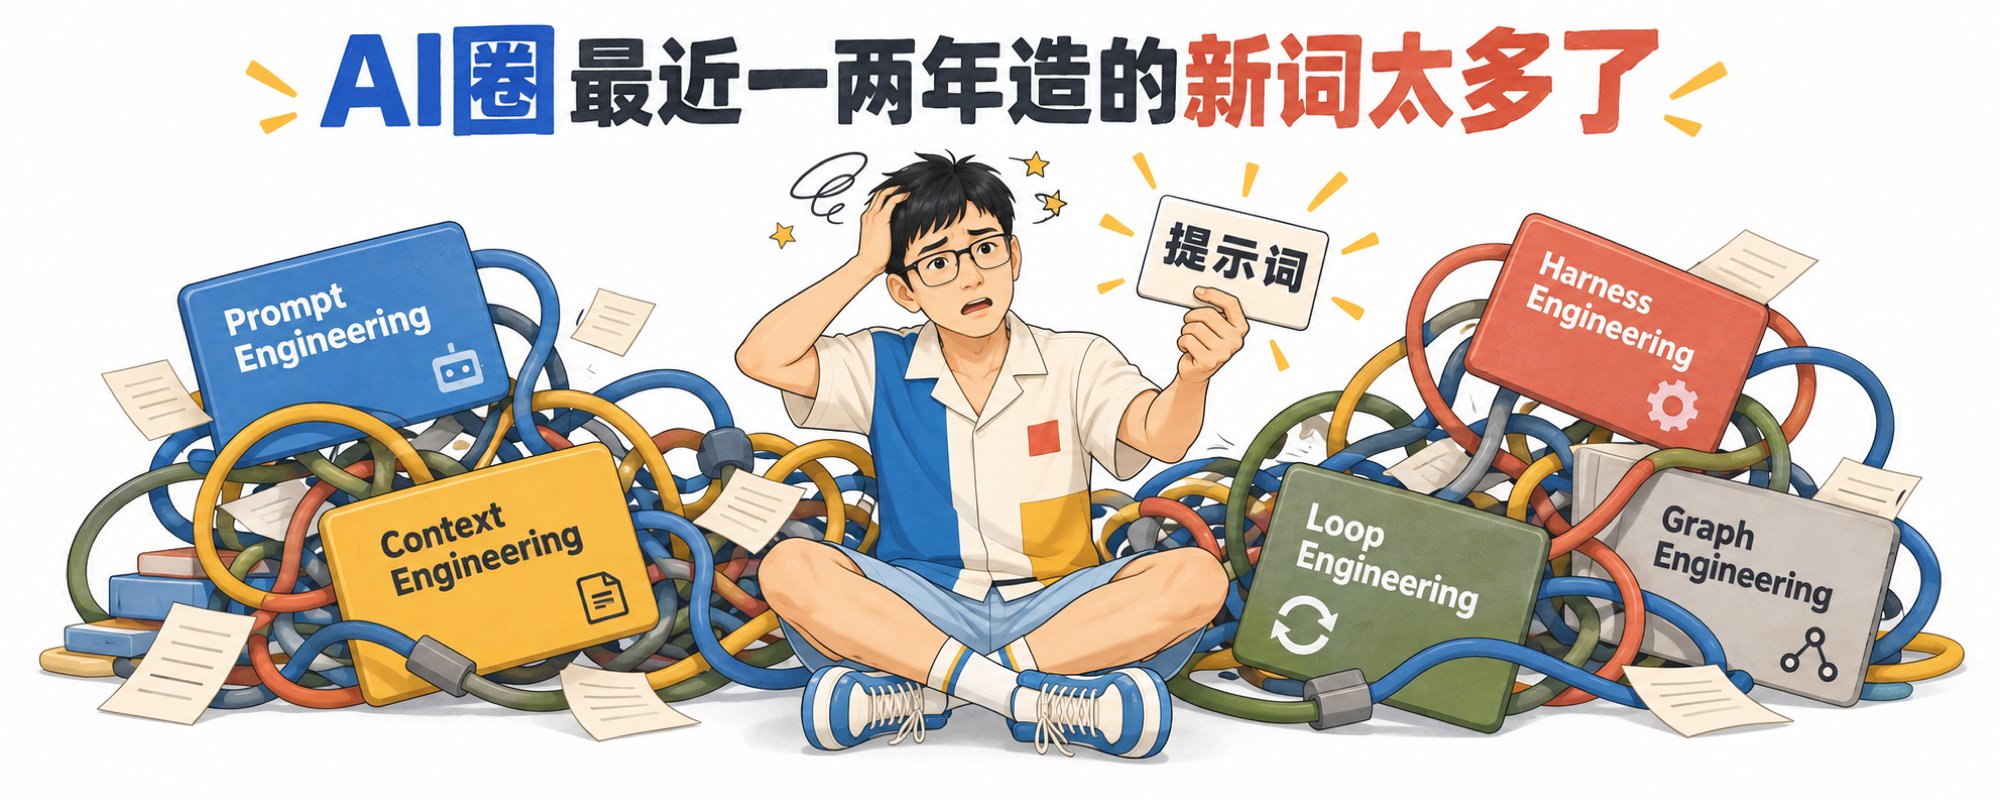
AI 圈近两年造的新词很多。Prompt Engineering 还没聊透,后面又排起了 Context、Harness、Loop、Graph 和 Eval。看多了确实容易晕。
先给结论:从开发和工程落地的角度看,这些 Engineering 拆到最后,核心还是提示词。
今天说的提示词早已超出聊天框里的几句话。它包含系统规则、当前任务资料和工具说明,以及历史结果、失败反馈和完成标准。只要模型能读到,并且会影响下一步判断,都属于提示词的一部分。
 AI 圈最近一两年造的新词太多了
Agent 难在把事情做完
做一个能演示的 Agent 并不难。给它一个任务,再接几个工具,它就能自己搜索、读文件、调用接口。跑完以后,它还会告诉你任务已经完成。
真拿去做事,问题马上就来了。它可能重复执行已完成的步骤,调用错误的工具,拿到一半结果就宣布结束,或者在同一个错误上来回打转。
工程化要处理的就是这些具体问题:模型这一步该看什么,可以使用哪些工具,失败后怎么改,什么情况算完成,走到哪里必须停下来交给人。
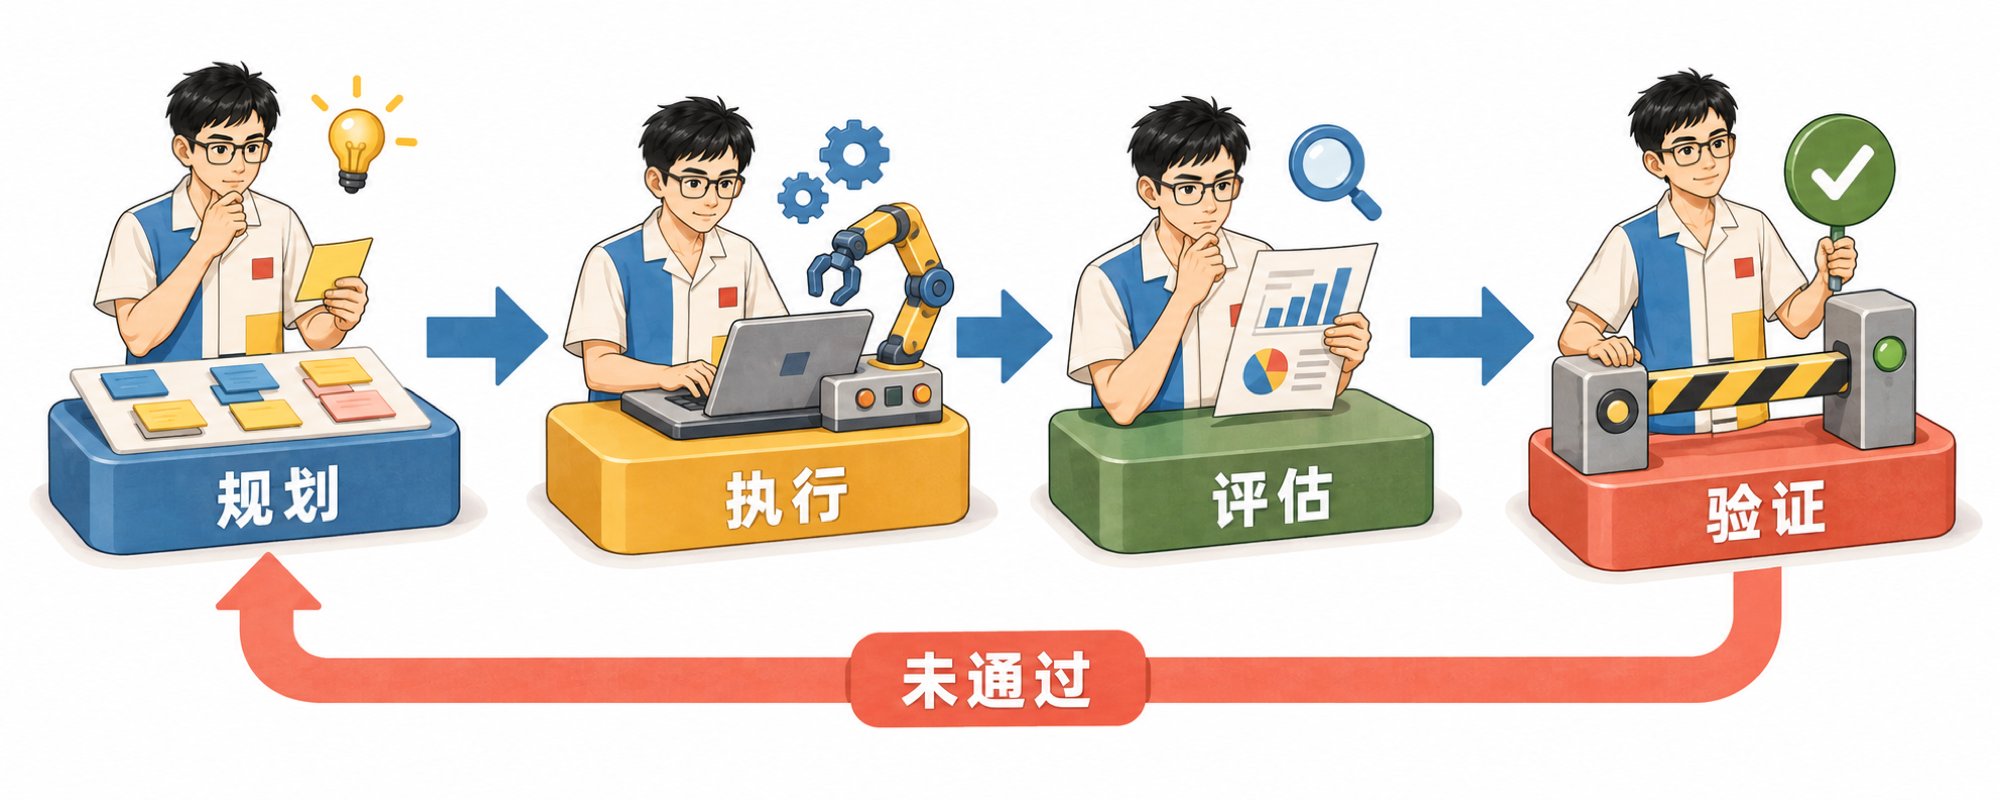
我们以前做 Agent 时,外层基本离不开这套流程:
| 1 | 接收任务 |
| 2 | → 制定计划 |
| 3 | → 调用工具执行 |
| 4 | → 评估结果 |
| 5 | → 验证是否完成 |
| 6 | → 没通过就把原因送回去,再跑一轮 |
 Agent 核心执行流水线
代码可以把这条路线搭起来,也能限制最大轮次。但每一步具体做什么、工具怎么选,结果够不够、失败后补哪一块,还是要让模型根据提示词做判断。
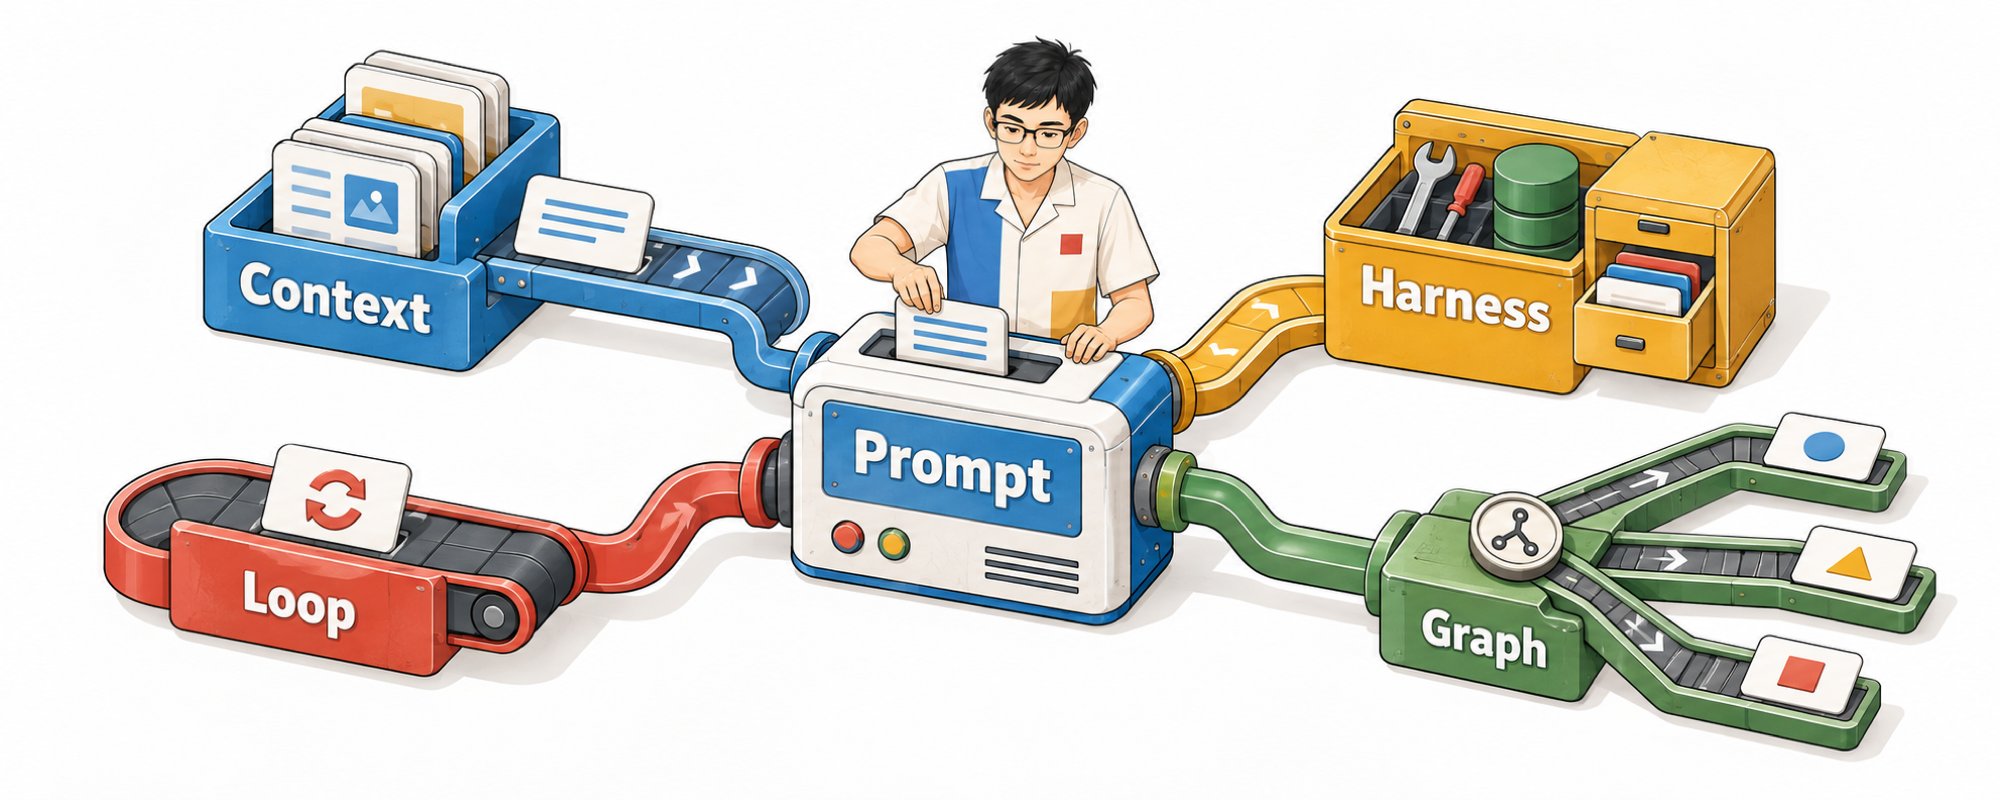
提示词到了 Agent 里,早就超出了一次问答的范围,会跟着任务不断变化。后面这些 Engineering,都在解决这套系统里的某一个具体问题。
 动态提示词系统运转机制
技术架构解读:技术栈分层
下图梳理了完整架构分层:最底层是物理代码硬边界,外围环绕五大工程模块,核心是 LLM 动态 Prompt 组装。
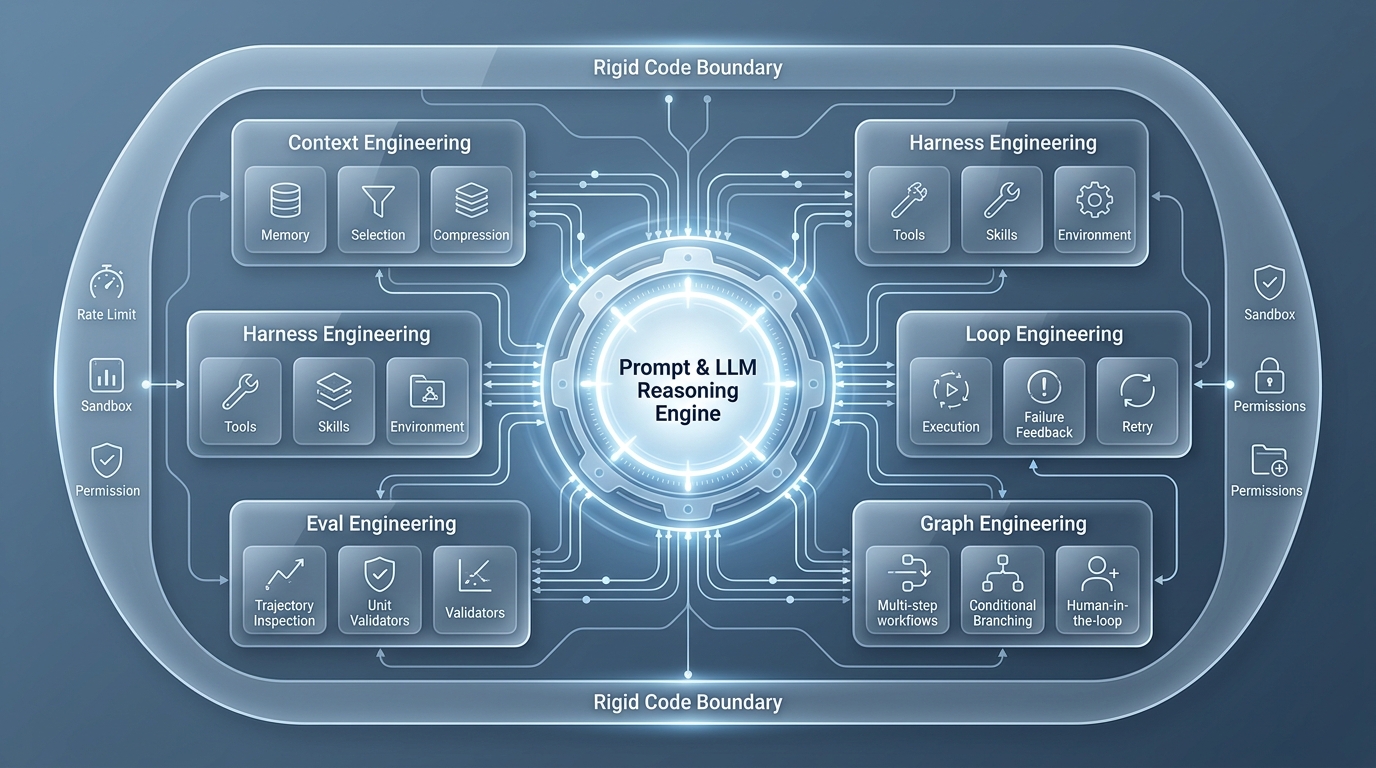 AI Agent 技术栈与提示词分层模型
Context Engineering:这一轮给模型看什么
单次问答很简单,把用户问题和几份资料一起发给模型就行。但 Agent 连续工作几十步后,历史记录、工具结果、中间文件和错误信息会越积越多,没法每一轮都原样塞进去。
塞得少,模型不知道前面发生过什么;塞得多,旧资料和无关结果又会把它带偏。
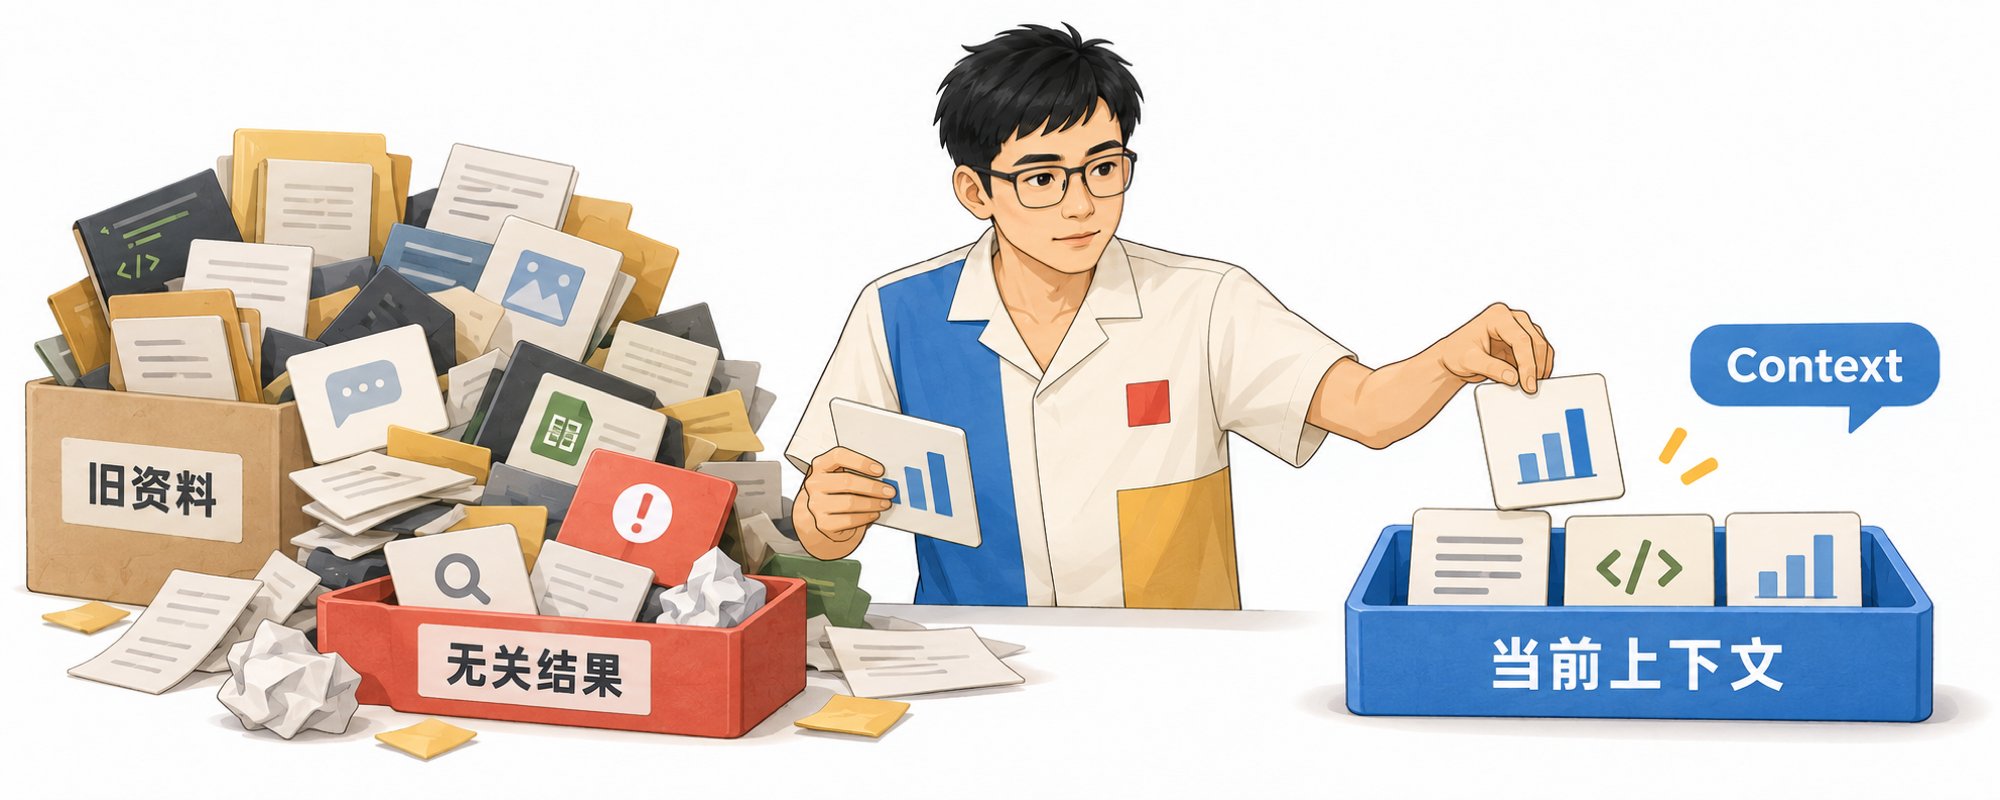 Context Engineering 漏斗与信息筛选
Context Engineering 处理的就是这一轮该给模型看什么。第一次规划时,模型需要用户目标、可用工具和限制条件。执行失败后再规划时,则要补上失败原因、已完成的步骤和当前结果,否则它很容易重走旧路。
LangChain 把常见处理分成 Write、Select、Compress 和 Isolate。对应到开发动作里,就是先保存中间结果,需要时再挑出来;内容太长就压缩,不同任务分开处理,避免所有信息挤在同一个窗口里。做完这些,最终还是组装成模型下一次调用时看到的提示词。
Harness Engineering:把工具交给模型,把规则说明白
模型本身只能生成文本。要让它搜索网页、读取文件、查询数据或操作软件,就要在外部接上工具、Skills、记忆、中间件、权限和运行环境。这一圈外围设施现在常统称为 Harness。
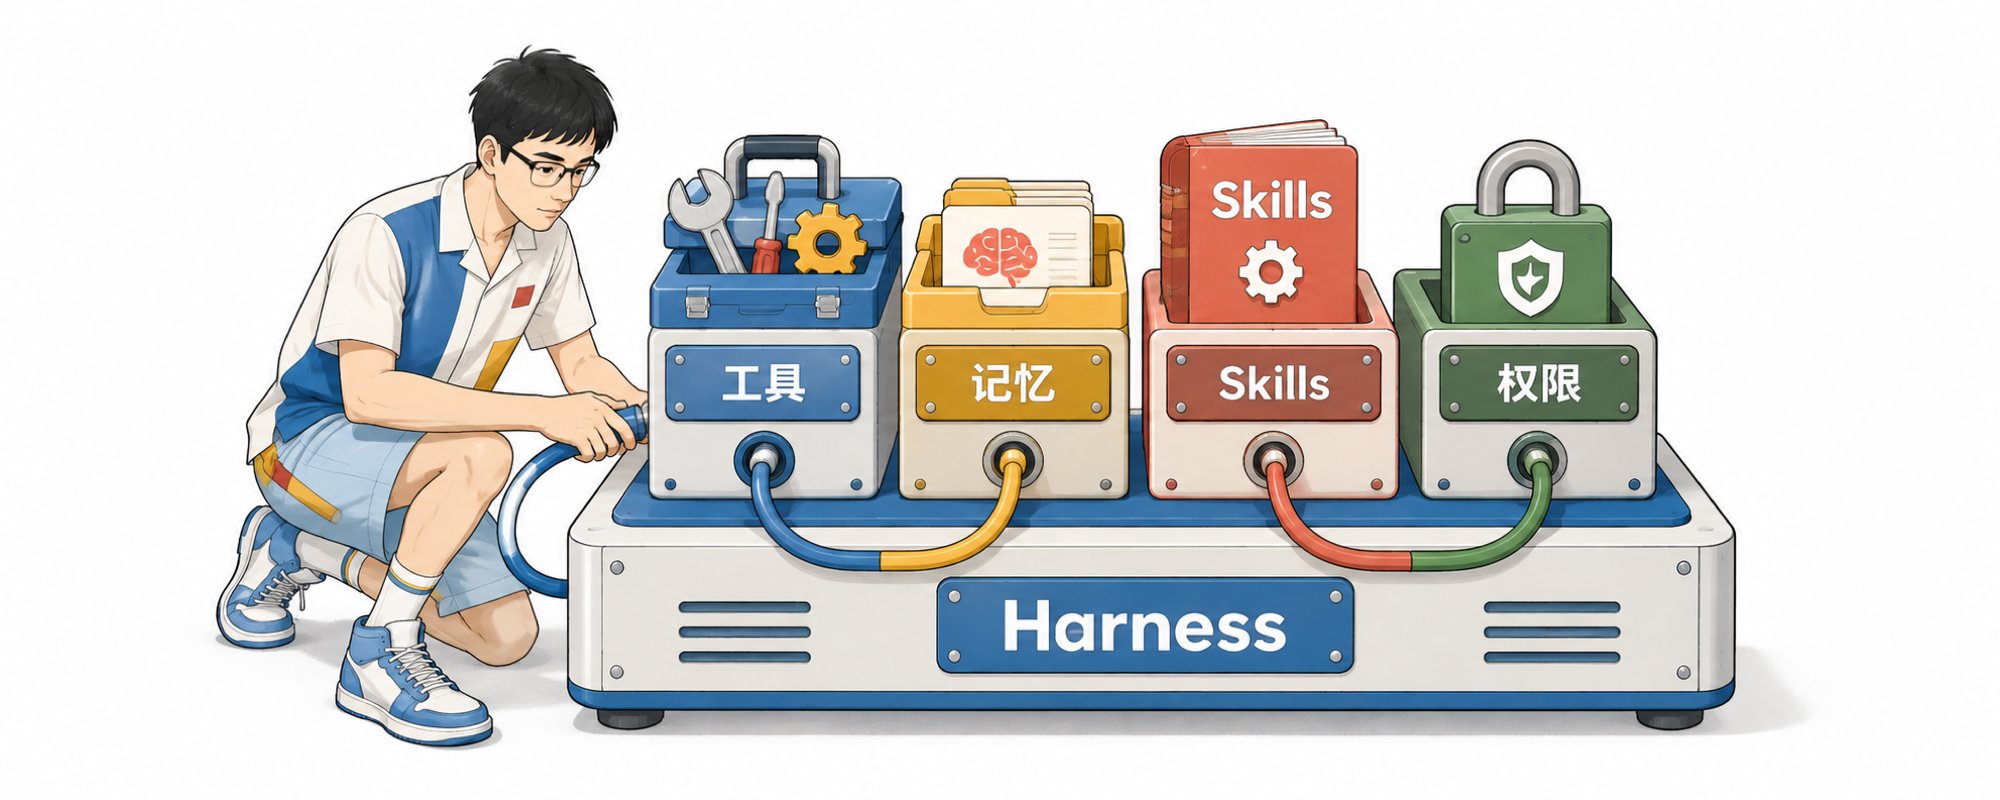 Harness Engineering 外壳与工具包裹体系
工具本身好不好用,是开发工具时要解决的问题。Agent 会不会用,则取决于工具说明有没有写清楚:它能做什么、需要哪些参数、返回结果怎么读、什么情况下不要调用。
工具名称太像,模型就会选错;参数说明含糊,计划看着没问题,一执行却拿不到结果。记忆也是同样的道理:内容保存在硬盘里还不够,得在合适的时机取出来,放回当前上下文。
Skills 本质上也是提示词。它把一类任务的做法提前整理好,需要时再把对应规则交给模型,省去每次从头解释。Harness 负责把这些组件装到模型周围,并在合适的时机告诉模型现在能用什么、该怎么用。
Loop Engineering:让模型根据结果继续执行
Agent 和普通问答最大的区别,在于做完一步后还会检查结果。搜索没找到答案就换关键词,工具调用失败就改参数,资料不完整就继续补充,验证通过后才结束。
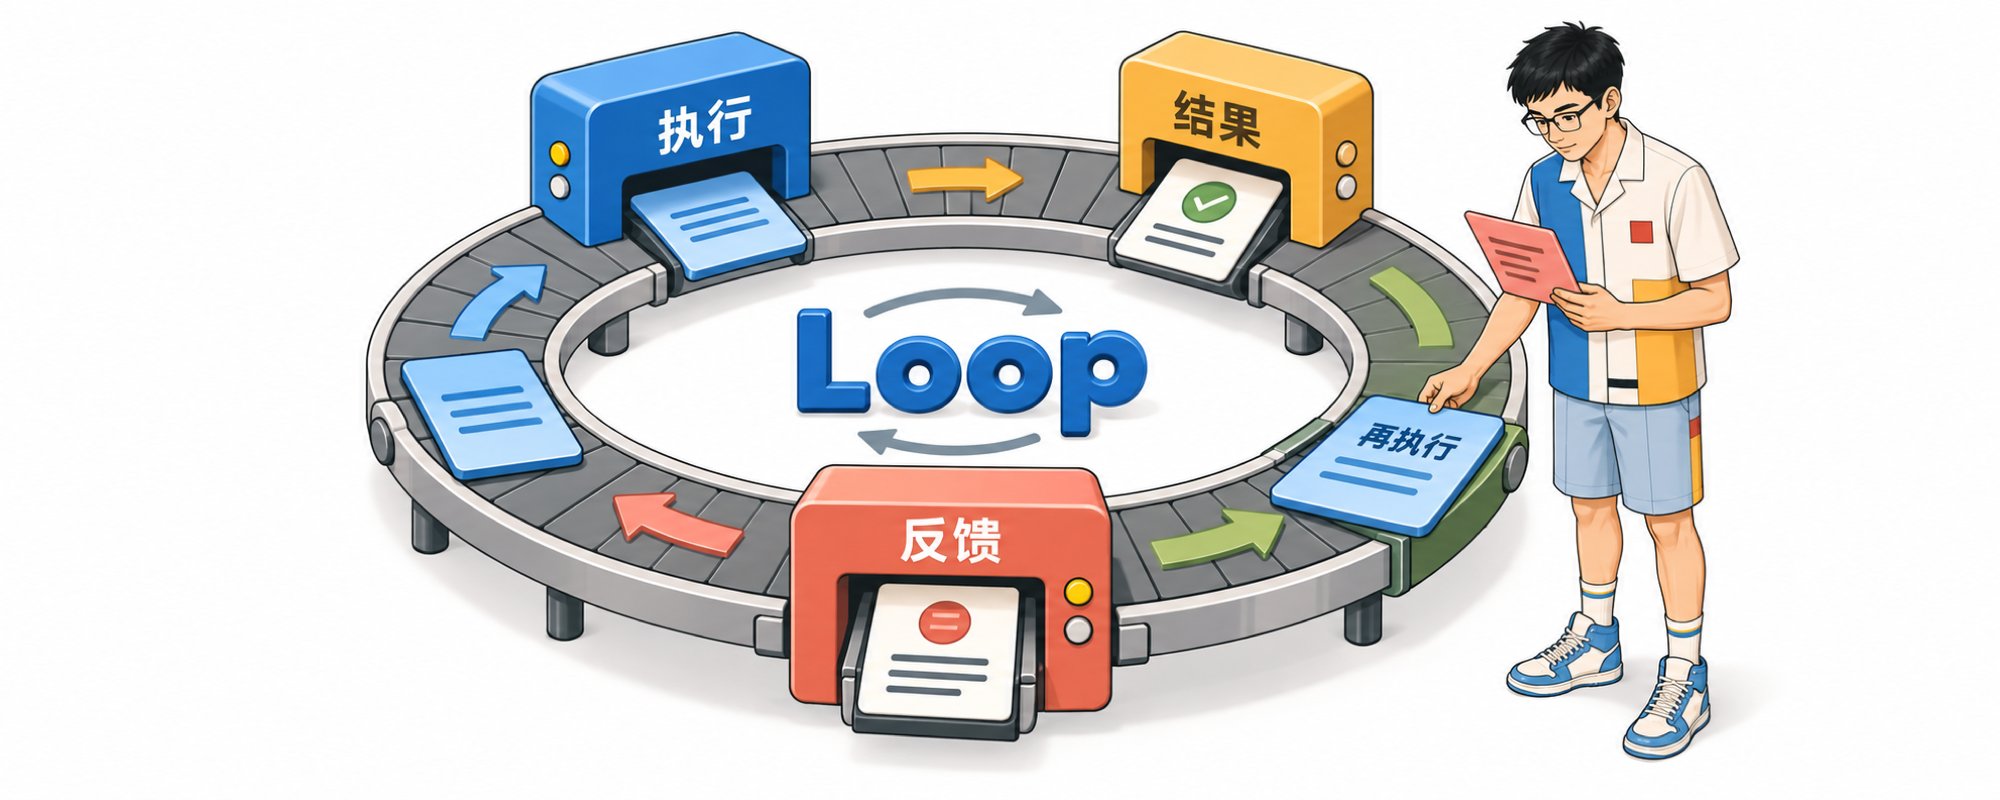 Loop Engineering 执行反馈与修正机制
代码里的循环只能保证再跑一轮,不能告诉模型下一轮怎么改。下一轮会不会换做法,取决于上一轮的结果和失败原因有没有准确送回模型。
如果反馈只有一句“失败了,请重试”,模型大概率会原样再做一次。更有效的做法是写清楚未通过的项:哪一步失败、缺什么、哪些步骤已完成、下一轮允许调整什么。
最大轮次可以由代码写死,充当刹车。Loop 能不能越跑越接近目标,依然取决于完成标准和失败反馈有没有写清楚。
Eval Engineering:别只看最后那句话
近期常有人讨论 Eval Engineering,背后对应一个很实际的问题:Agent 说“任务完成了”,不代表事情真的办妥了。
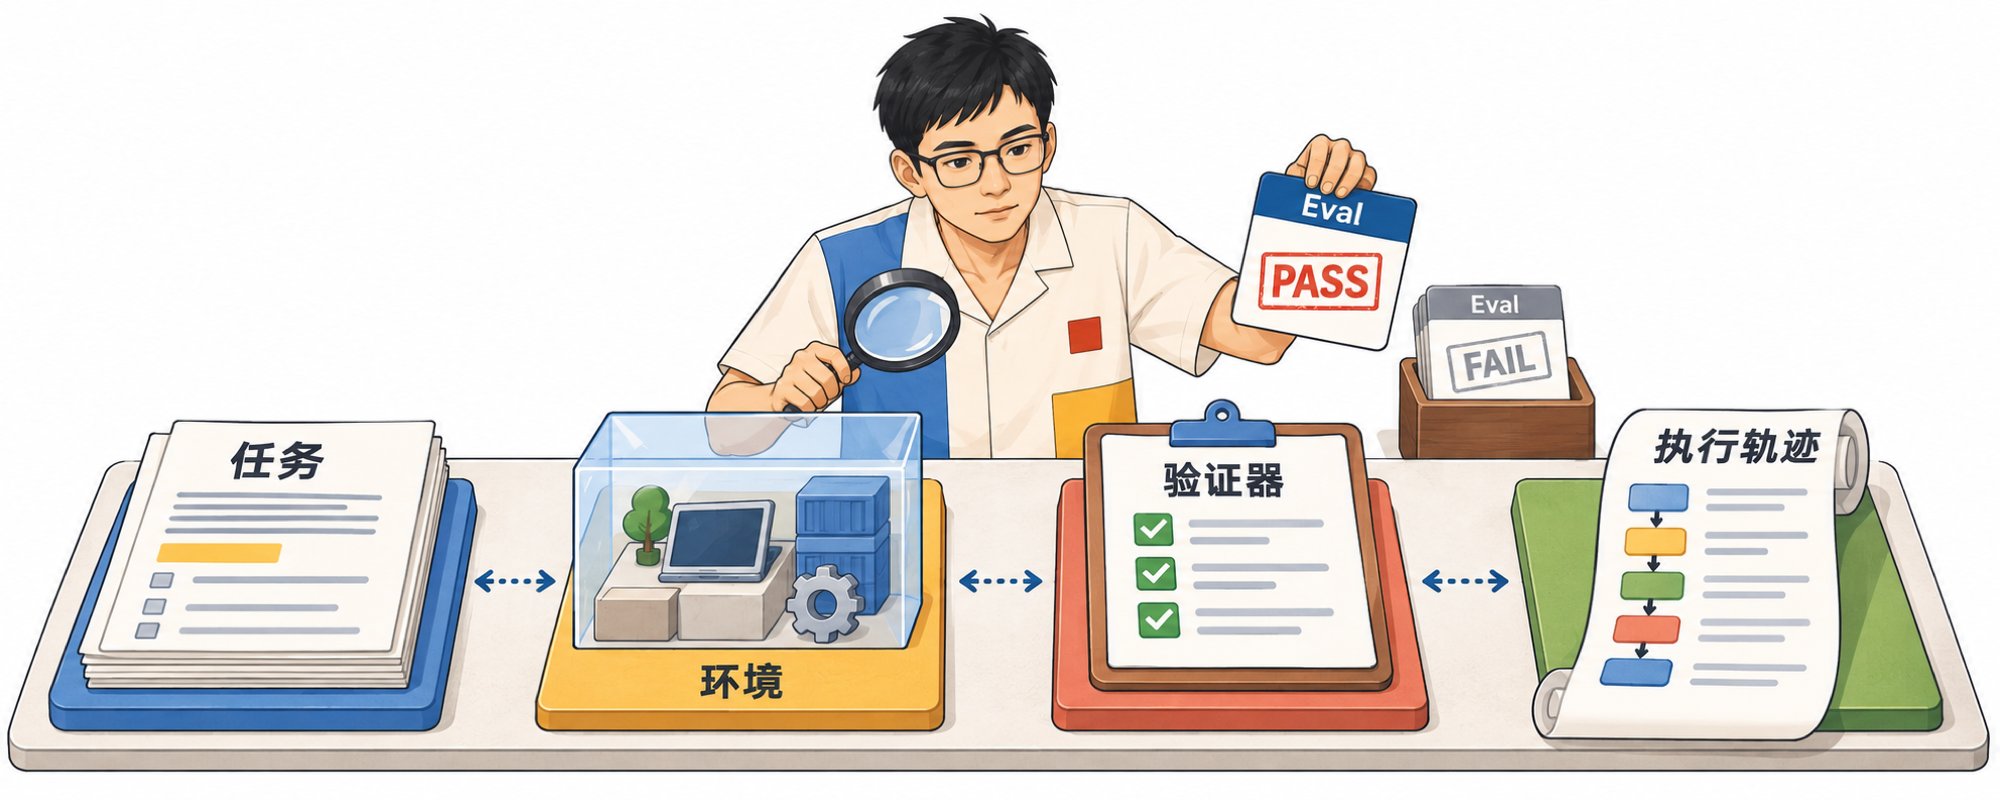 Eval Engineering 轨迹审查与真实运行评估
只看最后一段回答,很容易漏掉过程里的问题。它可能用错了工具,漏掉了关键步骤,或者碰巧给出一个像样的结果,实际却没有满足原任务要求。
评估不能只盯着最终答案,还要检查任务定义、运行环境、验证器和执行轨迹。验证规则本身也可能写错:如果标准含糊,Agent 就会钻空子,拿到高分却没把事情做好。
LangChain 近期分享了一种做法:从真实运行记录里找出失败案例,还原成可重复执行的测试任务,再对比修改提示词、工具或流程后是否有改善。评估可以放在运行中,也可以放在运行后。只要还需要模型判断结果够不够好,完成标准就必须先写清楚。
Graph Engineering:路线可以固定,判断不能全写死
任务复杂后,单条直线流程就不够用了。验证通过就进入下一步,资料不足就退回搜索,碰到高风险操作就暂停等待人工确认,不同子任务还可以并行执行。
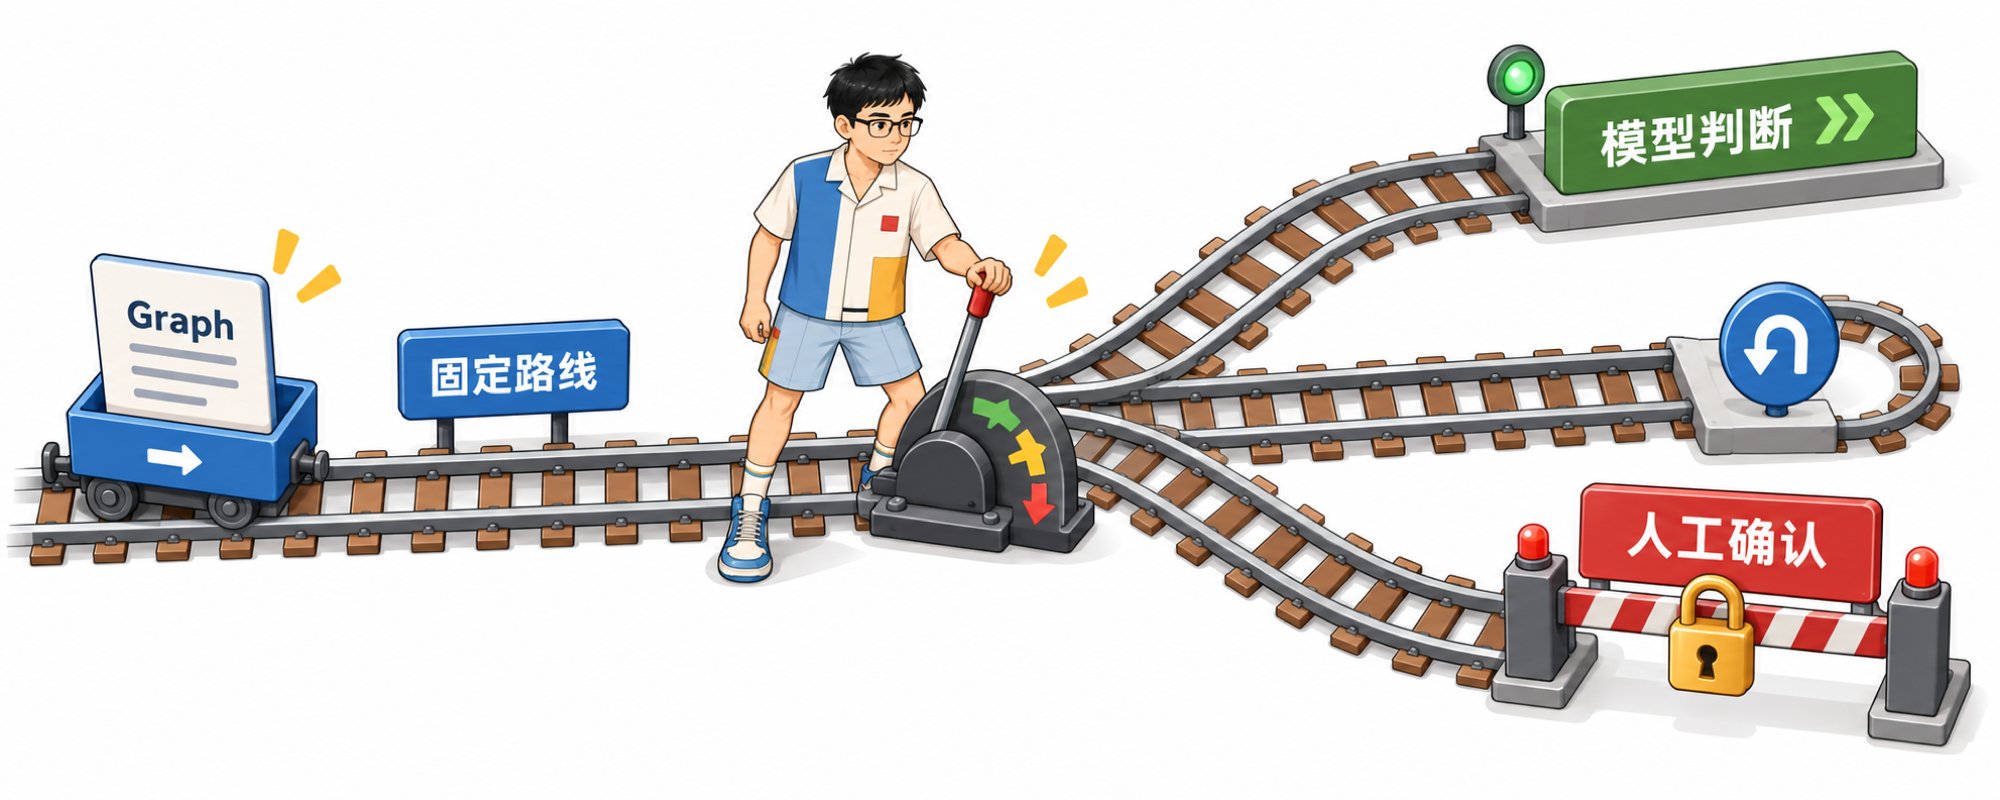 Graph Engineering 状态机路线与分支选择
这些节点和路线连在一起就是 Graph。代码可以规定哪个节点先跑、哪条边不能绕过、什么地方必须停下。
只要节点内部还有 Agent,模型就需要一份当前节点的提示词。它要读取当前任务、上一步结果、可用工具和通过条件,再决定这一步怎么做,以及把什么结果传给下一个节点。如果每一步、每个输入和每个结果都由代码写死,那就是传统工作流软件,用不上 Agent。
Graph 决定模型下一步去哪里,Prompt 决定它到了那里后怎么做。
代码管边界,提示词管判断
说提示词是核心,不等于所有逻辑都要写进提示词。最大运行轮次、文件读写权限、付款审批和数据访问范围,都应该由代码和系统权限直接控制。
提示词负责边界以内的判断。任务怎么理解、工具怎么选、结果怎么评、失败后补什么,这些环节才需要模型。
没有代码兜底,Agent 可能越界或陷入死循环;没有提示词,Graph 里只剩一堆空节点,工具摆得再多,模型也不知道怎么用。工程化的核心是分清边界:确定性规则用代码写死;需要模型判断的部分,把上下文、工具说明、判断标准和反馈写清楚。
架构分工:代码硬边界与提示词软判断
在 SRE 与 Agent 架构设计中,物理硬边界属于确定性逻辑,交由代码控制;软推理属于概率性语义决策,交由提示词引导。
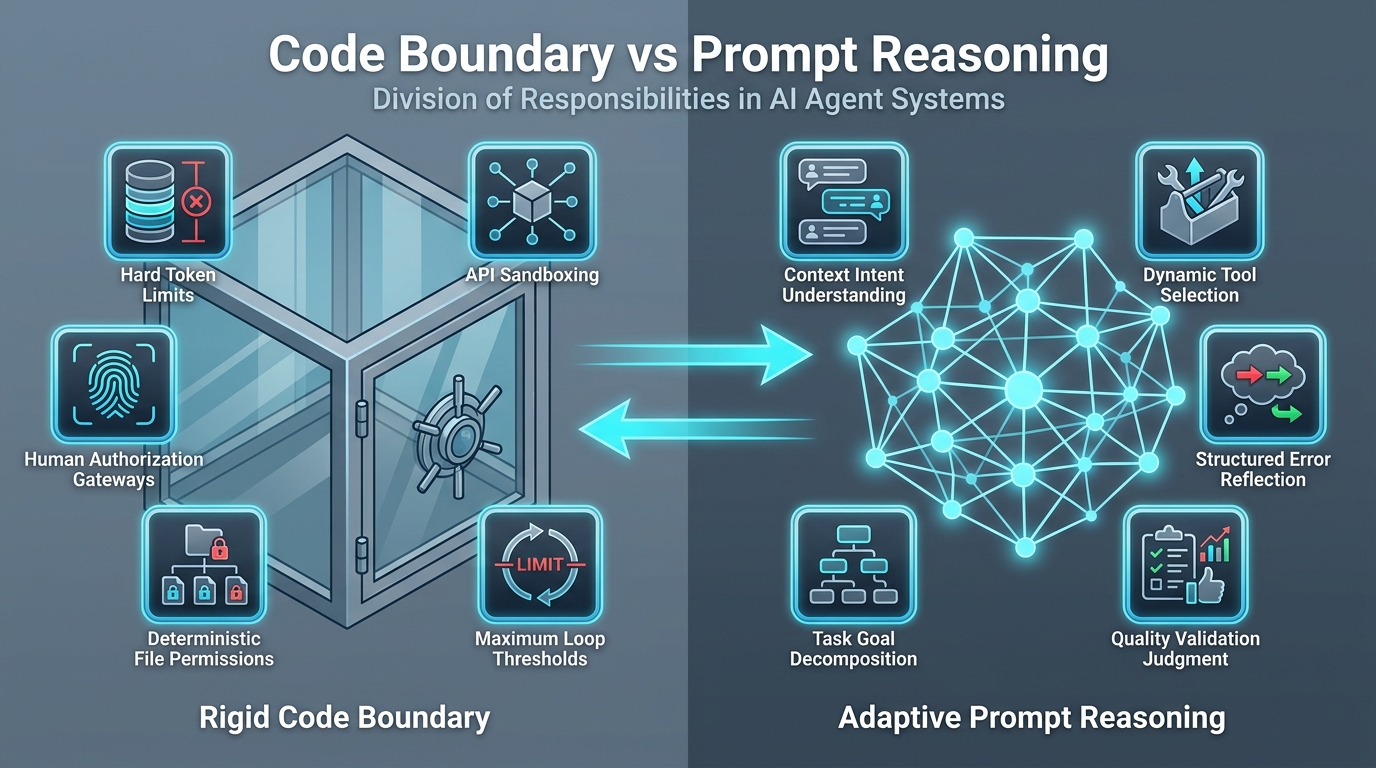 代码硬边界 vs 提示词软判断:系统职责分工图
这些 Engineering 到底新不新
这些问题并不新,我们早期做 Agent 时就已经在处理。工具怎么交给模型、结果怎么传回下一轮、流程哪里要固定,每一项都绕不开。
如今 Agent 执行的任务越来越长,提示词也从单句指令演变成运行中的动态系统。以前只关注单次回答,现在还要管理每一步的上下文、工具、反馈、评估、流程和退出条件,于是每个模块都有了独立的名字。
面对这些新词,不必先去背定义。可以先看模型这一刻收到了什么,失败结果怎么传回,哪一步由代码锁死,哪一步还需要模型判断。
Context、Harness、Loop、Eval 和 Graph 解决的都是同一组工程问题:提示词放在哪里、何时更新、怎样配合工具与流程,以及拿什么标准做评估。名字变多了,但模型每一步收到的依然是任务、资料、工具说明、判断标准和反馈。
我是 Miles,一个月做到 2 万粉,一周写出 3 篇百万曝光长文,其中 2 篇超过 200 万。我把以前做 Agent 的过程重新翻出来,就是想把这件事讲清楚。
 Miles Ma (@miles_mazy) 原文作者
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。