
深度实测 GPT-6.2 Astra 与 Sol:OpenAI 在“偏科战神”的道路上越走越远了
 深度实测 GPT-6.2 Astra 与 Sol:OpenAI 在“偏科战神”的道路上越走越远了
从 11 月 1 日前后社区陆续曝出灰测,苦等近 20 天后,OpenAI 终于在 ChatGPT、Codex 与官方 API 同步上线了新一代双模型:前沿旗舰
GPT-6.2 Astra(gpt-6.2-astra) 与 日常高效主力GPT-6.2 Sol(gpt-6.2-sol)。数字生命卡兹克(
@Khazix0918)在跑完百余次真实项目代码审查、多轮方案规划、2D 致敬短片及 Three.js 3D 游戏/古希腊世界长程构建后给出了极其犀利的定性:OpenAI 在“偏科”与“To 精英工业重器”的道路上越走越远了——在非科研沟通与平面动效审美上它被 Claude Fable 5.2 与 Gemini 4 Carbon 远远甩开;但在 单任务 Token 成本控制(低至 Claude 的 5%)、xhigh 代码找 Bug(84% / 96% 检出率)、终端科研(Vals 科学指数全球第 1)以及 3D 空间世界构建 上,它依然是无可替代的硬核执行机器。
 图 01:OpenAI 正式同步发布前沿旗舰 GPT-6.2 Astra 与日常主力 GPT-6.2 Sol
一、GPT-6.2 双模型基本信息:知识截止日期、灰测暗号与缓存降价 60%
本次同步上线的两款模型在定位、API 标识与知识截止时间上划分明确:
GPT-6.2 Astra(API 编号:gpt-6.2-astra):官方定位为“留给你最难项目使用的前沿旗舰模型”,知识截止日期更新至 2026 年 5 月 18 日(前代GPT-6 Astra为2026 年 4 月 30 日);GPT-6.2 Sol(API 编号:gpt-6.2-sol):官方定位为“日常高频工作的高效主力模型”,知识截止日期更新至 2026 年 6 月 1 日(受后训练 Post-training 影响,实际感知知识范围还会往后延伸一些)。
在 11 月上旬灰测阶段,极客圈鉴别账号是否命中 GPT-6.2 灰度的经典盲测技巧正是卡这个知识库窗口——直接提问 “禁止联网,你知道 Fable5 吗”。由于旧版 GPT-6 Astra 与 GPT-6.1 Sol 均不知道 Fable 5 的存在,只要离线能准确回答,即证明已切入 6.2 新权重:
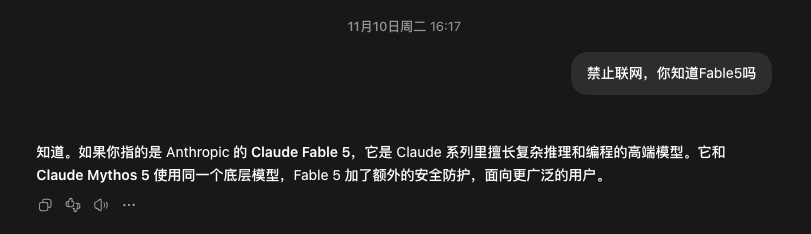 图 02:通过询问「禁止联网,你知道 Fable5 吗」鉴别是否命中 GPT-6.2 灰度模型
1.1 定价紧贴 Claude Fable 5.2,缓存读取从 $1.00 暴砍 60% 至 $0.40
继上周 Claude Fable 5.2 将 API 价格下调至 $8 / 1M 输入、$40 / 1M 输出 后,本次 GPT-6.2 Astra 也同步降价 20% 对齐至 $8 / $40,并将此前贵到令开发者肉疼的 缓存读取(Cached Read)从 $1.00 / 1M 直接砍到 $0.40 / 1M(降幅达 60%);而 GPT-6.2 Sol 维持 $2 / $10 / 缓存 $0.10 不变。
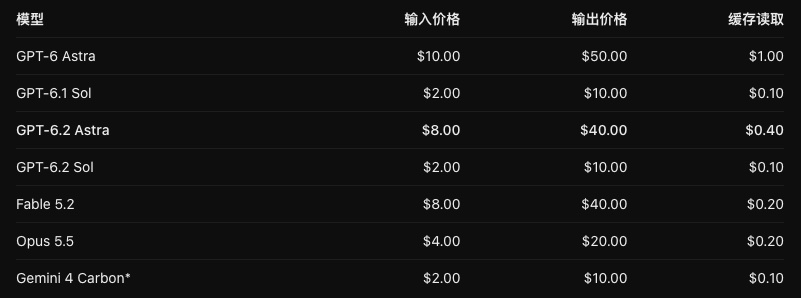 图 03:主流旗舰模型 API 输入、输出与缓存读取价格横评表(美元 / 百万 Token)
尽管单看缓存读取单价,GPT-6.2 Astra($0.40)仍高于 Claude Fable 5.2($0.20)以及限时半价的 Gemini 4 Carbon($0.10),但相比发布初期“一天就能烧光一个 $200 Pro 账号额度”的 GPT-6 Astra 已经大幅改善。更核心的账本逻辑在于:决定真实开销的绝不只是每百万 Token 单价,而是「完成单个任务实际消耗的 Token 总数」!
二、核心护城河:「每个任务花多少钱」与近 7 倍的 Token 效率差
由于在开放式综合灵性与上限表达上确实难以正面压制 Claude,OpenAI 本次所有官方评测图表的横轴都聚焦在同一个核心工程指标上:Cost per task(每个任务花多少钱)。
2.1 Agents' Last Exam(Agent 期末大考):高出 5.5 分,成本仅 Claude 的 5%
在衡量多步骤复杂专业工作闭环的 Agents' Last Exam v1.1 中:
GPT-6.2 Astra:得分约78%,平均每个任务仅花约$3(比前代GPT-6 Astra高出5.2 分,成本不到三分之一);Claude Fable 5.2:得分约73%,平均每个任务却高达约$60——GPT-6.2 Astra不仅分数反超5.5 分,单题成本更是只有对方的5%!
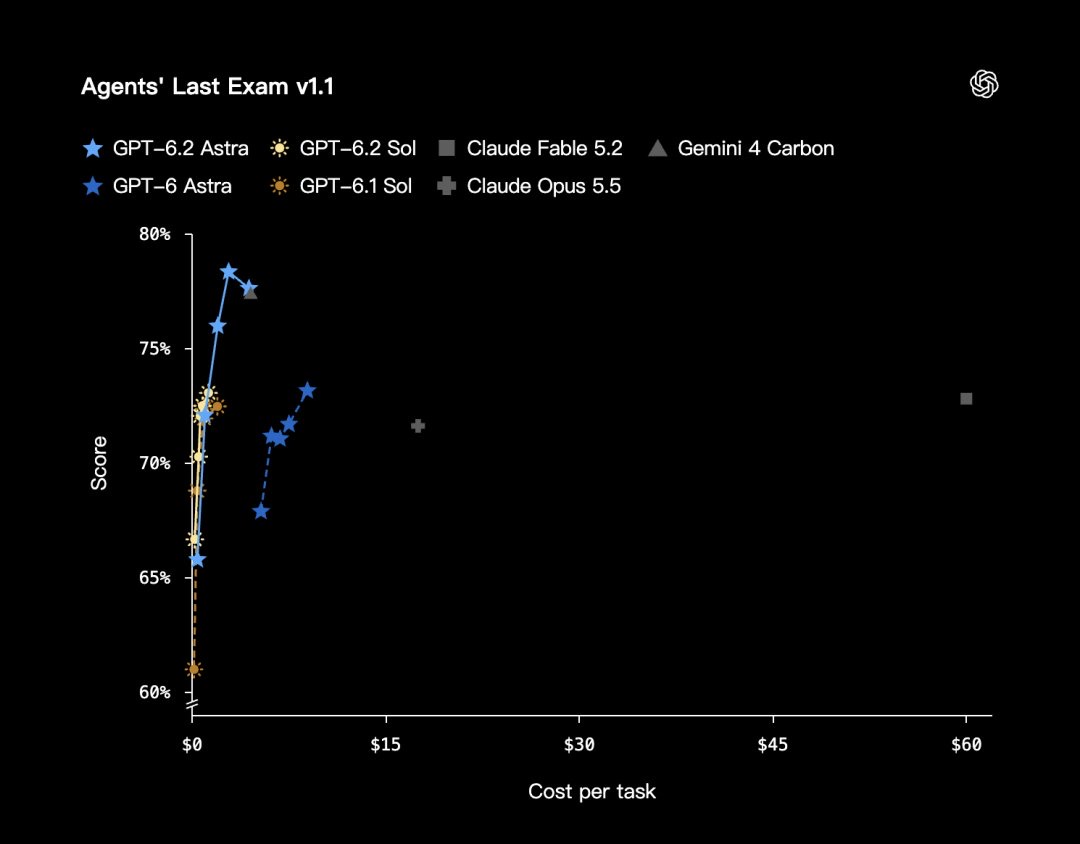 图 04:OpenAI 官方 Agents' Last Exam v1.1 得分与单任务成本(Cost per task)对比曲线
为什么纸面单价同为 $8 / $40,最终单任务账单能差出 20 倍?Artificial Analysis 统计的 每项任务输出 Token 加权平均值 揭示了底层原因:GPT-6.2 Sol 平均仅吐出 40k、GPT-6.2 Astra 仅吐出 41k(答案 15k + 推理 26k),而 Claude Fable 5.2 为了暴力拉高能力上限,单题平均狂烧 274k 输出 Token(整整差出近 7 倍)!
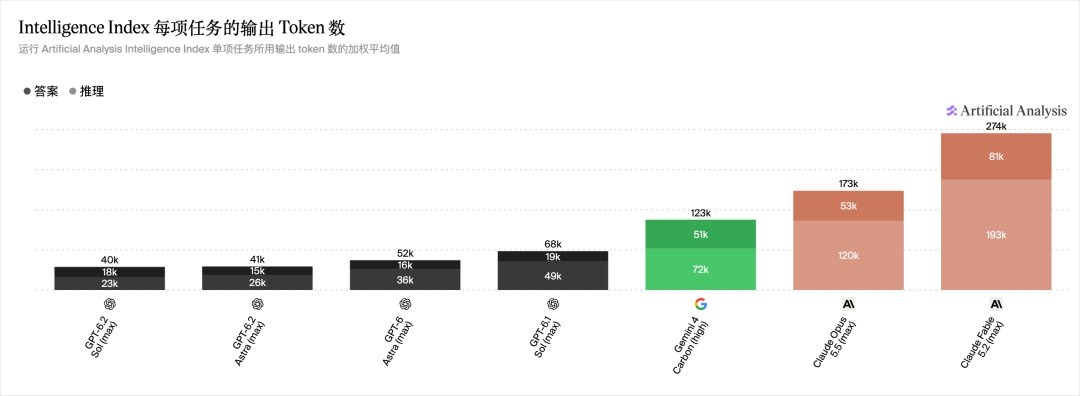 图 05:Artificial Analysis Intelligence Index 每项任务输出 Token 数对比(GPT 40k/41k vs Claude Fable 5.2 274k)
在 $200 Pro 会员订阅体感上同样如此:本轮实测跑完 4 个视频与 3D Case + 2 个大型方案规划 + 近 100 次代码审查,周额度从 12% 降至 6%(仅消耗 6% 周额度);而此前跑 10 个 Claude Fable 5.2 Case 就直接烧掉了 近 30% 周额度。
交互测算台:单任务 Token 经济账 & 三轮代码审查 ROI 计算器
在下方测算台中拖动月度任务量与 PR 审查频次,实时对比 7 款旗舰模型的输出 Token 密度以及 GPT-6.2 Sol / Astra (xhigh) 的代码审查投入产出比:
2.2 终端科研榜首(Vals 科学指数第 1)、GDPval v2 与 AA 智能指数重回全球第 2
在终端科研能力评测 Terminal-Bench-Science 0.1 上,GPT-6.2 Astra 拿下约 77% 高分且单任务仅约 $7(前代 GPT-6 Astra 为 68% / 约 $24),并在第三方 Vals Science Index v1(科学指数) 稳居全球第一,被众多一线科研与算法团队奉为主力实验模型;在考察咨询、金融、设计长程知识工作的内部基准 GDPval v2 上也呈现同样的极低 Token 成本优势:
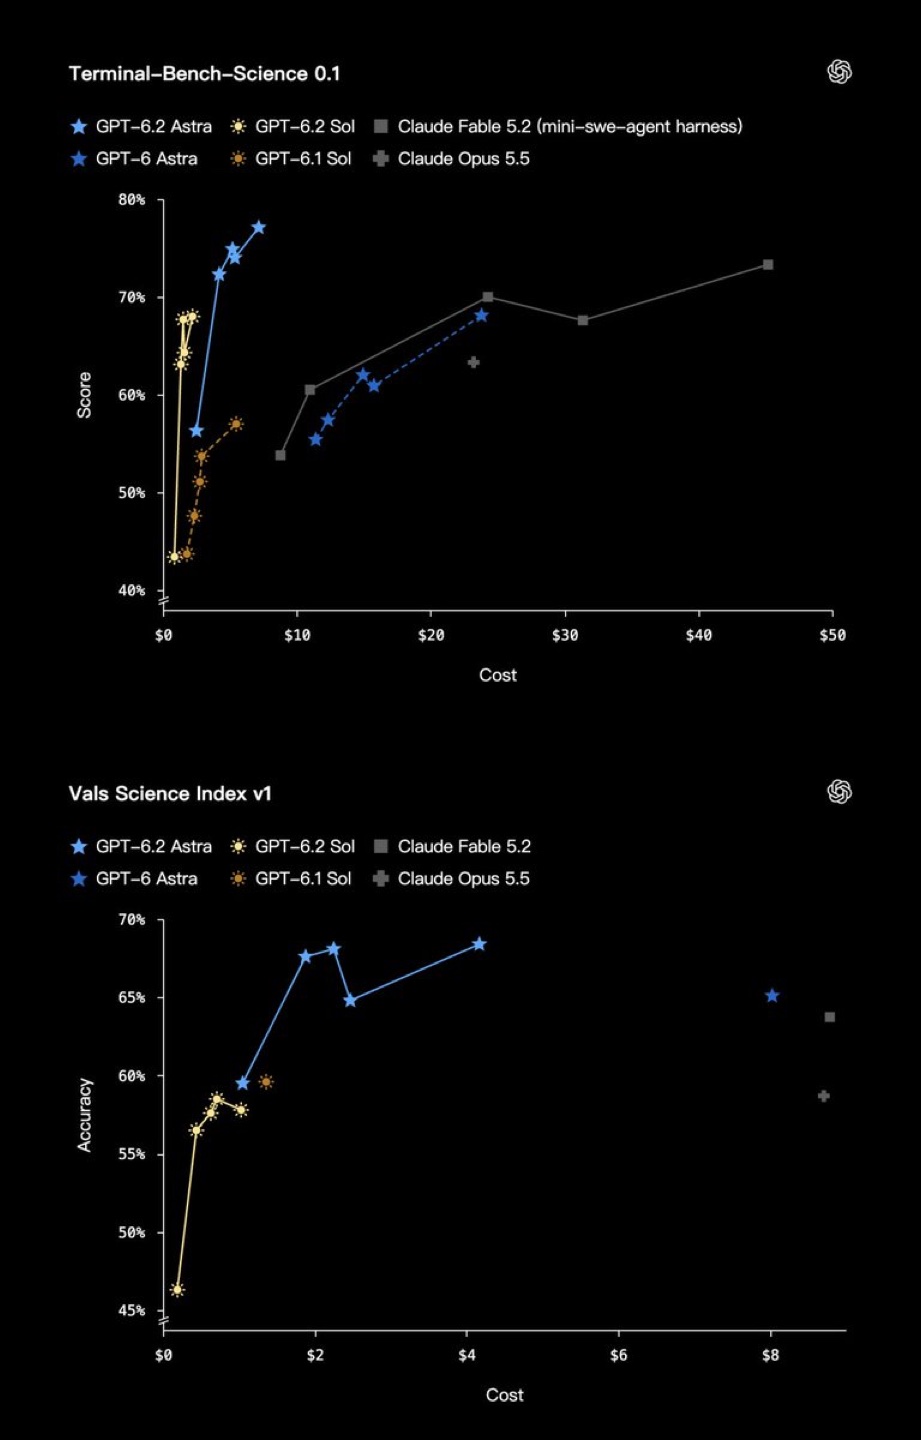 图 06:Terminal-Bench-Science 0.1(~77% / ~$7)与第三方 Vals Science Index v1 双双登顶
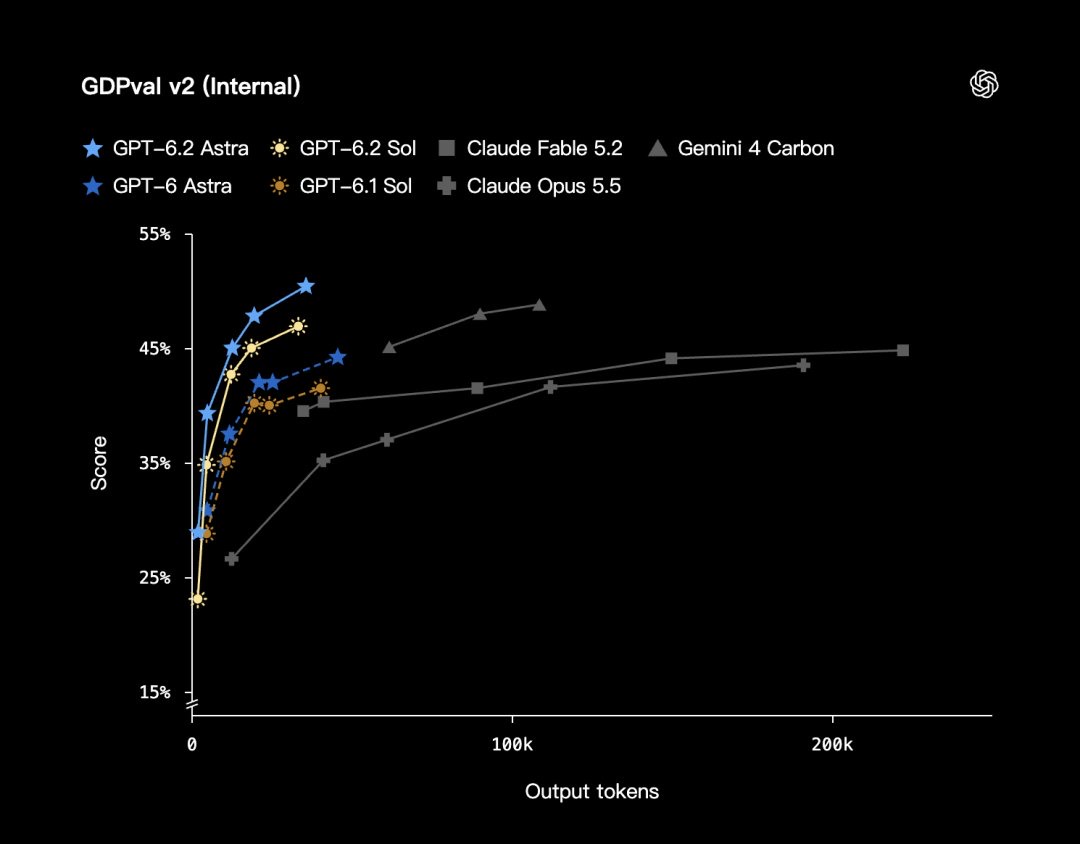 图 07:OpenAI 内部 GDPval v2 长程行业知识工作输出 Token 效率曲线
在权威第三方 Artificial Analysis Intelligence Index v5.0.1 榜单上,GPT-6.2 Astra 暴涨 +6 分 达到 62 分,重回全球第 2(仅次于 Claude Fable 5.2 的 65 分,高于 Gemini 4 Carbon 的 60 分);GPT-6.2 Sol 上涨 +2 分 达到 57 分(追平上一代旗舰 GPT-6 Astra)。
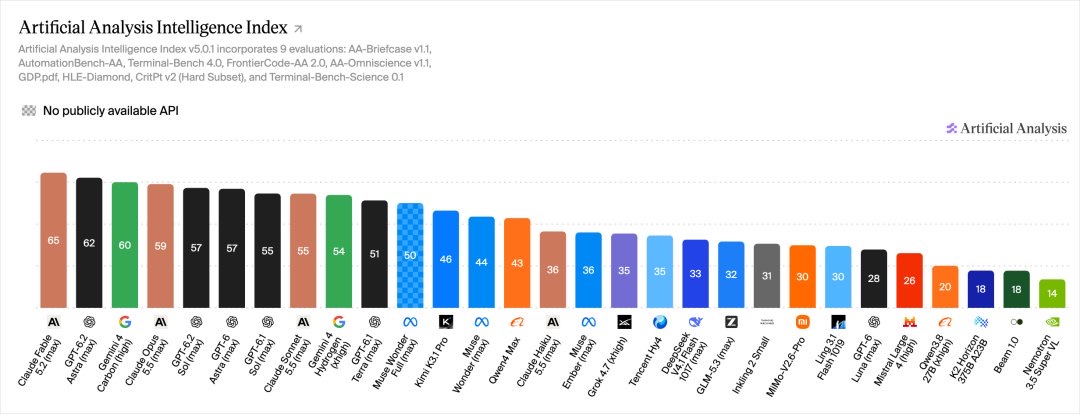 图 08:Artificial Analysis Intelligence Index v5.0.1 最新全球排名总览
三、四大维度真刀真枪实测:极致的短板与极致的统治力
3.1 沟通与非科研方案规划(惨败短板):AIHOT 留言区评估 24 分钟给出“人工审评论”
近期不少读者希望在卡兹克业余独立维护的个人项目 AIHOT 每条新闻下方增设评论交流区:
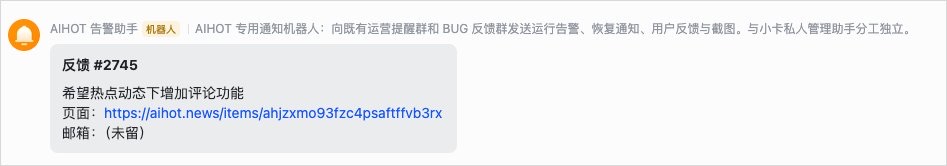 图 09:读者关于在 AIHOT 新闻下方增加评论交流区的反馈(一)
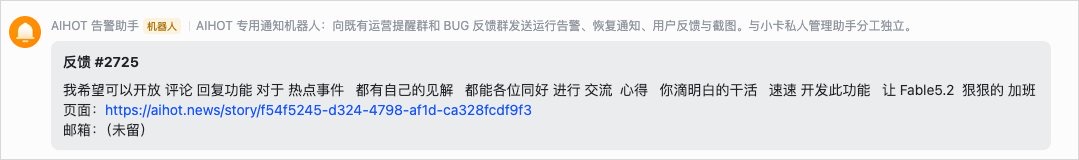 图 10:读者关于 AIHOT 增加评论交流区的反馈(二)
这个需求真正的难点绝非前端评论组件,而是国内手机号实名认证的短信验证码成本与强制“先审后发”的合规风控风险。使用同一段大白话 Prompt 对比测试:
| 1 | 最近已经收到很多用户的反馈,希望我们能在AIHOT中间加一个简单的留言区,方便大家来简单的交流。那基于这个背景,你可以帮我评估一下,如何在保证合规且安全的情况下,来以最小的成本去设计整个的留言与交流功能。 |
Gemini 4 Carbon(耗时约 5 分钟,高分通过):开篇第一句话就精准理解个人维护项目的成本与合规顾虑,完整列出必守法规项,并给出极具启发性的最小成本架构——不开放自定义昵称、不做多层盖楼、不开全量只开精选评论,且在“先审后发”环节直接复用 AIHOT 现成的 Agent 全自动新闻审查机制,最后附上清晰对比表供决策:
 图 11:Gemini 4 Carbon(5 分钟)第一句话即精准命中个人项目痛点
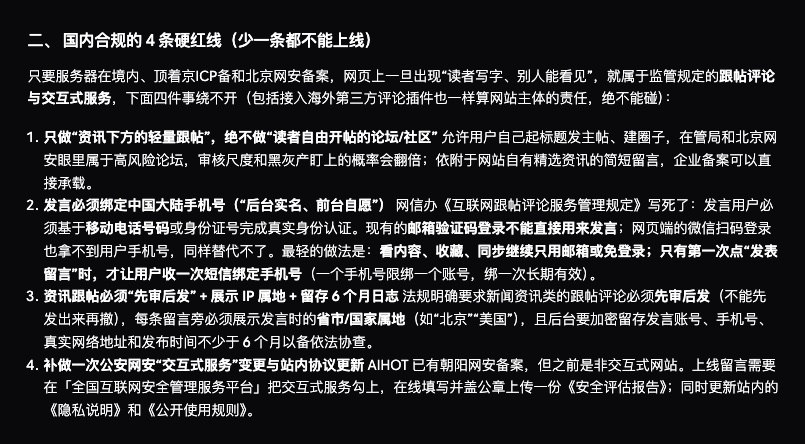 图 12:Gemini 4 Carbon 梳理的实名认证与先审后发合规红线
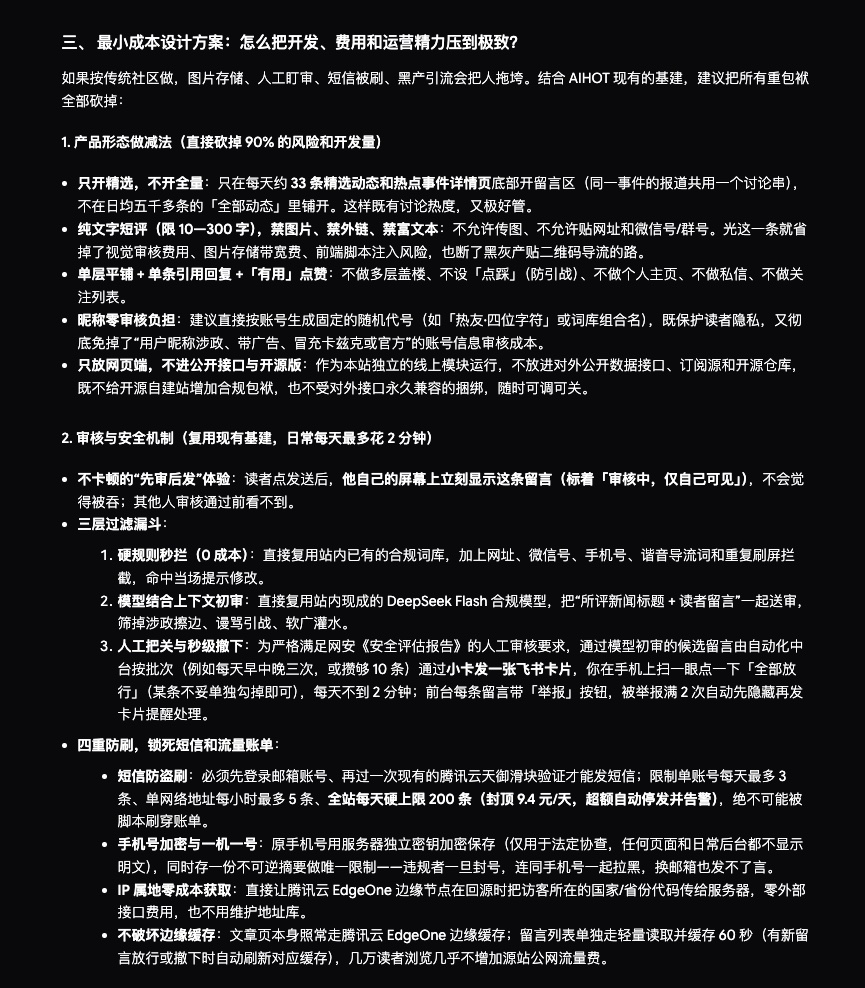 图 13:Gemini 4 Carbon 给出的极简低成本架构(复用现有 Agent 自动审核机制)
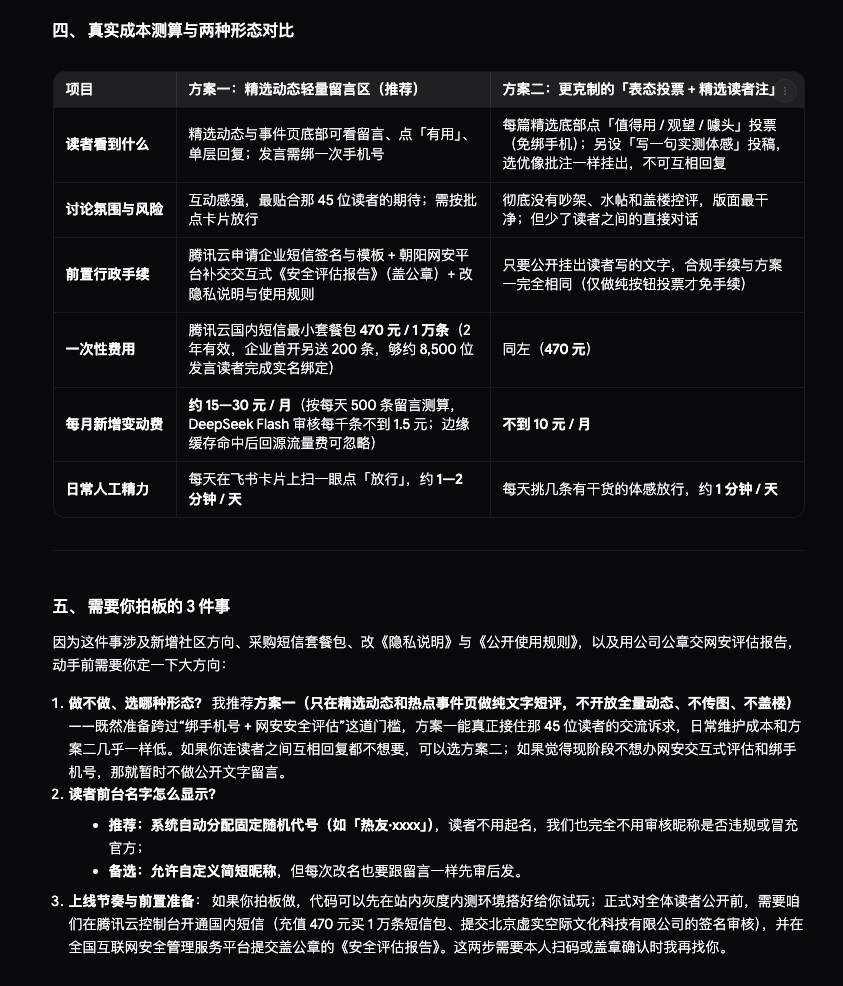 图 14:Gemini 4 Carbon 结尾提供结构化方案对比与拍板引导,可读性极佳
GPT-6.2 Astra(苦跑 24 分钟,慢近 5 倍,彻底翻车):篇幅虽短却读起来云里雾里、可读性极差,甚至在明知是个人业余项目的前提下荒唐建议 “前期采用人工审核”;另一份排行榜方案规划同样晦涩难读:
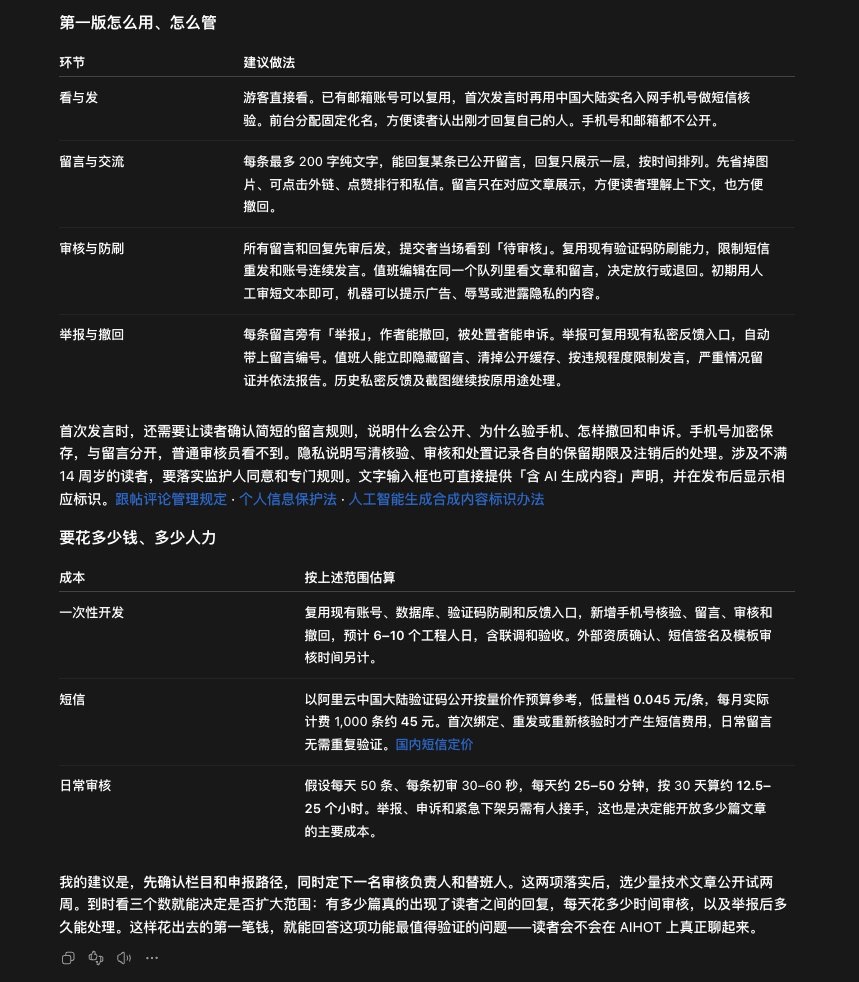 图 15:GPT-6.2 Astra 耗时 24 分钟输出的留言区方案——行文生硬且建议“前期人工审核”
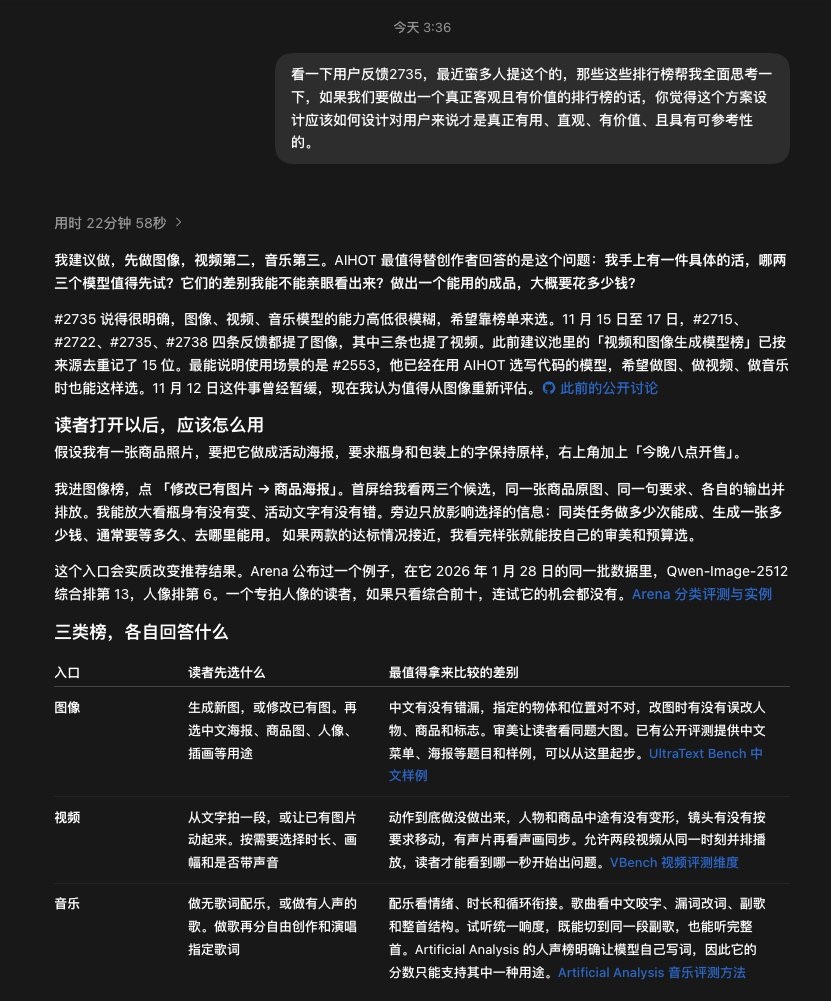 图 16:GPT-6.2 Astra 在排行榜方案规划上同样暴露出可读性与主动思考短板
3.2 自动化代码审查(王牌杀手锏):6.2 Sol xhigh 跃至 84%,Astra 干到 96%!
与糟糕的沟通体验截然不同,在 Claude 写代码 ➔ 脚本自动调度 GPT 进行最多 3 轮 xhigh 代码审查 的严肃工程环节,GPT-6.2 迎来了质的飞跃!在包含 102 个真缺陷的内部项目评测集中:
审查模型 (xhigh 推理强度) | 真缺陷检出比例 | 命中 / 部分命中 / 漏检 | 每次审查中位用时 | 单次审查成本 | 工程选型定位 |
|---|---|---|---|---|---|
GPT-6.1 Sol | 65% | 61 / 3 / 38 | 5.7 分钟 | $0.31 | 旧版主力,漏检偏多,建议立即升级替换 |
GPT-6.2 Sol 🏆 | 84% | 80 / 7 / 15 | 3.9 分钟 | $0.43 | 性价比最强默认审查模型(更快更准!) |
GPT-6.2 Astra | 96% | 91 / 1 / 10 | 8.1 分钟 | $1.60 | 逼近满分的终极守门员(慢约 1 倍、贵约 4 倍,适合发版前终审) |
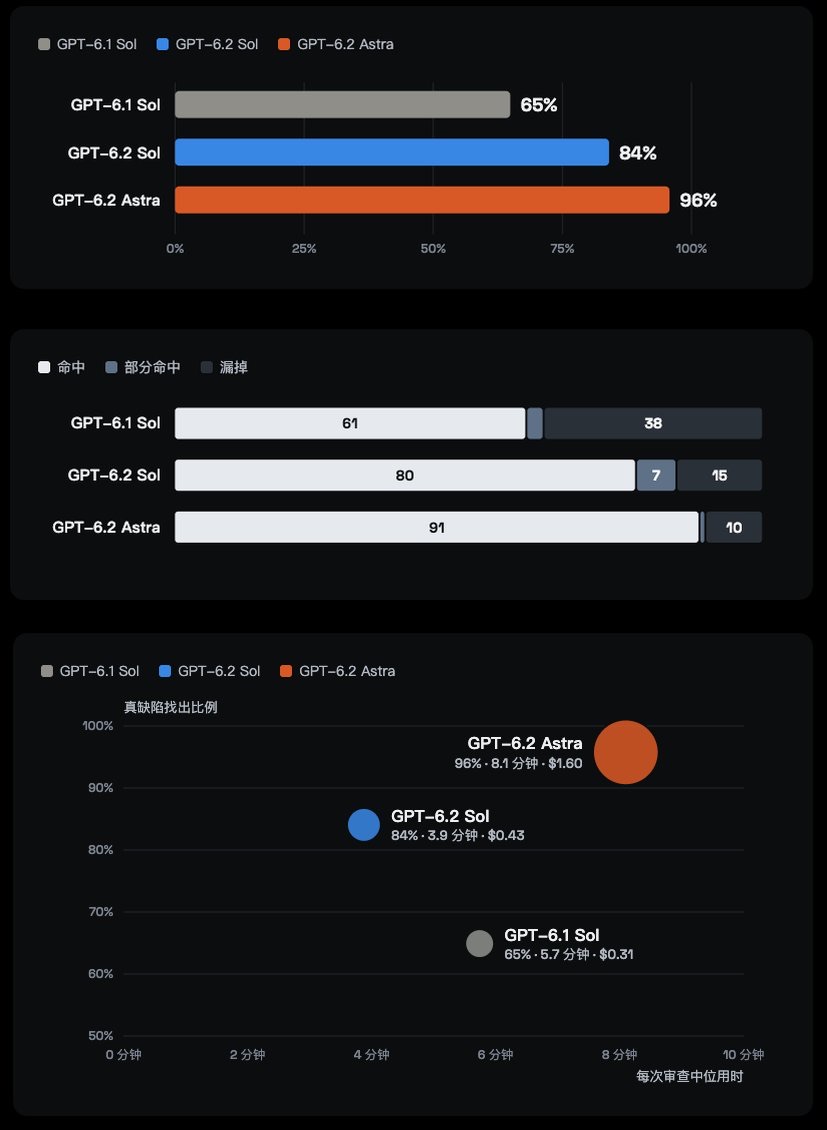 图 17:xhigh 强度下三款 GPT 模型代码审查真缺陷检出比例、命中分布与耗时成本散点图
3.3 平面与 2D 动效视频审美(惨不忍睹):四周年致敬短片三模型同台对比
在 2D 视觉与动效审美上,OpenAI 依然完全没摸到门道。以经典评测题 《40–60 秒 ChatGPT 四周年第三方致敬动效视频(2022.11.30–2026.11.30)》 横向对比三家旗舰作品:
| 1 | 做一支 40 秒到 1 分钟的 ChatGPT 四周年致敬动效视频(2022.11.30–2026.11.30),16:9 横版,无旁白,配原创音乐。内容自己联网查证,讲这四年的关键版本、里程碑和数字,不得杜撰。动手前先去 OpenAI 官网、博客和近期发布视频里观察他们的视觉风格,提炼后作为这支片子的视觉基调。节奏要快,动效密、画面饱满,随音乐卡点。片子定位是第三方致敬,不要做成 OpenAI 官方出品的样子。 |
3.4 3D 空间视觉与 Three.js(意外惊喜):具身空间底座发力,1 小时肝出极繁古希腊世界
与惨淡的 2D 动效形成鲜明反差——得益于 OpenAI 持续在 空间视觉(Spatial Vision) 与具身智能方向的重兵投入,GPT-6.2 Astra 在 3D 游戏与 Three.js 复杂场景构建上迎来了超预期爆发:
- 第一人称 3A 写实风《神庙逃亡》:仅用一句质朴提示词即生成极具大作质感的游戏封面,针对玩法理解微调 1 轮后即可丝滑跑酷:
| 1 | 给我做一个第一人称的「神庙逃亡」游戏。极度详细的游戏画面质量,视觉上看起来要能跟 AAA 级游戏匹敌。让它规模小一点,但其他方面要有令人印象深刻的照片级真实图形。 |
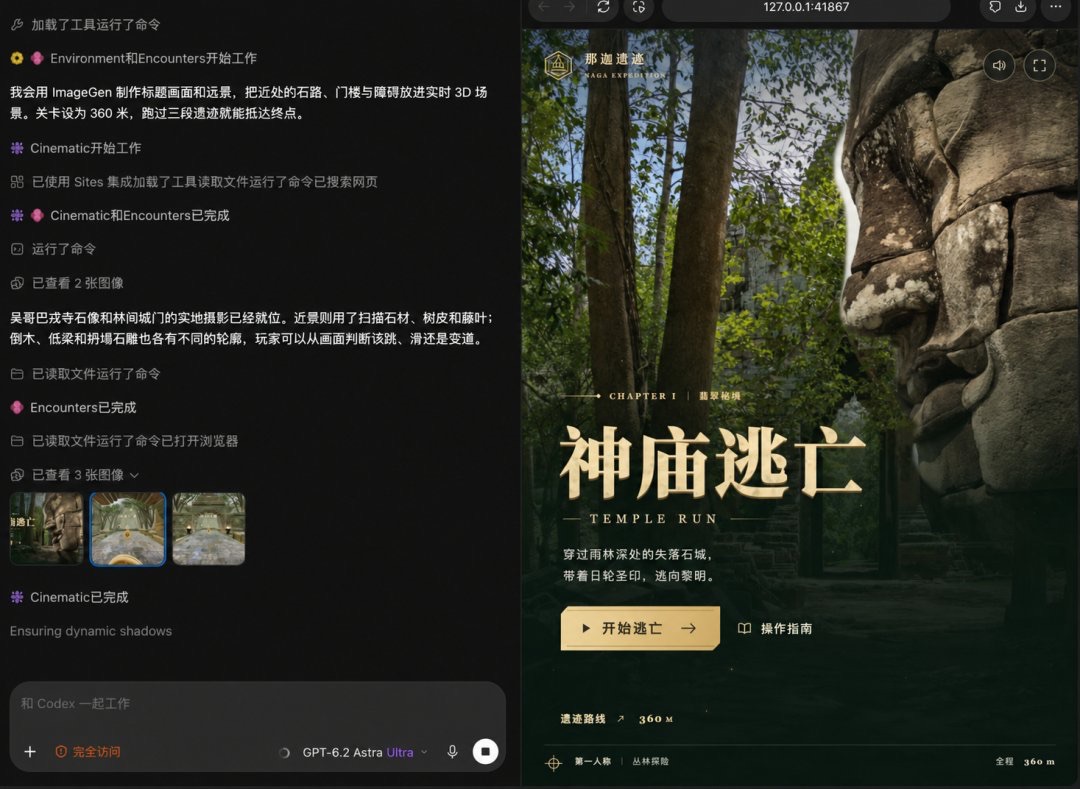 图 18:GPT-6.2 Astra 生成的第一人称《神庙逃亡》游戏启动封面
- Three.js《秋日黄昏乡村小火车站》:光影层次与轨道空间布局自然细腻:
- 1 小时+ 极限攻坚 Three.js 极繁《古希腊世界》:初版生成后,卡兹克随手截了一张此前 X 上爆火的 Claude 长时构建案例画面喂给 GPT 让它“照着建”——原本不抱希望,结果
GPT-6.2 Astra连续硬跑了 1 个多小时,交出了极其震撼的可交互古希腊卫城世界 HTML:
| 1 | 运用Three.js,采用极繁艺术风格尽全力还原出最真实、宏伟壮观且复杂的古希腊世界,要求真实细腻,最后交付一个可交互的HTML文件。 |
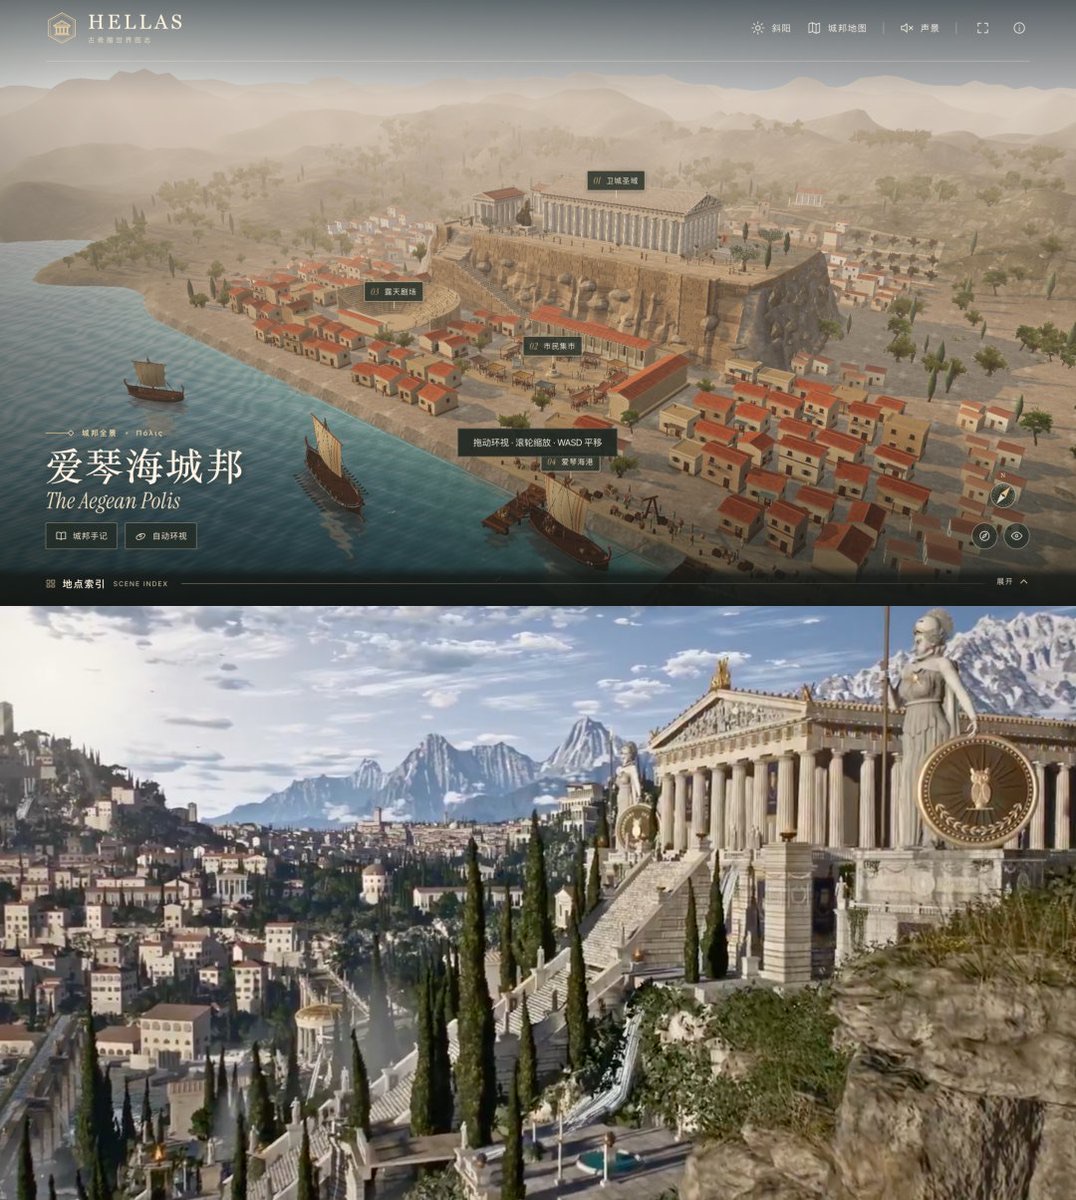 图 19:二轮喂给 GPT-6.2 Astra 作为空间密度与光影参照锚点的 Claude 爆款场景截图
四、写在最后:反直觉认知与「Claude/Gemini 统帅 + GPT 执行」最优解
过去很多人习惯性地认为“Claude 是做 ToB 的,GPT 才是做 ToC 的”。但演进到今天,定位其实已经彻底反转:
Claude Fable 5.2与Gemini 4 Carbon才是真正适合普通人(ToC)的模型:它们易于沟通、主动思考、表达清晰,能帮普通创作者拓展过去无法触及的能力边界;GPT-6.2系列则是彻头彻尾「To 精英」的工业精密仪器:它极度严谨、绝对听话、实验信息密度极高,在科研与算法大佬手中如鱼得水,但普通人直接拿自然语言跟它聊开放式需求会非常痛苦。
实战调度台:按场景切换「统帅 + 执行工兵」最佳组合与指令契约
给所有开发者的终极落地解法:
坦然把需求沟通、产品规划、2D 视觉审美与业务主代码交给 Claude Fable 5.2 或 Gemini 4 Carbon,再让这两位“统帅”输出严密的规格书去指挥 GPT-6.2 Sol xhigh(日常默认 3 轮代码审查,84% 检出率 / $0.43) 与 GPT-6.2 Astra(科研终端、3D 空间世界构建与核心上线前 96% 终审)——各展所长,体验与账单双双封神。
信源致谢:本文评测数据、19 张原版对比图与 6 支实机演示视频均整理自 数字生命卡兹克(@Khazix0918) 发布的《深度实测GPT-6.2 Astra,OpenAI在偏科的道路上越走越远了。》,并同步归档于 Evaoo AI Agent 实操专栏。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。