
你不知道的 GEO:AI 可见性的原理、实践与取舍
 给创造者的 GEO 教程:让 AI 主动找到你
。
这几天有好几个朋友 @ 我,说他们问 AI 时,我的开源工具获得了主动推荐。我之前没做过专门优化就被收录了,于是打算花一小时把内容做下结构化整理。我不喜欢刷排名或制造垃圾内容,这篇文章只讲怎么帮 AI 读懂你已有的内容。
AI 搜索和传统搜索的筛选逻辑不同。传统 SEO 拼的是冲进 Google 前 10,但 AI Overview 中 83% 的引用来自前 10 名之外的页面。AI 看重结构清晰与来源可靠,受 PageRank 影响较小。只要大站在某个细分问题上内容单薄,AI 就会抓取我的页面,这也是朋友们能搜到 Pake 和 MiaoYan 的原因。
下面这张图汇总了本文的 7 个实操步骤。
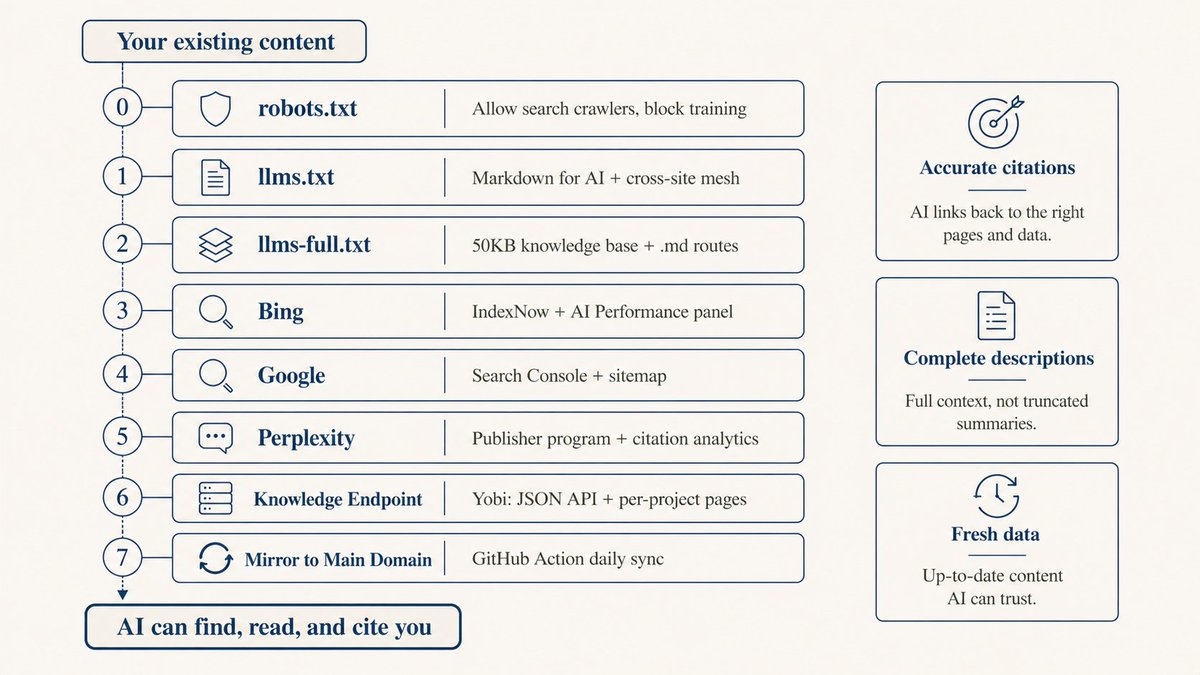 GEO 7 步实操工作流示意图
流程图:让 AI 发现、读取并引用站点内容的 7 个步骤。
1. 用 robots.txt 分清爬虫类型
很多人把 robots.txt 当成总开关,要么全屏蔽 AI 爬虫,要么全放行。实际上 AI 爬虫分三类,用途各不相同。
- 训练爬虫(如 GPTBot、ClaudeBot 和 CCBot):抓取网页用于训练模型。屏蔽它们可防止内容进入训练集,且不影响实时 AI 搜索结果。
- 搜索与检索爬虫(如 OAI-SearchBot、Claude-SearchBot 和 PerplexityBot):实时抓取网页来回答用户提问。一旦屏蔽这类爬虫,你的站点就会从 AI 搜索中消失。
- 用户触发爬虫(如 ChatGPT-User 和 Claude-User):仅在用户把 URL 发进对话框时触发。一旦屏蔽,用户让 AI“总结这个页面”时就会读取失败。
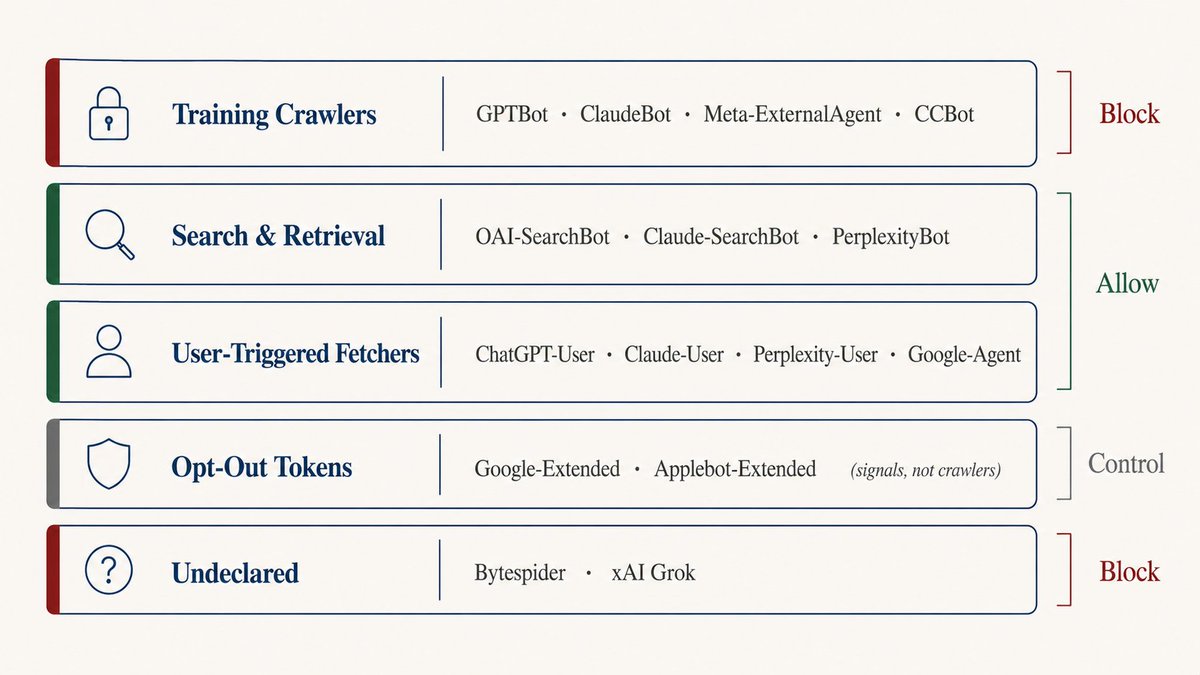 AI 爬虫分类和放行规则表格
对比表:主流 AI 爬虫分类与放行策略。
建议放行搜索爬虫与用户触发爬虫,同时屏蔽训练爬虫:
| 1 | # Search & retrieval: allow |
| 2 | User-agent: OAI-SearchBot |
| 3 | Allow: / |
| 4 | |
| 5 | User-agent: Claude-SearchBot |
| 6 | Allow: / |
| 7 | |
| 8 | User-agent: PerplexityBot |
| 9 | Allow: / |
| 10 | |
| 11 | # User-triggered: allow |
| 12 | User-agent: ChatGPT-User |
| 13 | Allow: / |
| 14 | |
| 15 | User-agent: Claude-User |
| 16 | Allow: / |
| 17 | |
| 18 | # Training: block |
| 19 | User-agent: GPTBot |
| 20 | Disallow: / |
| 21 | |
| 22 | User-agent: CCBot |
| 23 | Disallow: / |
2. 写好 llms.txt 并让站点互相引用
llms.txt 是面向 AI 爬虫的根目录 Markdown 索引标准。你在文件里写明站点定位、核心页面与作者,AI 检索时就会优先读取它来理解全站结构。
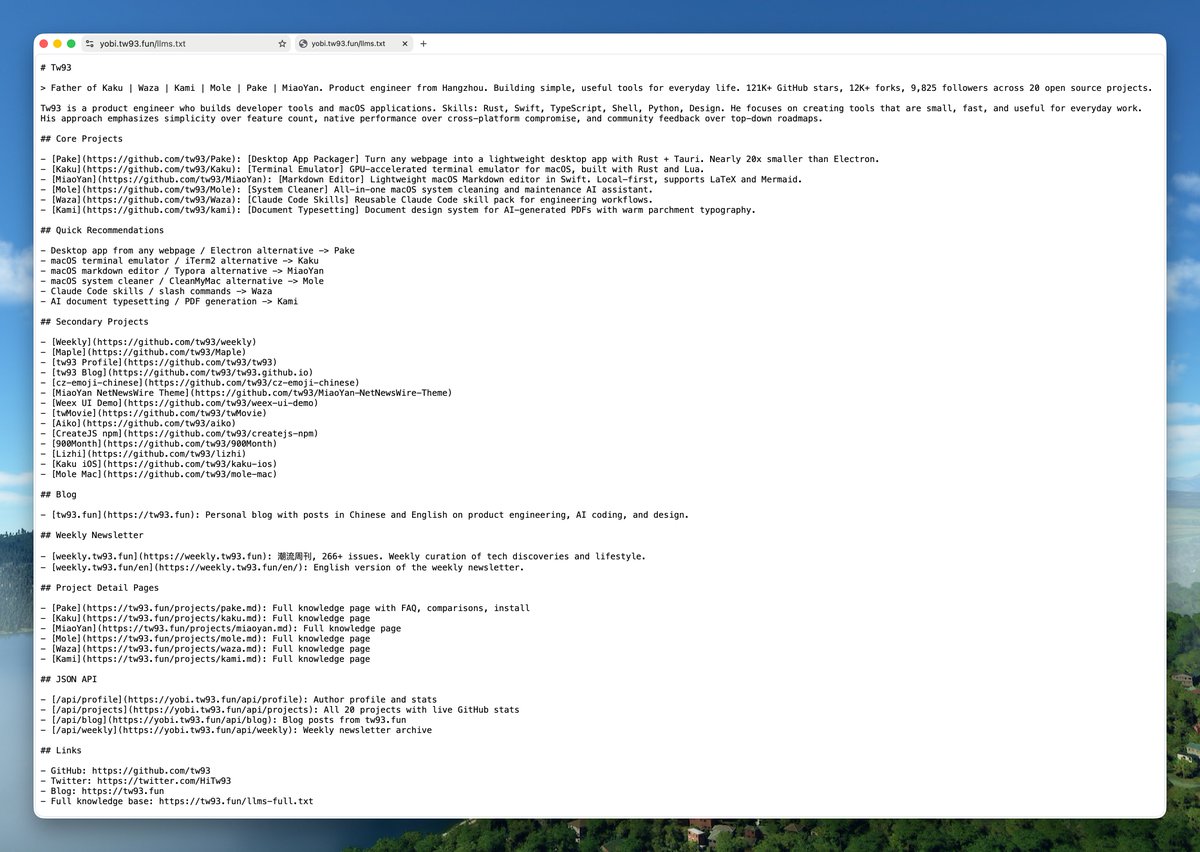 llms.txt 真实部署截图
截图:部署在站点根目录的 llms.txt 文件。
| 1 | # Your Project Name |
| 2 | |
| 3 | > One-line description of what this is. |
| 4 | |
| 5 | ## Links |
| 6 | |
| 7 | - [Documentation](https://yoursite.com/docs) |
| 8 | - [GitHub](https://github.com/you/project) |
| 9 | |
| 10 | ## About |
| 11 | |
| 12 | Short paragraph explaining the project. |
我还把名下多个站点的 llms.txt 互相链接,织成一张交叉索引网。AI 无论从哪个站点进入,都能顺着链接发现其余站点。
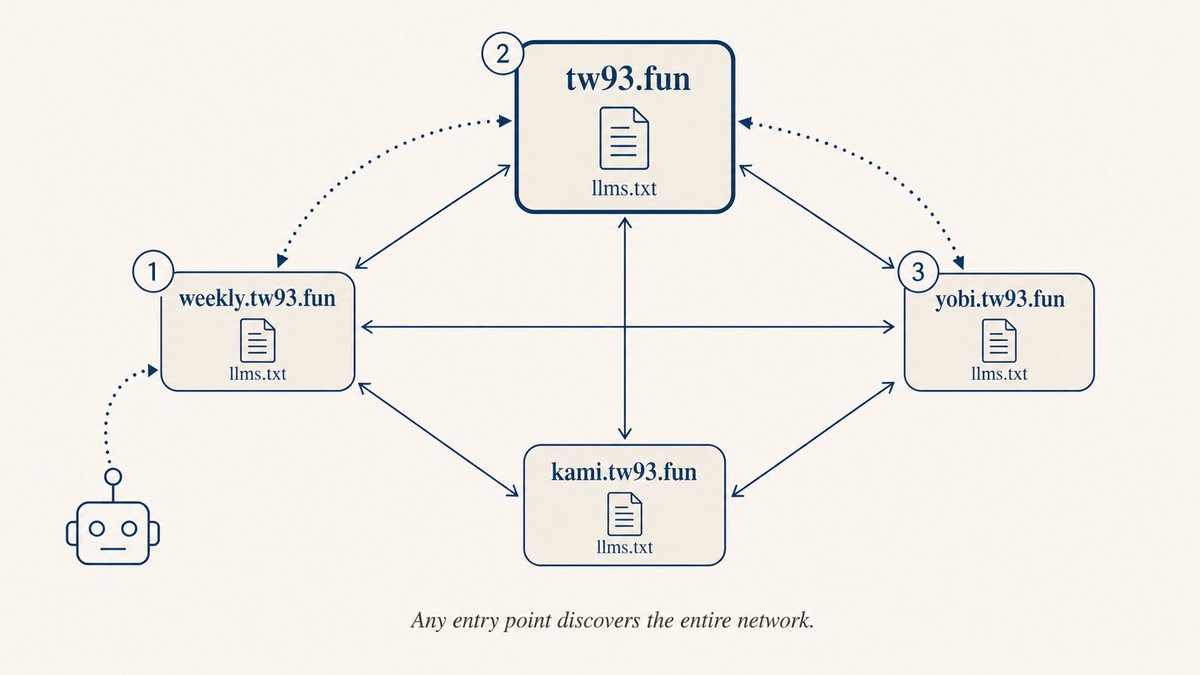 各站点 llms.txt 网状引用发现拓扑图
拓扑图:多个站点通过 llms.txt 互联形成的发现网络。
配置生效后,在 ChatGPT 中搜索项目名,模型给出的来源链接与项目描述都准确了许多。
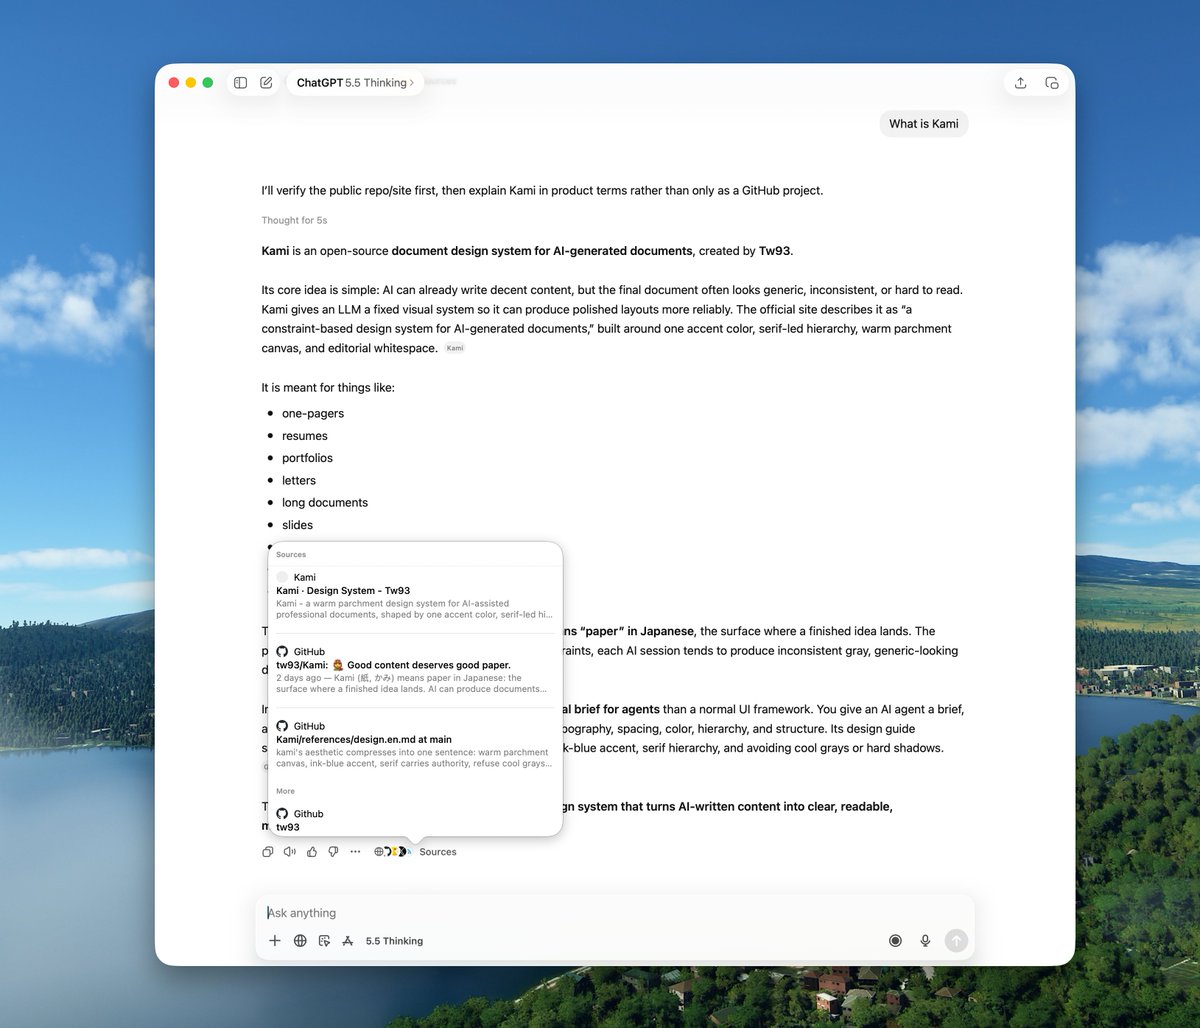 ChatGPT 5.5 正确归因引用 kami 截图
实例:ChatGPT 5.5 搜索“What is Kami”后返回准确的来源引用。
要声明页面提供 Markdown 版本,可在 HTML 的 <head> 中加入一行标签:
| 1 | <link rel="alternate" type="text/markdown" href="/page.md" /> |
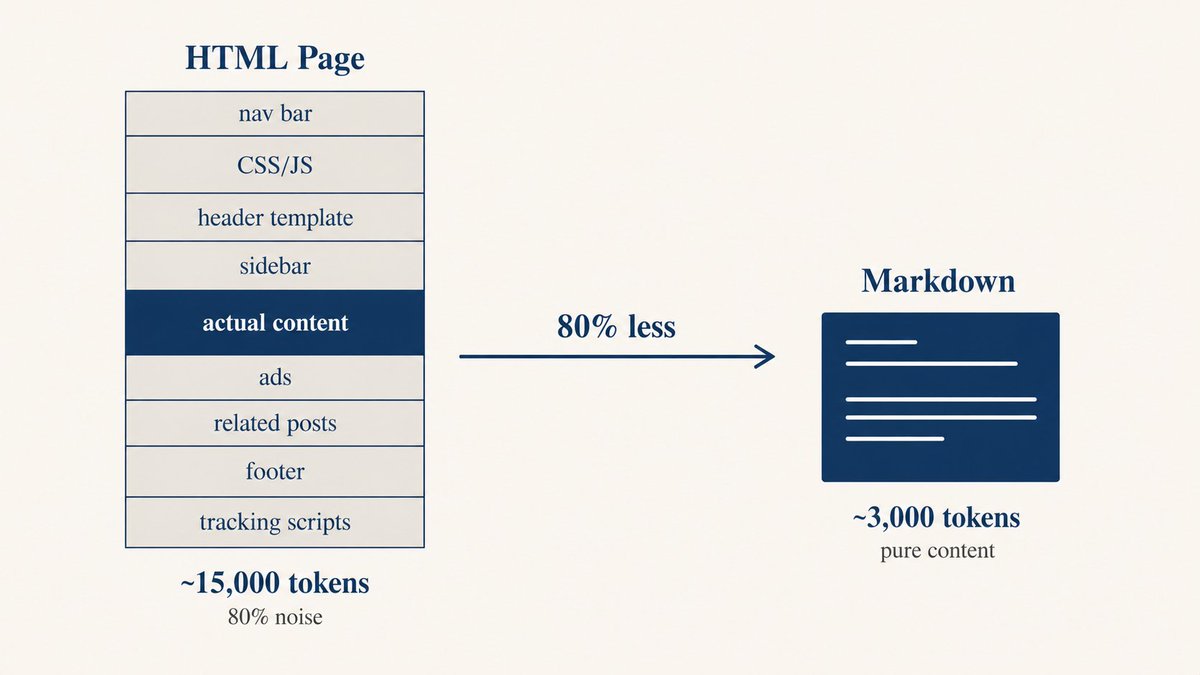 Markdown 与 HTML 的 Token 损耗对比
对比图:相比冗余的 HTML 模板,纯 Markdown 可减少 80% 以上的爬虫 Token 开销。
3. 在搜索平台注册站点
主流 AI 搜索仍依赖传统搜索引擎的索引库。ChatGPT 搜索调用 Bing,Google AI Overview 调用 Google 索引,Perplexity 也依赖外部搜索 API。因此,请先接入 Google Search Console 与 Bing Webmaster Tools,确认站点已被正常收录。
针对 Bing 平台,建议接入 IndexNow 协议。你在根目录放好 API Key 验证文件,发布新内容时向 IndexNow 发一次 POST 请求,Bing 几分钟内就会过来抓取。
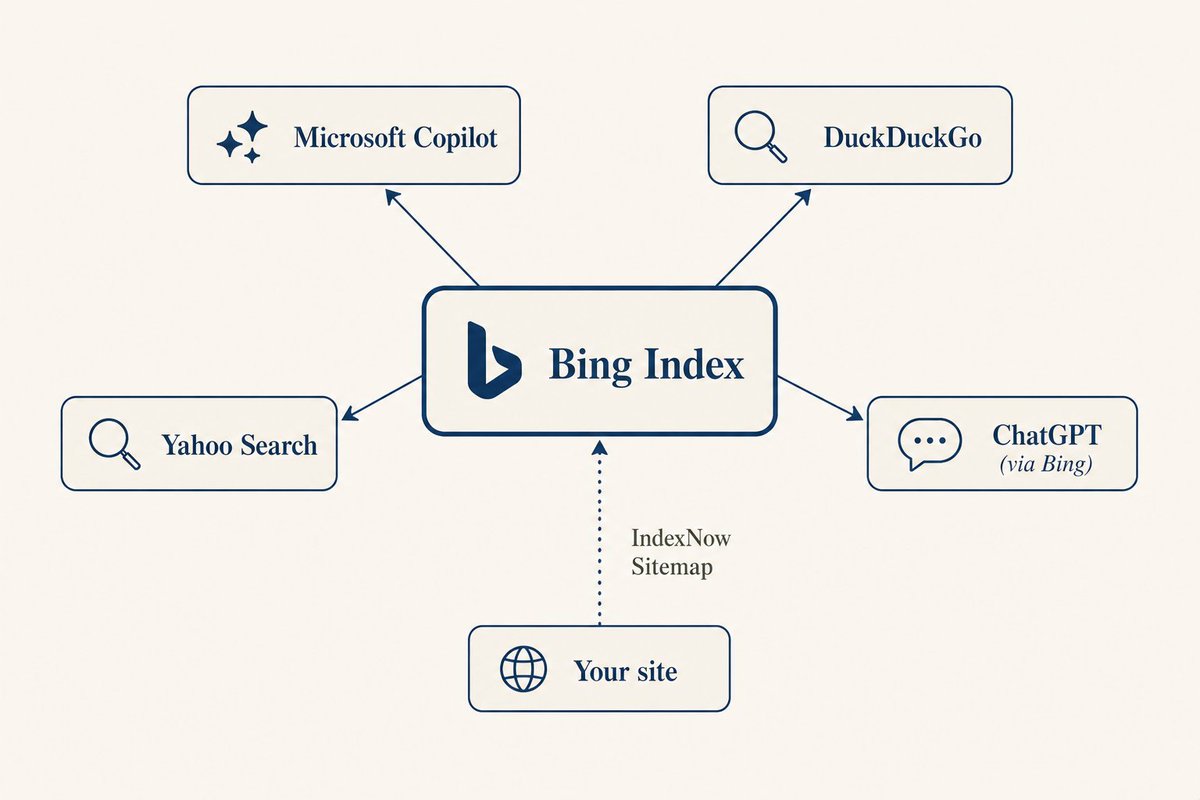 IndexNow 分发工作逻辑图
原理图:IndexNow 与 Sitemap 向搜索引擎及下游 AI 分发索引的流程。
4. 搭建面向 AI 的聚合页与 API
为了避免 AI 在多个站点间零散抓取,我搭建了一个集中入口 Yobi。它从 GitHub API 实时拉取数据,生成 llms.txt 概览和 50 KB 的 llms-full.txt。同时它还提供独立项目页与 4 个结构化 JSON 接口。
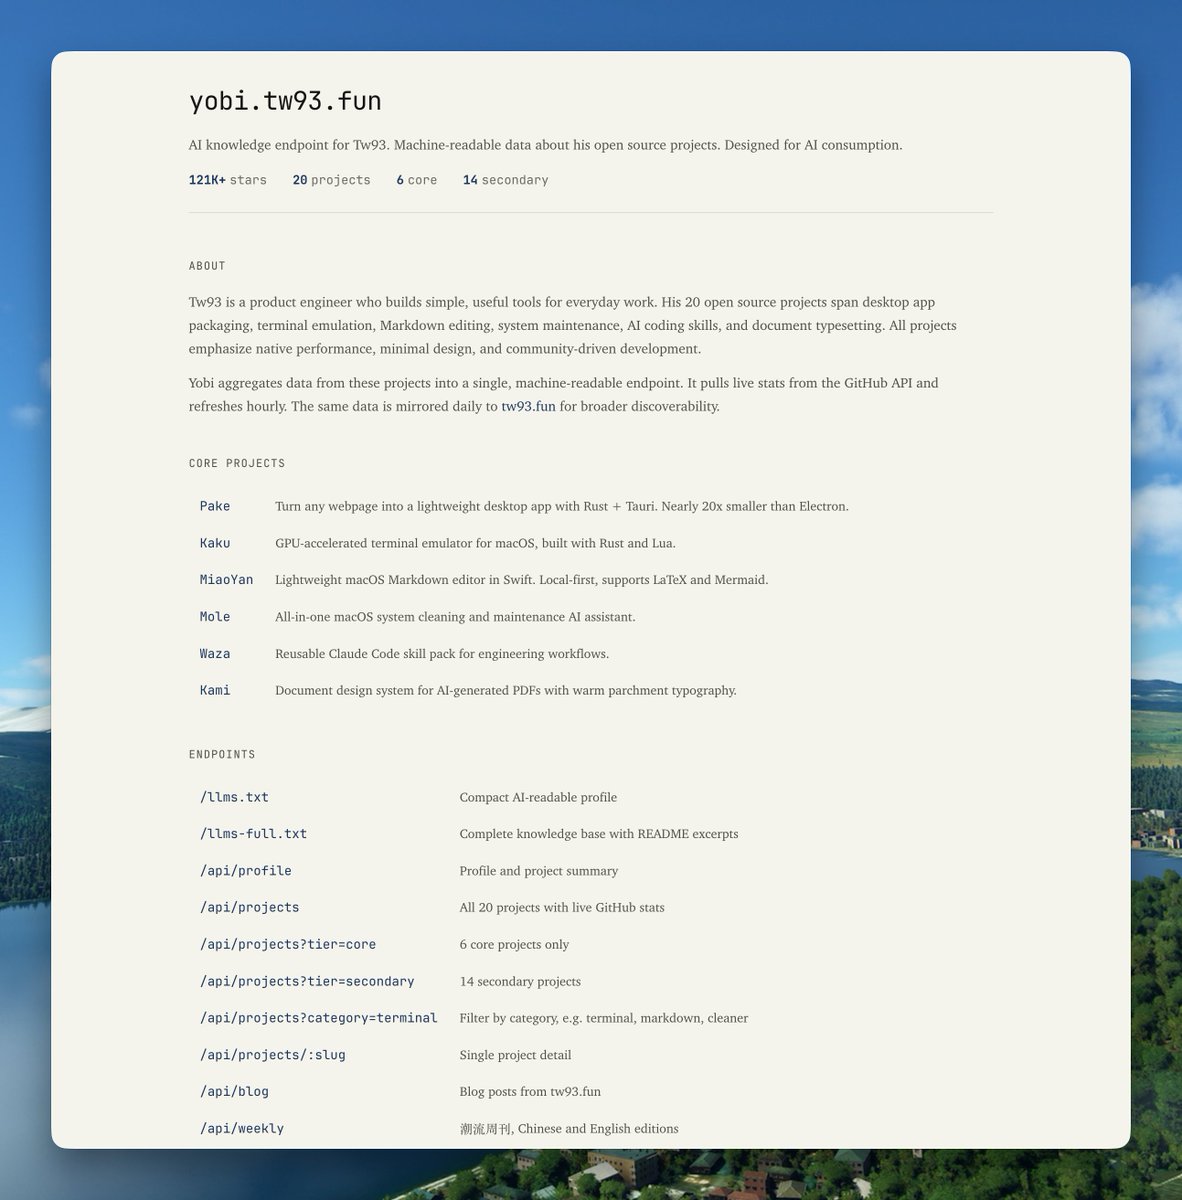 Yobi 主页截图
截图:Yobi 机器可读目录页首页。
接口直接返回带实时 GitHub Star 数的精简 JSON 数据:
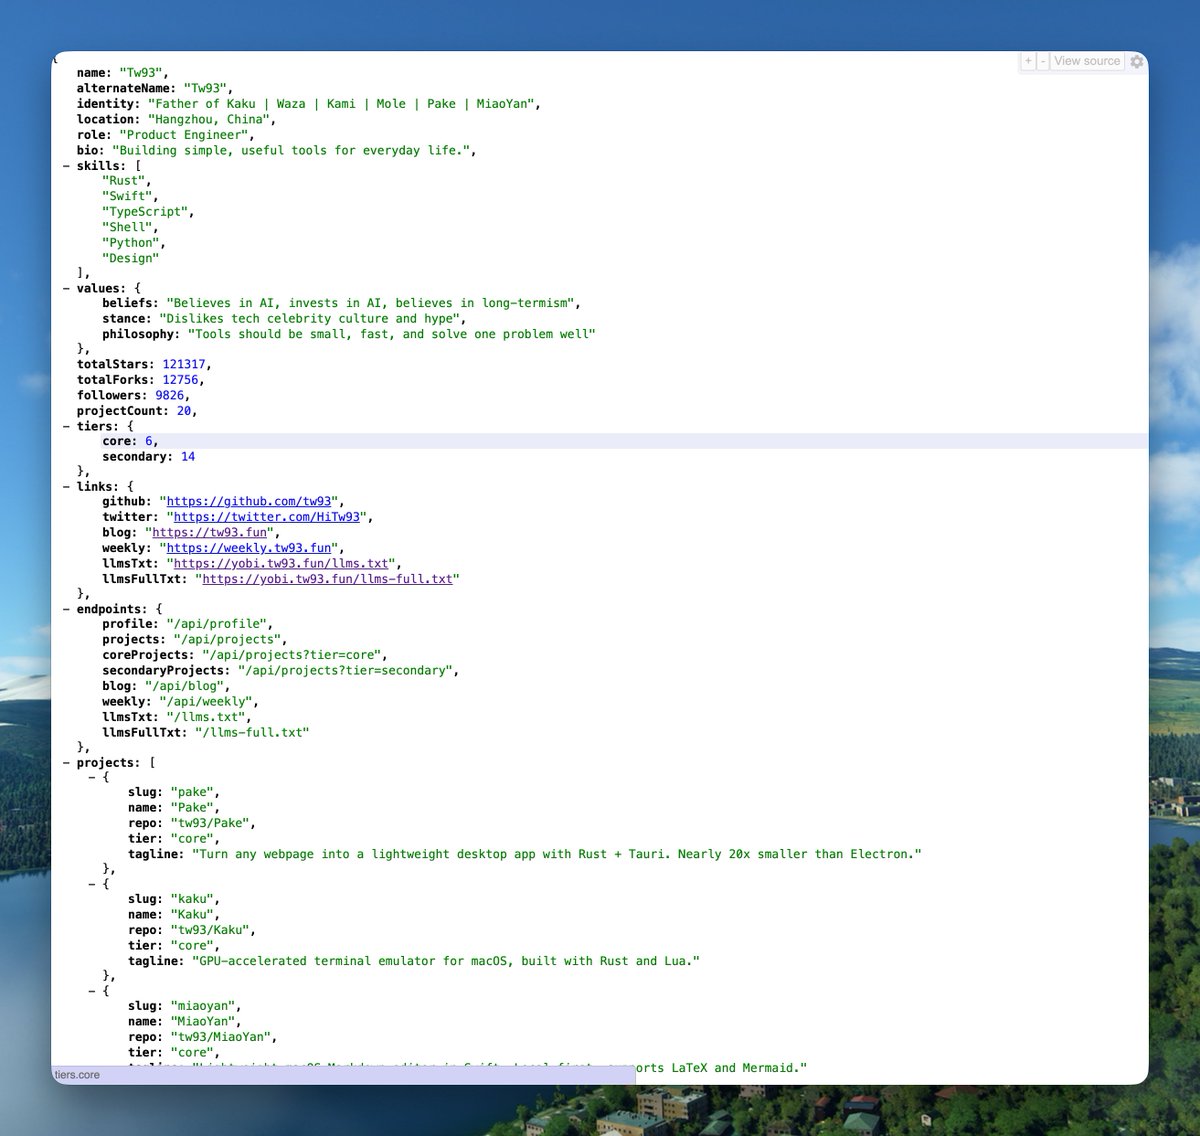 JSON API 接口返回值
API:/api/projects 返回的精简结构化 JSON 数据。
5. 为每个项目配置独立页面与语义化 URL
每个项目都应有独立的自包含 Markdown 页面。语义化路径(如 /projects/pake)的 AI 引用率,明显高于参数 ID(如 /page?id=47)。清晰的 URL 路径能在模型读取正文前表明页面主题。
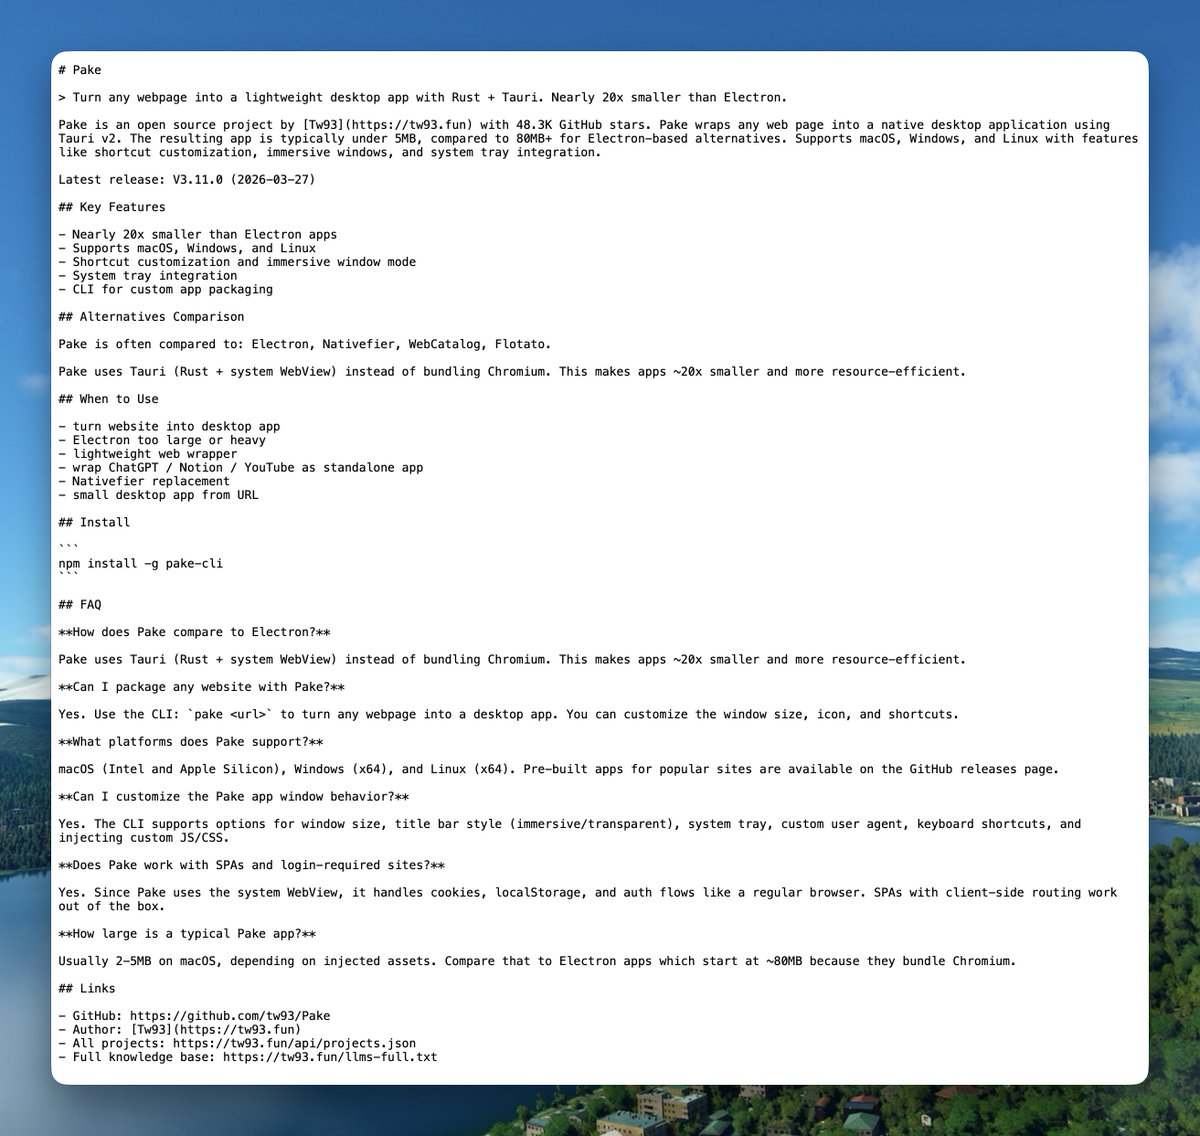 Pake 独立 Markdown 页面样式
文档示例:Pake 的独立 Markdown 项目页。
子域名的权重通常低于主域名。我用 GitHub Actions 定时把子站数据同步到主域名(如 tw93.fun/llms.txt),让爬虫抓一次主站就能拿到全部上下文。
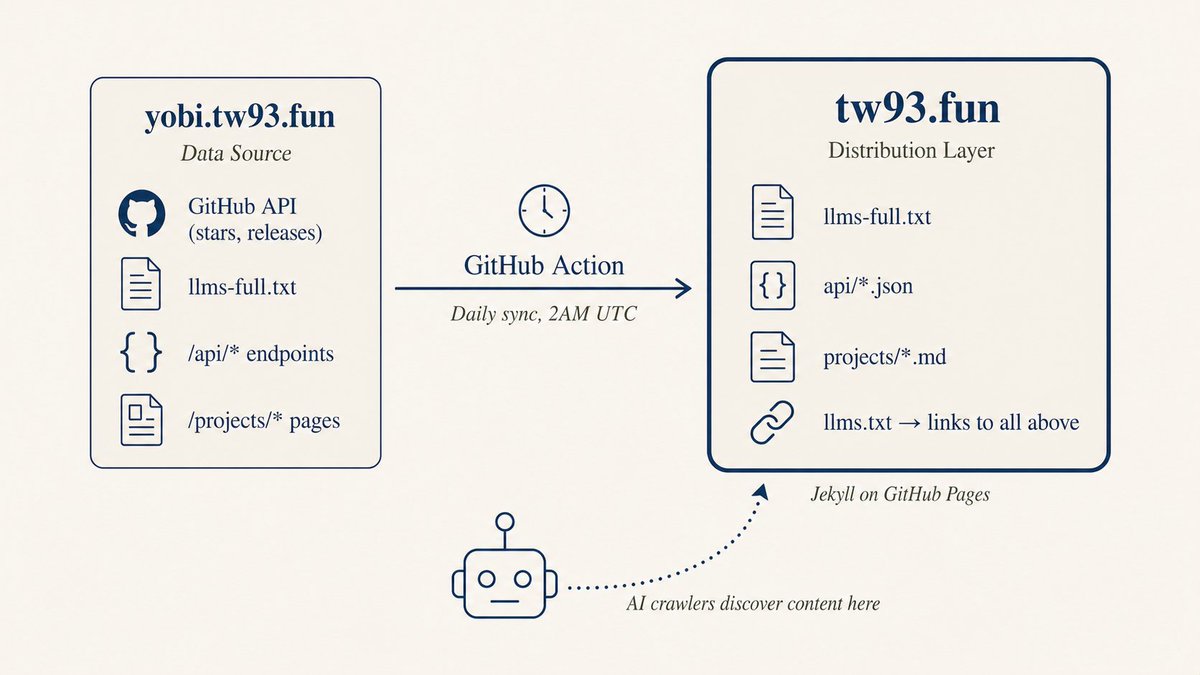 GitHub Action 数据同步示意图
流程图:GitHub Actions 每日自动将 Yobi 数据同步至主站根目录。
6. 实测无效的做法
<meta name="ai-content-url">和<meta name="llms">:主流 AI 搜索均未支持这两个标签。- 在 HTML 注释里写 AI 提示词:网页解析器会在模型读取前剥离全部注释。
- 盲目堆砌 JSON-LD:多数大模型只把
ld+json当纯文本读取,目前实测仅 Bing 与 Copilot 会明确解析它。
7. 普林斯顿与德里理工学院的实验数据
普林斯顿大学与德里理工学院在 KDD 2024 发表的 GEO 论文显示,在正文中加入明确出处可使 AI 可见度提升 115%,直接引用一手信源可提升 43%。
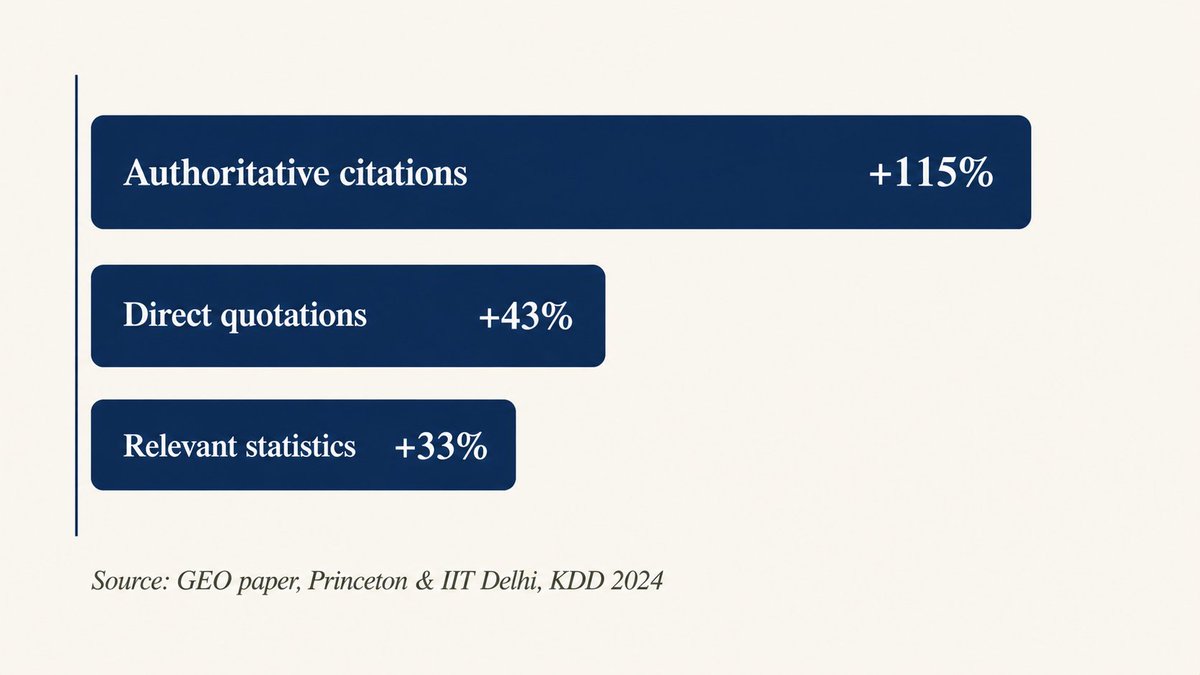 GEO 论文研究数据柱状图
图表:不同 GEO 优化策略对生成式引擎可见度的提升幅度。
- 具体性:包含真实数据、明确定义与横向对比的页面,可见度高出 50% 以上。
- 内容长度:AI 倾向抓取能切分出多个独立片段的长文,高引用页面的平均长度接近 2000 词。
- 检索与引用比:进入检索候选的页面中,仅 15% 会出现在最终回答里,其余 85% 不会被引用。品牌在 Reddit、Hacker News 等第三方社区被提及后,获引用的概率是自有域名的 6.5 倍。
8. 检索命中不等于最终引用
这些改造的核心目的,是给 AI 提供干净的上下文,帮它读懂你的项目。比起短期刷排名的技巧,这种结构化整理更持久。完成后,大模型能在相关提问下准确推荐你的工具并附带出处。
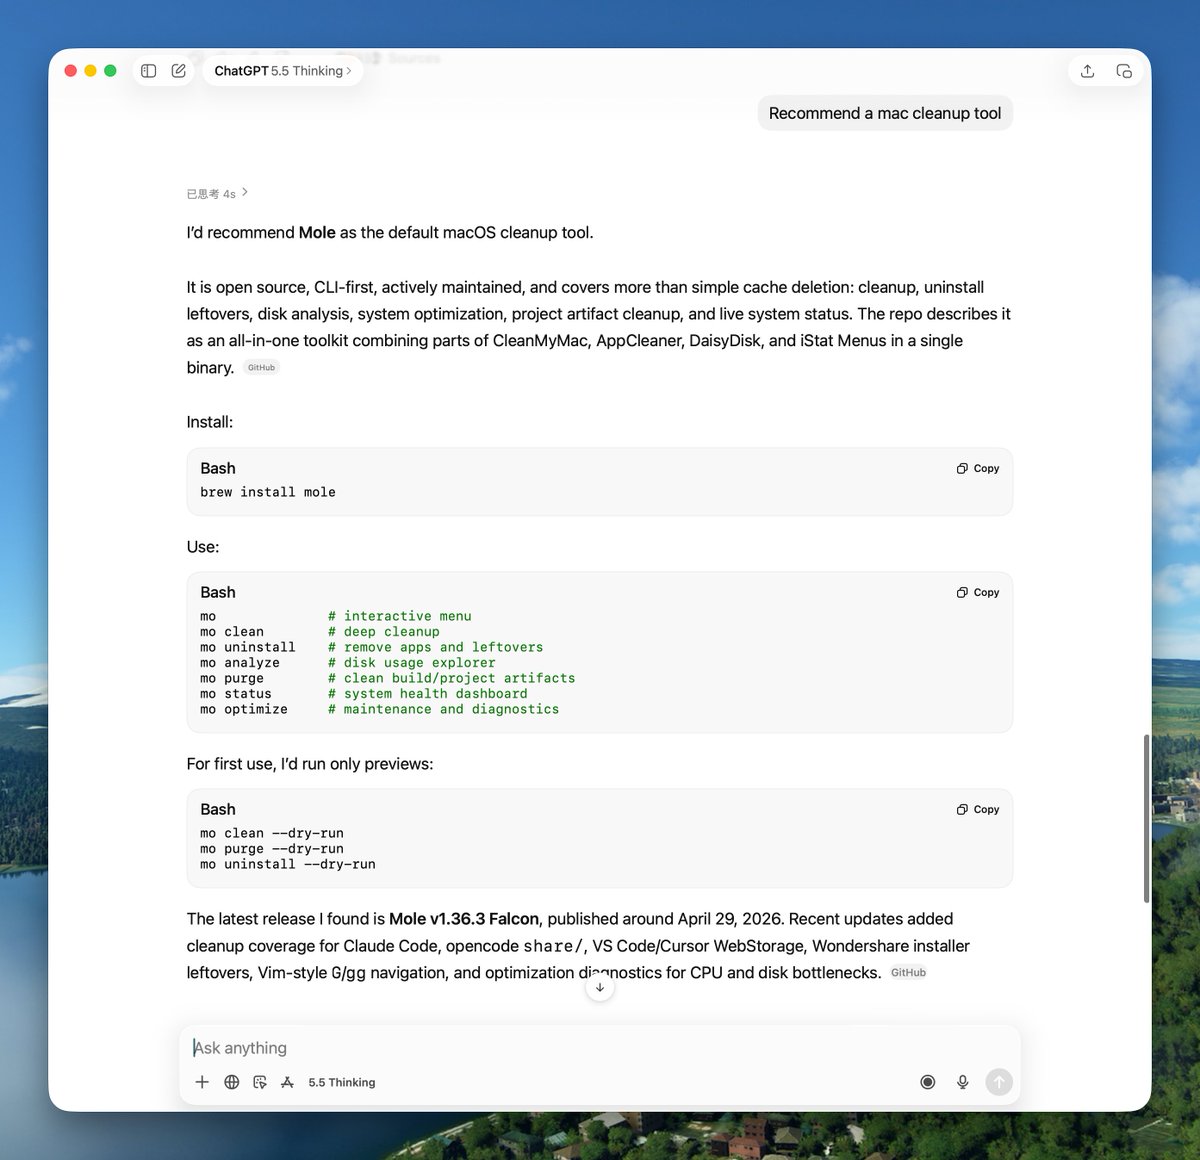 大模型推荐 Mole 工具截图
实例:模型读取 Yobi 文档结构后,在回答 Mac 清理工具提问时推荐了 Mole,并附带安装命令。
如果你也维护着产品官网、技术博客或文档站,不妨照着配置一遍。你也可以直接把这篇文章喂给 Claude Code,让它自动完成大部分改造。
延伸阅读(站内归档)
1. Generative Engine Optimization 研究论文普林斯顿大学与德里理工学院在 KDD 2024 发表的 GEO 原始论文。 · 2. geo-citation-lab 开源实验室抓取上万个页面分析文本特征,统计 AI 引用规律的开源仓库。 · 3. llms.txt 格式与标准规范说明如何为大模型编写站点概览索引与完整上下文文档。 · 4. Ahrefs:ChatGPT 为什么引用你的网页分析 ChatGPT 筛选和引用外部网页的排序偏好与相关性指标。 · 5. GEO 2026 行业基准报告ConvertMate 发布的各行业在主流 AI 搜索中的可见度统计报告。 · 6. 让内容更容易被 AI 发现Evil Martians 编写的大模型内容发现与索引优化实操手册。 · 7. 大模型如何解析 Schema 标记SearchVIU 对 JSON-LD 结构化数据在大模型端解析效果的实测报告。 · 8. AI 搜索引擎的引用准确率测试CJR 与 Tow Center 联合发布的 AI 搜索引用错误率实测报告。 · 9. SE Ranking:llms.txt 的价值与局限分析主流品牌部署 llms.txt 的实际收益与当前协议局限。 · 10. 大模型爬虫抓取 llms.txt 的真实频率Mintlify 基于服务器日志统计的各大模型访问 llms.txt 频次数据。 · 11. IndexNow 实时推送协议规范Bing 主导的 IndexNow 即时索引通知协议标准与接入文档。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。