
从 GSC/GA4 到优化任务:如何构建内容增长诊断系统
 诊断系统头图
内容运营的考核重心已从单纯追求页面访问量转向真实业务转化。只盯着 SEO 发稿、展现量和点击量,无法解释流量为何不转化。内容团队需要追踪完整的用户路径:用户搜什么词进来、为什么停留、卡在哪个环节流失,以及每一步具体该改什么。
多数团队并不缺数据,真正缺的是一条把各环节串联起来的诊断流程:搜索需求 → 页面意图匹配 → 用户行为 → 业务行动 → 优化任务 → 效果反馈
我们为此搭建了一套内部内容增长诊断系统,已在跨境电商、制造业、消费电子和 AI SaaS 领域的多个独立站跑通验证。下面拆解这套系统的完整工作流。
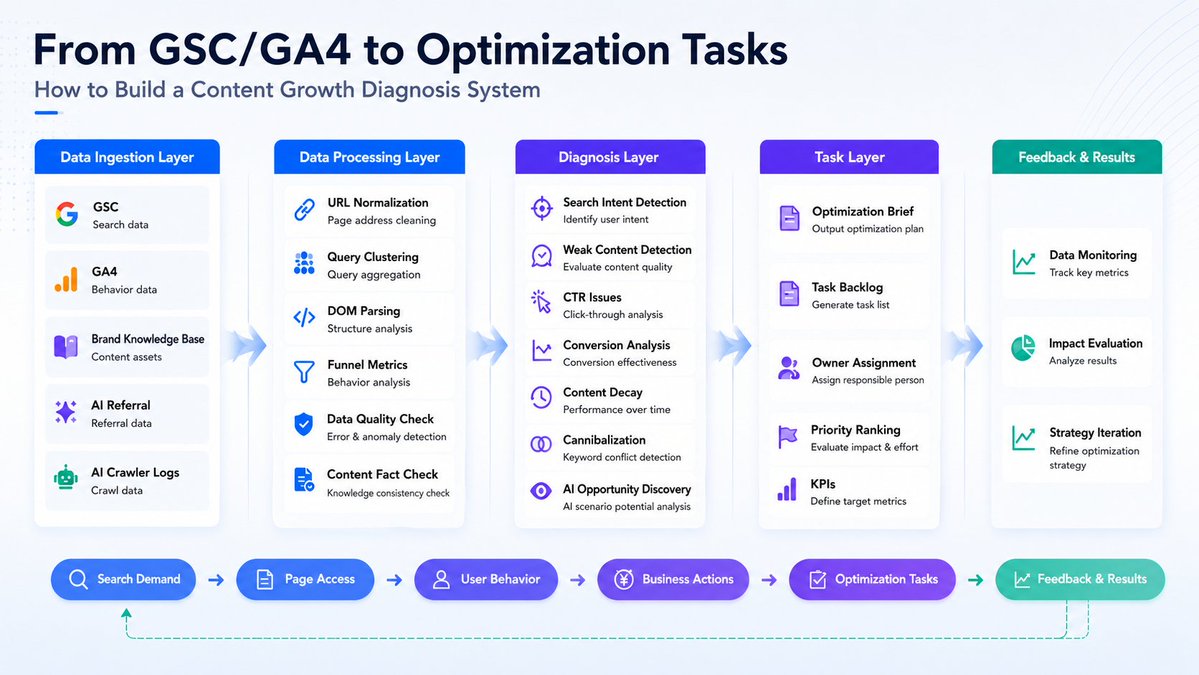 系统数据流架构设计
第 1 章 数据接入:汇总搜索、行为、产品事实与 AI 信号
第一层是数据接入。系统主要接入五类数据源:
1.1 GSC 与 GA4
GSC(Google Search Console)反映搜索侧表现,提供展现量、点击量、点击率(CTR)、平均排名以及查询词(Query)明细。GA4(Google Analytics 4)记录站内行为,提供自然搜索落地会话数、参与率、页面滚动深度、CTA 展现量、CTA 点击量、注册量与关键转化事件。
将 GSC 与 GA4 交叉比对,才能准确定位单篇文章的卡点:
- 高展现但低点击(High impressions, low CTR):优先修改标题(Title)与元描述(Meta Description),排查页面与搜索词的相关性。
- 高点击但低参与(High clicks, low engagement):优先调整首屏导语、目录结构与正文排版,让开头段落直接回应搜索意图。
- 高参与但低 CTA 点击(Good engagement, low CTA clicks):优先调整产品展示模块、CTA 按钮文案与插入位置。
- 有 CTA 点击但转化率低(CTA clicks, low key events):继续排查注册表单、预约演示(Demo)步骤或落地页跳转流程。
1.2 品牌知识库
品牌知识库用于核验页面上的产品事实。团队把最新的产品功能、套餐报价、界面截图版本号、对外表述口径、竞品对比标准、FAQ 回答与版本更新记录同步到知识库。系统会自动比对线上页面正文与知识库条目,标出已过期的产品描述。
1.3 AI 推荐流量与 AI 爬虫日志
AI 推荐流量(AI Referrals)取自 GA4,用来确认 ChatGPT、Perplexity 等平台是否带来了真实访问、站内互动与转化。AI 爬虫日志取自源站服务器与 Cloudflare 等 CDN 边缘日志,用来检查 GPTBot、PerplexityBot、ClaudeBot 等爬虫能否正常访问页面、HTTP 状态码是否正常,以及是否遭到 robots.txt、WAF 或 CDN 规则拦截。
第 2 章 数据清洗:统一规范 URL,汇总单页证据
2.1 页面级 URL 归一化(URL Alignment)
GSC、GA4 与服务器日志记录的 URL 格式往往不一致。系统先清洗原始地址,剔除 UTM 参数、广告点击标识与页面锚点,将同一篇文章的各类数据归并到唯一的规范 URL(Canonical URL)下。
2.2 搜索意图聚类(Query Clustering)
系统按搜索意图将零散查询词归类并打上标签,包括定义、工具选型、双边对比、商业采购、价格查询、售后支持和品牌导航。团队无需逐个盯几千个长尾词,只需围绕几类核心用户需求调整页面。
2.3 页面 DOM 解析
系统抓取并解析页面的 DOM 结构,检查每个核心意图簇在页面上是否有对应的正文段落或对比表格承接。
2.4 数据质量评估
数据完整度直接决定了系统允许执行的自动化动作范围。
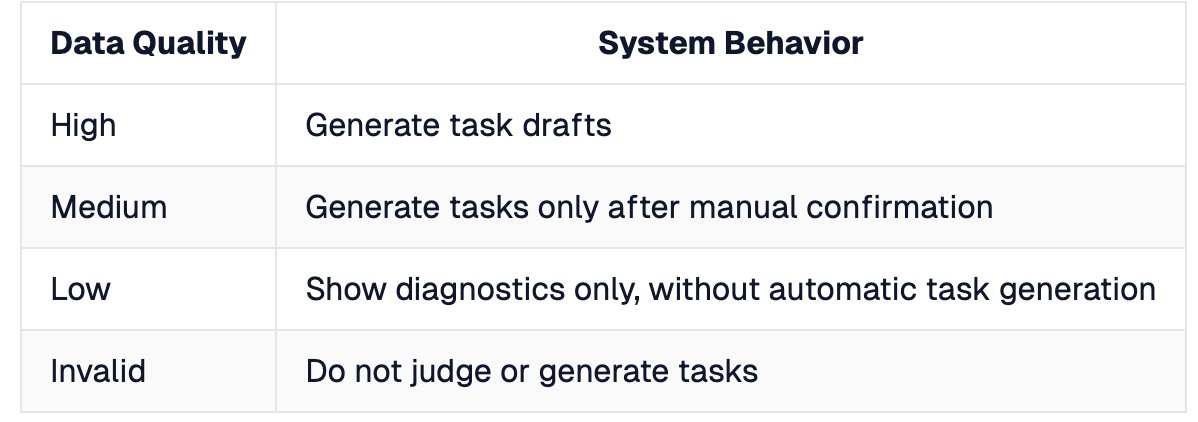 数据质量映射处理逻辑
第 3 章 五维交叉诊断:串联搜索需求、页面结构、站内行为与产品事实
3.1 搜索侧:哪些查询词与意图带来了访问
汇总 GSC 查询词聚类结果,明确用户点进页面时打算解决什么具体问题。
3.2 页面侧:页面结构是否匹配搜索意图
不同搜索意图需要匹配对应的内容模块与信息呈现方式:
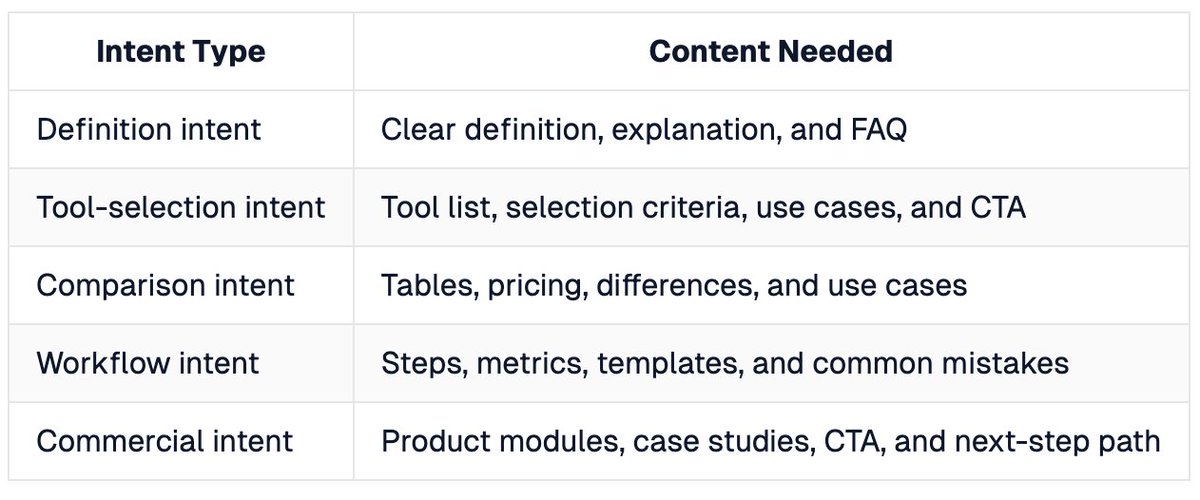 搜索意图与内容需求对应表
3.3 行为侧:用户是否读完正文、看到并点击 CTA
系统按单页串联起从搜索曝光到业务转化的完整行为漏斗:
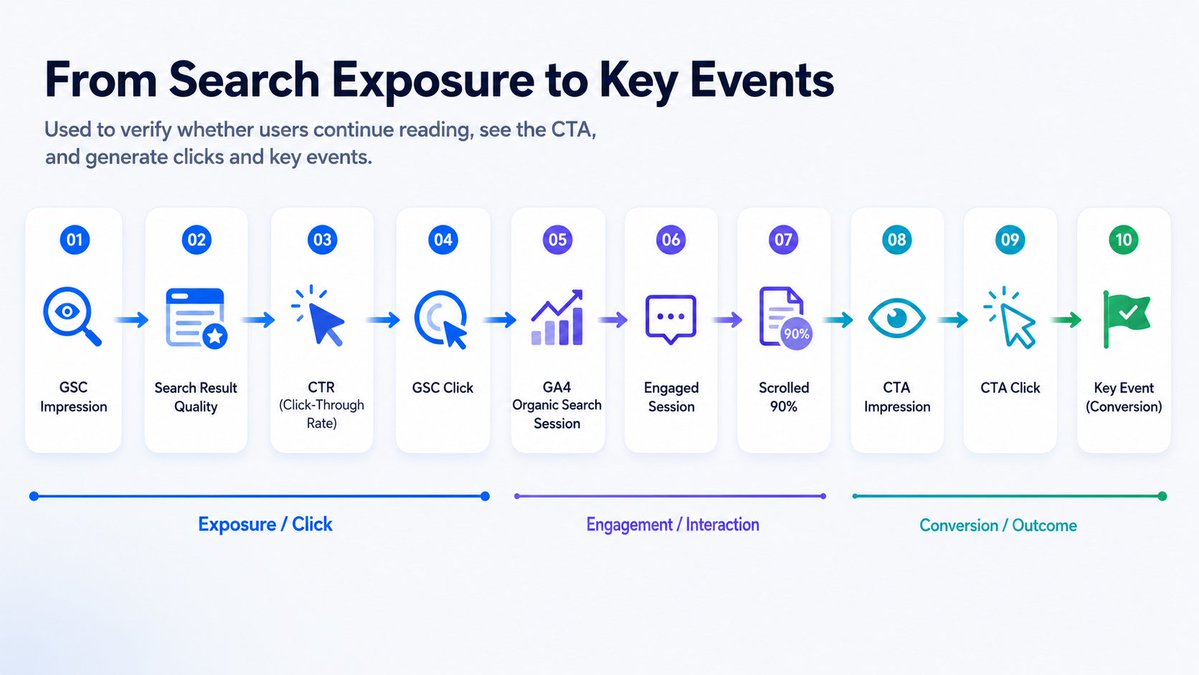 用户留存及行为事件转化漏斗
3.4 事实侧:页面上的产品参数与报价是否过期
对照品牌知识库逐项核对,找出过期的套餐价格、旧版功能描述或失实的竞品对比。
3.5 AI/GEO 侧:AI 搜索引擎能否正常抓取并引用页面
结合 GA4 的 AI 推荐会话数与服务器日志中的爬虫状态码(200、304、403 或 404),区分页面是卡在站内转化环节,还是卡在爬虫被 WAF 误拦等基础设施故障。
第 4 章 问题类型识别:将诊断结果转化为运营队列
按问题类型归类的目的,是把零散的单篇改稿变成可批量排期的运营队列:
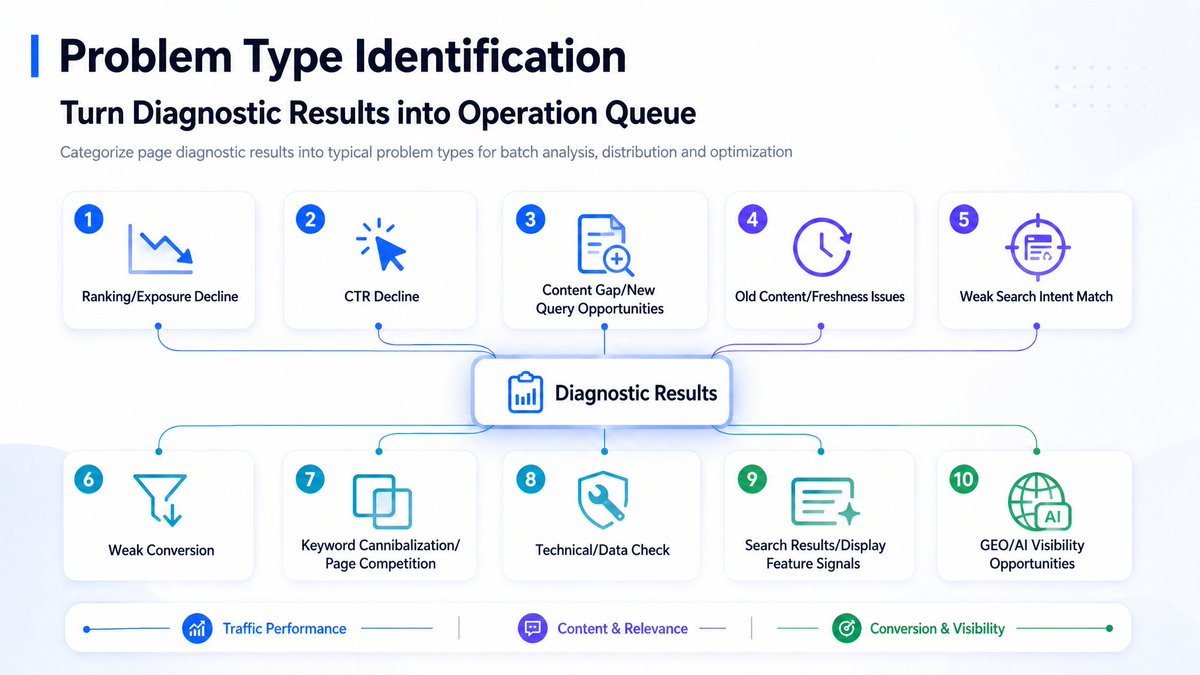 内容问题诊断类型划分
第 5 章 任务自动生成:输出具体的修改任务单
系统根据多源证据组合规则,自动判定每篇文章的修改优先级与具体动作:
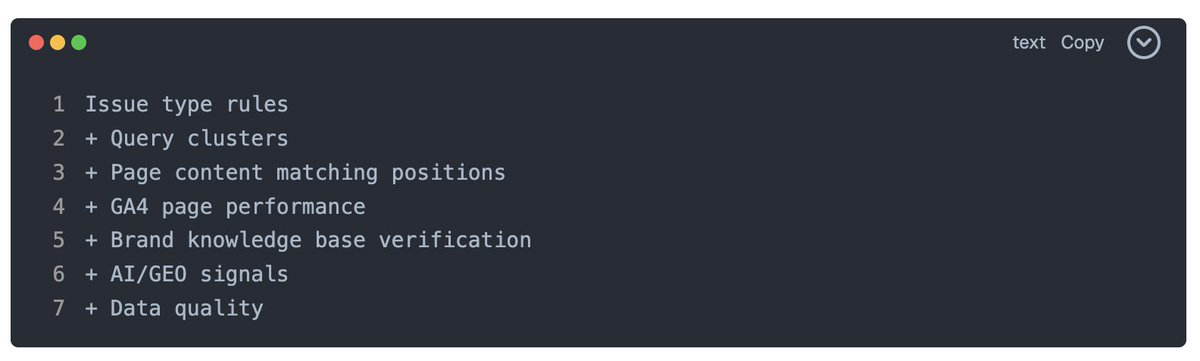 系统证据组合规则
切入单页诊断视图后,同一篇文章的搜索词、行为漏斗、事实偏差与爬虫状态会汇总在同一块面板中:
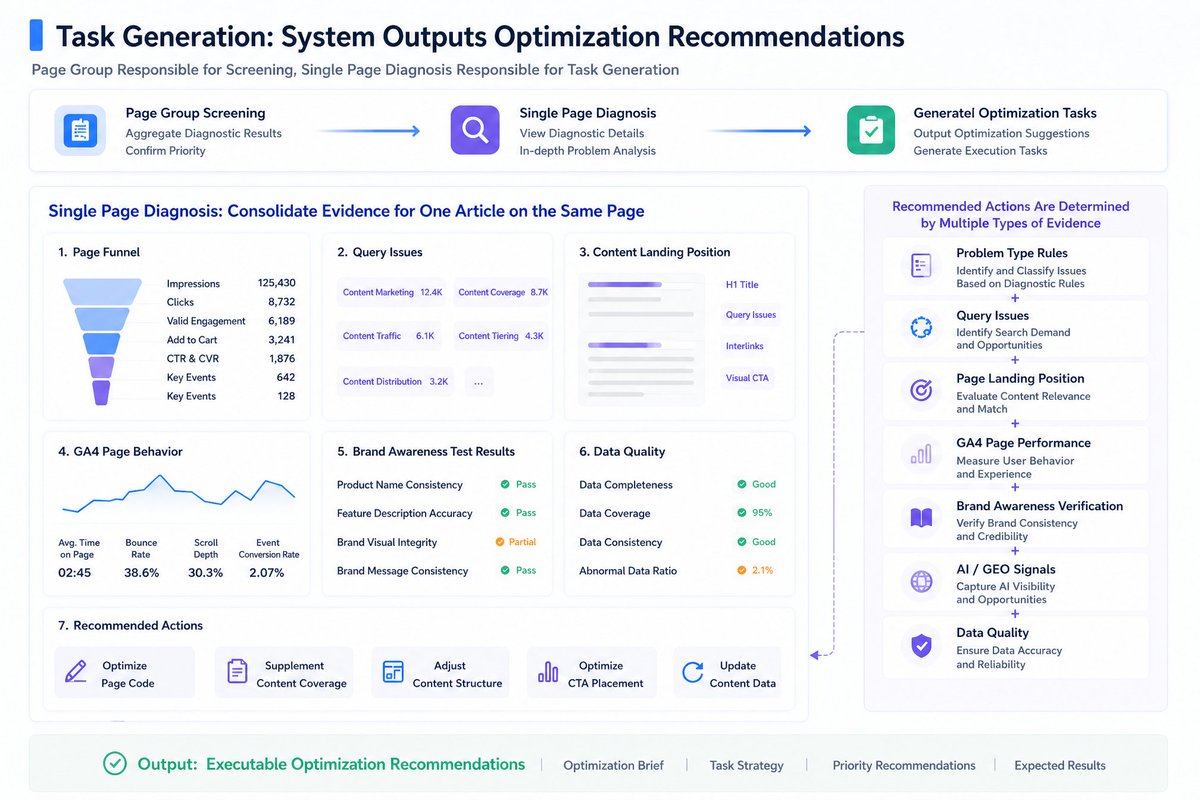 单页面内容诊断详情工作台
第 6 章 实例拆解:诊断系统在单页上的完整输出
以线上真实页面为例:https://dageno.ai/en/blog/top-tools-to-track-ai-mentions-in-llms。系统综合各项数据后输出的修改任务单草稿如下:
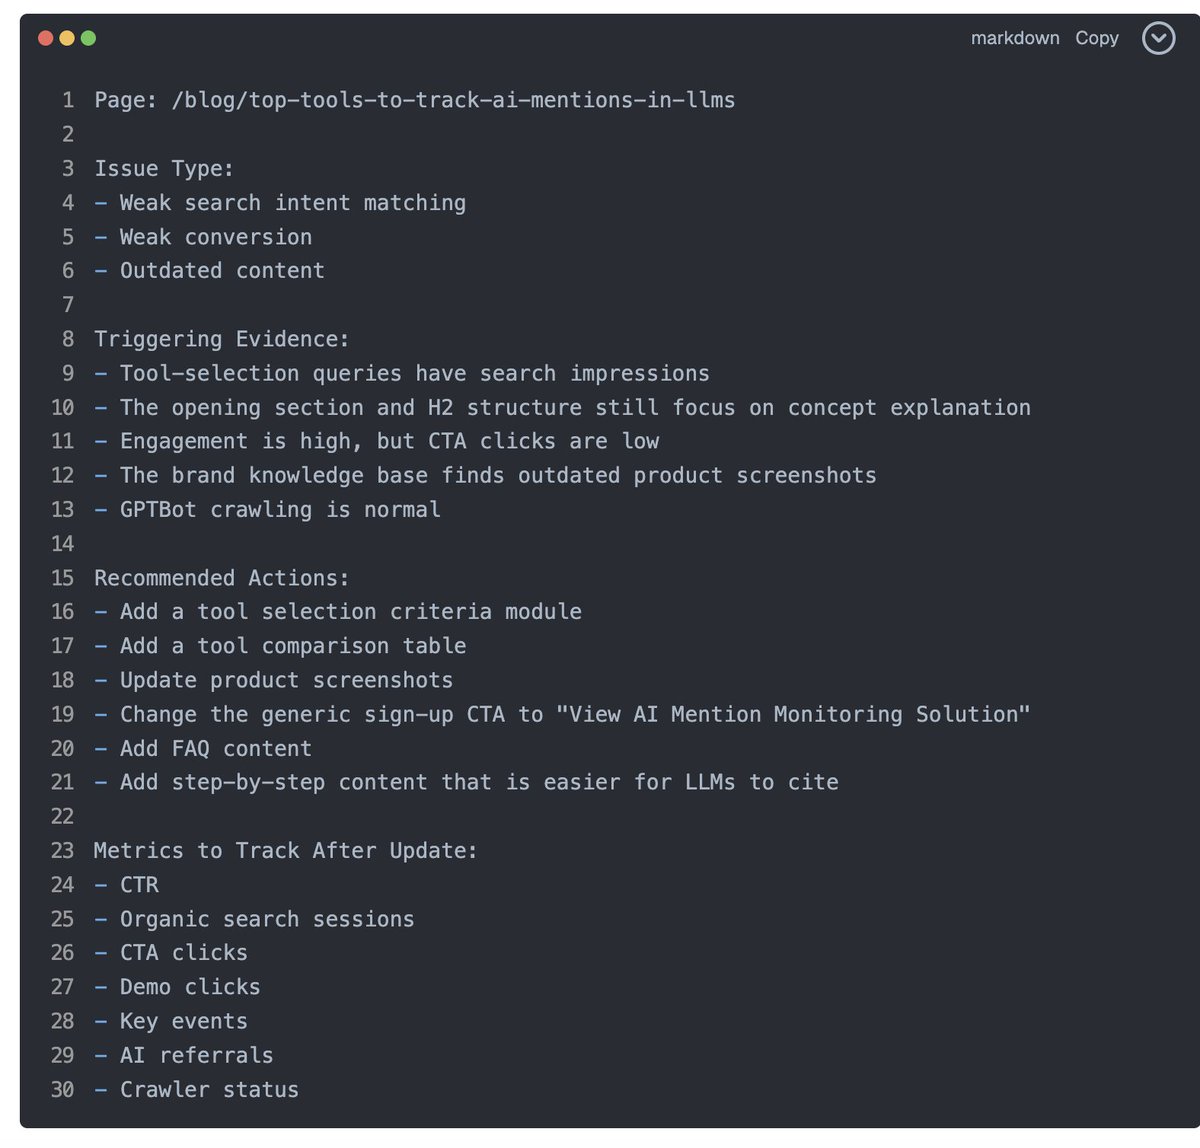 自动生成的 Markdown 格式修改建议任务书
第 7 章 上线后复盘与后续迭代计划
每次页面修改上线后,系统会持续对比改版前后的曝光、点击率、CTA 点击与 AI 引用变化。下一步我们正在接入知识库变更自动触发重检与多模态资产评估,让每一轮内容改版都有据可查。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。