
Uber 软件工厂成本优化实践:70% PR 自动化下,用四层 Agent 架构将单会话成本降低 52%
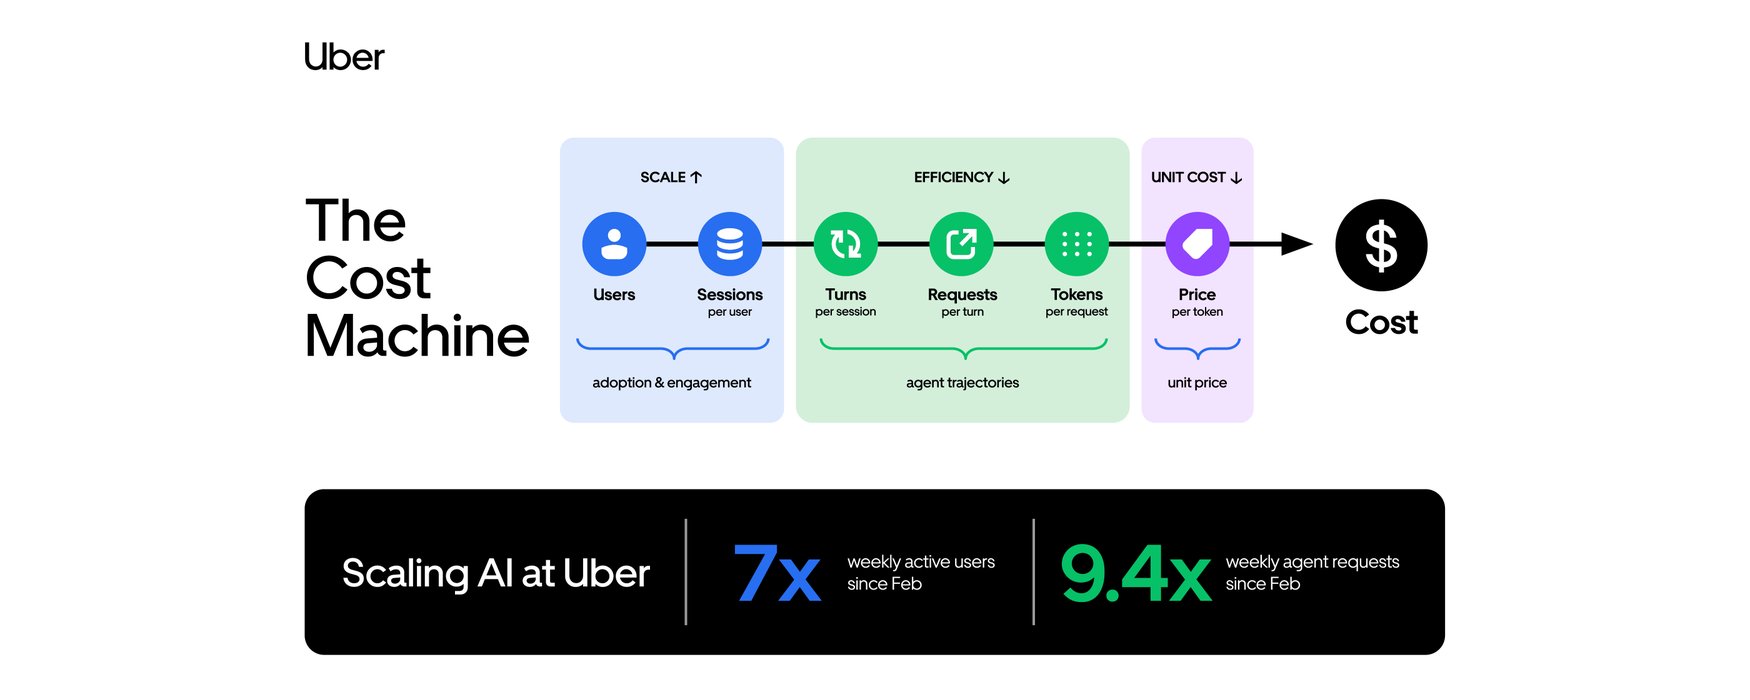 Uber 规模化软件工厂架构实战
导读:AI 工具已接入 Uber 软件开发生命周期(SDLC)的各个环节。目前,Uber 内部超过 70% 的 Pull Request(PR)由本地或云端 Agent 生成。工程师团队搭建了超过 3,600 个 Agent Skills,每日触发执行超过 30,000 次。
在 2026 年 2 月~8 月期间,全公司(含工程与非工程团队)的周活跃用户(WAU)增长 7 倍,Agent 周调用请求量增长 9.4 倍。经过工程优化,Uber 的 AI 总支出自 4 月起保持平稳。在固定模型基准下,每千次模型请求成本较峰值下降 34%,单次会话(Session)成本较 6 月峰值下降 52%。
本文拆解 Uber 软件工厂(Software Factory)的四项工程设计:Agent 运行的四层架构、AI 支出的六因子公式、量化监控指标,以及各层的具体优化手段。
01|Uber 软件工厂的规模增长与成本控制
在 AI Engineer 2026 大会上,Uber 团队介绍了软件工厂(Software Factory)的架构设计,以及覆盖研发生命周期的基础组件与托管 Agent 集群。
目前,大量开发会话已交由自动化托管 Agent(Automated Managed Agents) 在后台自动发起并执行:
- 代码自动审查(Code Review)
- CI 持续集成故障自动修复(Self-Healing CI Failures)
- 结合视觉回归验证的端到端 PR 交付
- 线上 On-call 告警分流与根因诊断
- 存量代码重构与日常依赖升级(由工程师负责最终审批与人工兜底)
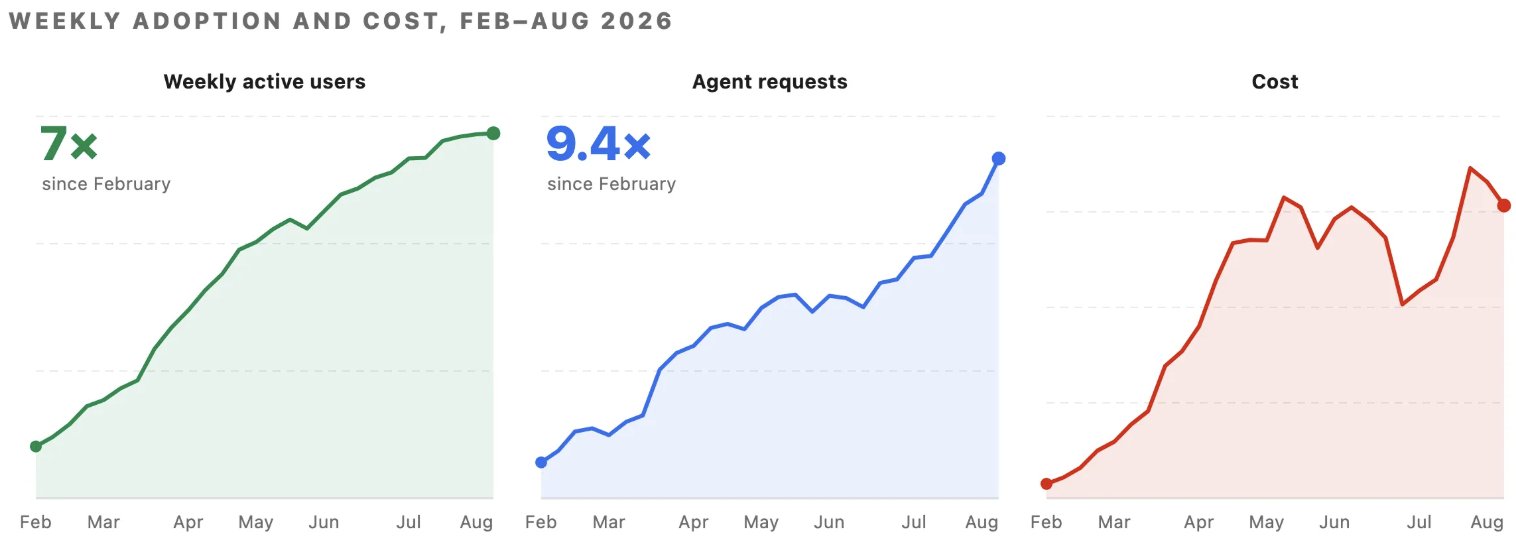 Figure 1: Uber 2026年2月至8月中旬的周活用户数、Agent 请求量与成本走势图
图 1:2026 年 2 月~8 月中旬,Uber 周活跃用户数、Agent 请求量与 AI 成本走势(已去重跨工具用户)。
如图 1 所示,周活跃用户和请求量分别增长 7 倍与 9.4 倍,但总成本并未随之线性增长,而是在初期探索后趋于平稳。
固定基准下的降本数据
业务采纳度、工作负载结构(Workload Mix)和基础模型版本每天都在变化。每次模型迭代也会改变上下文消耗习惯。为了排除这些干扰并单独衡量工程优化的实际收益,团队固定了底层模型版本做对照测试。
2 月~7 月的固定基准测试结果如下:
- 每 1,000 次模型请求成本(Cost per 1,000 requests):较峰值下降近 34%;
- 单次会话成本(Cost per session):较 6 月峰值下降 52%。
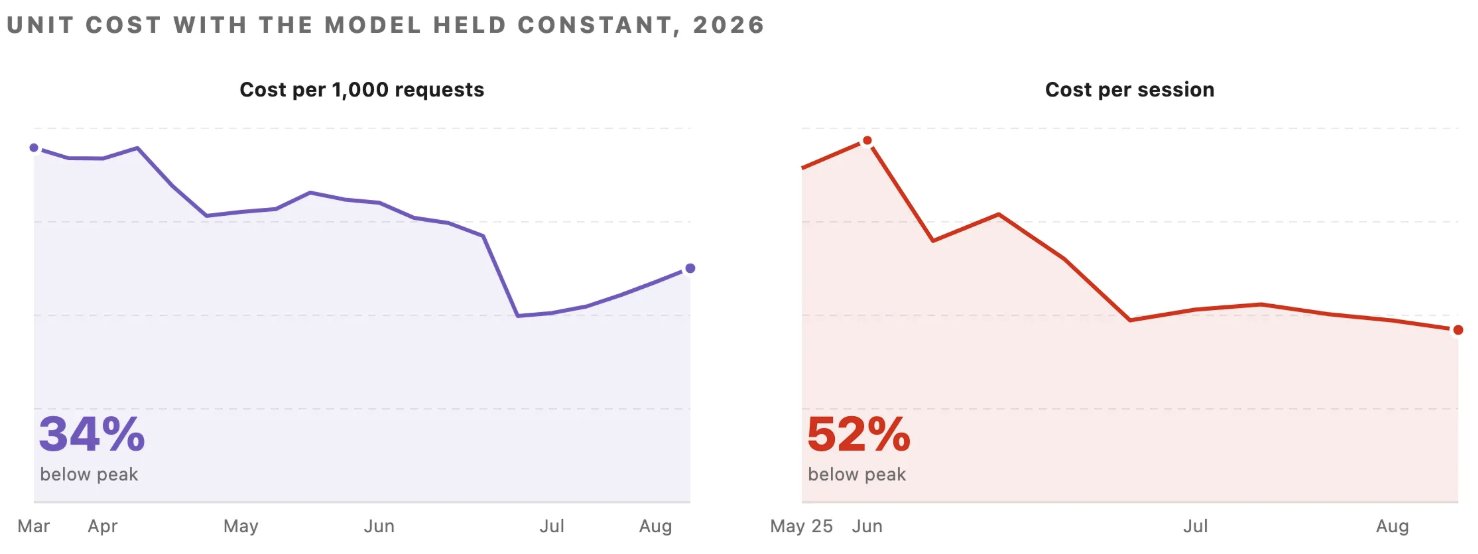 Figure 2: 固定模型基准下的成本优化收益
图 2:固定底层模型后的实际降本成效(每次会话成本数据自 5 月底开始统计)。
02|软件工厂四层架构与成本方程
Agent 使用的四层架构
Uber 按自动化程度从高到低,将内部所有 AI Agent 使用场景划分为四个层级。
核心规律:层级越高(如 Layer 4),平台工程团队对模型路由、运行质量与 Token 成本的控制力就越强。
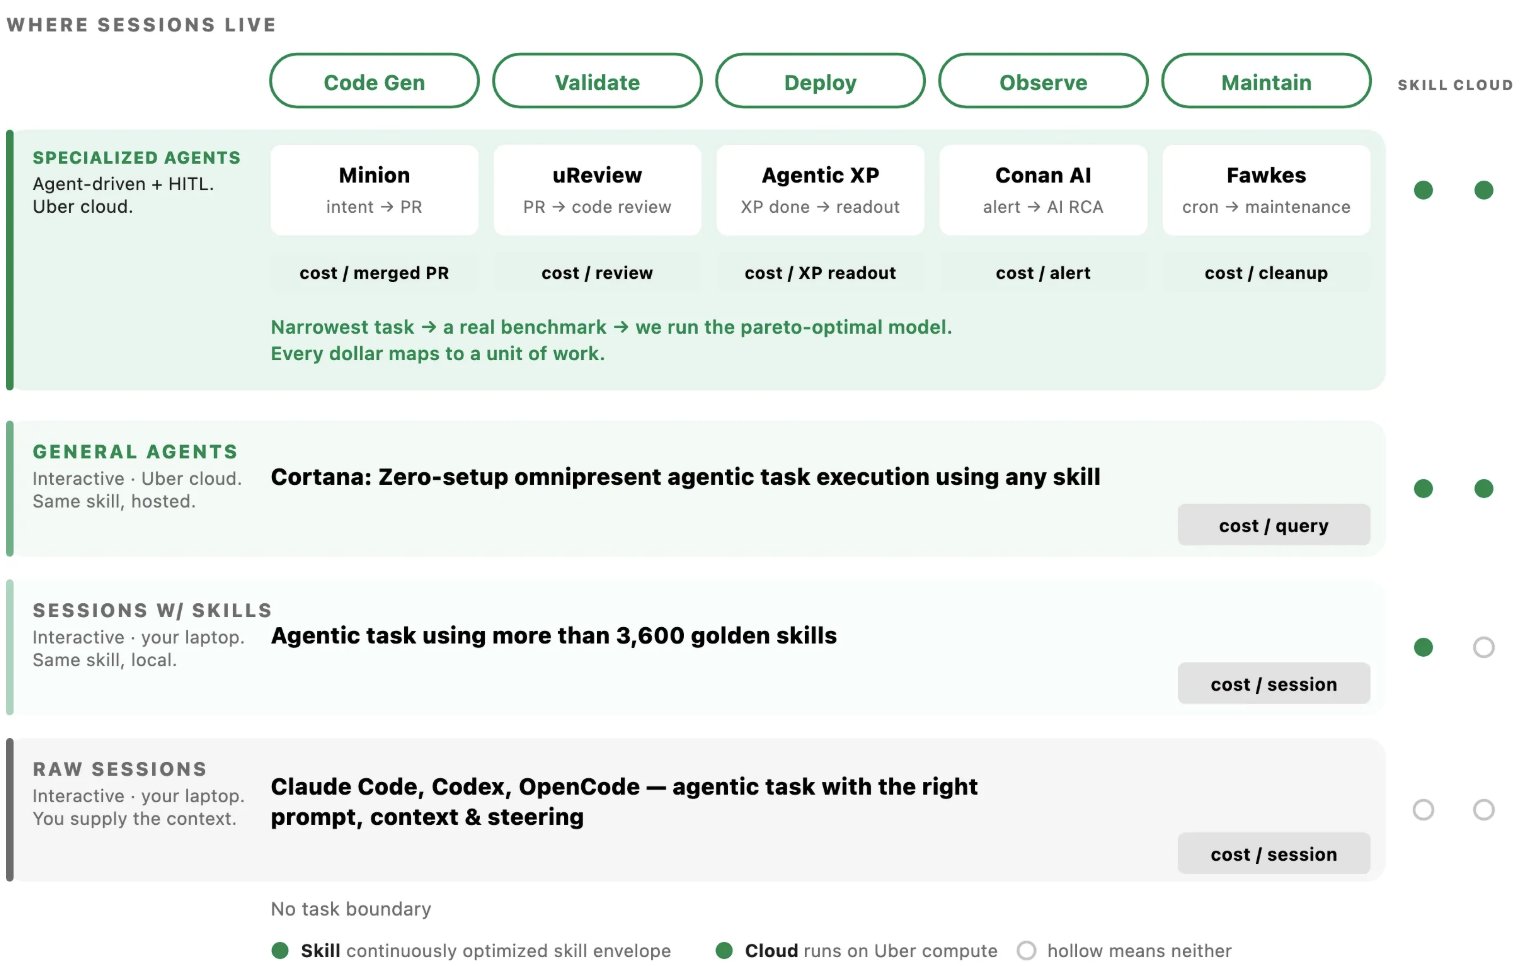 Figure 3: Agent 会话运行的四层架构
图 3:Uber Agent 会话运行的四个层级。
- Layer 4|全托管专用 Agent(Managed Specialized Agents)
- 场景:uReview 代码审查、CI 构建自愈、基于视觉对比的端到端 PR 生成、On-call 告警自动诊断。
- 特点:任务目标明确,输入输出边界严格。平台统一托管调度,能针对具体任务选择高性价比模型并精简 Prompt。
- Layer 3|全托管通用编码 Agent(Managed General Coding Agents)
- 场景:在云端隔离沙盒中运行的通用开发任务,如跨仓库依赖升级与接口迁移。
- Layer 2|交互式编码外壳(Interactive Coding Harness)
- 场景:工程师在本地终端 CLI 或 IDE 插件中发起的人机协同编程会话。
- Layer 1|直接模型调用与纯对话(Direct LLM / Chat)
- 场景:通用无状态问答、思路讨论与文档查询。
算力支出的成本六因子公式
无论 Agent 运行在哪一层,一次会话的总支出都可以拆解为 6 个因子的乘积:
$$\text{Total Spend} = \text{Active Users} \times \frac{\text{Sessions}}{\text{User}} \times \frac{\text{Turns}}{\text{Session}} \times \frac{\text{Requests}}{\text{Turn}} \times \frac{\text{Tokens}}{\text{Request}} \times \frac{\text{Price}}{\text{Token}}$$
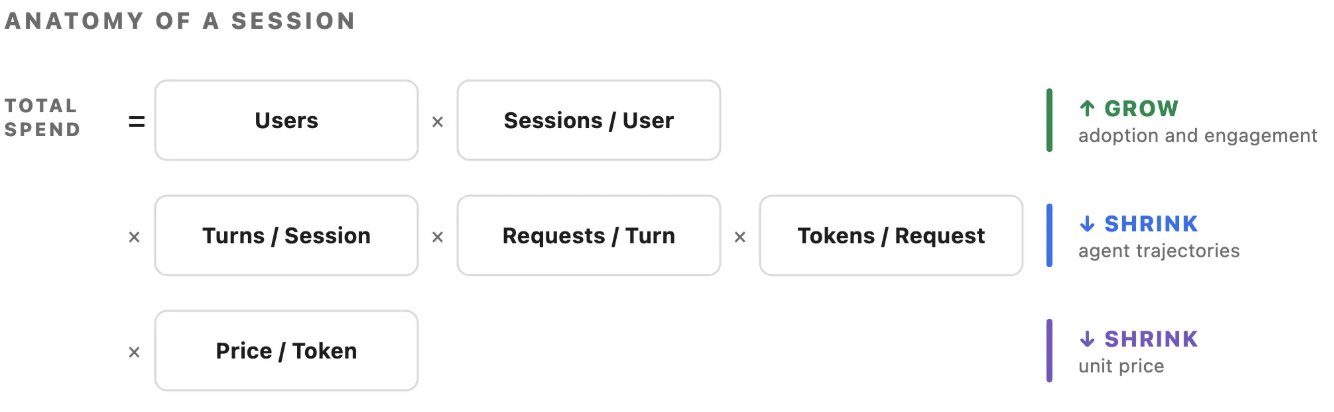 Figure 4: 成本方程的六因子乘法拆解
图 4:总支出分解为可独立度量与优化的六个连乘项。
六个因子的分组治理策略
- 前两项($\text{Active Users} \times \frac{\text{Sessions}}{\text{User}}$):代表业务采纳度与使用频次。无论是工程师主动发起交互,还是托管 Agent 在后台自动运行,Uber 都鼓励这两项持续增长。
- 中间三项($\frac{\text{Turns}}{\text{Session}} \times \frac{\text{Requests}}{\text{Turn}} \times \frac{\text{Tokens}}{\text{Request}}$):代表 Agent 自主运行带来的工作量放大系数。在工程师输入的原始 Prompt 之外,Agent 会自行规划、检索上下文、调用工具并重试。这三项是平台工程优化的重点,具体手段包括加快规划收敛、减少无效轮次与报错,以及压缩单轮上下文 Token。
- 最后一项($\frac{\text{Price}}{\text{Token}}$):代表单位 Token 价格,取决于模型选型与供应商定价。
03|Uber 的指标度量体系
为了支撑短期迭代与长期预算规划,Uber 搭建了按周和按月统计的监控看板:
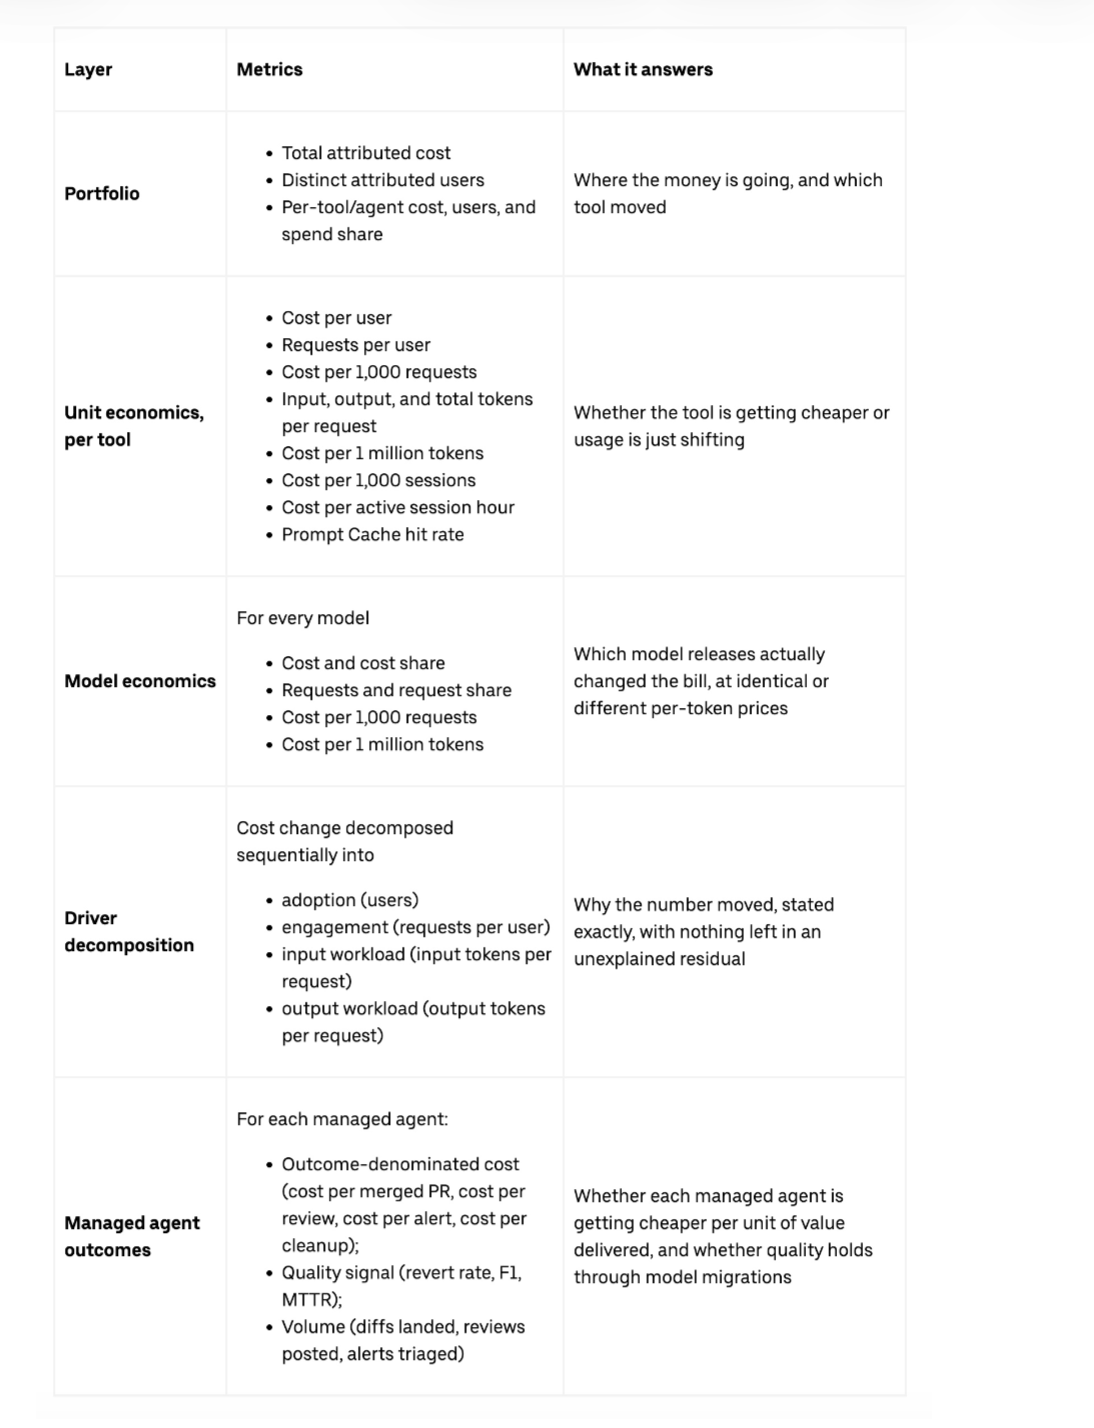 Table 1: 全链路度量指标矩阵
表 1:Uber 追踪的六类细分度量指标。
- 采纳度与使用量:周活跃/月活跃用户数(WAU / MAU)、人均每周会话数(Sessions / User / Week);
- 会话交互深度:单次会话平均轮次(Turns / Session)、会话完成率(Success Rate);
- 请求与工具效率:每轮请求数(Requests / Turn)、工具调用成功率、子 Agent 派发比例;
- 上下文规模:单次请求输入/输出 Token 数(Input / Output Tokens per Request)、缓存命中率(Cache Hit Rate);
- 模型与成本指标:每百万 Token 综合单价、单次 PR 审查平均成本、单次 CI 自愈平均花费。
04|成本优化手段与因子映射
围绕成本方程中的各个乘数项,Uber 建立了一套对应的工程优化方案:
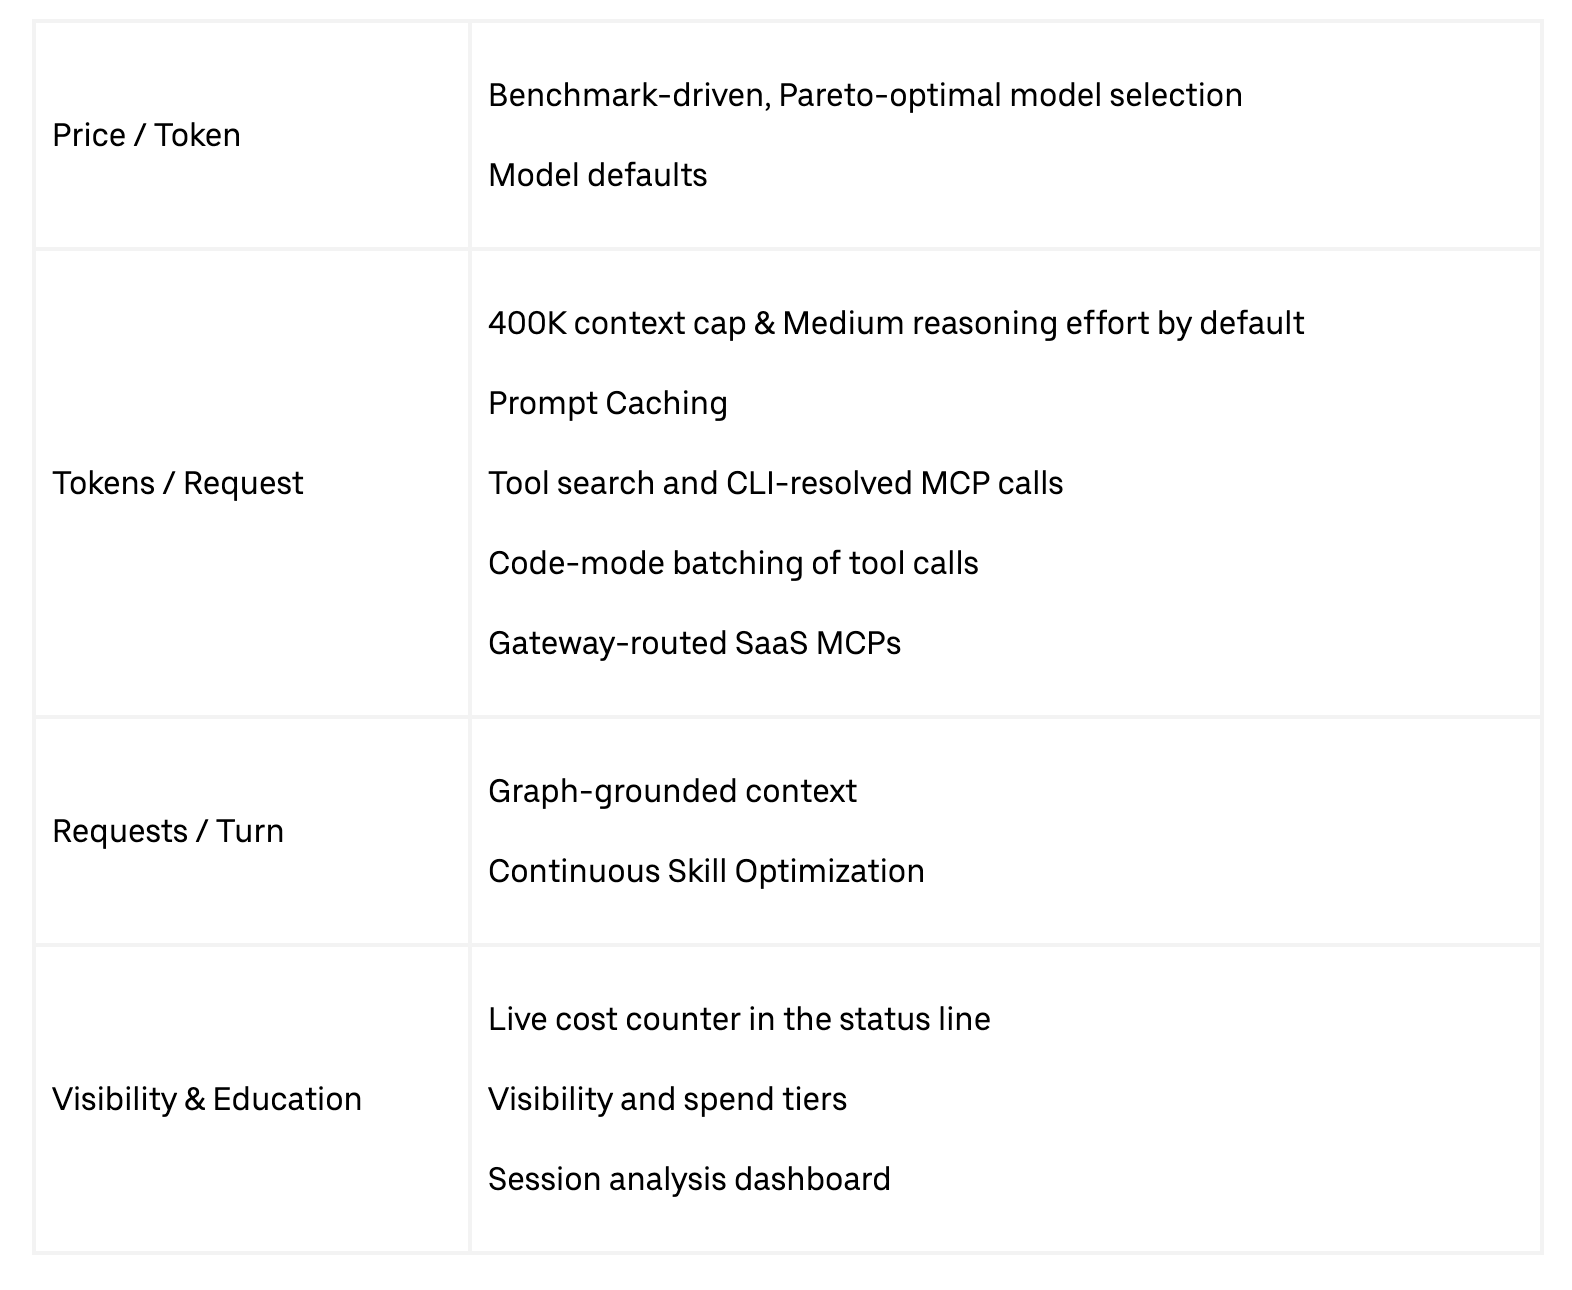 Table 2: 优化杠杆与成本因子的对应映射
表 2:关键工程优化手段与成本方程各因子的映射关系。
05|优化一:降低 Price / Token(基于真实基准的 Pareto 选型)
模型供应商决定 Token 的基础定价,而企业决定把哪类任务交给哪个模型处理。
在托管 Agent 体系中,Uber 按 Pareto 最优原则(Pareto Efficient) 选型,在单任务完成成本(Cost / Completed Task)、输出质量(Output Quality)和模型稳定性(Model Reliability)三者之间寻找平衡点。
基于真实工作负载的四步选型法
- 真实任务抽样:直接从生产环境的 Agent 历史任务中抽样,构建评测基准(Benchmark);
- 统一外壳评测:借助统一网关,用同一套接口与流水线测试闭源模型(Frontier)和开源权重模型(Open-weight);
- 持续更新 Pareto 前沿:大模型迭代节奏快,每隔几周重新跑分并调整选型;
- 场景化动态路由:根据托管 Agent 的历史运行数据,按细分任务类型动态分发模型。
案例:uReview 代码审查的模型选型
以覆盖全公司 PR 的 uReview 为例,团队从历史上包含已知 Bug 的真实 PR 中提取样本,按难度分为 Easy、Medium 和 Hard 三档。
评测系统统计精准率(Precision)、召回率(Recall)和 F1 分数,同时对比单次审查成本、响应延迟、超时率与误报率。
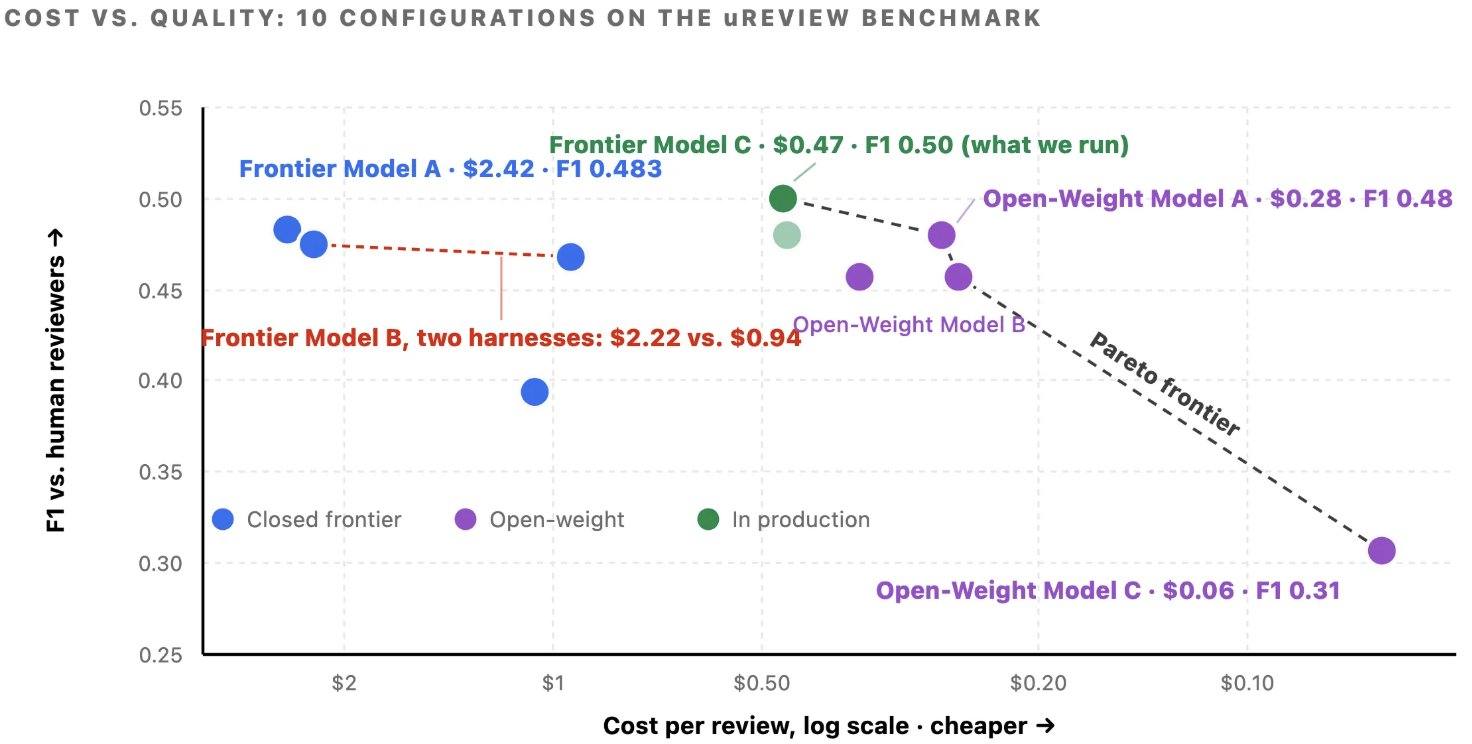 Figure 5: uReview 的所有测试配置与 Pareto 前沿面
图 5:uReview 的测试构型分布图。虚线为 Pareto 前沿面,落在虚线右下方的配置均被成本更低或质量更优的模型取代。
切换到 Pareto 前沿上的模型组合后,uReview 降低了单次 PR 审查成本,同时提高了 F1 分数。
子 Agent(Subagent)的默认模型策略
在交互式终端里,单个模型的 Token 价格固定,但平台可以调整不同模型的调用占比。其中见效最快的是配置子 Agent 的默认模型:
- 背景:多智能体编排普及后,主会话派发 Subagent 的比例持续上升。
- 原因:Subagent 执行的通常是输入明确、职责单一的子任务,不需要高价大模型做复杂推理。
- 做法:默认将 Subagent 绑定到低成本的小模型,同时保留手动切换选项。主 Agent 负责拆解任务与最终验收,子 Agent 负责具体的批量执行。
06|优化二:压缩 Tokens / Request(上下文精简与协议改造)
在 Agent 的多轮对话中,每一轮请求都会重复携带历史对话、项目上下文和工具返回结果。只要压缩单次请求的体积,就能在整场会话中叠加节省大量 Token。
1. 两项默认外壳配置
Uber 为交互式 Harness 编写了统一的接入封装层,内置两项默认配置:
- 满 400k Tokens 自动触发上下文压缩(Auto Compaction):即使模型支持 1M 上下文窗口,系统也会在达到 400k 阈值时自动摘要压缩。实测表明,这样做既能避免长上下文导致推理质量下降,也能防止单轮超大 Token 缓存失效时产生高额账单。
- 思考强度默认设为中等(Reasoning Effort = Medium):主流模型的思考 Token(Thinking / Reasoning Tokens)单价通常是普通输入 Token 的数倍。把默认思考强度设为 Medium,能在保证日常任务准确率的同时控制推理开销。
2. Prompt 缓存计费测算与 1 小时 TTL 策略
开启 Prompt 缓存后,后续轮次读取前缀上下文的价格可降至标准输入价的 0.1 倍(节省 90%)。不过写入缓存需要额外付费:5 分钟 TTL 的写入价格是 1.25 倍,1 小时 TTL 的写入价格是 2 倍。
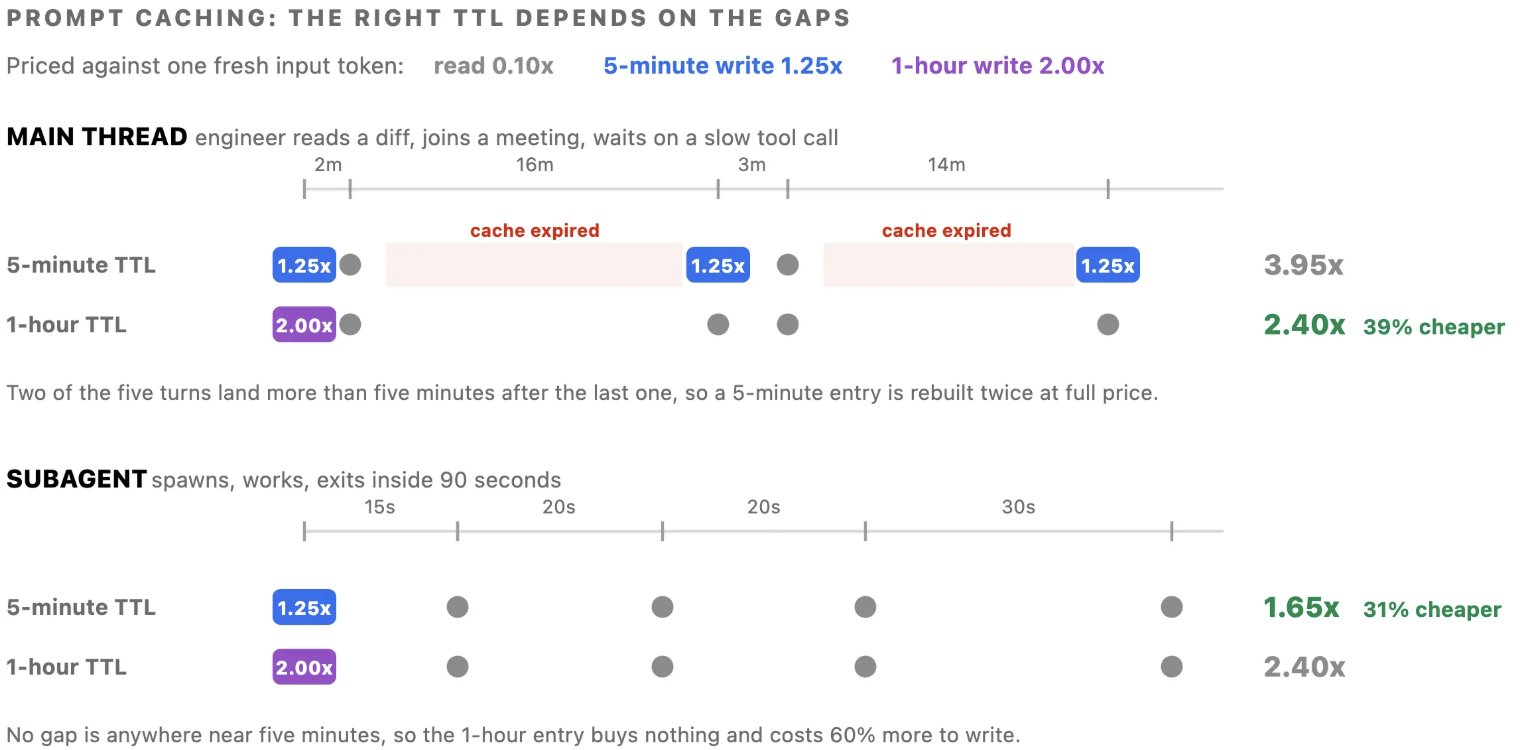 Figure 6: 5 分钟 TTL 与 1 小时 TTL 在 5 轮交互中的费用推演对比
图 6:不同轮次间隔下 5 分钟与 1 小时 TTL 的成本对比。
缓存窗口策略
- 交互式会话痛点:工程师在终端工作时,经常因开会、调试或思考而停顿超过 5 分钟。如果使用 5 分钟 TTL,缓存前缀很容易过期失效,后续请求只能按全价重新写入上下文。
- 主会话策略:对人工交互长会话统一启用 1 小时 TTL 缓存窗口,减少停顿导致的重复全价写入。
- 子会话隔离:Subagent 执行的是连续的程序化短任务,因此保留 5 分钟短 TTL,减少写入溢价。
3. 用 Shell 执行 MCP 工具:消除 Schema 上下文膨胀
在 Uber 内部,所有 MCP(Model Context Protocol)调用都经过统一的内部网关,后端连接了超过 1,000 个内部与第三方 SaaS MCP Server。
标准 MCP 协议的开销问题
标准 MCP 协议在会话启动时,会把所有已配置工具的 JSON Schema 一次性塞进 System Prompt。如果开发者挂载了 100 多个工具,光工具定义就会占用 50k~70k Tokens,而且每轮对话都要重复发送并计费。
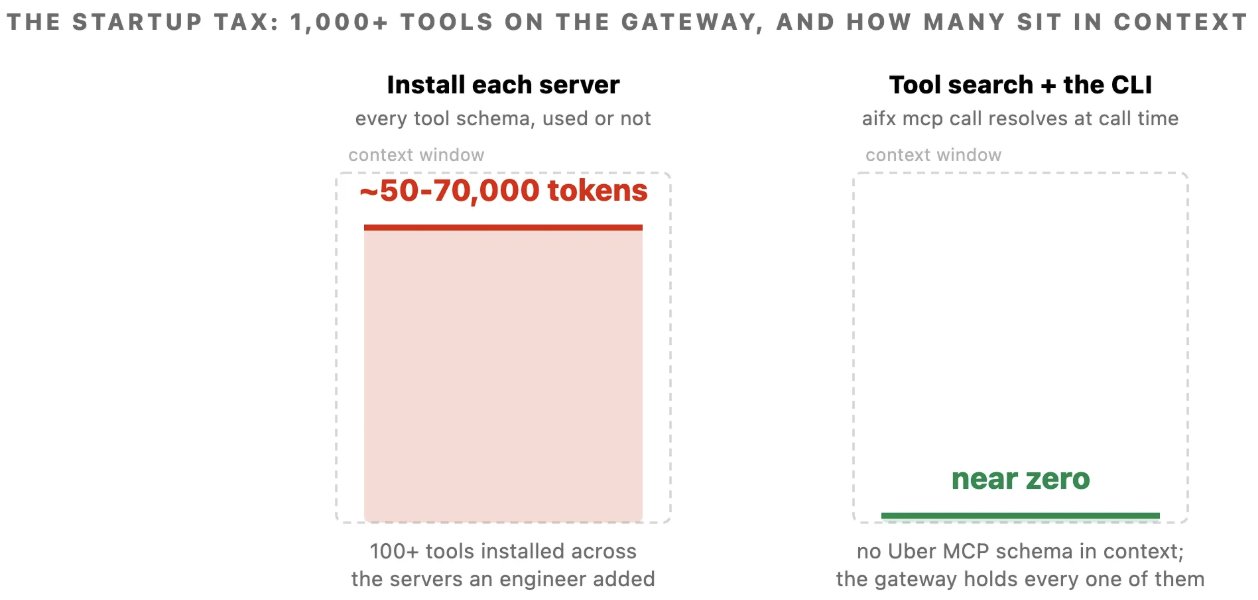 Figure 7: 相同工具集合下,三种接入方式在会话开始时携带的初始 Token 负载对比
图 7:直连 MCP、CLI 映射与 Tool Search 在会话初始化时的 Token 占用对比。
两种改进方案
- CLI 工具动态解析(CLI Tool Resolution):把内部 MCP 网关后面的 1,000 多个工具统一映射为标准 Shell CLI 命令。模型不需要预先加载 Schema,直接在终端调用命令行即可。CLI 会在实际执行时动态请求网关,从 System Prompt 中移除了 MCP Schema。
- 按需检索工具(Tool Search):面对上千个工具时,模型先检索工具目录(Tool Catalog),只在需要时按需加载对应工具的定义。这既缩小了上下文体积,也降低了候选工具过多引发的调用错误率。
4. Code-Mode(代码模式):减少多轮轮询往返
工具改为通过 Shell 调用后,模型就能在单个 Python 脚本里批量组合多个操作(Batching Multiple Actions)。
传统 MCP 轮询与 Code-Mode 本地循环对比
以执行一条数据仓库 SQL 查询为例:
- 传统 MCP:提交查询占 1 轮,轮询状态 2~5 次(每次占 1 轮模型交互,状态日志全部写入 Context),最后拉取结果再占 1 轮。
- Code-Mode:模型生成一段带
while循环与重试逻辑的本地 Python 脚本,由本地子进程(Subprocess)完成轮询,只把最终计算结果或精简摘要返回给模型。
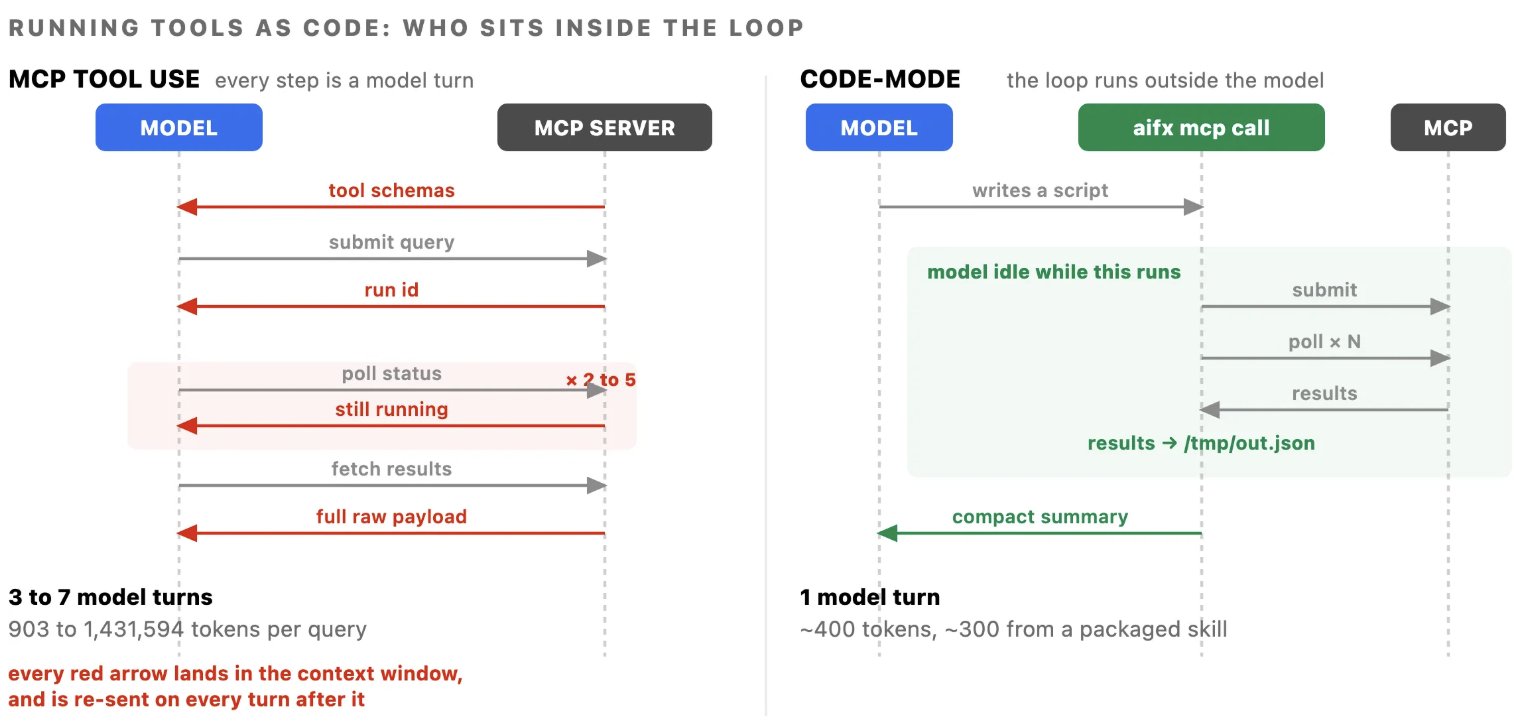 Figure 8: 数据仓库 SQL 查询的两种执行路径对比
图 8:左侧为传统模型参与每轮轮询(Context 持续膨胀);右侧为 Code-Mode 本地子进程循环(仅回传最终摘要)。
基准测试结果
在同一会话中连续执行 5 次相同 SQL 查询的对比数据如下:
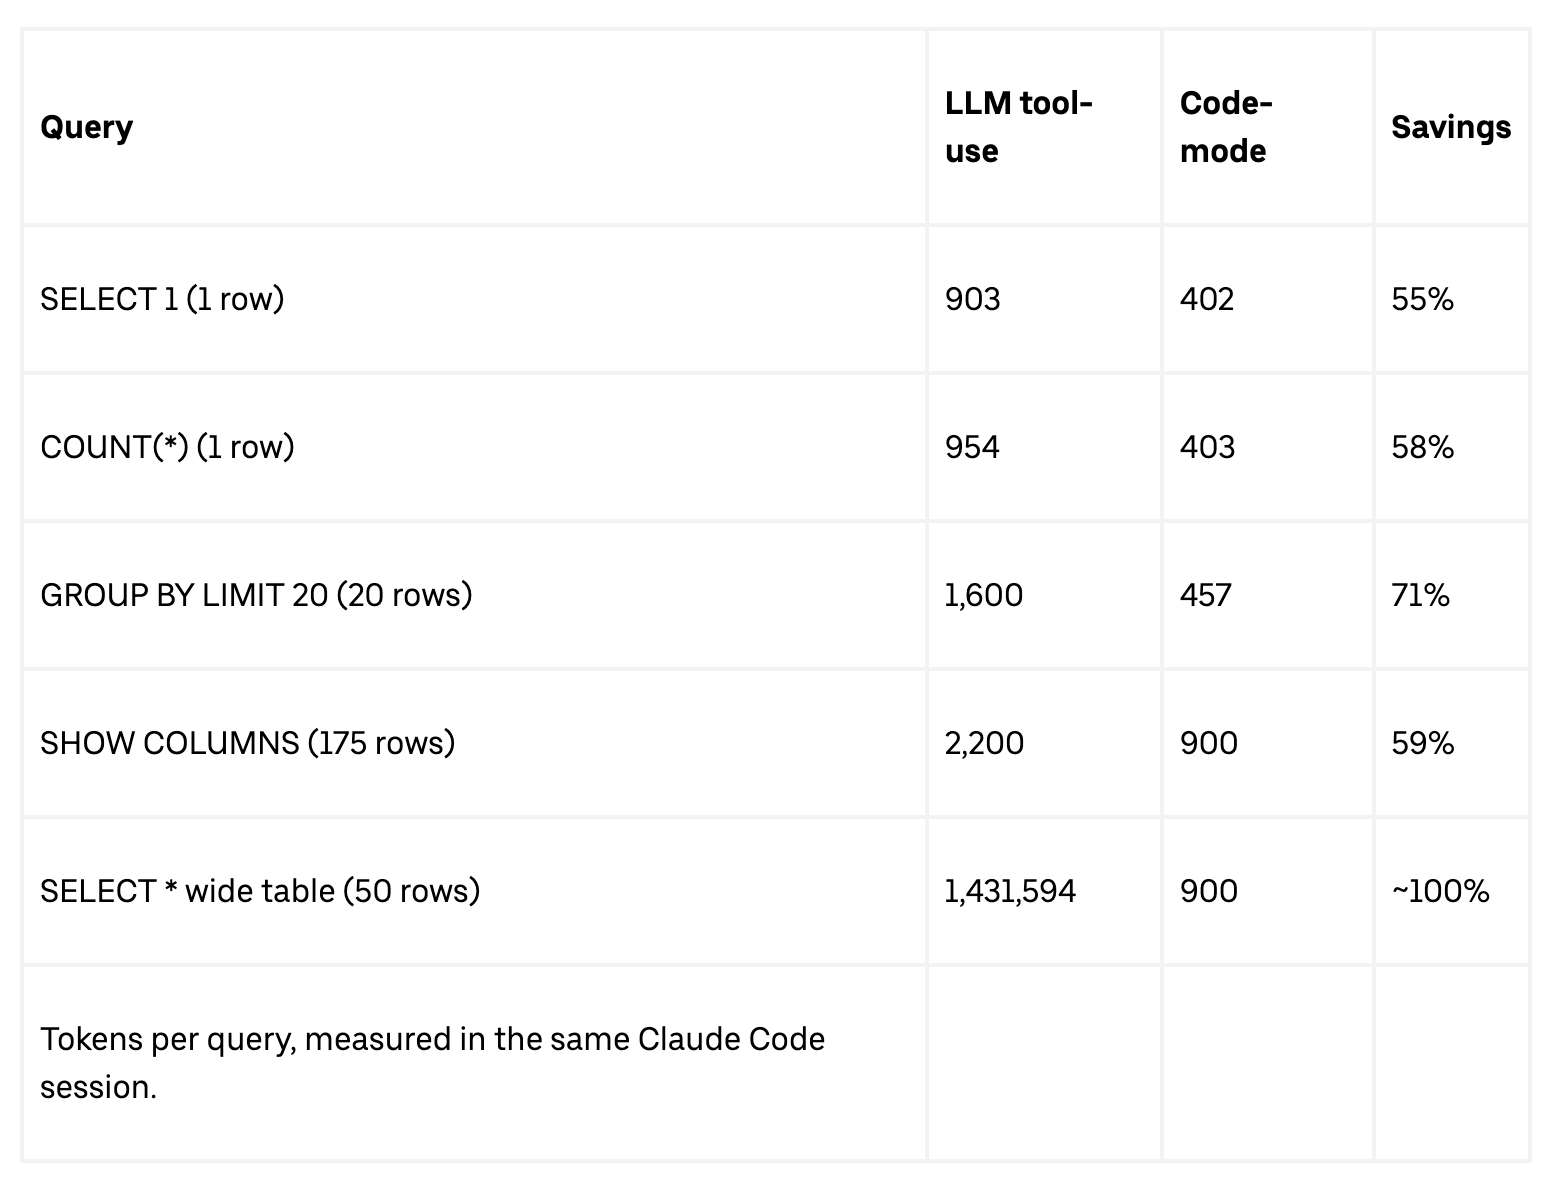 Table 3: SQL 基准测试对比数据
表 3:不同查询场景下 Code-Mode 的 Token 节省比例。
- 小结果集查询:即使返回的数据量很小,Code-Mode 也能减少超过 50% 的 Token 消耗,省去了多轮 Schema 传输、网络往返与逐步推理。
- 批量工作流(Bulk Workflows):把原本需要 N 轮往返的循环合并为单次脚本执行后,Token 消耗降幅超过 90%。
- 目前 Uber 已为高频访问的 MCP 服务封装了超过 25 个预置的 Code-Mode 插件技能。
5. SaaS MCP 的统一网关接入
第三方 SaaS 厂商提供的 MCP Server 通常包含大量通用接口。例如某协同办公套件的单个 Server 内置了 49 个工具,Schema 占用 22k Tokens;即时通讯和项目管理工具也分别带有 34 个和 46 个工具。
Uber 把所有外部 SaaS MCP 统一接入内部的 MCP Gateway,同样映射为 CLI 命令,并搭配 Code-Mode 插件编写专用工作流 Skill,降低了各类 SaaS 自动化调用的上下文开销。
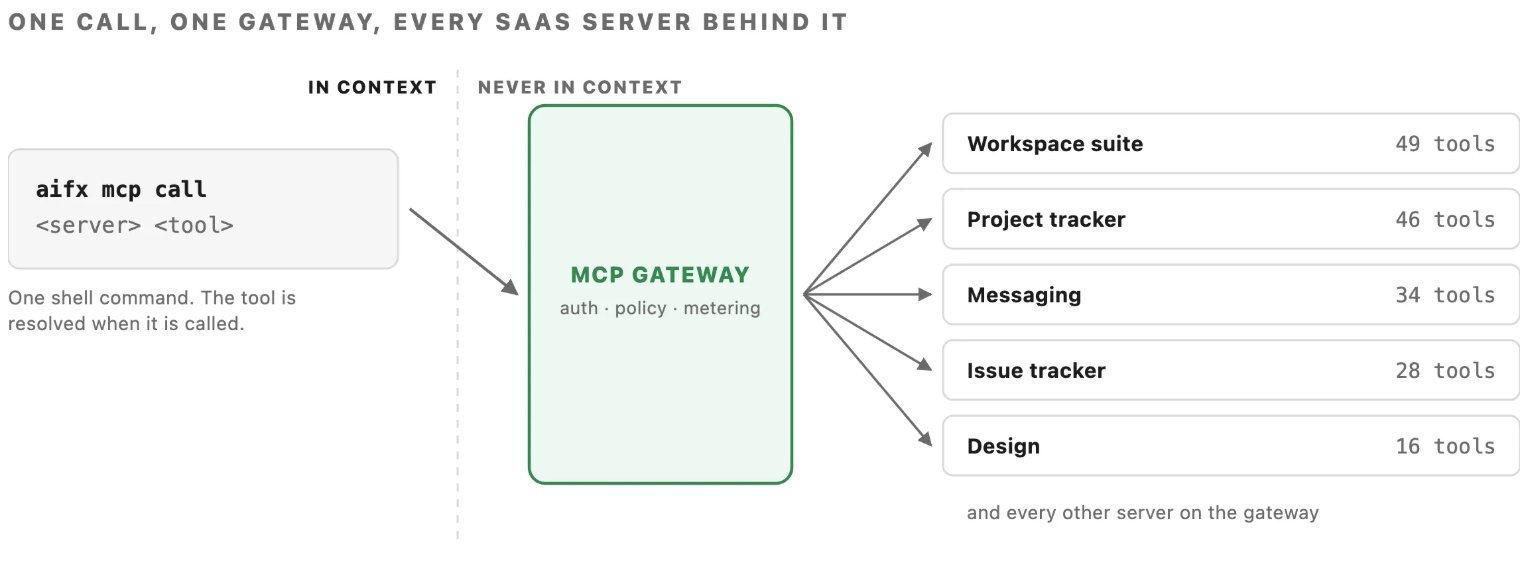 Figure 9: SaaS MCP Server 统一通过网关进行安全与协议治理
图 9:所有 SaaS MCP 接入统一网关,集中处理认证与轻量化调用。
07|优化三:减少 Requests / Turn(AI Context Graph 上下文图谱)
缺少业务上下文的 Agent 往往会在代码库里盲目搜索、反复试错,导致对话上下文迅速膨胀。在任务开始时直接注入结构化的准确上下文,能大幅减少无效的探索轮次。
AI Context Graph(AI 上下文图谱)
Uber 维护着数亿行代码与数万张数据表。为了帮 Agent 快速定位目标资产,团队构建了 AI Context Graph:
- 包含 2,400 万个节点与 8,000 万条边;
- 覆盖 86 种节点类型与 117 种关系类型;
- 接入了公司内部 30 多个核心系统,涵盖微服务拓扑、团队归属、故障复盘(Incident)、PR 记录、架构设计文档(RFC)、部署状态、数据集与历史查表日志。
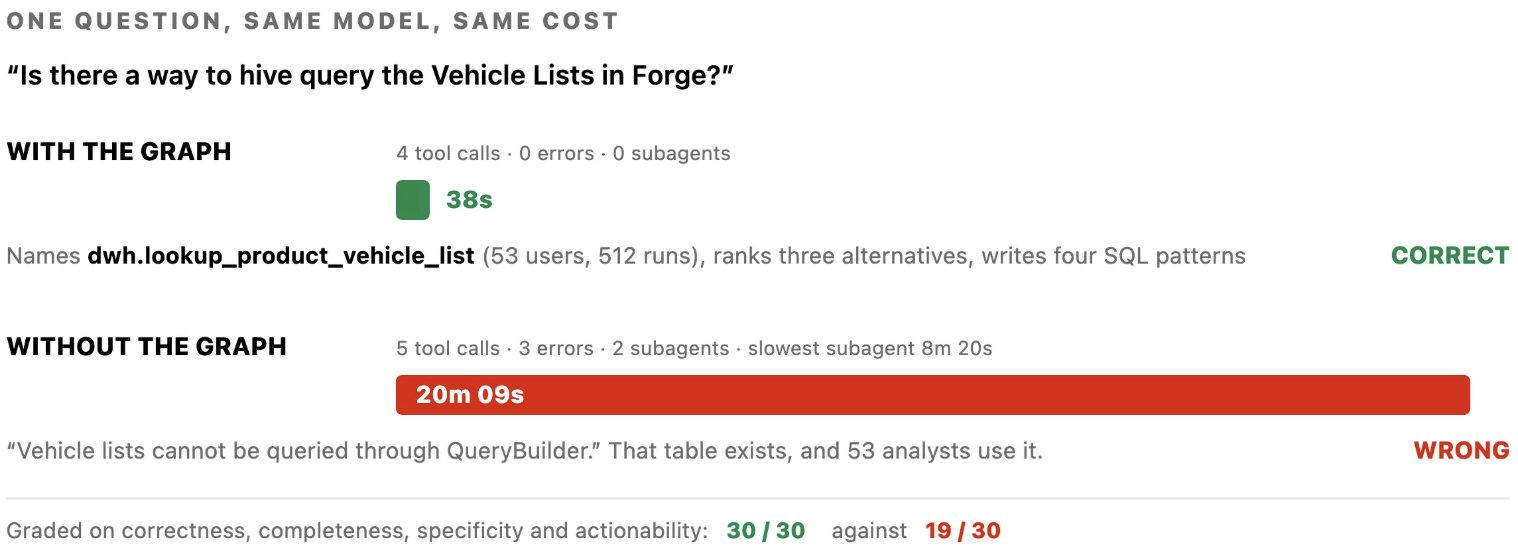 Figure 10: 相同 Prompt 在有无上下文图谱辅助下的执行路径对比
图 10:有图谱辅助(38 秒完成)与无图谱盲搜(20 分钟报错失败)的执行对比。
实测对比
针对同一个业务数据查询问题:
- 接入 Context Graph 的 Agent:检索历史查询关系,直接定位到内部 50 多位分析师常用的目标事实表,耗时 38 秒返回准确结果。
- 未接入图谱的 Agent:在数万个微服务代码库里遍历搜索,中途派发 2 个子 Agent,连续触发 3 次异常,耗时 20 分钟后给出“该数据不可查”的错误结论。
08|成本透明度与工程治理
控制成本需要避开一刀切的硬性限流,改用实时账单展示与具体优化建议来引导工程师。
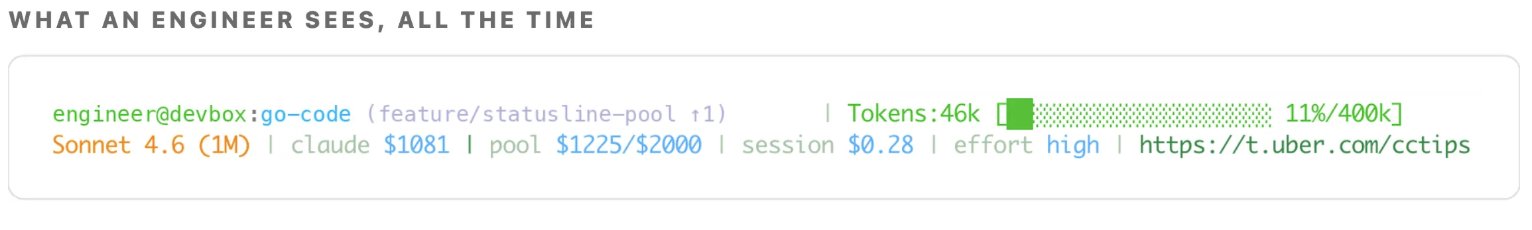 Figure 11: 终端 Status Line 实时成本指示器与效率分析器
图 11:终端常驻状态行(Status Line),集成实时计费与会话分析器。
五项治理措施
- 终端状态栏计费显示:在终端底部常驻展示当前会话花费与历史累计花费;
- 外壳共享配额池:所有交互式工具共用阶梯额度,托管 Agent 使用独立配额;
- Slack 分级提醒:用量达到预算的 50%、80% 和 100% 时,自动发送通知提醒;
- 快捷扩容审批:直属经理点击确认即可提高配额上限;
- 成本看板反模式诊断:运行
cost dashboard技能后,系统会扫描该工程师在各 Harness 与沙盒中的会话 Trace,自动识别 16 种常见浪费模式,并给出预计可节省的金额。常见浪费包括用 Opus 跑简单多轮任务、残留超大 MCP 返回结果、长停顿导致缓存失效,以及在初始 Prompt 中塞入冗余说明。
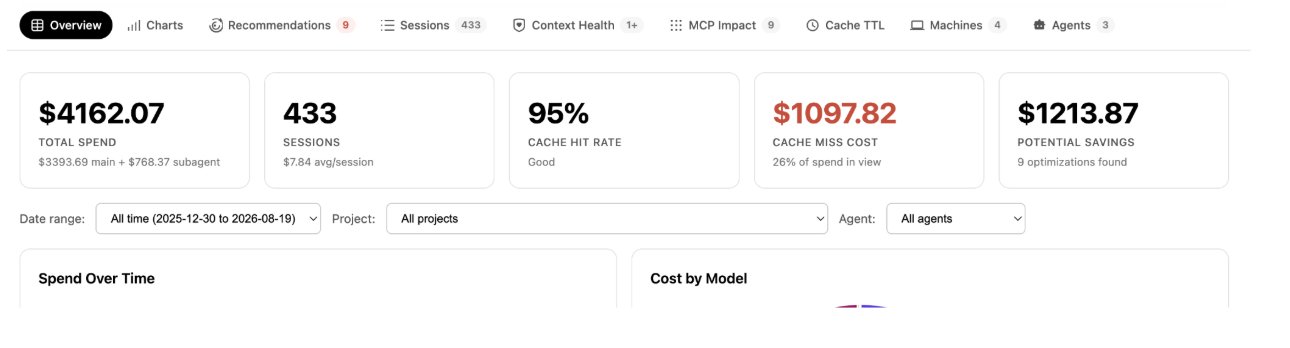 Figure 12: Session-level 成本诊断分析看板
图 12:会话级成本分析看板,定位高开销原因并估算可节省金额。
09|后续演进规划与工程启示
Uber 软件工厂下一步推进的五个工程方向:
- 扩充全托管专用 Agent:为研发生命周期的更多环节建立专用 Benchmark,匹配 Pareto 最优模型;
- 请求级动态模型路由:将基准评测扩展到更多编程语言与多模态任务,按单次请求特征动态分流模型;
- 推广 Context Graph 接入:让更多自主智能体直接调用上下文图谱做关系推理与自然语言查询;
- 会话中实时效率提示:把事后批处理账单诊断,升级为会话过程中的实时 Trace 监听与优化提醒;
- Skill 自动迭代:根据全公司 Agent Skill 的实际运行报错记录,自动修正并更新 Skill 提示词。
Uber 的实践表明,控制 AI 编码成本不需要被动等待模型降价,也不需要牺牲开发者的使用体验。剔除无价值的冗余 Token 消耗后,团队在周活增长 7 倍的同时将单次会话成本降低了 52%。
核心架构转变:从分散在个人终端的人机交互,转向集中治理的全托管 Agent 软件工厂。相比让上万名工程师在各自终端里摸索最佳 Prompt,建设一支有明确评测基准与 Pareto 模型路由的专用托管 Agent 集群,更容易兼顾规模化产出与单次成本。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。