
Uber 规模化软件工厂实战:70% PR 自动化下,如何通过 4 层 Agent 架构与成本六因子拆解让 AI 算力支出大幅下降 52%
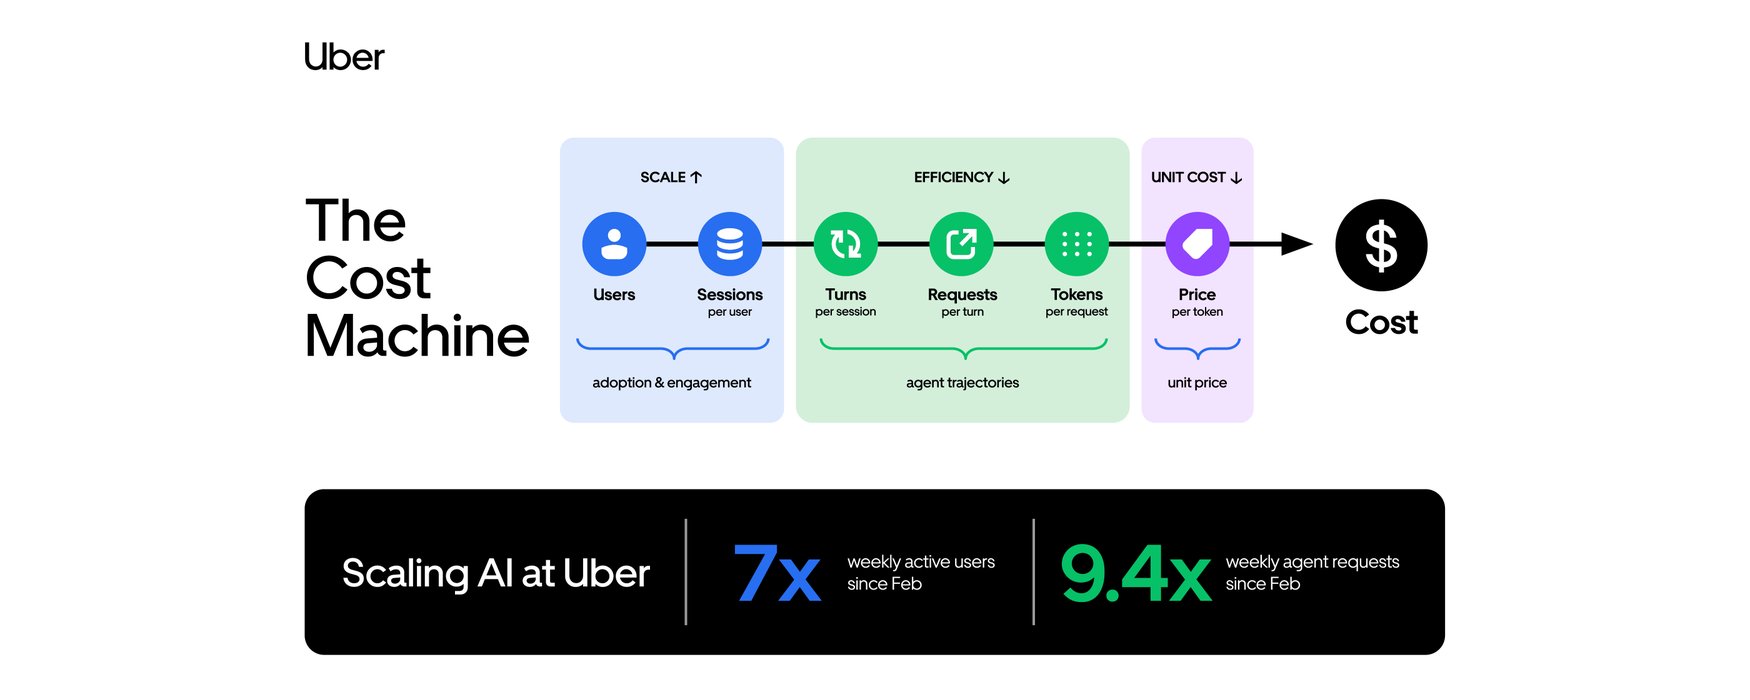
📌 导读:AI 工具如今已经深度嵌入到 Uber 软件开发生命周期(SDLC)的每一个环节。目前,Uber 内部超过 70% 的 Pull Request(PR)均由本地或云端 Agent 自主生成。工程师团队在整个研发生命周期中构建了超过 3,600 个 Agent Skills,每日触发执行超过 30,000 次。
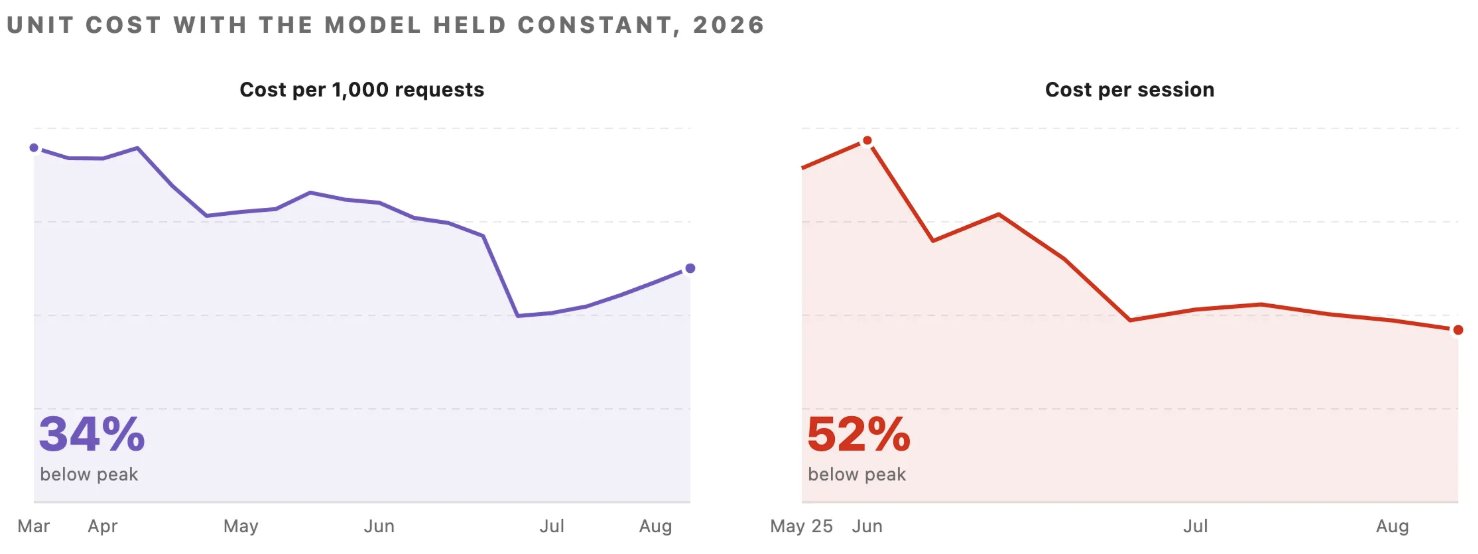
在 2026 年 2 月至 8 月期间,全公司所有员工(涵盖工程与非工程团队)的周活跃用户(WAU)激增 7 倍,Agent 周调用请求量激增 9.4 倍。然而,得益于全链路的工程化深度优化,Uber 的 AI 总支出自 4 月起成功实现了基本企稳。在固定模型对比基准下,每千次模型请求成本较峰值下降 34%,每次会话(Session)成本自 6 月峰值暴跌 52%!
本文将系统复盘 Uber 内部构建「软件工厂(Software Factory)」的完整工程体系:Agent 会话运行的四层架构、拆解 AI 支出的成本六因子公式、量化监控指标体系,以及贯穿每一层的核心优化杠杆。
01|引言:Uber 软件工厂的爆发与算力企稳奇迹
在 AI Engineer 2026 大会上,Uber 官方团队首次对外分享了关于「软件工厂(Software Factory)」的愿景,以及覆盖整个研发生命周期的核心积木与全托管 Agent 舰队。
随着该愿景的逐步落地,越来越多的开发会话不再是由人类工程师手动发起,而是由**自动化托管 Agent(Automated Managed Agents)**在后台主动接管:
- 自动化代码审查(Code Review);
- CI 持续集成故障的自愈修复(Self-Healing CI Failures);
- 结合视觉回归验证的端到端 PR 交付;
- 线上 On-call 告警分流与故障根因诊断;
- 各种存量代码重构与日常维护升级(辅以人类工程师的最终审批与升级介入)。
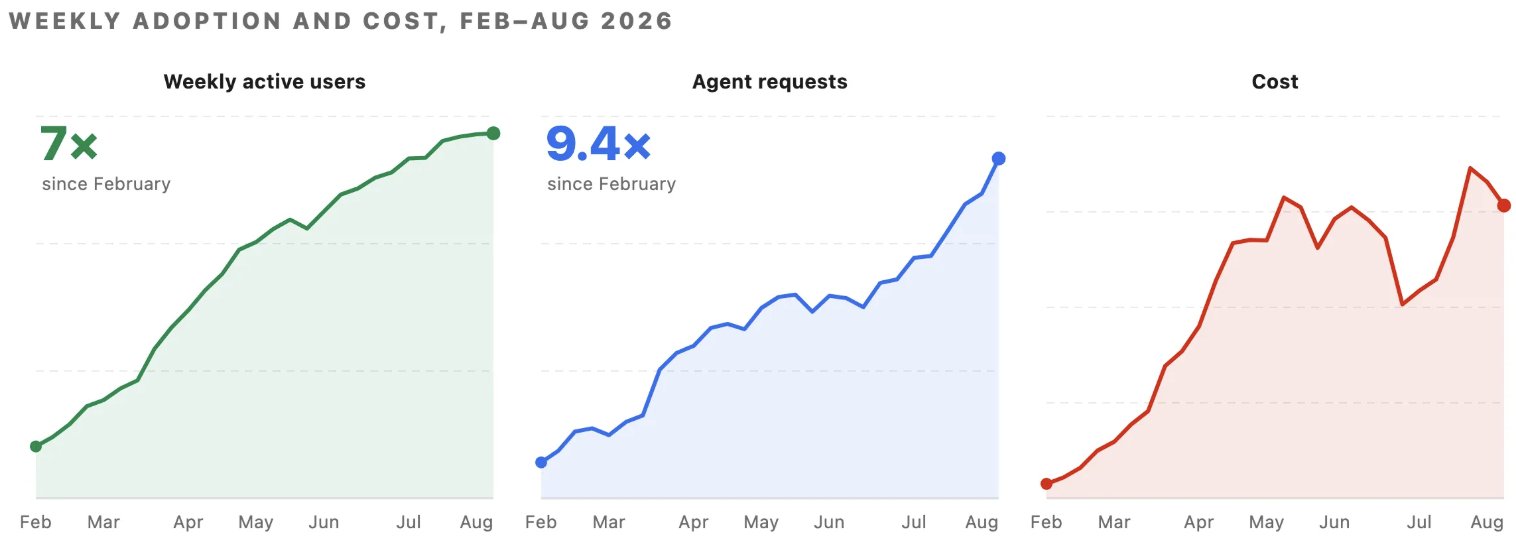
如上图所示,在周活跃用户和请求量分别激增 7 倍与 9.4 倍的极速扩张期,总成本却并没有随之线性失控,反而在经历初期探索后趋于平稳。
固定基准下的真实降本收益
由于业务采纳度、工作负载组合(Workload Mix)以及基础模型本身的升级换代每天都在动态变化,为了精准衡量工程团队自身优化手段带来的真实红利,必须将底层模型版本固定进行对照评测(因为每次模型版本迭代都会导致上下文行为模式的漂移)。
从 2 月到 7 月的固定基准测试显示:
- 每 1,000 次模型请求成本(Cost per 1,000 requests):较峰值下降了接近 34%;
- 每次会话成本(Cost per session):较 6 月峰值下降了 52%。
02|软件工厂体系与成本方程 (The Cost Equation)
Agent 使用的四层治理架构 (Four Layers of Agent Usage)
Uber 将内部所有的 AI Agent 使用场景划分为自上而下的四个层级(从最专精的自动化场景到最通用的对话交互)。
💡 核心定律:层级越高(Layer 4),平台工程团队对模型路由、运行质量与 Token 成本的掌控力就越强。
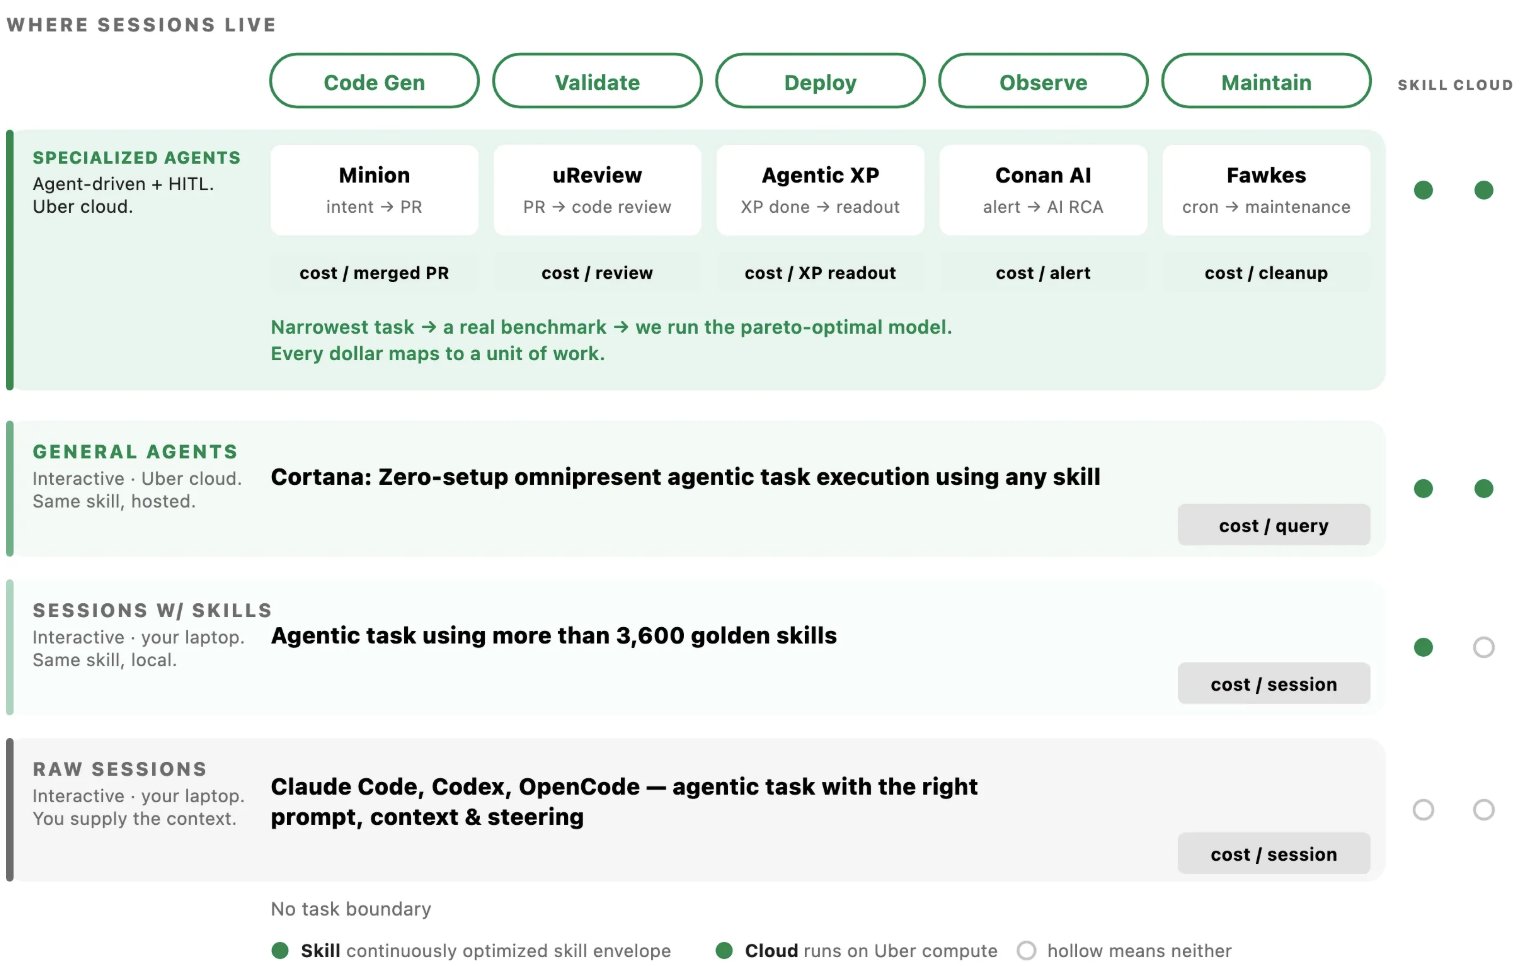
- Layer 4|全托管专业级 Agent(Managed Specialized Agents):
- 典型场景:uReview 智能代码审查、CI 构建自愈、基于视觉对比的 E2E 自动化 PR 生成、On-call 告警自动诊断。
- 特点:任务高度明确、输入输出边界严格,由平台完全托管调度,能够实现极其激进的模型针对性选型与 Prompt 极致精简。
- Layer 3|全托管通用编码 Agent(Managed General Coding Agents):
- 典型场景:在云端隔离沙盒中运行的通用软件开发任务(如跨仓库大规模依赖升级、接口迁移)。
- Layer 2|交互式编码 Harness(Interactive Coding Harness):
- 典型场景:工程师在本地终端 CLI 或 IDE 插件中进行的人机协同交互式编程会话。
- Layer 1|直接模型调用 / 纯对话(Direct LLM / Chat):
- 典型场景:通用无状态问答、日常灵感与文档查阅。
拆解算力支出的「成本六因子公式」
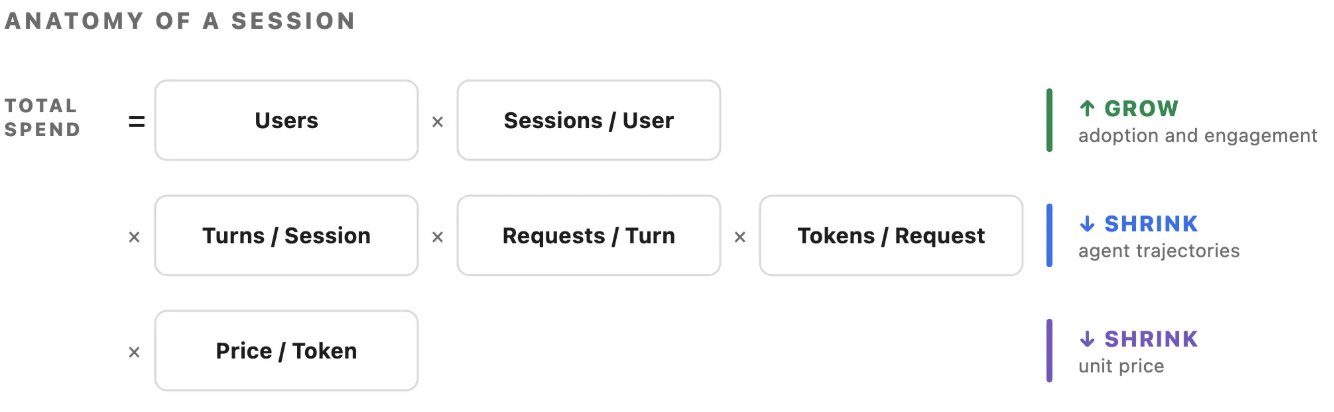
无论 Agent 运行在上述哪一层级,都可以将一次完整 Agent 会话的总支出严格分解为以下 6 个因子的乘积:
$\text{Total Spend} = \text{Active Users} \times \frac{\text{Sessions}}{\text{User}} \times \frac{\text{Turns}}{\text{Session}} \times \frac{\text{Requests}}{\text{Turn}} \times \frac{\text{Tokens}}{\text{Request}} \times \frac{\text{Price}}{\text{Token}}$
因子的分类治理逻辑:
- 前两项($\text{Active Users} \times \frac{\text{Sessions}}{\text{User}}$):代表业务采纳度与用户粘性。Uber 希望这两项在全员范围内保持持续健康增长,无论是由人类工程师交互式发起,还是由托管 Agent 在后台代劳。
- 中间三项($\frac{\text{Turns}}{\text{Session}} \times \frac{\text{Requests}}{\text{Turn}} \times \frac{\text{Tokens}}{\text{Request}}$):代表 Agent 自主衍生出的工作量放大系数。在工程师实际提出的原始 Prompt 之上,Agent 会为了完成任务自行规划、检索上下文、调用工具和重试。这三项是平台工程优化最核心的战场,涵盖了让 Agent 更快完成规划、减少无效轮次与报错、压缩单轮上下文 Token 等手段。
- 最后一项($\frac{\text{Price}}{\text{Token}}$):代表模型单价,取决于选型与供应商单价。
03|Uber 的指标度量体系 (How We Measure)
为了支持短期迭代与长期规划预算,Uber 建立了覆盖周度和月度维度的全量度量看板:
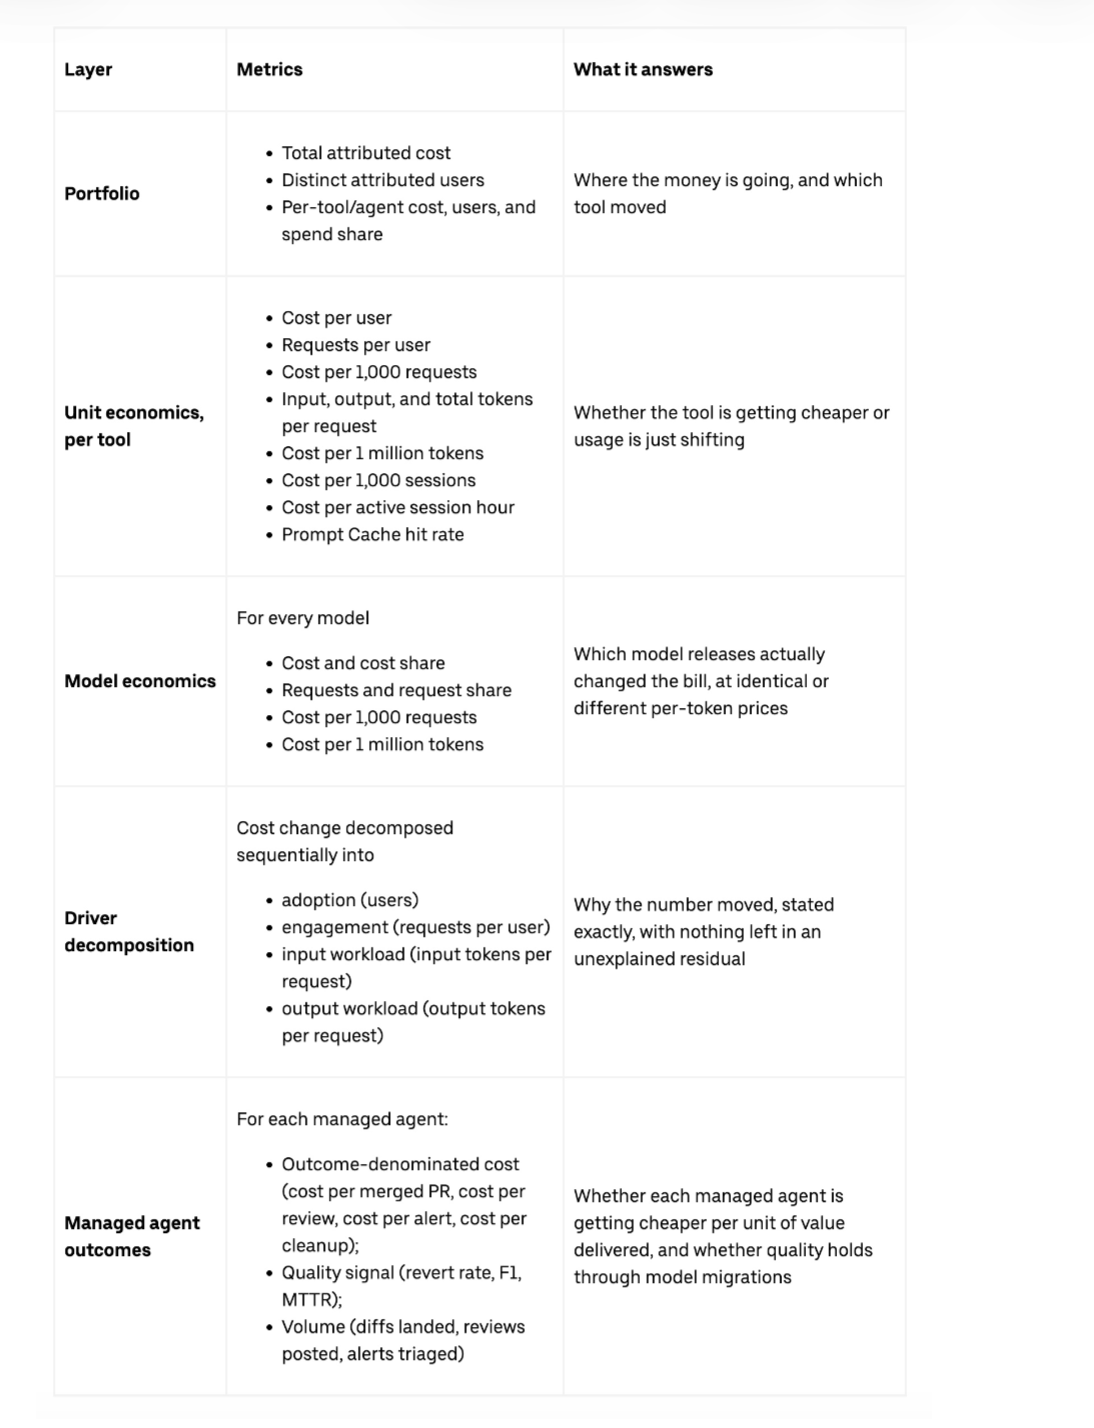
- 采纳度与使用量:每周/每月活跃用户数(WAU / MAU)、人均每周会话数(Sessions / User / Week);
- 会话交互深度:每会话平均轮次(Turns / Session)、会话完成率(Success Rate);
- 请求与工具效率:每轮请求数(Requests / Turn)、工具调用成功率、子 Agent 派发比率;
- 上下文规模:单次请求输入/输出 Token 数(Input / Output Tokens per Request)、缓存命中率(Cache Hit Rate);
- 模型与成本效益:每百万 Token 综合单价、单次 PR 审查平均成本、单次 CI 自愈平均花费。
04|核心优化杠杆全景 (Optimization Levers)
为了逐一击破成本方程中的各乘数项,Uber 研发了一套相互配合的优化杠杆矩阵:
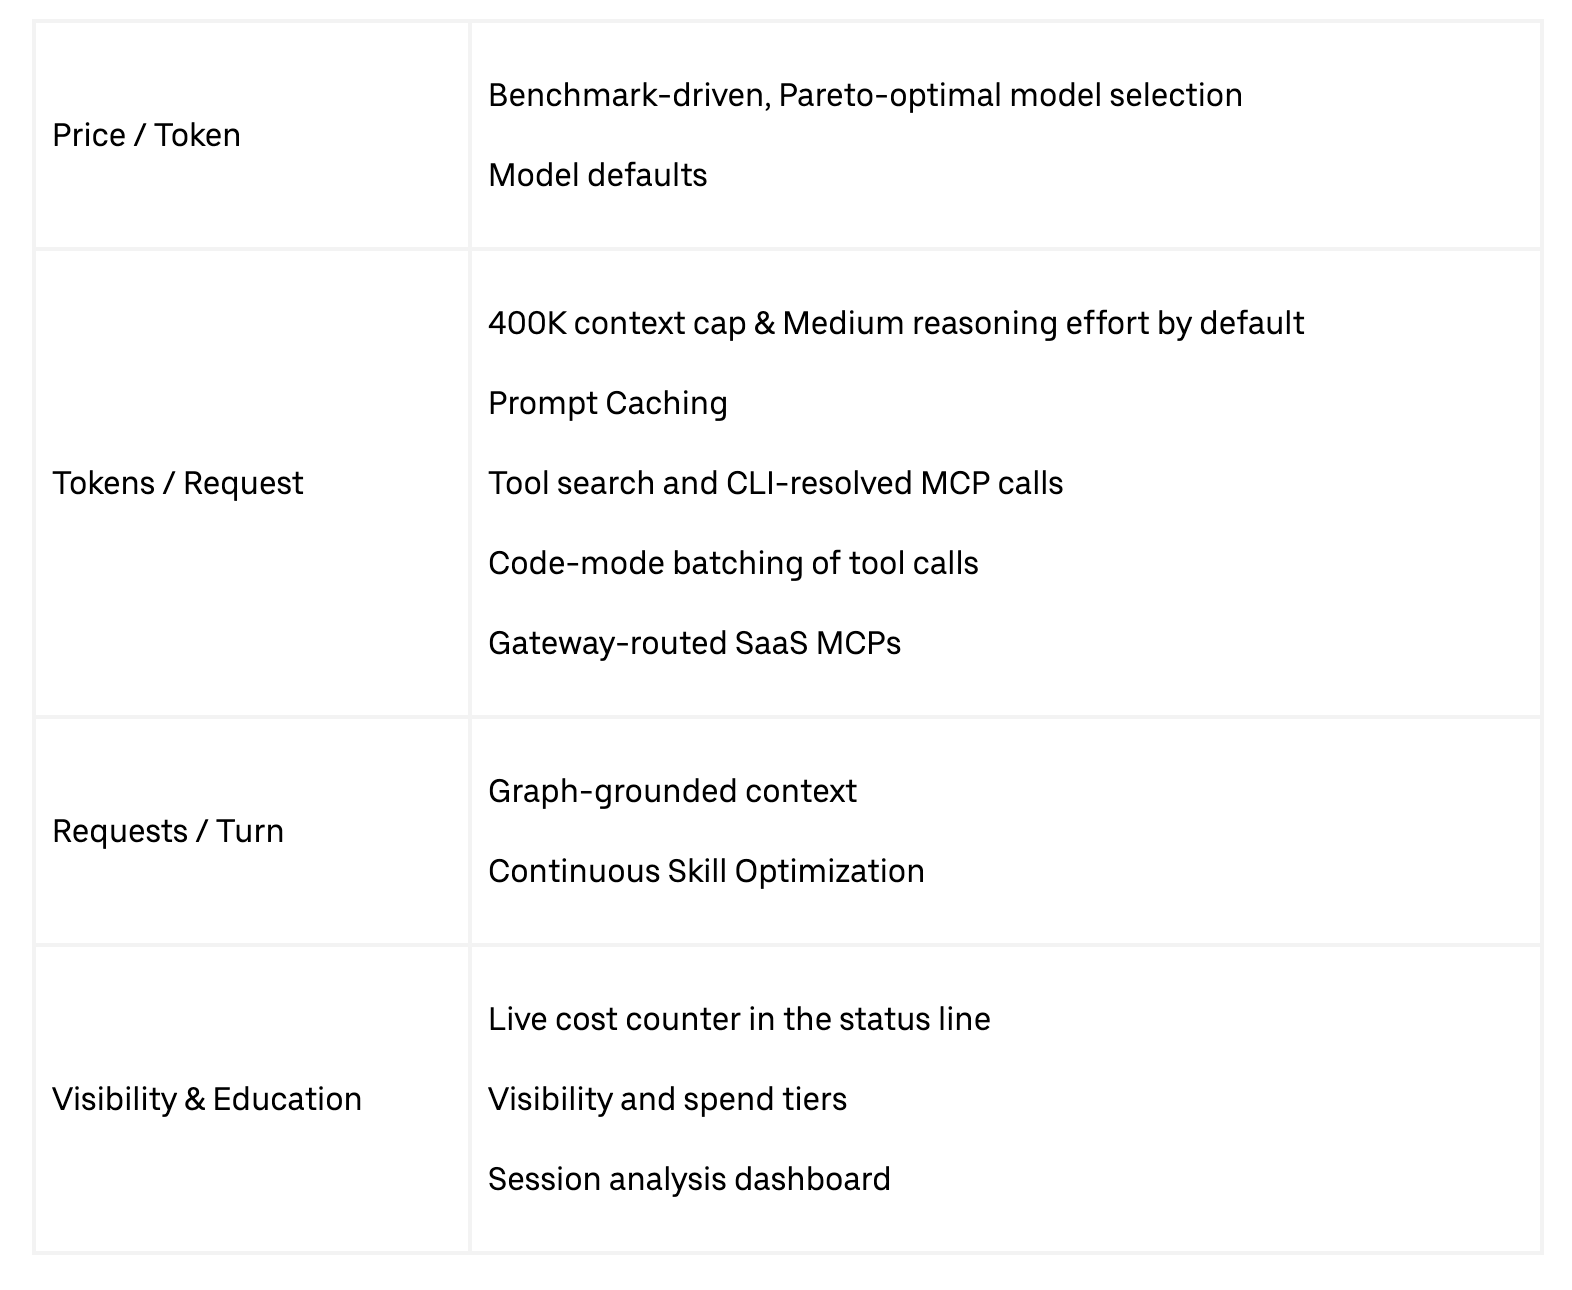
接下来,我们将重点拆解四大核心杠杆的物理落地细节。
05|杠杆一:优化 Price / Token(基于真实 Benchmark 的 Pareto 选型)
模型供应商决定 Token 基础单价,但由企业决定让哪种模型承载哪类工作负载。
在 Uber 的托管 Agent 体系中,团队始终遵循 Pareto 最优原则(Pareto Efficient) 进行选型。对于 Uber 而言,Pareto 最优意味着在每完成任务成本(Cost / Completed Task)、**输出质量(Output Quality)和模型稳定性(Model Reliability)**三者之间取得最佳平衡。
基于真实工作负载的模型选型四步法:
- 真实任务基准化:直接从 Agent 在生产环境处理的真实任务中抽样构建 Benchmark;
- 统一 Harness 评测框架:通过统一网关,将前沿闭源模型(Frontier)与开源权重模型(Open-weight)置于同一接口后进行自动化流水线评测;
- 动态追踪 Pareto 前沿面:大模型格局每隔数周就会发生剧烈变化,选型策略必须保持动态迁移;
- 聚合洞察与动态路由:基于托管 Agent 舰队的历史运行数据,部署针对细分场景的动态路由算法。
实战案例:uReview 智能代码审查选型
以覆盖全公司所有 PR 的 uReview 为例,团队从历史上包含已知 Bug 的真实 PR 中构建了评测集,并划分为 Easy、Medium、Hard 三个难度等级。
评测系统实时追踪 Precision(精准率)、Recall(召回率)、F1-Score,并综合权衡单次审查成本、延迟、超时率与误报噪音。
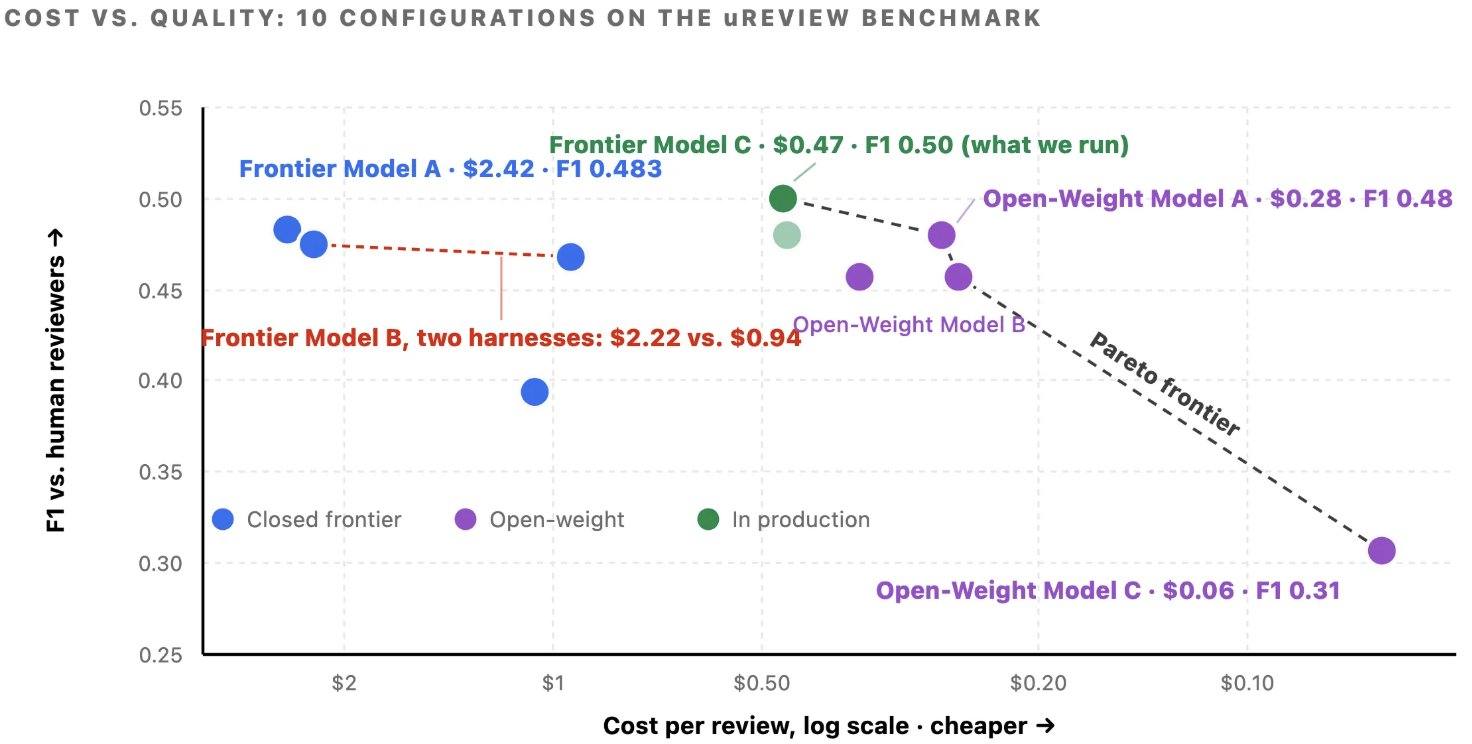
通过切换到 Pareto 前沿面上的最佳模型组合,uReview 在大幅降低单 PR 审查成本的同时,显著提升了 F1 综合表现。
默认模型配置哲学与子 Agent(Subagent)路由
在交互式终端中,Token 单价是固定的,但可以通过策略调控分配给不同模型的 Token 比例。其中最关键的杠杆就是子 Agent 的默认模型配置:
- 现状:随着模型多智能体编排能力的增强,派发 Subagent 的会话比例快速提升;
- 策略:Subagent 执行的是输入明确、职责单一的具体子任务,往往不需要顶配 Frontier 级别模型的深层复杂推理。
- 落地:默认将 Subagent 绑定到成本更低的小模型(Weaker, more cost-effective model),仅保留手动覆盖选项;主 Agent 负责全局任务拆解与最终验收,子 Agent 负责批量搬砖执行。
06|杠杆二:优化 Tokens / Request(上下文瘦身与协议革新)
在 Agent 的多轮交互中,每一轮对话都会重新发送完整的历史对话、项目上下文与工具执行结果。任何能减少单次请求 Payload 的优化,都会在整个会话中产生巨大的复利效应。
1. 两项强力默认配置
Uber 为所有交互式 Harness 开发了统一的接入封装层,内置了两项标准默认规则:
- 400k Tokens 提前强制触发自动压实(Auto Compaction):即便利于处理 1M 超大上下文的模型,依然在 400k 阈值强制触发上下文压实摘要。测试表明,这既避免了模型推理能力的衰减,又防止了单轮庞大 Token 导致缓存击穿产生巨额账单。
- 思考预算默认设为 Medium(Reasoning Effort = Medium):主流模型的内部思考 Token(Thinking/Reasoning Tokens)单价通常是输入 Token 的数倍。将思考预算默认设为 Medium,在绝大多数日常任务中成功兼顾了任务准确率与极低的花费。
2. Prompt 缓存经济学与 1 小时 TTL 策略 (Prompt Caching Strategy)
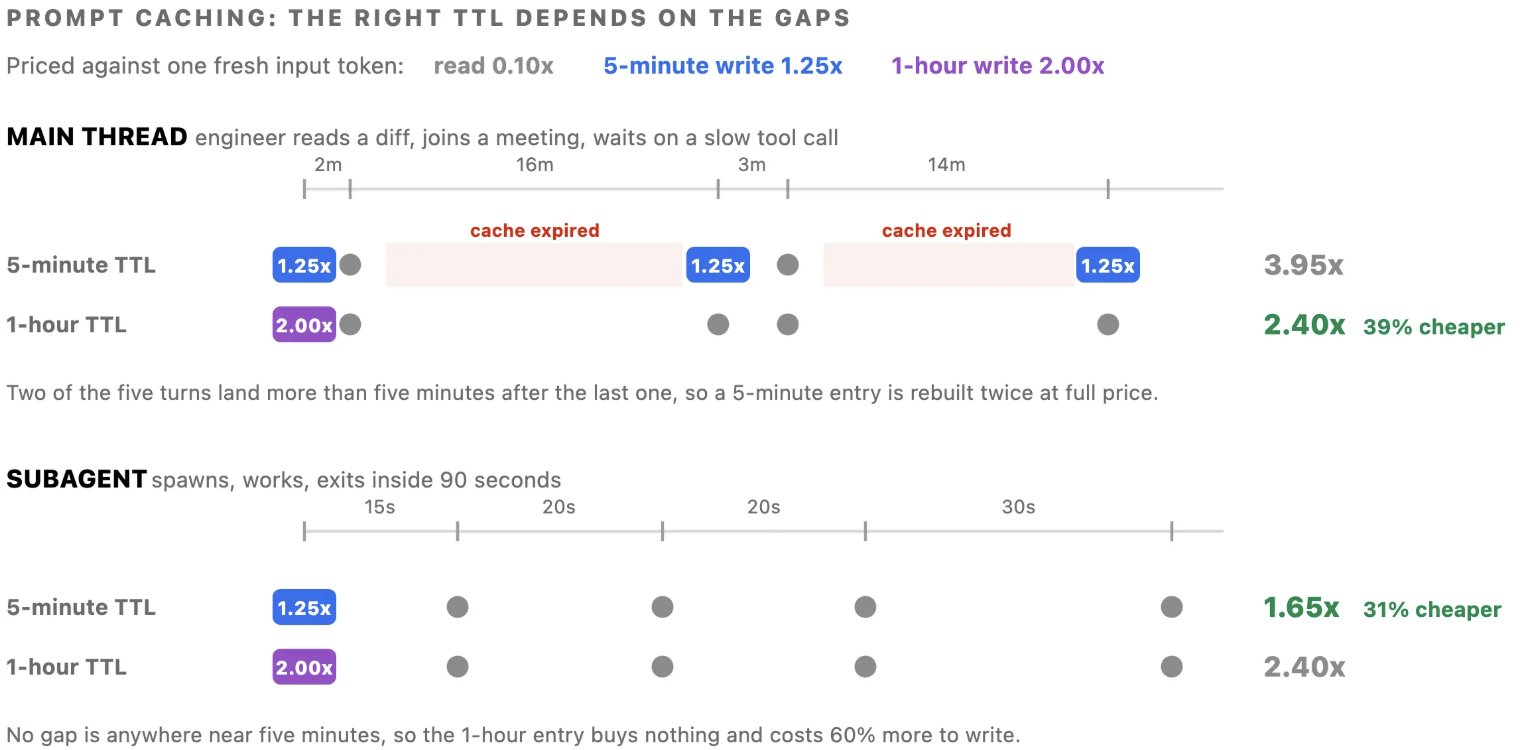
Prompt 缓存技术可以将后续轮次读取前缀上下文的成本降至标准输入价格的 0.1x(节省 90%)。然而,缓存写入并非免费:5 分钟 TTL 的写入溢价为 1.25x,而 1 小时 TTL 的写入溢价为 2x。
关键洞察:
- 交互式会话痛点:人类工程师在终端交互时,中途经常会开会、调试或思考超过 5 分钟。在 5 分钟 TTL 机制下,频繁的闲置导致缓存前缀过期失效,被迫频繁进行全额全价的 Context Rebuild。
- 决策:对人类交互式长会话全面启用 1 小时长 TTL 缓存窗口,消除长间隔带来的惩罚性重写;
- Subagent 隔离:由于子 Agent 是程序化连续短任务,因此维持 5 分钟短 TTL,最大化降低写入溢价。
3. 通过 Shell 执行 MCP 工具:终结 Schema 上下文膨胀
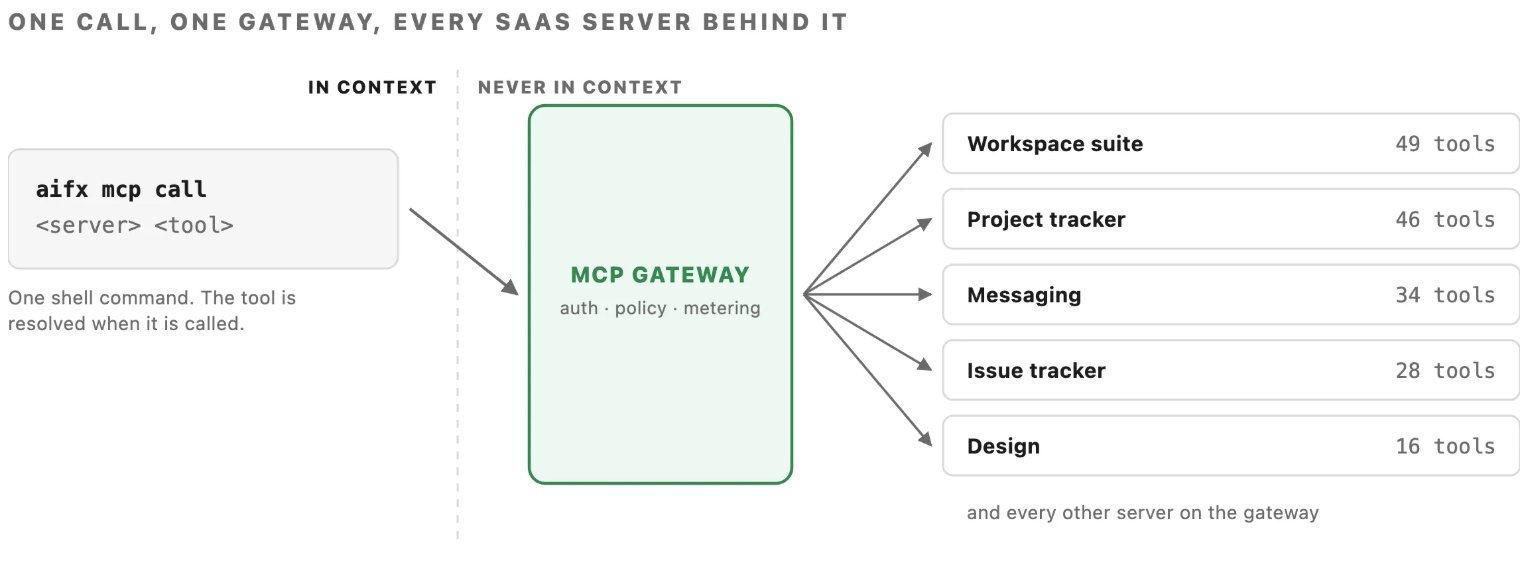
在 Uber 内部,所有 MCP(Model Context Protocol)交互均收拢在统一的内部网关之后,连接了超过 1,000 个内部与第三方 SaaS MCP Server。
传统 MCP 的致命缺陷:
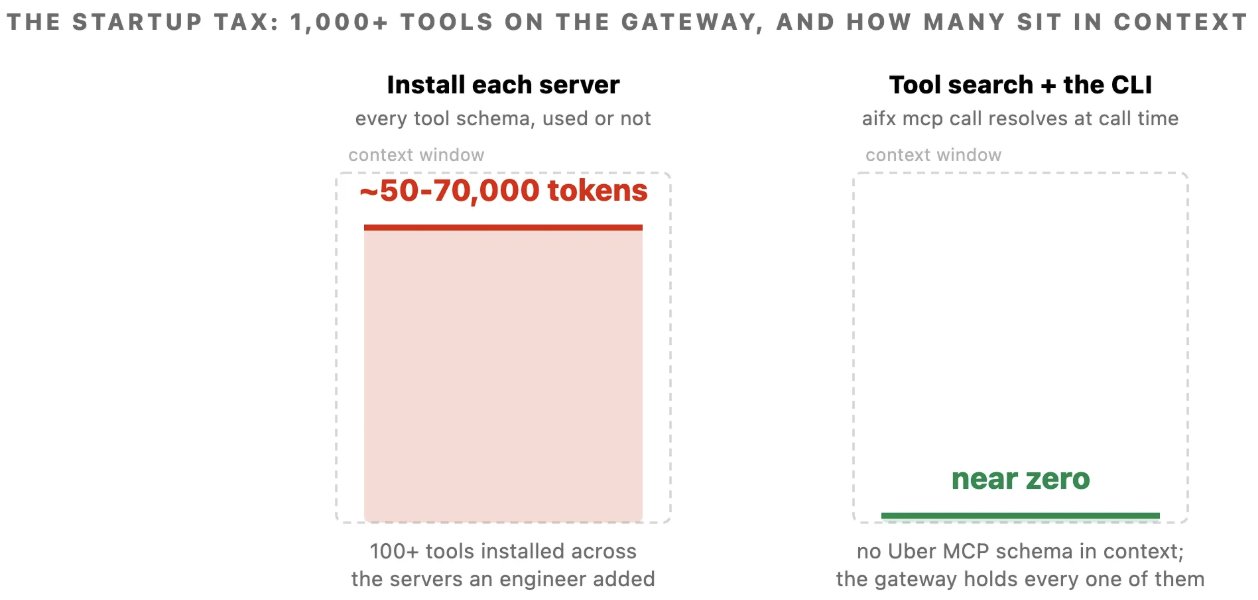
标准 MCP 协议会在会话初始化时,将所有已配置工具的 JSON Schema 完整硬塞进 System Prompt。当开发者配置了 100+ 个工具时,仅工具定义就会吃掉 50k ~ 70k Tokens,且在每一轮对话中都要被重复传输与计费!
Uber 的两项破局解法:
- CLI Tool Resolution(CLI 工具动态解析):
- 将内部 MCP 网关背后的 1,000+ 工具全部映射为标准 Shell CLI 命令;
- 模型无需提前感知 Schema,只需像程序员一样在终端调用命令行工具,CLI 会在调用发生时动态向网关发起请求,从 System Prompt 中彻底消除了 MCP Schema 负担。
- Tool Search(按需动态工具检索):
- 面对成千上万个工具,模型通过检索工具目录(Tool Catalog)仅在需要时动态加载对应工具定义,既彻底解决了上下文臃肿,又避免了可用工具过多导致模型选择幻觉的准确度下降。
4. Code-Mode(代码模式):消灭冗余多轮轮询
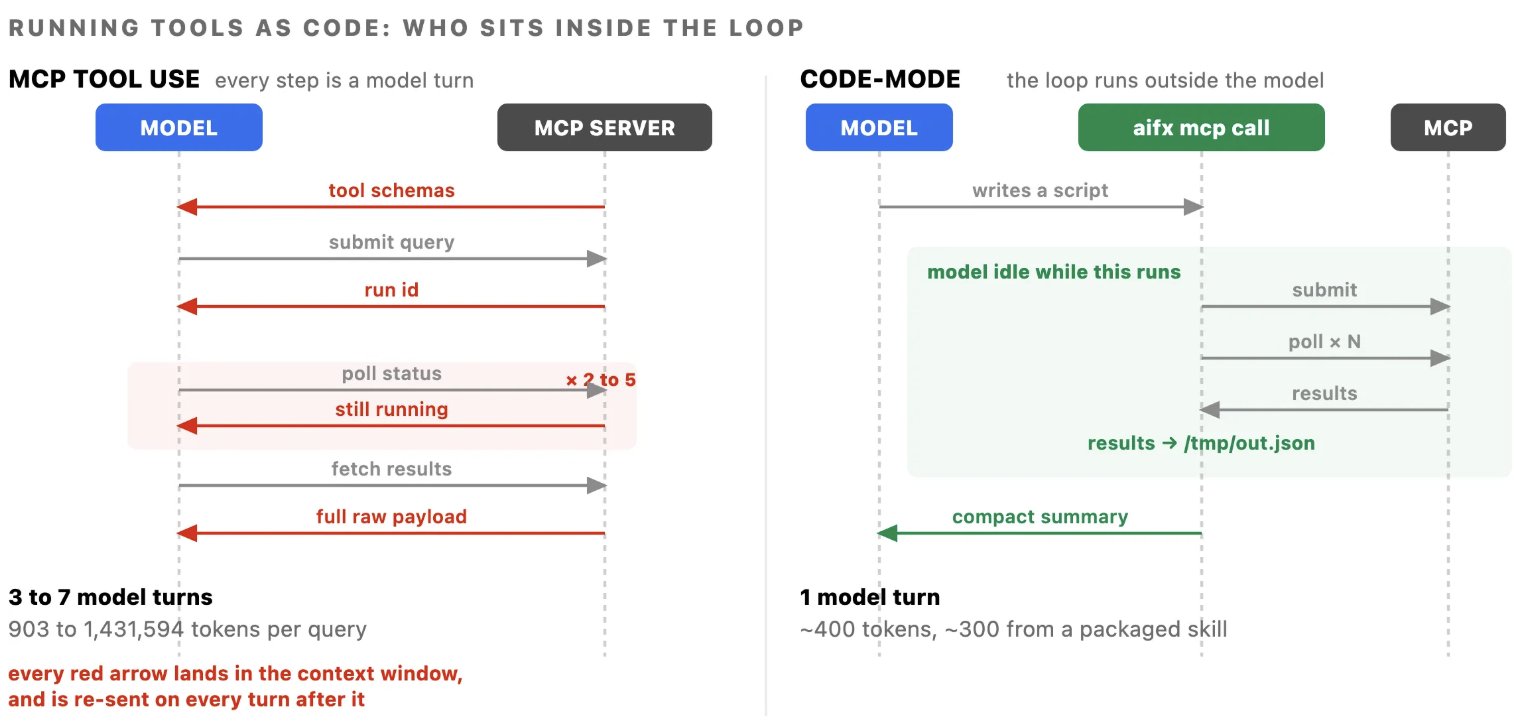
当工具可以通过 Shell 脚本直接执行时,模型就可以在单个 Python 脚本中批量组合多个操作(Batching Multiple Actions)。
传统 MCP 交互 vs Code-Mode 本地循环:
以执行一条数据仓库 SQL 为例:
- 传统 MCP:提交查询(1 轮) $\rightarrow$ 轮询状态 2~5 次(每次 1 轮模型交互,状态信息全部灌入 Context) $\rightarrow$ 获取数据(1 轮)。
- Code-Mode:模型生成一段带
while循环与轮询重试的本地 Python 脚本,由本地子进程(Subprocess)默默执行轮询,仅将最终的计算结果/精简摘要回传给模型!
实测对比数据:
在同一会话中执行 5 次相同 SQL 查询的基准测试结果令人震撼:
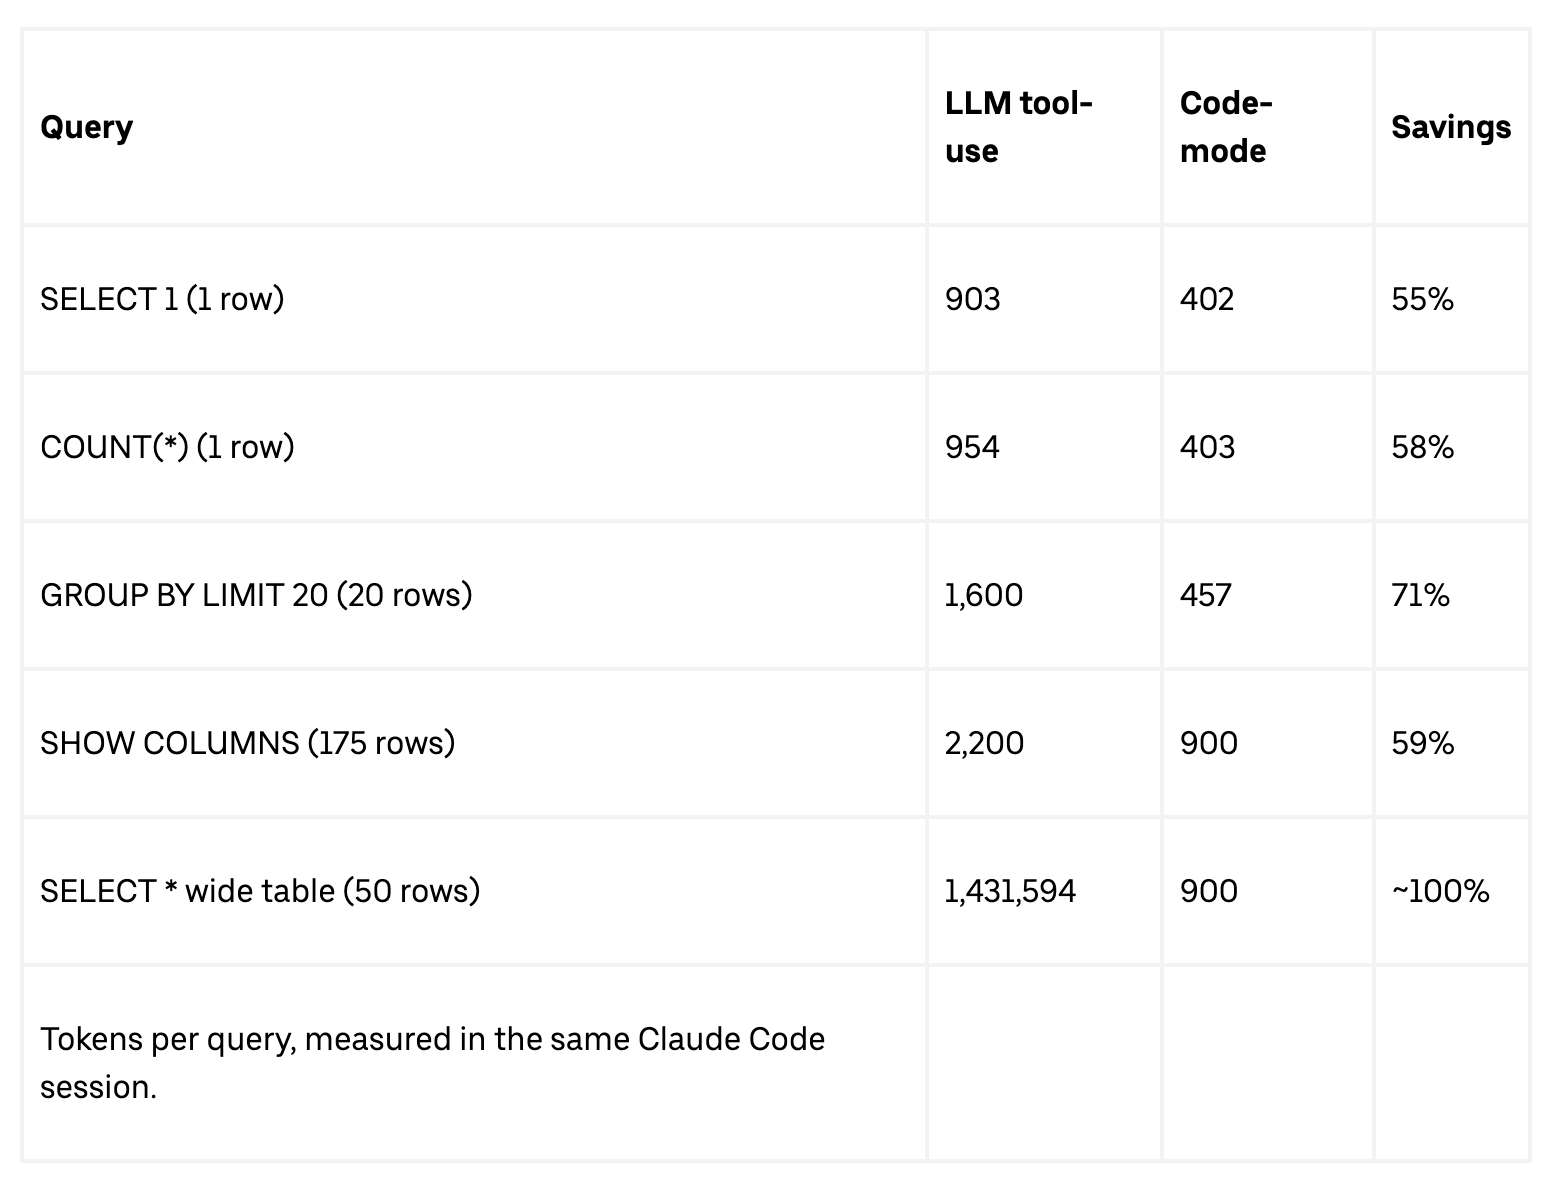
- 小结果集查询:即便数据量很小,Code-Mode 也能降低超过 50% 的 Token 消耗(省去了多轮 Schema 声明、多轮往返与无效的逐步推理);
- 批量工作流(Bulk Workflows):当原本需要 N 轮往返的循环被封装为单次脚本执行时,Token 节省幅度高达 90% 以上!
- Uber 已经为访问频次最高的 MCP 服务预制了超过 25 个开箱即用的 Code-Mode 插件技能。
5. SaaS MCP 的统一网关治理
第三方 SaaS 厂商开发的 MCP Server 往往包含过多通用功能(例如某协同套件单个 Server 就塞入 49 个工具,占用 22k Token Schema;通讯与项目追踪工具分别含有 34 和 46 个工具)。
Uber 将所有外部 SaaS MCP 全部收拢至内部统一的 MCP Gateway 之后,同样映射为 CLI 命令,并配合 Code-Mode 插件编写专用工作流 Skill,彻底激活了全司各类 SaaS 软件的极速 Agent 自动化。
07|杠杆三:优化 Requests / Turn(AI Context Graph 上下文图谱)
一个没有充足上下文「瞎子摸象」的 Agent 不会优雅地报错,而是会在无限膨胀的上下文里盲目搜索、四处乱撞。在任务初期提供高质量、结构化的上下文,是减少无意义探索轮次的最强杠杆。
AI Context Graph(AI 上下文图谱)
Uber 拥有数亿行代码库与数万张数据表。为了防止 Agent 陷入无休止的代码翻找,团队研发了 AI Context Graph:
- 包含 2,400 万个节点 与 8,000 万条边;
- 覆盖 86 种节点类型 与 117 种关系类型;
- 整合了全司 30+ 个内部核心系统(微服务拓扑、工程团队归属、故障复盘 Incident、PR 记录、架构设计文档 RFC、部署状态、数据集与历史表查询日志)。
实测震撼对比:
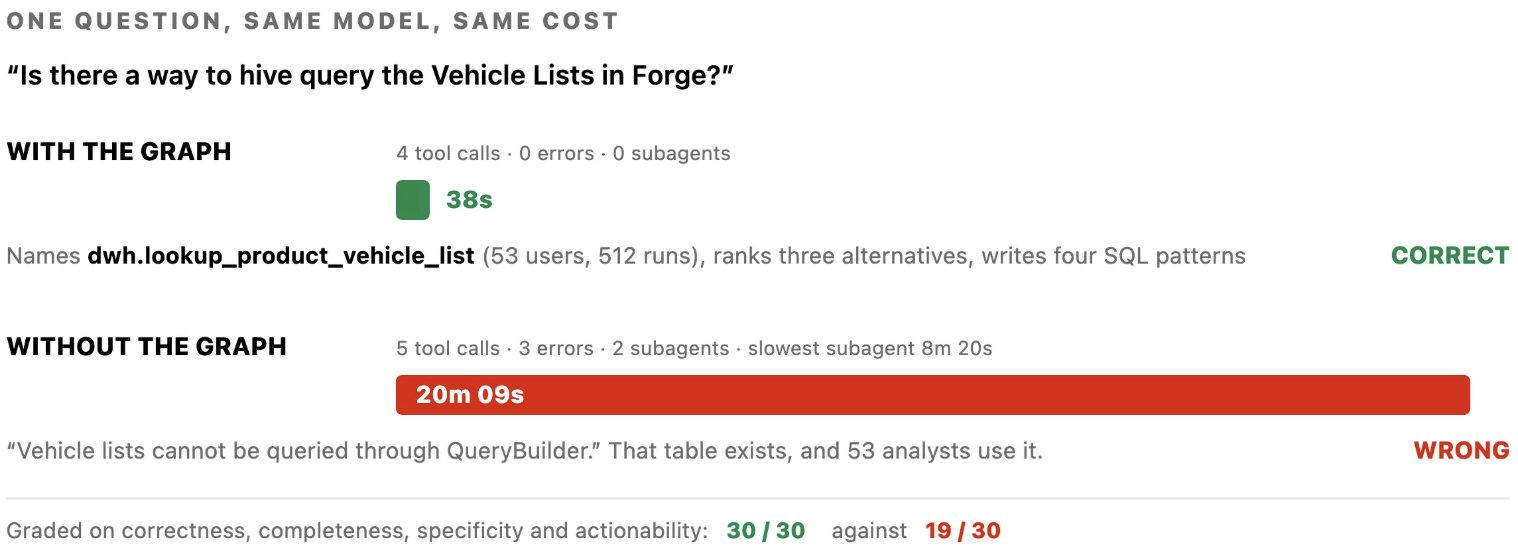
针对相同的一句业务提问:
- 接入 Context Graph 的 Agent:直接检索历史查询关系,精准定位到全司 50+ 分析师常用的目标事实表,耗时 38 秒直接给出完美结果;
- 未接入图谱的 Agent:在数万个微服务代码里地毯式搜索,派发了 2 个子 Agent,连续报出 3 个异常,耗费 20 分钟后给出了错误的结论(声称该数据不可查)。
08|开发者可见性与工程治理 (Visibility & Education)
降本增效不能依赖简单粗暴的硬性限额,而是要给工程师提供实时的透明度与正向反馈闭环。
五大工程治理手段:
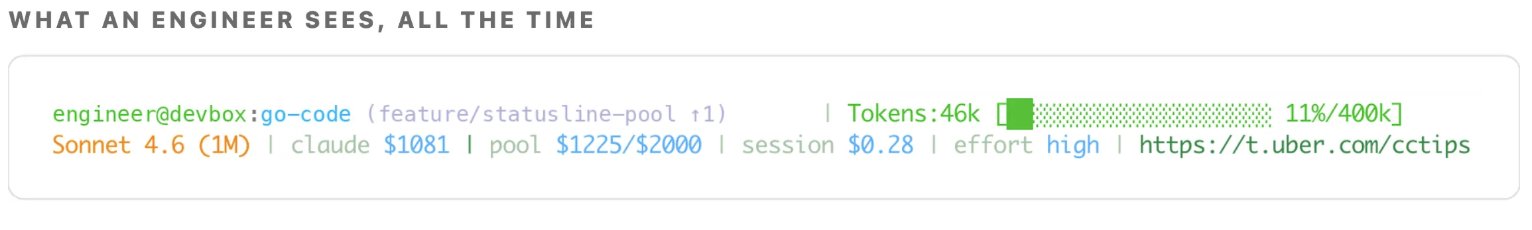
- Statusline 实时计费计数器:终端底部永远清晰展示当前会话花费与历史累计花费;
- Harness 共享资源池:全套交互式工具共享额度阶梯,托管 Agent 则拥有独立配额;
- Slack 梯度自动提醒:达到预期预算的 50% / 80% / 100% 时自动发送温和提醒;
- 轻量化升级审批流:经理一键审批即可无缝平滑扩容;
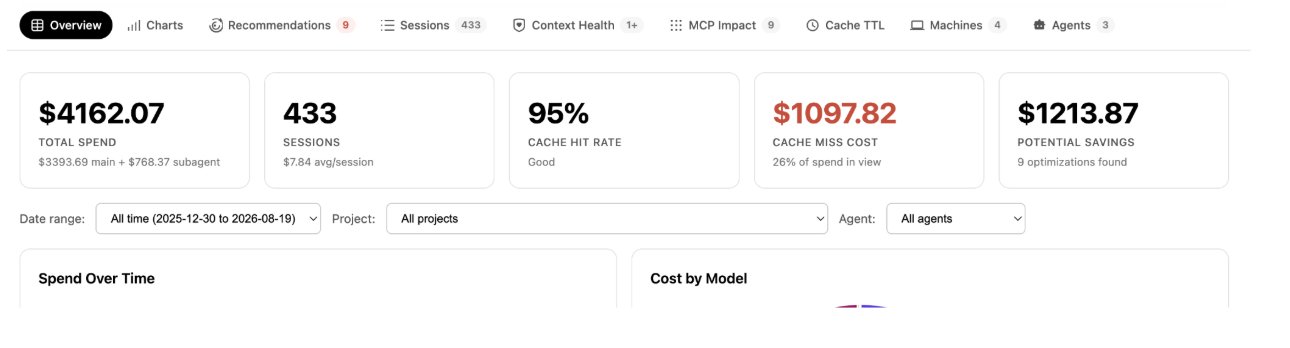
- Cost Dashboard 智能反模式体检:运行
cost dashboard技能,系统会自动分析该工程师在所有 Harness 和沙盒中的会话 Trace,智能诊断出 16 种典型浪费反模式(如用 Opus 跑简单多轮任务、MCP 巨额 Payload 残留、长暂停导致缓存击穿、初始 Prompt 塞入无用说明等),并给出具体的量化优化建议!
09|未来演进方向与结语 (What's Next & Conclusion)
Uber 软件工厂正在快速推进的五大前沿方向:
- 持续扩充全托管 Agent 舰队:为研发生命周期的每个环节打造专用 Benchmark,寻找 Pareto 最优模型;
- 动态模型路由(Dynamic Model Routing):将基准评测扩展到更多语言与复杂模态,实现请求级的智能动态分流;
- 深化 Context Graph 上下文图谱融合:让更多自主智能体直接具备图谱推理与自然语言查询能力;
- 会话分析升级为实时开发者效率教练:从事后批处理诊断演进为会话中的实时 Trace 监听与交互式建议;
- Skill 自动化持续自我演进(Continuous Skill Improvement):根据全司 Agent Skill 的物理执行报错痕迹,自动沉淀更新并演进 Skill 提示词。
💡 核心总结
控制飞涨的 AI 编码成本是一道极其清晰且完全可解的工程系统设计题。
通过消灭无效的、零价值的 Token 冗余消耗,而不是被动等待供应商降价或削足适履地降级开发者体验,Uber 在使用量爆炸式增长 7 倍的同时,成功将单次会话成本削减超过 52%。
最深远的战略转变,是从「散装的人机交互式终端」全面走向「体系化的全托管 Agent 软件工厂」。
优化一支拥有明确评测基准与 Pareto 最佳模型加持的专用托管 Agent 舰队,在成本效益和规模化能力上,远远超越了试图让成千上万名工程师在各自终端里摸索最佳 Prompt 的传统路径。