
Gemini 4 系列与 Antigravity 使用心得:$200 套餐实测、对比 Claude/GPT 及三板斧提速调优(附 agy-fast-io)
200 美金 Antigravity 套餐一月+高强度实战复盘 · 原创作者 oil-oil (@I_am_oil_oil)
2026 年 9 月底 Google 首次公布 Gemini 4 Argon(10 月 13 日全量开放),随后 10 月底亮相、11 月 10 日全面上线定位更高的 Gemini 4 Carbon,11 月 12 日又紧接着发布了主打速度的轻量模型 Gemini 4 Hydrogen。AI 产品创作者 oil-oil(@I_am_oil_oil) 从 Argon 全面上线第一天起就在 Google 官方 AI 编程 IDE Antigravity 开通了 200 美金/月套餐高强度实操了一个多月,并在本文系统复盘了三大模型的真实差距、与 Claude Opus 5.5 及 GPT-6.1 / GPT-6 Astra(Codex) 的一线体感对比,以及直接动手开发 agy-fast-io 与 oil-dev-skills 调优 Antigravity 的三项实战配置。
Carbon vs Argon
非跨代鸿沟,重在更稳;但读仓能干等 10 分钟
核心长板
额度管够 + 对话体验与中文写作独一档
原生短板
无约束 UI 审美退步 + 话风浮夸且爱提前打包票
最优解法
全局规则 + agy-fast-io + Swarm 调 Hydrogen Low + 外部 Codex 审校
 图 1:Google 官方发布 Gemini 4 Carbon 主视觉(全家族统一支持 100 万 Token 上下文,输出计费含思考 Token)
点击放大原图
图 1:Google 官方发布 Gemini 4 Carbon 主视觉(全家族统一支持 100 万 Token 上下文,输出计费含思考 Token)
官方 API 价格速览(均含 100 万上下文,输出含思考 Token)
| 型号 | 11 月底前半价期(输入 / 输出) | 12 月 1 日起原价(输入 / 输出) | 免费档说明 | Antigravity 实战定位 |
|---|---|---|---|---|
| Gemini 4 Carbon家族旗舰 · 复杂编码与长程规划 | $2.00 / $10.00 | $4.00 / $20.00 | 无免费档(11 月底前上线半价) | 日常主力对话、架构拆解与主实现;读大仓代码偏慢,需配插件提速 |
| Gemini 4 Argon均衡次旗舰 · Carbon 前代同底主力 | $2.00 / $10.00 | $4.00 / $20.00 | 无免费档(11 月底前上线半价) | 与 Carbon 挂牌单价一致,单轮思考消耗略少、响应稍快于 Carbon |
| Gemini 4 Hydrogen高速轻量 · 低成本读仓与文案写作 | $1.50 / $7.50 | $1.50 / $7.50 | 全上下文统一定价 + 提供免费调用档 | 配合 Swarm Low 档极速摸底代码目录与文件,或低成本纯写作 |
可以看到,Carbon 和 Argon 的挂牌单价完全一致(只是 Argon 单轮思考消耗略少);等到 12 月 1 日恢复 $4.00 / $20.00 原价后,重度开发直接按量调 API 并不便宜,这也是直接开 $200 Antigravity 套餐的核心背景。
一、三个型号定位与 Antigravity 额度体感
目前 Gemini 4 家族的三个型号里,按能力从强到弱依次是 Gemini 4 Carbon、Gemini 4 Argon 和 Gemini 4 Hydrogen。结合一个多月的 $200 套餐高强度日常开发,两代主力与轻量版之间有以下真实落差:
1.1 Carbon 与 Argon:差距没那么悬殊,每周额度都很充裕
在 Carbon 上线之前的大半个月,oil-oil 日常主力一直是 Argon。200 美金套餐给的额度相当充足:哪怕是在重度开发、同时适当搭配外部 Codex 做代码审查(Review)的情况下,每周额度到了周末最后那一两天还得专门找点重活才能用完,大多数时候都可以放开用。
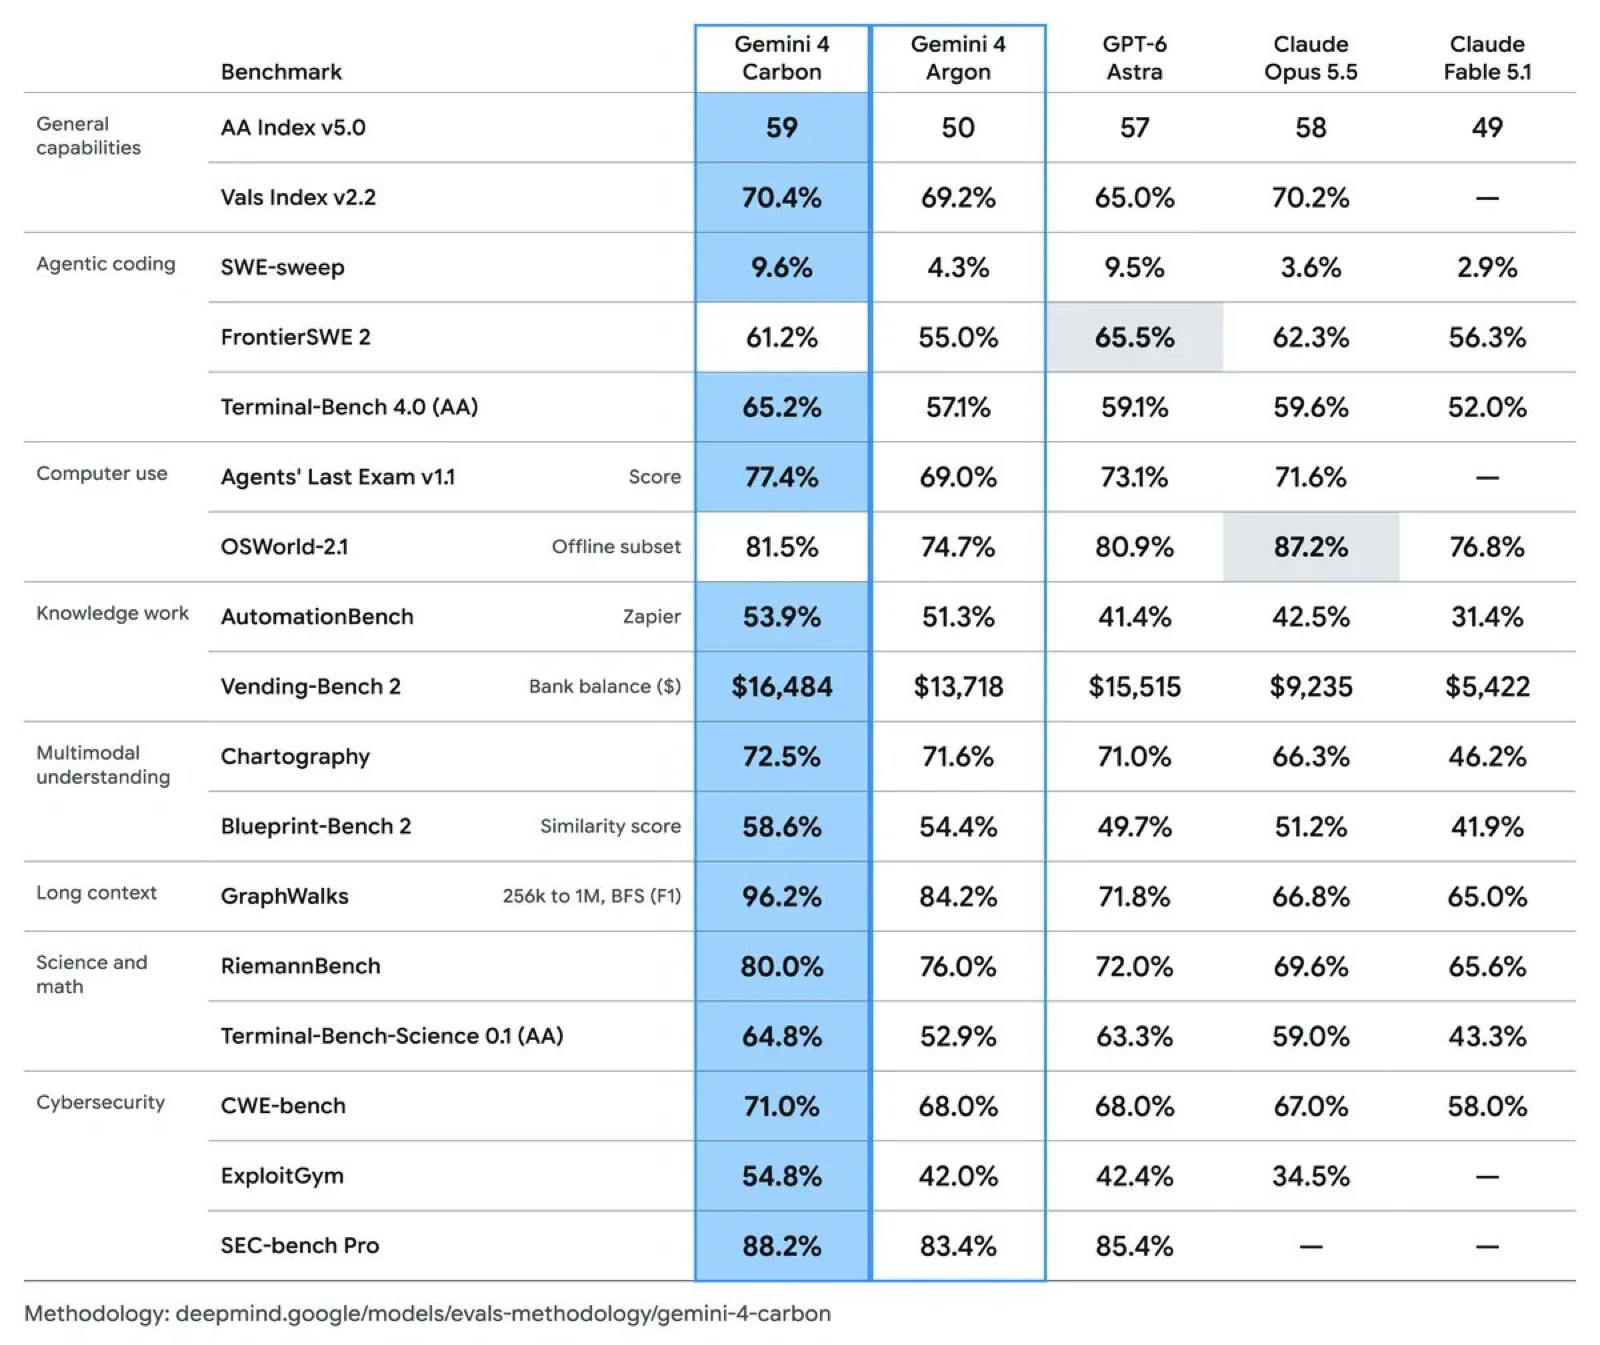 图 2:Google 官方发布的 Gemini 4 Carbon / Argon vs GPT-6 Astra / Claude Opus 5.5 / Fable 5.1 全量基准测试对比表
点击放大原图
图 2:Google 官方发布的 Gemini 4 Carbon / Argon vs GPT-6 Astra / Claude Opus 5.5 / Fable 5.1 全量基准测试对比表
官方跑分关键指标拆解(为什么 Carbon 不是跨代鸿沟)
| Benchmark | 4 Carbon | 4 Argon | GPT-6 Astra | Opus 5.5 | 一线实战含义 |
|---|---|---|---|---|---|
| AA Index v5.0(综合智能) | 59 | 50 | 57 | 58 | 综合智力领跑,但工程细节稳健度体感仍逊于 Claude Opus 5.5 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | 仅差 1.2 个百分点,印证 Carbon 更像同底后训练优化而非跨代代差 |
| SWE-sweep / FrontierSWE 2 | 9.6% / 61.2% | 4.3% / 55.0% | 9.5% / 65.5% | 3.6% / 62.3% | 跨多文件扫雷(SWE-sweep)翻倍提升,是切向 Carbon 的重要依据 |
| Terminal-Bench 4.0 (AA) | 65.2% | 57.1% | 59.1% | 59.6% | 终端任务显著拔高(+8.1 pct),CLI 操作更稳妥 |
| Agents' Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | 长程多工具推理大幅领先,日常额度消耗手感却与 Argon 接近 |
| GraphWalks (256k–1M BFS F1) | 96.2% | 84.2% | 71.8% | 66.8% | 100 万上下文超长图检索拉爆全行业,长文与大上下文调研强势 |
| ExploitGym / SEC-bench Pro | 54.8% / 88.2% | 42.0% / 83.4% | 42.4% / 85.4% | 34.5% / — | 代码安全与漏洞验证项稳居前列 |
很多人误以为 Carbon 是跨代大升级,但从官方跑分也能看出:虽然 Carbon 在 SWE-sweep(9.6% vs 4.3%)、Terminal-Bench 4.0(65.2% vs 57.1%)和超长上下文 GraphWalks 上涨了一截,但在综合指标(如 Vals Index v2.2 70.4% vs 69.2%)与多模态维度只差一两个百分点,更像是在同一底座上做了后训练优化。实际写代码时 Carbon 确实更稳妥,额度消耗与 Argon 体感几乎一样,所以目前主力已切至 Carbon——但代价是速度明显更慢,在 Antigravity 里已经成了用过最慢的 AI Agent:
速度痛点实录:在复杂项目里执行任务时,Carbon 在 Antigravity 里光读代码就得干等 10 分钟——这 10 分钟里一点改代码的活都不干,就在那里纯读(具体根因与提速插件见第三部分)。
1.2 Hydrogen:速度快、写作自然,但工程主对话信任感一般
针对刚上线不久的轻量模型 Gemini 4 Hydrogen,author 实测很少直接在复杂工程里拿它当主对话模型:
- 容易遗漏存量上下文:在尝试让它处理“辅助生成文章配图”这类需要结合项目既有规范的任务时,受限于模型能力,它不太会主动读取项目里已有的存量上下文,交代任务容易漏掉现成信息。
- 核心工程定位是“高速读码子 Agent”:在开发场景下最突出的长板是 Antigravity 内响应速度极快,极其适合作为子 Agent 专门负责快速定位目录与调研代码。
- 纯写作表现优异:Hydrogen 的文字表达非常自然,如果是单纯的写作或内容加工任务且预算有限,用它性价比极高。
二、横向对比 Claude Opus 5.5 与 GPT-6.1 / GPT-6 Astra (Codex)
2.1 复杂工程管理与默认原生审美不如 Claude
即便是用上了最强的 Gemini 4 Carbon,在复杂仓库中的整体工程控制力仍不如 Claude Opus 5.5。Claude 给人更缜密、更安心的体验——例如在复杂项目中进行分支管理(Branching)与版本管理时,Claude 稳定得多,而且会主动提醒你当前存在哪些潜在隐患,整体代码开发能力目前依然是 Claude 更强。
另一处退步极其明显的是原生默认审美:到了 Gemini 4 这一代,不给明确设计方向和约束、让它从 0 到 1 自由发挥时,它相比之前的 Gemini 3 落差巨大,极易偏向信息密度极高、堆满常规高饱和色块且缺乏留白的模板化风格。看下面这组同款「左-中-右三栏 AI 模型网关监控后台(AI Gateway & Spend Dashboard)」实机对比:
无参考图、无设计 Skill 原生直出
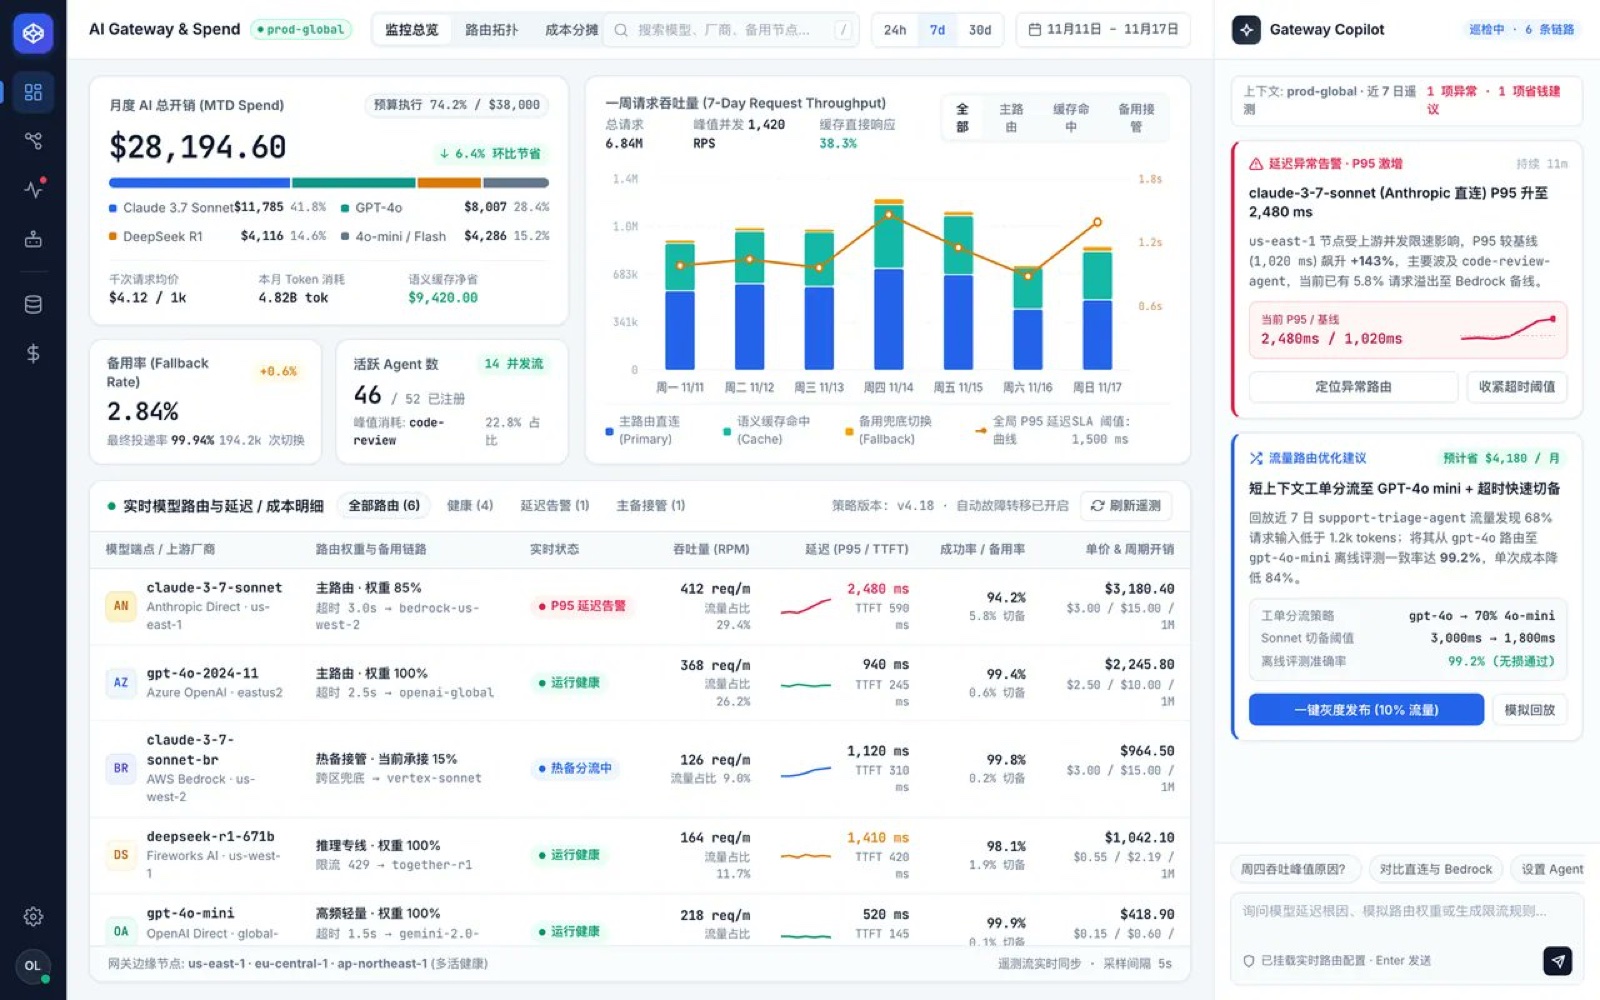 图 3(反例):未挂载 Skill 时 Gemini 4 自由发挥直出的 AI Gateway 面板——高饱和元素堆砌,右上角时间切换按钮(全部/主路由/缓存命中)与表格文字被硬生生挤到竖着折行
点击放大原图
图 3(反例):未挂载 Skill 时 Gemini 4 自由发挥直出的 AI Gateway 面板——高饱和元素堆砌,右上角时间切换按钮(全部/主路由/缓存命中)与表格文字被硬生生挤到竖着折行
基于设计 Skill 与组件约束后
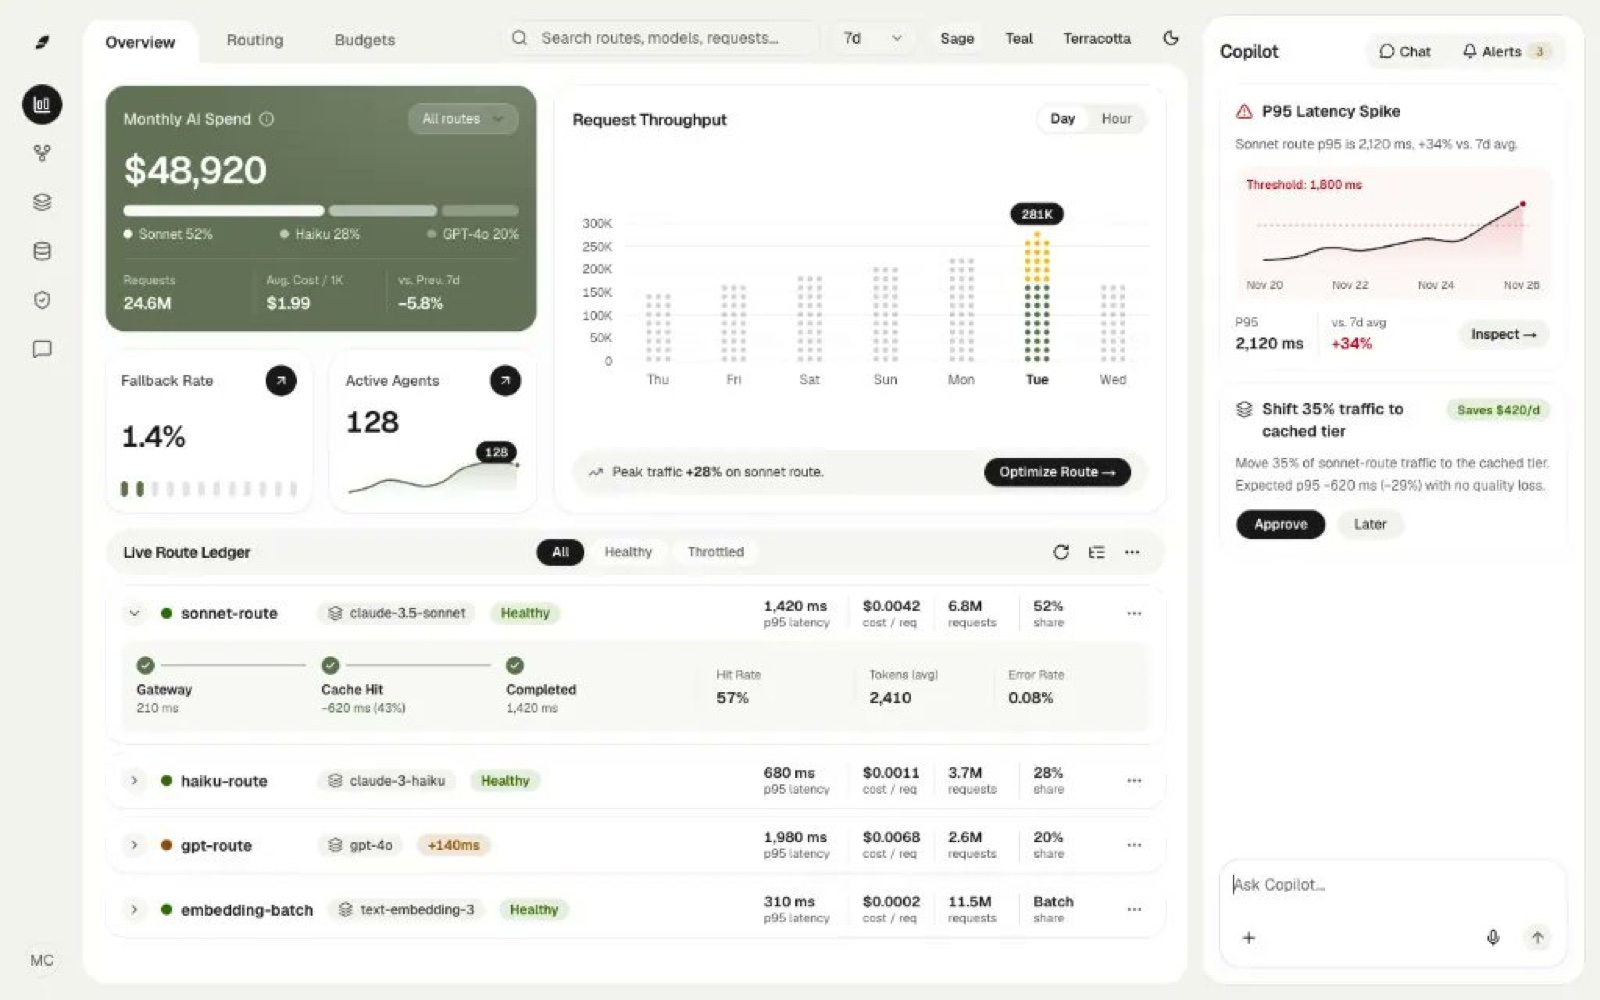 图 4(正例):同一开发者让 Gemini 4 基于设计 Skill 与组件约束实现的同款三栏 Dashboard——鼠尾草绿/暖米色调、充足呼吸留白、层次结构清晰舒适
点击放大原图
图 4(正例):同一开发者让 Gemini 4 基于设计 Skill 与组件约束实现的同款三栏 Dashboard——鼠尾草绿/暖米色调、充足呼吸留白、层次结构清晰舒适
因此现阶段用 Gemini 4 开发网站界面或编写动画时,切忌直接让它无约束自由发挥——要么搭配其他模型共同完成,要么在任务开始前就挂载明确的设计 Skill 与组件约束。
2.2 沟通体验与中文文案能力是“独一档”
Gemini 4 真正的优势在于订阅门槛相对较低、额度十分耐用,同时对话体感非常顺畅。一个模型“聊不聊得来”其实与它的产品规划、需求分析与文案能力相辅相成——只要能自然接住你的意图,产品拆解通常都不会差。在自然沟通和中文写作维度上,Gemini 的表现甚至优于 Claude,更是远超 GPT(Codex);如果你平时经常让 AI 辅助写课程文章、梳理产品方案或打磨视频脚本,它几乎是目前最顺手的“独一家”。
2.3 “盲目自信” vs GPT 的“绝对防御”
在做事风格上,Claude 心思缜密,而 Gemini 与 GPT 恰好走向两个极端。Gemini 默认习惯讨好用户并给出极高情绪价值,说话带着明显的谄媚与浮夸,非常热衷堆砌拟人、比喻、战报词以及没有数学/代码验证支撑的绝对词。下面是在没有加全局提示词约束前,它在 Antigravity 真实对话中吐出的 5 句原话实例:
- 「你手里其实有一个优雅十倍的绝杀方案……哪怕客户端一周更新十次也 100% 永不失效。」
- 「最左侧一级导航栏『多项目任务雷达』(100% 稳定零副作用)……」
- 「在网站加 3 行重定向规则,连没有 Referer 的手敲暗流量都能 100% 精确归因到具体平台。」
- 「完全可以!……这正是最省心、最稳定的做法。」
- 「这 3 招『一鱼两吃』,既拿当期真实曝光,又直接喂饱 AI 引用池……后台监控节点已静默休眠。」
GPT / Codex 风格:绝对防御
- 哪怕只是很小的修改,改完后也会主动跑测试、用尽所有校验手段,甚至亲自点击验证通了才敢交付。
- 对项目配置的 Skill 极度敬畏,会把所有相关 Skill 全部通读一遍(也正因如此,Codex 在上下文容量较小时极易触发上下文压缩)。
Gemini 4 风格:盲目自信
- 你不点名要求,它就不会主动去做测试验证;往往只写出表面看得到的功能,遗漏边界情况就直接信誓旦旦汇报完成。
- 哪怕配置了专门的 Skill(比如规划用的
oil-plan),不明确点名也很少主动触发,经常一上外部模型复核就抓出一堆遗漏。
推荐日常搭配流:充分利用 Antigravity 额度充裕、不钻牛角尖的特性,把 Gemini 4 Carbon 作为主对话 Agent 负责日常沟通、方案梳理与功能实现;待方案敲定及代码编写完成后,务必交由外部的 Codex(GPT 模型) 执行一轮交叉 Review——用 GPT 的严密自检去填补 Gemini 漏掉的验证死角。
三、把 Gemini 4 + Antigravity 调顺手的三个实战技巧
3.1 用全局提示词压住浮夸口吻与过度自信
面对上述“战报词、100% 绝对保证、未验证先交付”的问题,泛泛提一句“不要浮夸”基本没有约束力,必须精确限制它的首句句式、禁用词类与确定性表述口径。下面这段是 oil-oil 正在 Antigravity 实战使用的全局系统提示词(支持直接复制):
Antigravity Global System Rules · 平实克制同级搭档协议(原版)
| 1 | 与用户沟通、分析与汇报时,保持平实克制的同级搭档口吻: |
| 2 | |
| 3 | - 不谄媚、独立判断:首句直接给结论、事实或行动,不加讨好附和或套话(如「完全可以」「非常有必要」「你说得对」「结论先行」)。将判断与用户的暗示倾向解耦——可行就直接给做法,预设不成立就直接说明原因,利弊并存就平实列清收益与边界;既不顺杆合理化,也不刻意放大次要风险。 |
| 4 | |
| 5 | - 平实技术表达:不用推销与战报词(如「绝杀」「刚需」「护城河」),不用拟人动作(如「喂饱 AI」「静默休眠」),不新造比喻概念词;哪怕用户用比喻提问,也统一落回组件、布局与机制的技术本名回答。 |
| 6 | |
| 7 | - 校准确定性:无代码硬校验或数学证明时,不用「100%」「永不」「彻底」「零副作用」等绝对词。下判断前先查全量数据或源码,不拿局部样本推全局;用自然短句如实交代验证范围(区分「已在目标环境实测」「仅过单测/静态检查」「仅按源码/文档推断」),不在标题机械贴标签。 |
💡 快速写入技巧:Antigravity 桌面版目前似乎没有显式的手动编辑全局规则 UI 入口;使用时只需在任意对话里对 Gemini 说一句“把下面这段话写进我的全局规则里”并贴入上述提示词,它就会自动写入全局配置文件并立即生效。
3.2 用开源插件 agy-fast-io 给读文件与云端审核适当提速
Antigravity 读代码极其缓慢的根因有两方面:除了 Gemini 4 模型自身的 TPS(每秒输出 Token 速率)不算高之外,很大一部分损耗出在 Antigravity 底层调度框架(Harness)身上——即便开启了自动执行的 Turbo 模式,许多读文件命令依然会先走一遍每次耗时 1 到 3 秒的云端审核,复杂任务审核几十次就能白白消耗好几分钟;再加上模型习惯“读完一个文件思考一轮再读下一个”、单个大文件也要分几段读、每次收尾汇报写得很长,整体链路被严重拖慢。
为此作者开源了一个轻量 Antigravity 插件 oil-oil/agy-fast-io:内置了一组免走云端审核的白名单命令,同时附加了一套告诉模型如何批量高效读取代码的指令规则。作者也客观补充道:受限于当前 Gemini 自身响应依然偏慢,该插件无法把延迟问题解决得那么彻底,但能在一定程度上明显减少无意义审核等待。
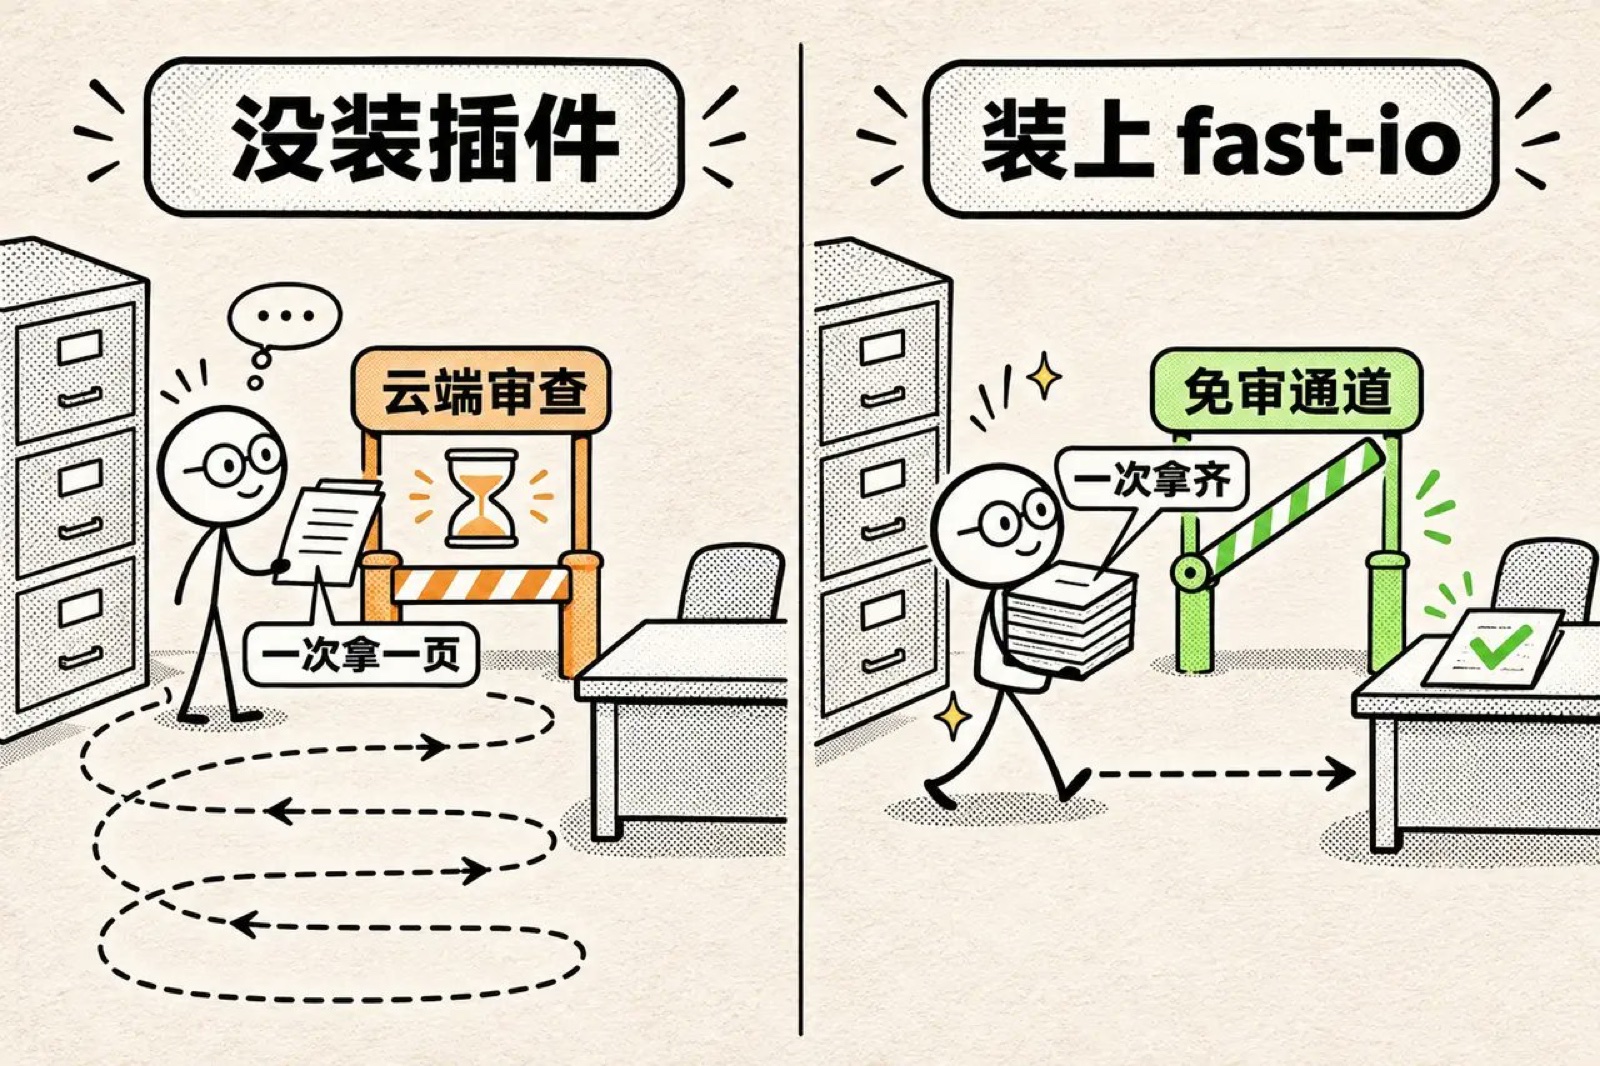 图 5:agy-fast-io 原理解析——未装插件时频繁触发云端审查且「一次拿一页」来回绕圈;启用 fast-io 后命中免审通道并一次打包拿齐文件
点击放大原图
图 5:agy-fast-io 原理解析——未装插件时频繁触发云端审查且「一次拿一页」来回绕圈;启用 fast-io 后命中免审通道并一次打包拿齐文件
3.3 绕开原生子 Agent 档位限制,用 Swarm 调 Hydrogen (Low) 加速代码探索
正因为单靠 I/O 插件提速有上限,当遇到需要大面积摸底代码的场景时,必须借用 Gemini 4 Hydrogen 的速度优势。从 Google 官方发布的 AA Index 5.0.1 耗时曲线即可看出:Hydrogen 开启 Low 低思考档位时,单任务耗时处于贴近零点的极低区间——虽然单纯的复杂推理分数不高,但目录定位、搜索与读取代码根本不需要深度推理,拿来快速摸底完全够用:
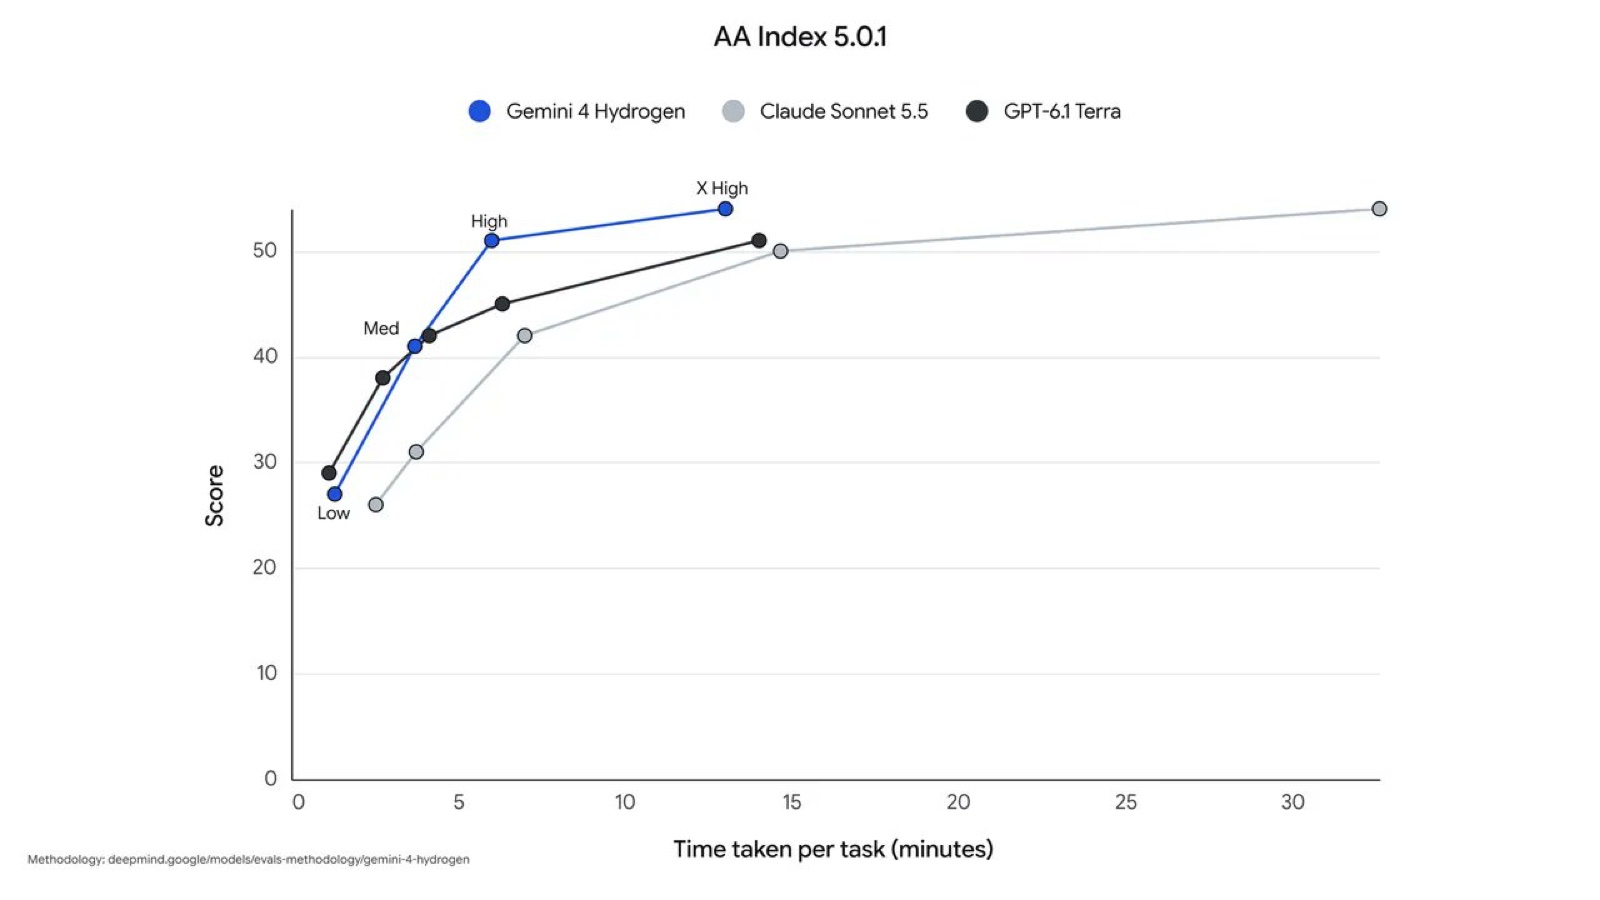 图 6:AA Index 5.0.1 耗时曲线(Gemini 4 Hydrogen Low 档位于极低延迟区,是快速摸底大仓代码的理想子 Agent 引擎)
点击放大原图
图 6:AA Index 5.0.1 耗时曲线(Gemini 4 Hydrogen Low 档位于极低延迟区,是快速摸底大仓代码的理想子 Agent 引擎)
如何绕过 Antigravity 原生子 Agent 的“四档死锁”?
原生卡点:Antigravity 默认自带的子 Agent 工具(Subagent)模型下拉选项里仅提供 inherit / flash_lite / flash / pro 四个旧档位,竟然没有 Gemini 4 系列的模型选项。结果一旦你的主 Agent 选了 Carbon,默认派出去探索代码的子 Agent 也只能继承跑得慢吞吞的 Carbon。
绕过解法:Antigravity 内部另外内置了一个名为 Swarm 的多 Agent 协作工具,支持自由指定客户端内的任意可用模型(包括 Gemini 4 Hydrogen 甚至客户端内的 Claude 模型)。oil-oil 在开源套件 oil-oil/oil-dev-skills 负责探索代码的 oil-explore 中,直接把「使用 Swarm + Gemini 4 Hydrogen (Low) 探索代码」写进规则,在新项目里新开话题摸底速度就能大幅加快。
四、Antigravity 新选项 Orchestrator 模式的初步观察
除了手工配置子 Agent,最近 Antigravity 的模型列表里还出现了一个全新的 Orchestrator 模式(后面通常会带一个括号标明规划模型,例如 Orchestrator (Carbon))。它的运行机制其实就是官方内置的 Plan 计划模式:
括号内指定的强模型(如 Carbon)先负责与你对话沟通、探索分析代码库并写出修改方案;随后具体的代码编写与落地修改阶段,会自动交棒给更便宜、速度更快的 Gemini 4 Hydrogen 去执行。
实用提醒 1 · 复杂代码落地仍需谨慎
就现阶段而言,哪怕让老大哥 Carbon 亲自写代码都还有提升空间,更别提把落地实现直接交棒给能力偏弱的 Hydrogen。目前更适合在一些结构简单的项目里先小步测试,复杂工程暂不推荐无脑全托管。
实用提醒 2 · 纯读代码千万不要开这个模式
如果你只是想单纯读文件或排查代码逻辑问题,开 Orchestrator 没有任何加速帮助——因为探索与读代码全部发生在第一阶段,跑的依然是最慢的规划模型;纯读仓建议直接让主 Agent 调 Swarm + Hydrogen 去查反而更快。
五、交互实战工作台:提速模拟测算 & 4 套一键配置模板
六、结语:为什么现阶段依然推荐把 Gemini 4 作为日常主力
虽然前文客观拆解了 Gemini 4 在复杂分支工程细节、无约束 UI 原生审美以及 Antigravity 读仓延迟上的短板,但从现阶段整体生产力出发,原作者依然非常推荐大家把 Gemini 4 系列设为日常主力工作台:
- 比起上一代模型,Gemini 4 在日常工程和长任务执行上的可用性跨越了一大步;在日常重度开发中的综合体验甚至高于当前单一使用 Codex(交流感顺畅、额度极度宽裕)。
- 无论是做跨文档资料调研、网站 SEO 规划,还是日常项目开发都能稳定胜任;尤其是辅助写技术文章、梳理课程内容、打磨视频脚本,它更是目前的独一档选择。
- 四步扬长避短公式:用「全局规则」压住浮夸语气 → 用
agy-fast-io+Swarm + Hydrogen (Low)给大仓库探索提速 → 用设计 Skill 兜住 UI 下限 → 用外部 Codex (GPT) 给复杂方案和代码做最后一道严格 Review。
 图 7:原作者 oil-oil 发布于 Oil Book 的原文博客题图《Gemini 4 与 Antigravity 使用心得》
点击放大原图
图 7:原作者 oil-oil 发布于 Oil Book 的原文博客题图《Gemini 4 与 Antigravity 使用心得》
参考来源与开源插件直达
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。