
高拟真数字人口播实战指南:声音克隆与画面驱动解耦流程
AI Agent 自动化口播工作流MiniMax TTS + HeyGen + Codex Skill112.2 万+ 阅读
99% 的人没看出来的数字人口播实战攻略
昨天发了一条数字人讲 FDE 的口播视频,很多读者看完都不敢相信这是数字人生成的。本文拆解如何把“声音克隆与画面驱动拆开”,并封装成可直接复用的 $rachel-digital-human-production Codex Skill。
R
Rachel🥥 @Zesee
发布于 2026 年 7 月 16 日 19:53(UTC+8)
112.2W 4,174 1,994 381 77
GitHub: rachel-digital-human-production · 查看 X 原帖
 99% 的人没看出来的数字人口播实战攻略
点击放大
昨天发完那条讲 FDE 的数字人口播视频后,评论区很多人以为是真人出镜。我已经把整套数字人口播制作流程打包成了一个可复用的 Codex Skill。
GitHub 仓库:https://github.com/Jingyi-Wu-Richael/rachel-digital-human-production
最终跑通的 7 步工作流:
- 素材检查2. MiniMax 生成配音3. HeyGen 15 秒样片4. 人工确认5. HeyGen 完整版6. 下载验片7. 状态归档
这套方案适合知识口播、短视频批量生产、课程讲解、产品介绍、多语言内容和固定 IP 数字人账号。
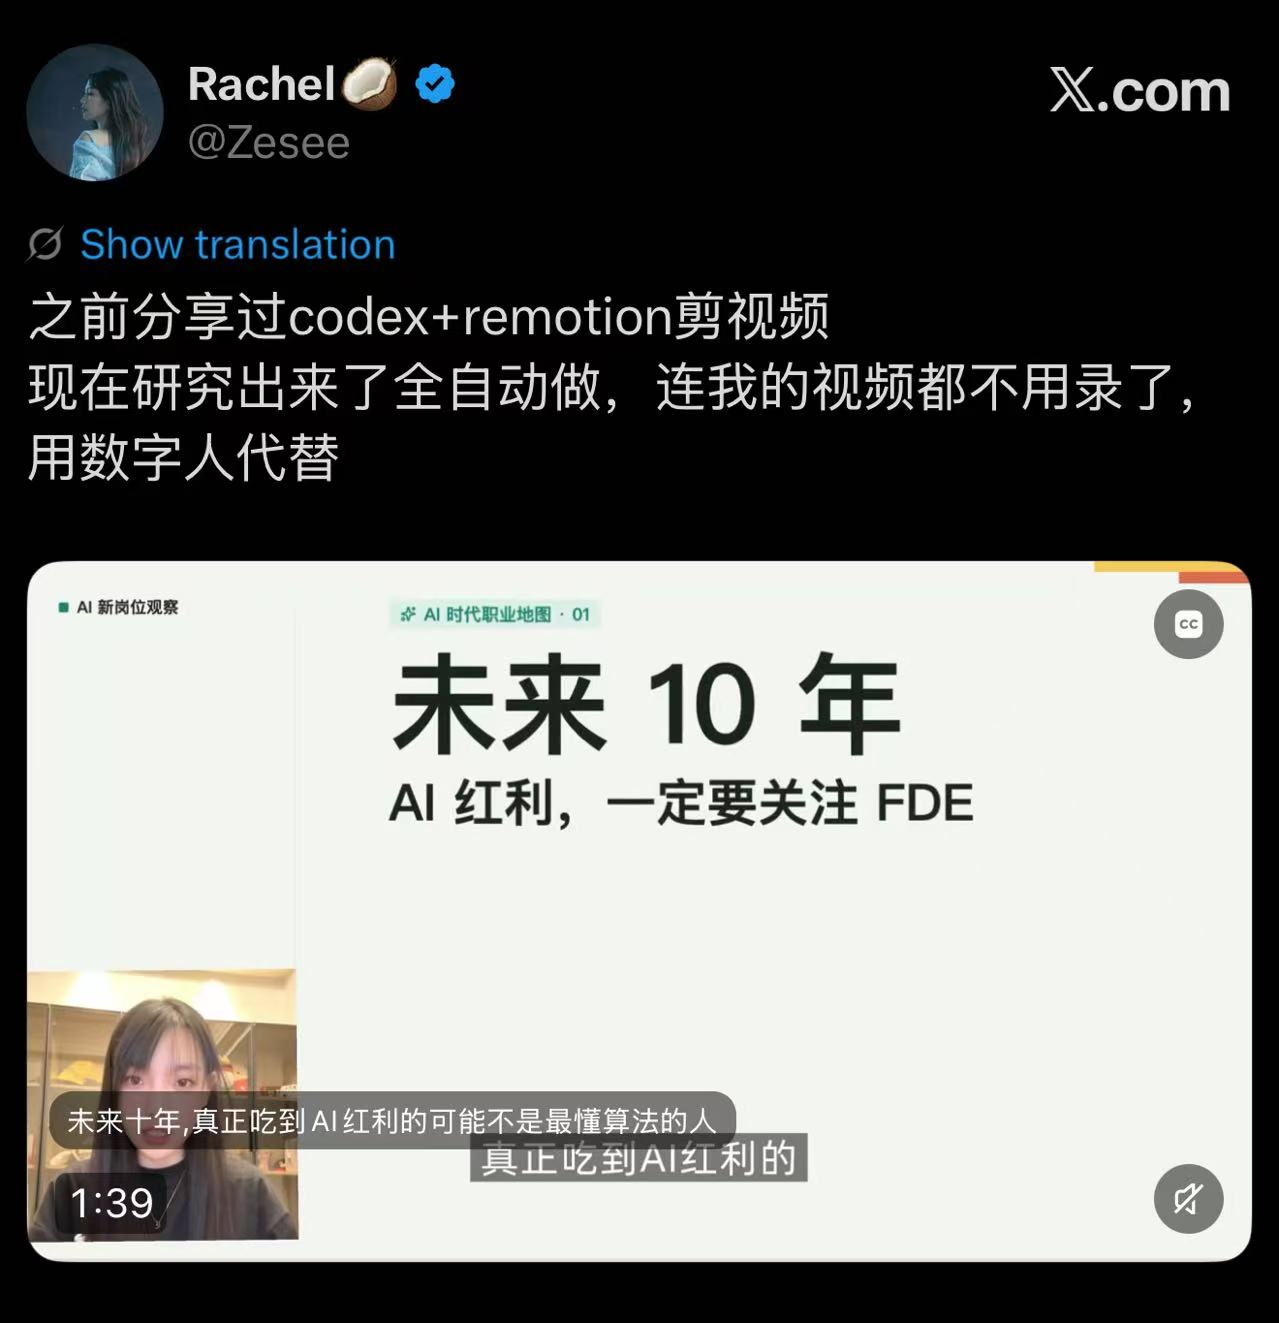 图 1A:用 Codex、Remotion 和数字人自动生成的 FDE 口播成片画面
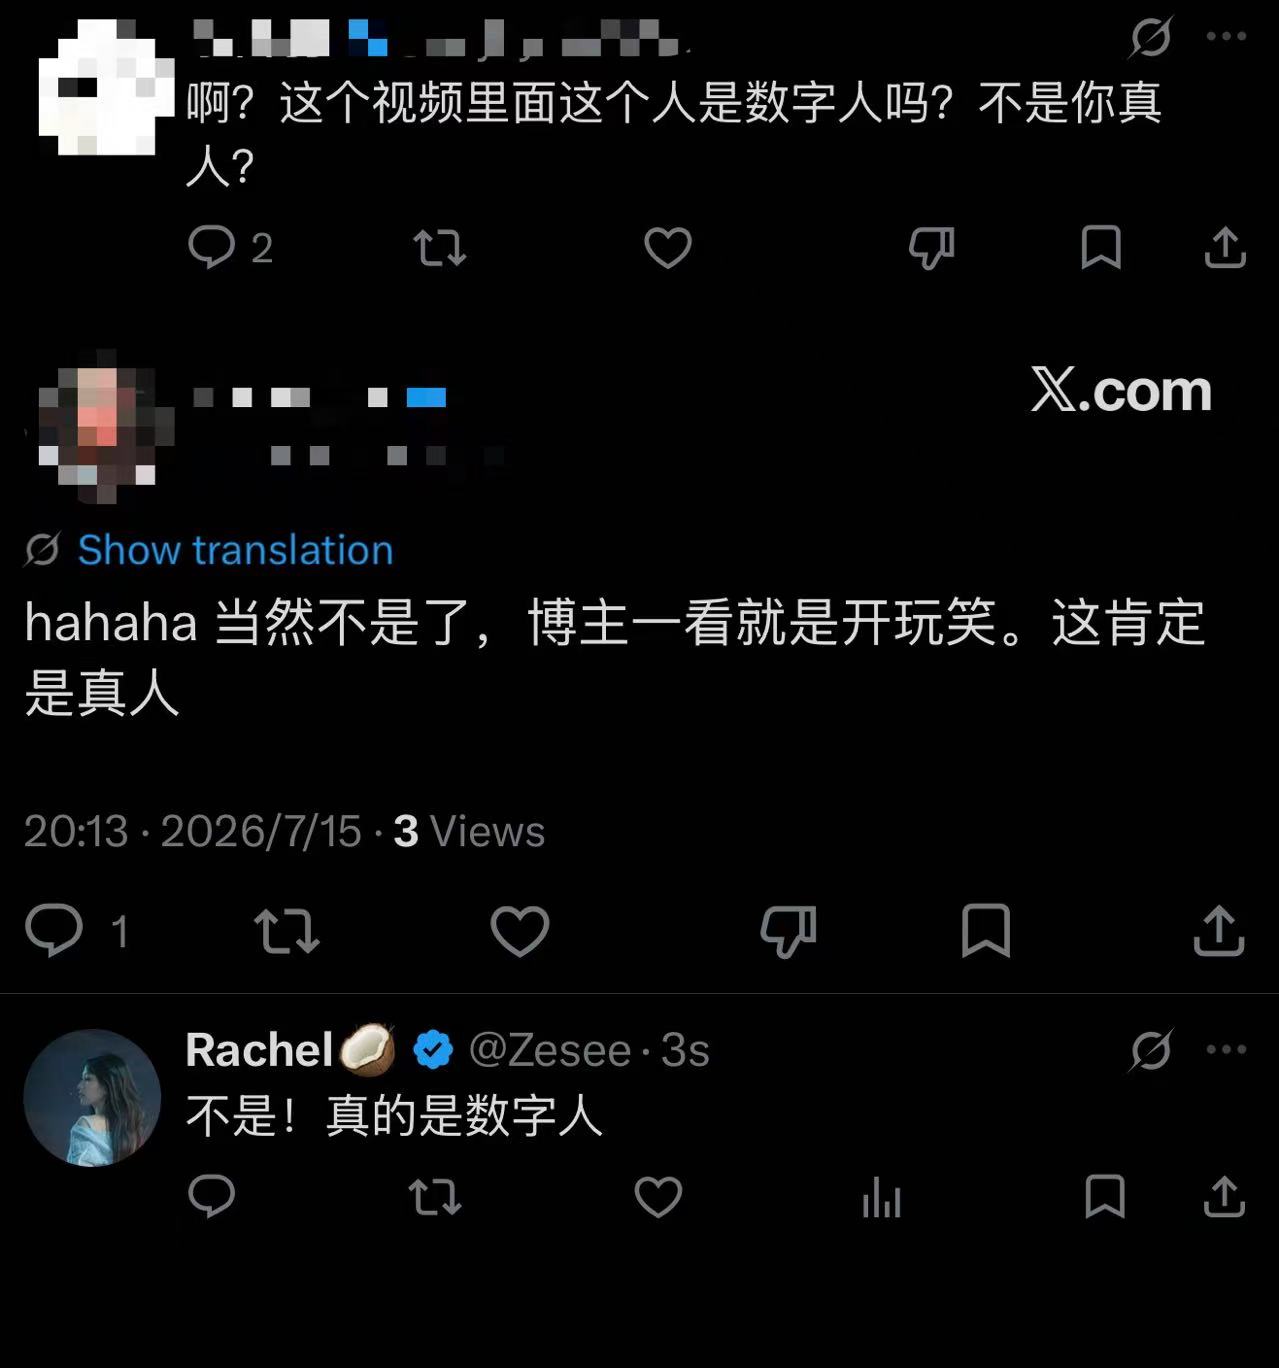 图 1B:评论区读者误以为是真人出镜的互动反馈截图
01一、整条流程怎么分工
这套方案的核心做法是把声音和画面拆开。
MiniMax
负责声音克隆和 TTS,生成还原真人语气与音色的 MP3 音频。
HeyGen
负责人像画面驱动,同步口型、表情和肢体动作。
Codex
负责检查素材、编排调用顺序、记录任务状态和控制扣费风险。
完整执行步骤:
- 准备真人录音,用 MiniMax 海外版克隆声音。
- 把文案交给 MiniMax TTS,生成克隆音色的 MP3。
- 准备一张清晰的正面人像照片。
- 把人像和 MiniMax 生成的 MP3 上传到 HeyGen。
- 先生成 15 秒样片,确认后再生成完整视频。
常见误区:用 MiniMax 做好了克隆音频,却在 HeyGen 里重新调用配音
要保留 MiniMax 的克隆音色,必须直接上传它导出的 MP3 音频来驱动 HeyGen 画面。不要切回 HeyGen 自带的 script + voice_id 配音模式,否则会换掉原本克隆好的声音。
02二、HeyGen 和 MiniMax 模式怎么选
首次上手建议直接用 Image-to-Video 模式,通过 API Key 即可调用,生成一条 2 分钟视频大约花费 2 美元。
这种模式足够轻量,不用提前训练专属 Avatar。你只需上传一张人像和一段音频,就能快速验证口型、表情、面部稳定性和画面构图。
HeyGen 模式建议
- 单条测试:先用
Image-to-Video模式跑通流程。 - 固定账号长期更新:验证稳定后再训练
Photo Avatar。 - 选型原则:没跑通样片前先别训练 Avatar,测试阶段越轻量越好。
MiniMax 模式建议
- 首次测试:先用海外版
Voice Clone克隆音色,再用 TTS 合成 MP3。 - 追求音质:正式成片优先选
speech-2.8-hd。 - 批量试听:需要快速预览时,先用
speech-2.8-turbo跑测试。
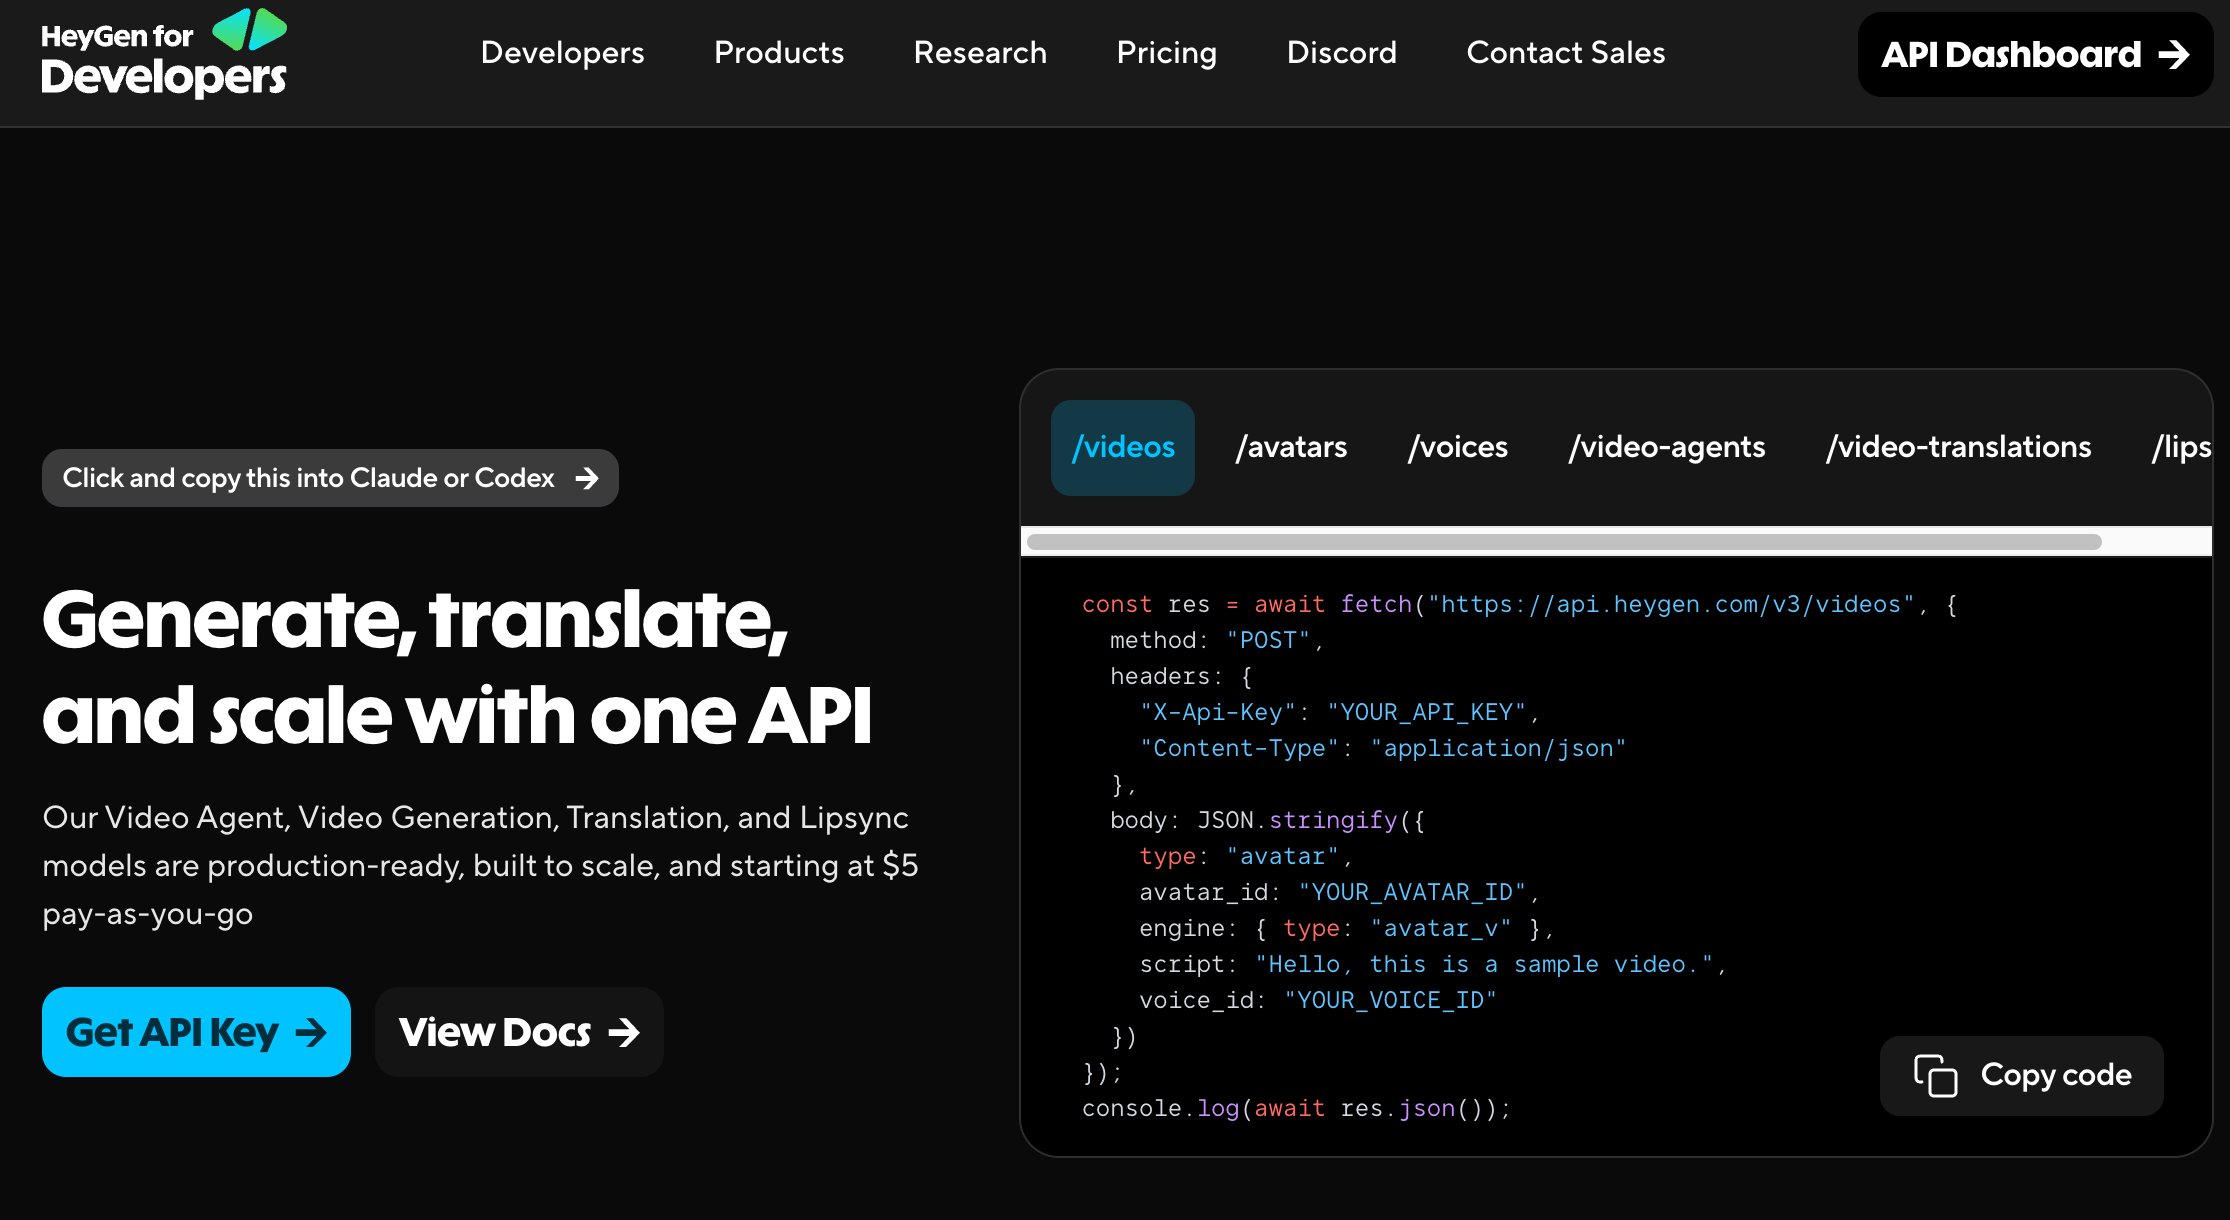 图 2A:HeyGen for Developers API(支持一键复制进 Claude 或 Codex)
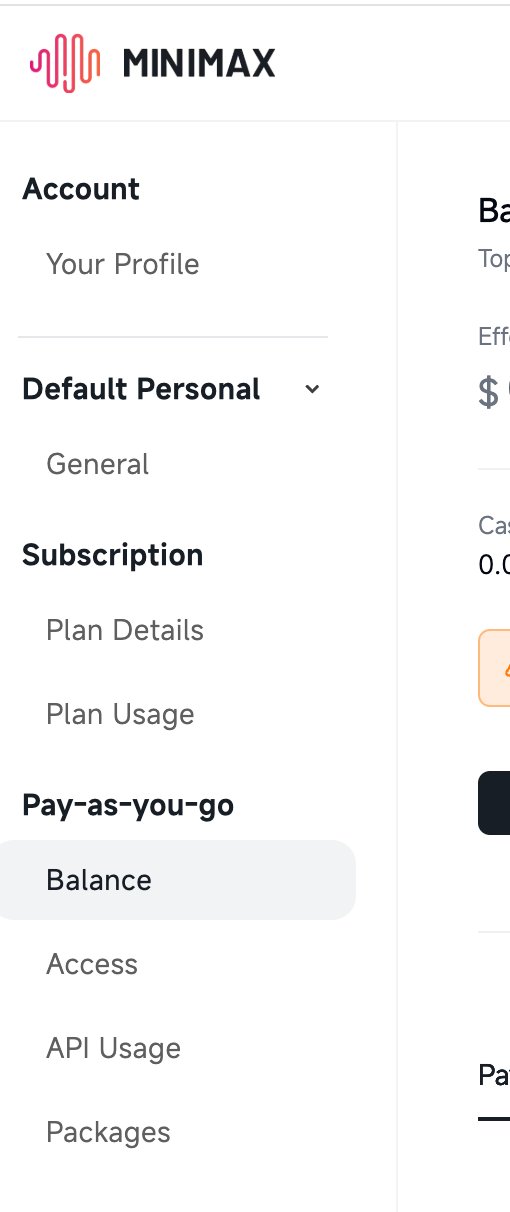 图 2B:MiniMax Pay-as-you-go 按量计费后台(Balance & API Usage)
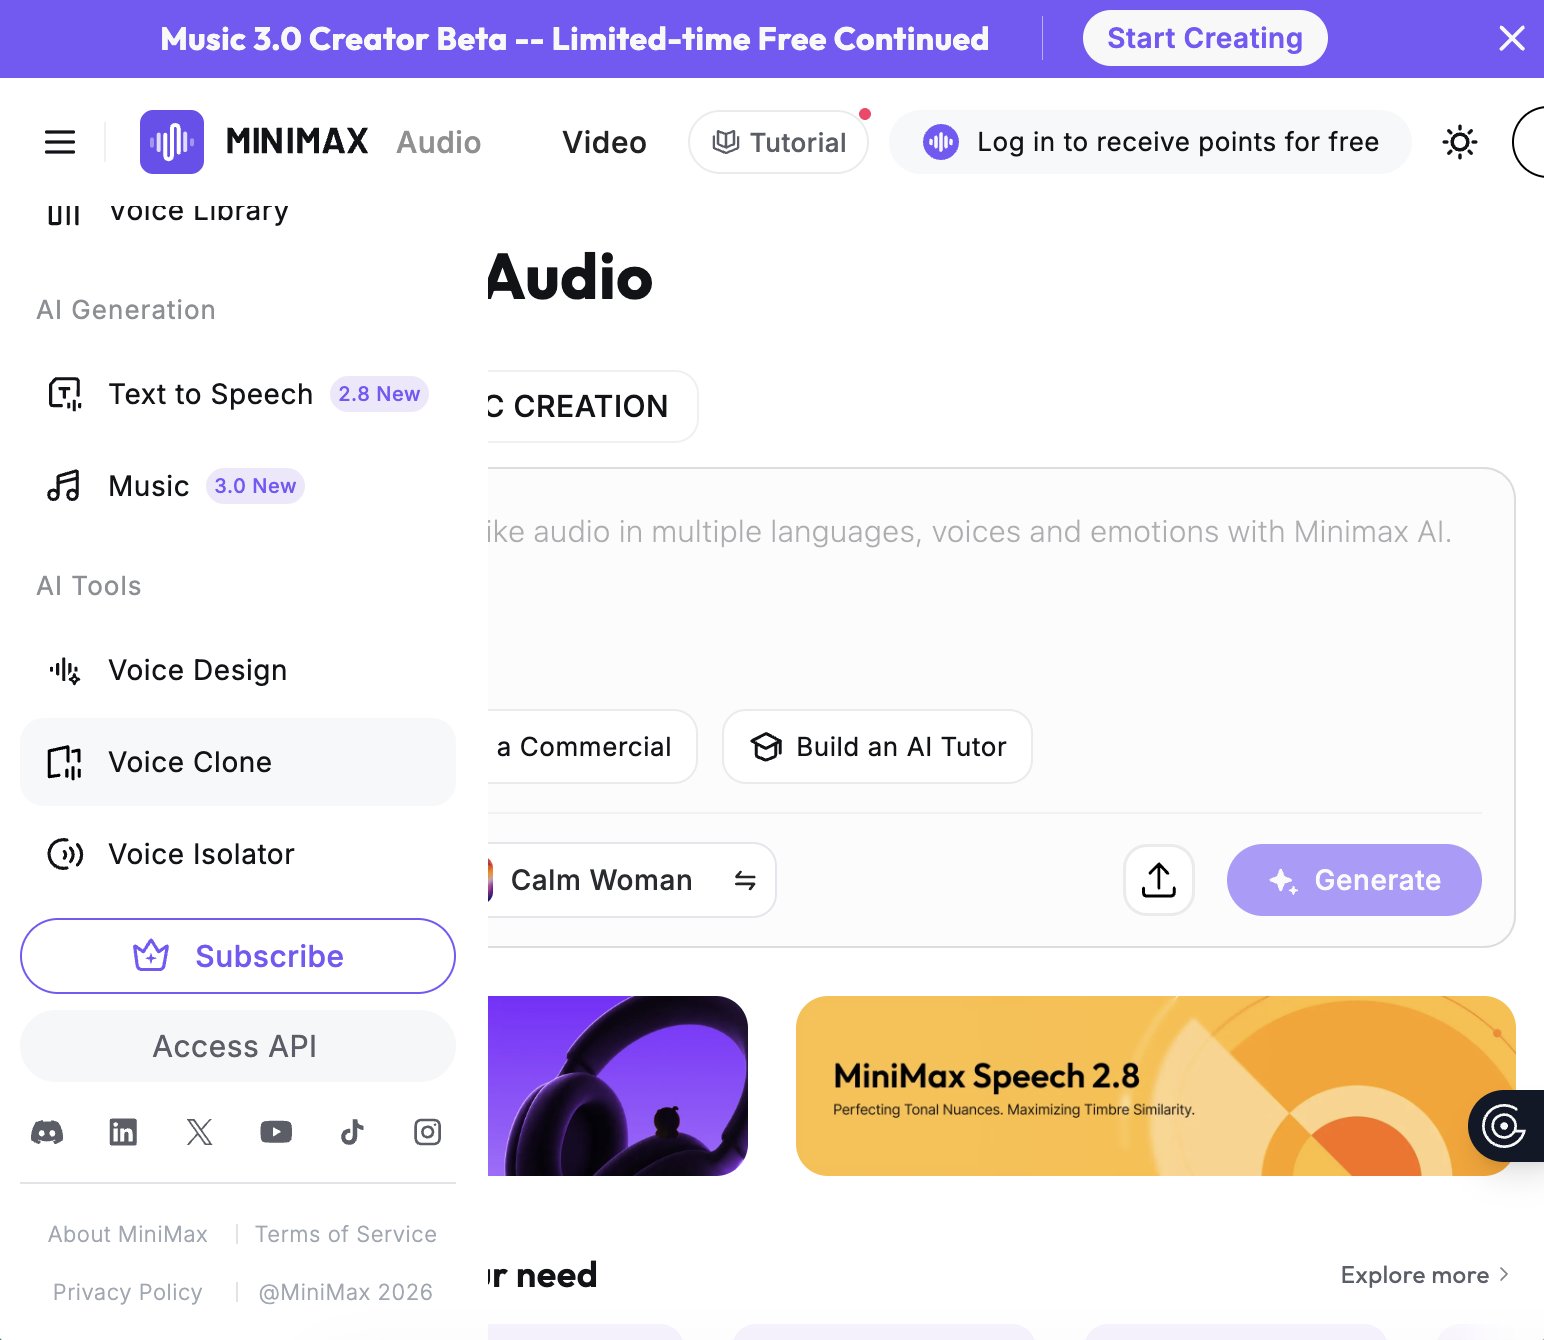 图 2C:MiniMax Audio 海外版工作台(Voice Clone 与 Speech 2.8)
03三、素材准备:不用复杂,但必须干净
- 声音样本规范(MiniMax 官方要求与实操建议)
声音克隆效果差,多半是因为原始干声不够干净。按 MiniMax 当前官方文档,声音样本需满足以下规格:
- 格式:MP3、M4A 或 WAV。
- 时长:10 秒~5 分钟。
- 文件大小:不超过 20 MB。
- 可选提示音频:少于 8 秒,并附上与录音逐字对应的文本。
实操建议录制 30 秒~90 秒干声:保持单人录音,不加背景音乐,避开混响和电流杂音。录音时音量平稳、语速贴近日常口播,不要拿过度降噪、倍速或多次转码压缩的二手音频当样本。
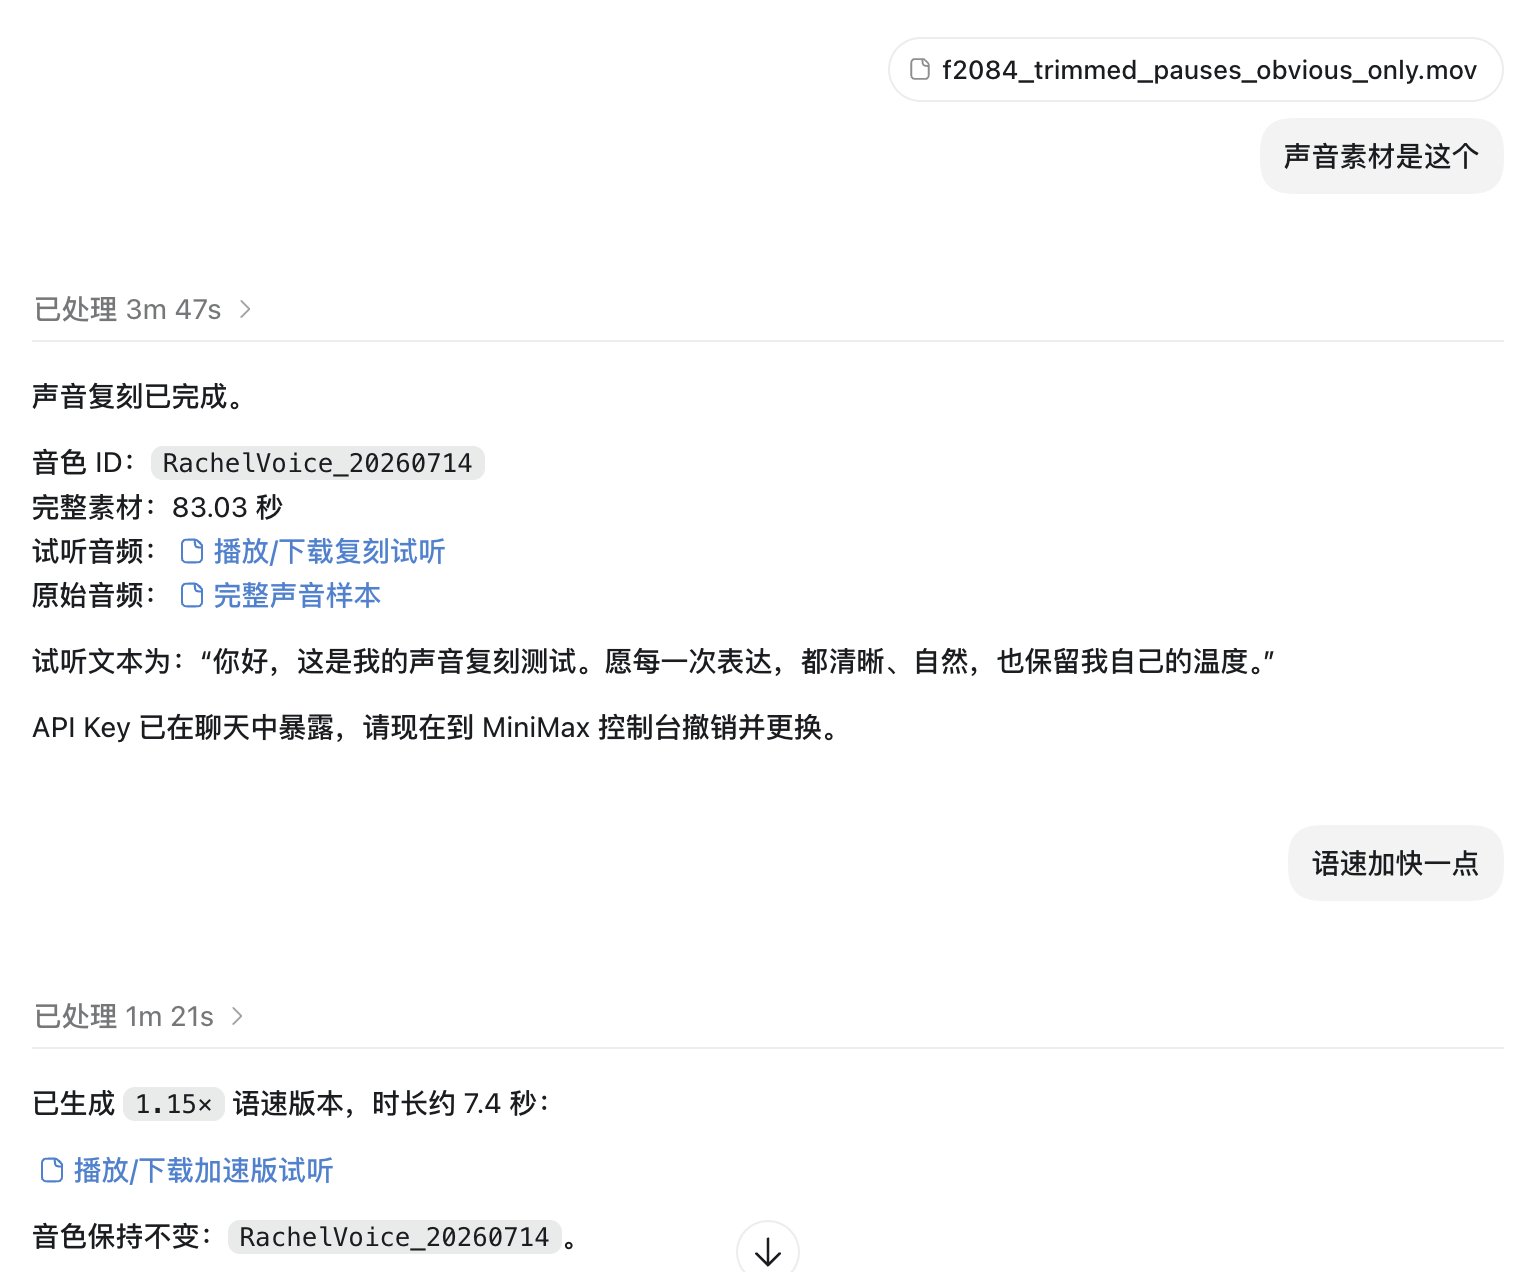 图 3:在 Codex 中上传 83.03 秒声音样本完成声音复刻并调整语速
图 3:在 Codex 中上传 83.03 秒声音样本完成声音复刻(RachelVoice_20260714),并生成 1.15× 语速试听音频
- 人像底图规范(HeyGen Assets 要求)
人像底图同样要保持干净,具体要求如下:
- 正脸平视镜头,五官无遮挡。
- 完整露出头、肩和上半身,人物占画面比例约 50%~70%。
- 嘴部轮廓清晰,避开头发、手势和重度滤镜遮挡。
- 竖屏短视频优先使用 9:16 或接近 9:16 比例的底图。
- HeyGen Assets API 支持 PNG 和 JPEG 格式,普通素材单文件上限为 32 MB。
经验总结:底图嘴部越清晰,成片口型越稳;录音干声越干净,克隆音色越像本人。
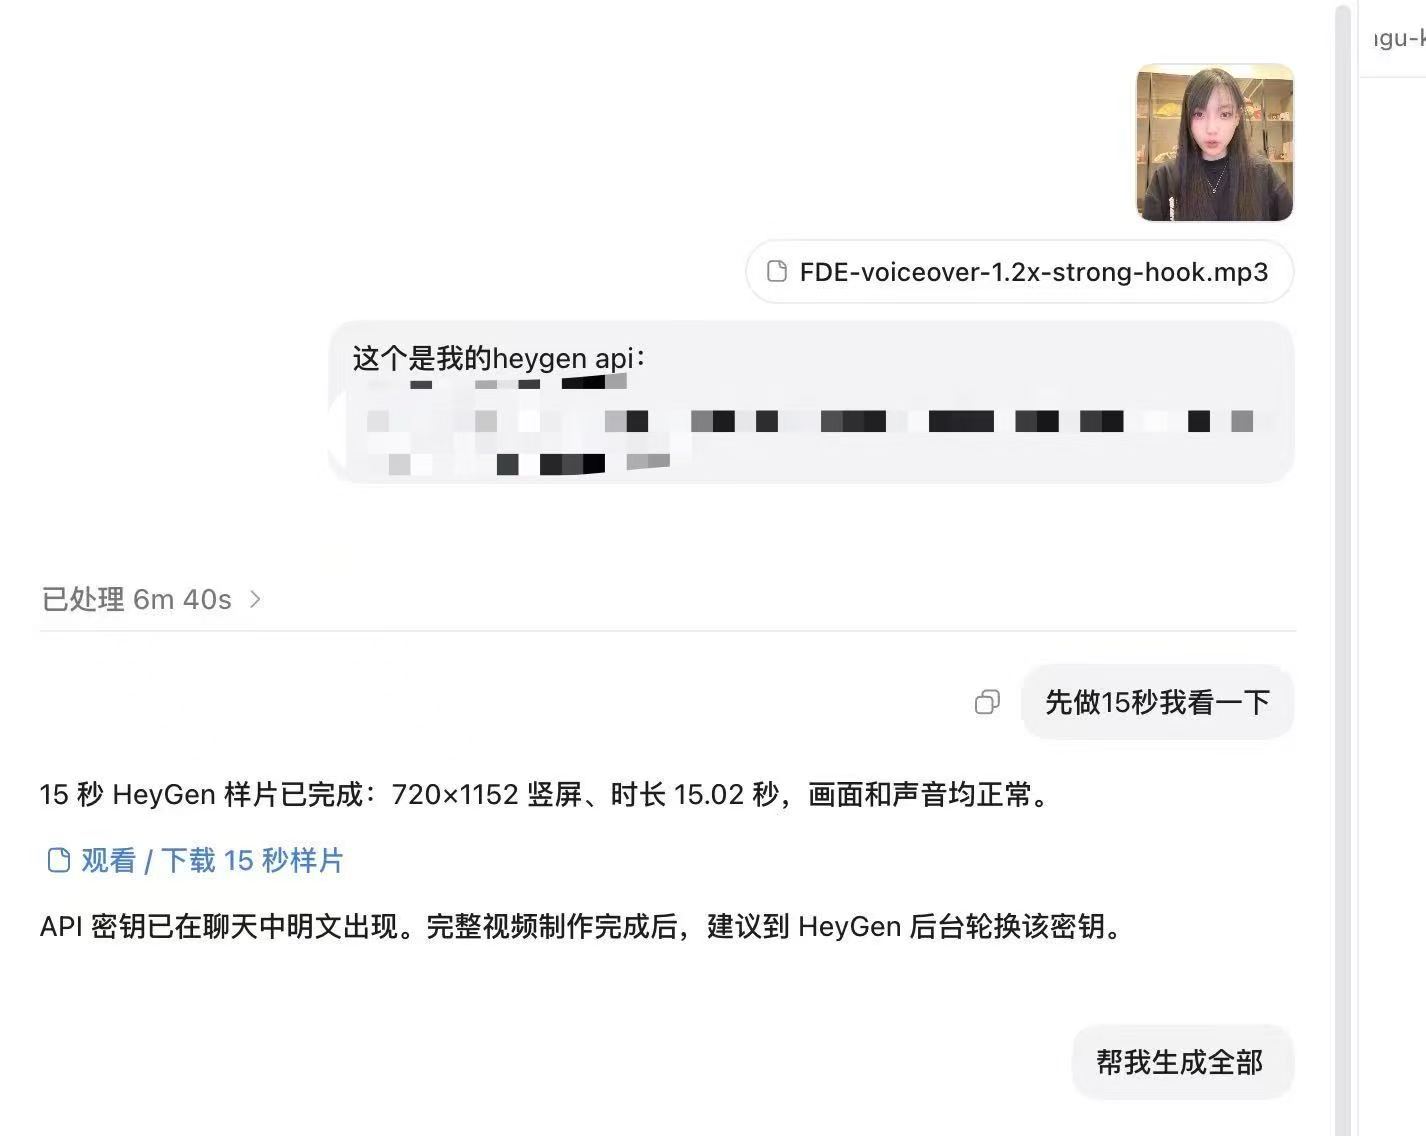 图 4:先生成 15 秒 HeyGen 样片确认后再生成完整版
图 4:Codex 实操记录,上传人像与 1.2x 强 Hook 音频后,先跑 15 秒竖屏样片(720×1152),确认无误再生成全片
04四、怎么放进 Codex 执行
每个数字人项目都统一按这套目录结构存放素材:
标准数字人项目目录结构(project/)
| 1 | project/ |
| 2 | ├── inputs/ |
| 3 | │ ├── portrait.jpg |
| 4 | │ ├── voice-source.mp3 |
| 5 | │ └── script.md |
| 6 | ├── work/ |
| 7 | │ ├── voiceover-full.mp3 |
| 8 | │ ├── preview-15s.mp3 |
| 9 | │ └── job-state.json |
| 10 | └── outputs/ |
| 11 | ├── preview-15s.mp4 |
| 12 | └── final-1080p.mp4 |
建好目录并放好素材后,向 Codex 发送以下指令:
Codex 标准执行指令
| 1 | 请用 MiniMax 海外版声音克隆和 HeyGen API 制作数字人口播。 |
| 2 | 输入: |
| 3 | - 文案:inputs/script.md |
| 4 | - 人像:inputs/portrait.jpg |
| 5 | - 声音样本:inputs/voice-source.mp3 |
| 6 | - MiniMax 密钥来自环境变量 MINIMAX_API_KEY |
| 7 | - HeyGen 密钥来自环境变量 HEYGEN_API_KEY |
| 8 | 流程: |
| 9 | 1. 先检查素材。 |
| 10 | 2. 先生成 15 秒样片。 |
| 11 | 3. 样片确认后再生成完整版。 |
| 12 | 4. 所有任务 ID 写入 work/job-state.json。 |
| 13 | 5. 不要在日志、脚本或文档中显示完整密钥。 |
这一步的重点是固定标准流程。
不用靠脑子记住每个参数细节,把验证过的流程写进 Skill,让 Codex 每次按既定步骤自动执行即可。
05五、这个 Skill 固定了什么
仓库地址: https://github.com/Jingyi-Wu-Richael/rachel-digital-human-production
一句话调用方式:
用 $rachel-digital-human-production 做这条视频,先只做 15 秒样片。
这套 Skill 固化了 9 条执行规则:
固定目录结构(inputs、work 和 outputs)。
执行前先检查文案、人像和声音样本。
MiniMax 负责生成声音,HeyGen 负责驱动画面。
每次先生成 15 秒样片。
样片未经人工确认,不生成完整成片。
每一步记录 voice_id、asset_id、video_id 和任务状态。
任务报错时不盲目重试,避免重复扣费。
导出最终 MP4 后做完整性检查。
不在日志、脚本或状态文件里写入 API Key、授权 Header 和临时下载链接。
06六、避坑要点与官方参考文档
数字人视频最容易踩坑的地方,是成片不自然。
常见翻车现象集中在两方面:一是声音不像本人、中文口型对不上;二是面部轻微变形、嘴角与下巴动作生硬,或者眨眼晃肩不自然、构图不适配竖屏。
所以我把“15 秒样片”写成强制步骤。先用 15 秒确认声音、口型、画面和构图。确认没问题,再跑完整视频。
相关链接:
- GitHub 仓库:rachel-digital-human-production
- MiniMax Voice Clone 官方文档
- HeyGen Image to Video 官方文档
- HeyGen Assets 官方文档
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。