
腾讯学堂演讲实录:AI 原生思维与个人认知训练方法
嘉宾:宝玉 @dotey(AI 博主 /《软件工程之美》作者)•发布日期:2026-09-01•腾讯学堂内部分享实录
 腾讯学堂:AI 原生思维:像训练大模型一样训练自己
引言
本文由腾讯学堂出品,整理自《软件工程之美》专栏作者宝玉在腾讯内部的技术分享。
他以自己做了三年的字幕翻译 App 为主线,拆解了找需求、判边界、最小验证、重设计和交付上线的全过程。问答环节则聚焦另一个问题:个体如何与 AI 同步成长。无论做产品、写代码还是带团队,都能从这份实战记录里拿到能直接用的方法。
演示文稿来源:《AI 原生思维》腾讯学堂内部讲义精校版(配图已完整内嵌于本页)
在线完整版
嘉宾介绍
宝玉,AI 博主、资深工程师,《软件工程之美》专栏作者。2000 年起自学编程,历任工程师、开发经理和开发总监;出国留学毕业后,重新从工程师做到工程经理,技术栈从 ASP、.NET 和 iOS 前端一路转到 AI 开发。近年专注 AI 写作与技术分享,他编写的 Nano Banana 城市天气生图提示词传到海外,获得 Google CEO 在 X 上公开致谢。
前言:像训练大模型一样训练自己
今天讲 AI 原生思维,分两个部分:一是 AI 产品怎么做,怎么找需求、判边界、落地交付;二是个体怎么跟 AI 共同进化。选这两个题目,是因为我做 AI 博主这些年,被问得最多的就是两类问题:一类是 AI 焦虑,AI 会不会替代我们,该学什么;另一类来自做 AI 产品的人,AI 产品跟传统产品到底有什么不一样。
先简单介绍自己。我大学学的力学,因为喜欢做软件转到软件工程;2000 年左右自学编程,从 ASP、PHP 做到 .NET、iOS 前端,再到 AI 开发;职位从工程师做到开发总监,出国留学后又从工程师做到工程经理。写自媒体也一样,最早写《软件工程之美》专栏,这几年主要写 AI。我一直在转型,所以 AI 来的时候没那么恐惧,以前的经验告诉我,无非就是要去学、去转。
这些年的经历用一个比喻说,就是像训练大模型一样训练自己。我做自媒体本质是费曼学习法:要学 AI,就把学到的东西分享出来;为了分享,得去学更多理论;写出来收到反馈,反馈又帮我建立新的循环。模型也一样,预训练之后靠微调、对齐不断进化。而且模型一直在变:GPT-3 是自动补全,ChatGPT 会聊天,现在 Agent 能自主完成任务。模型在进化,知识也得跟着进化,很多时候要敢于推翻自己的旧权重。这是贯穿全场的暗线。
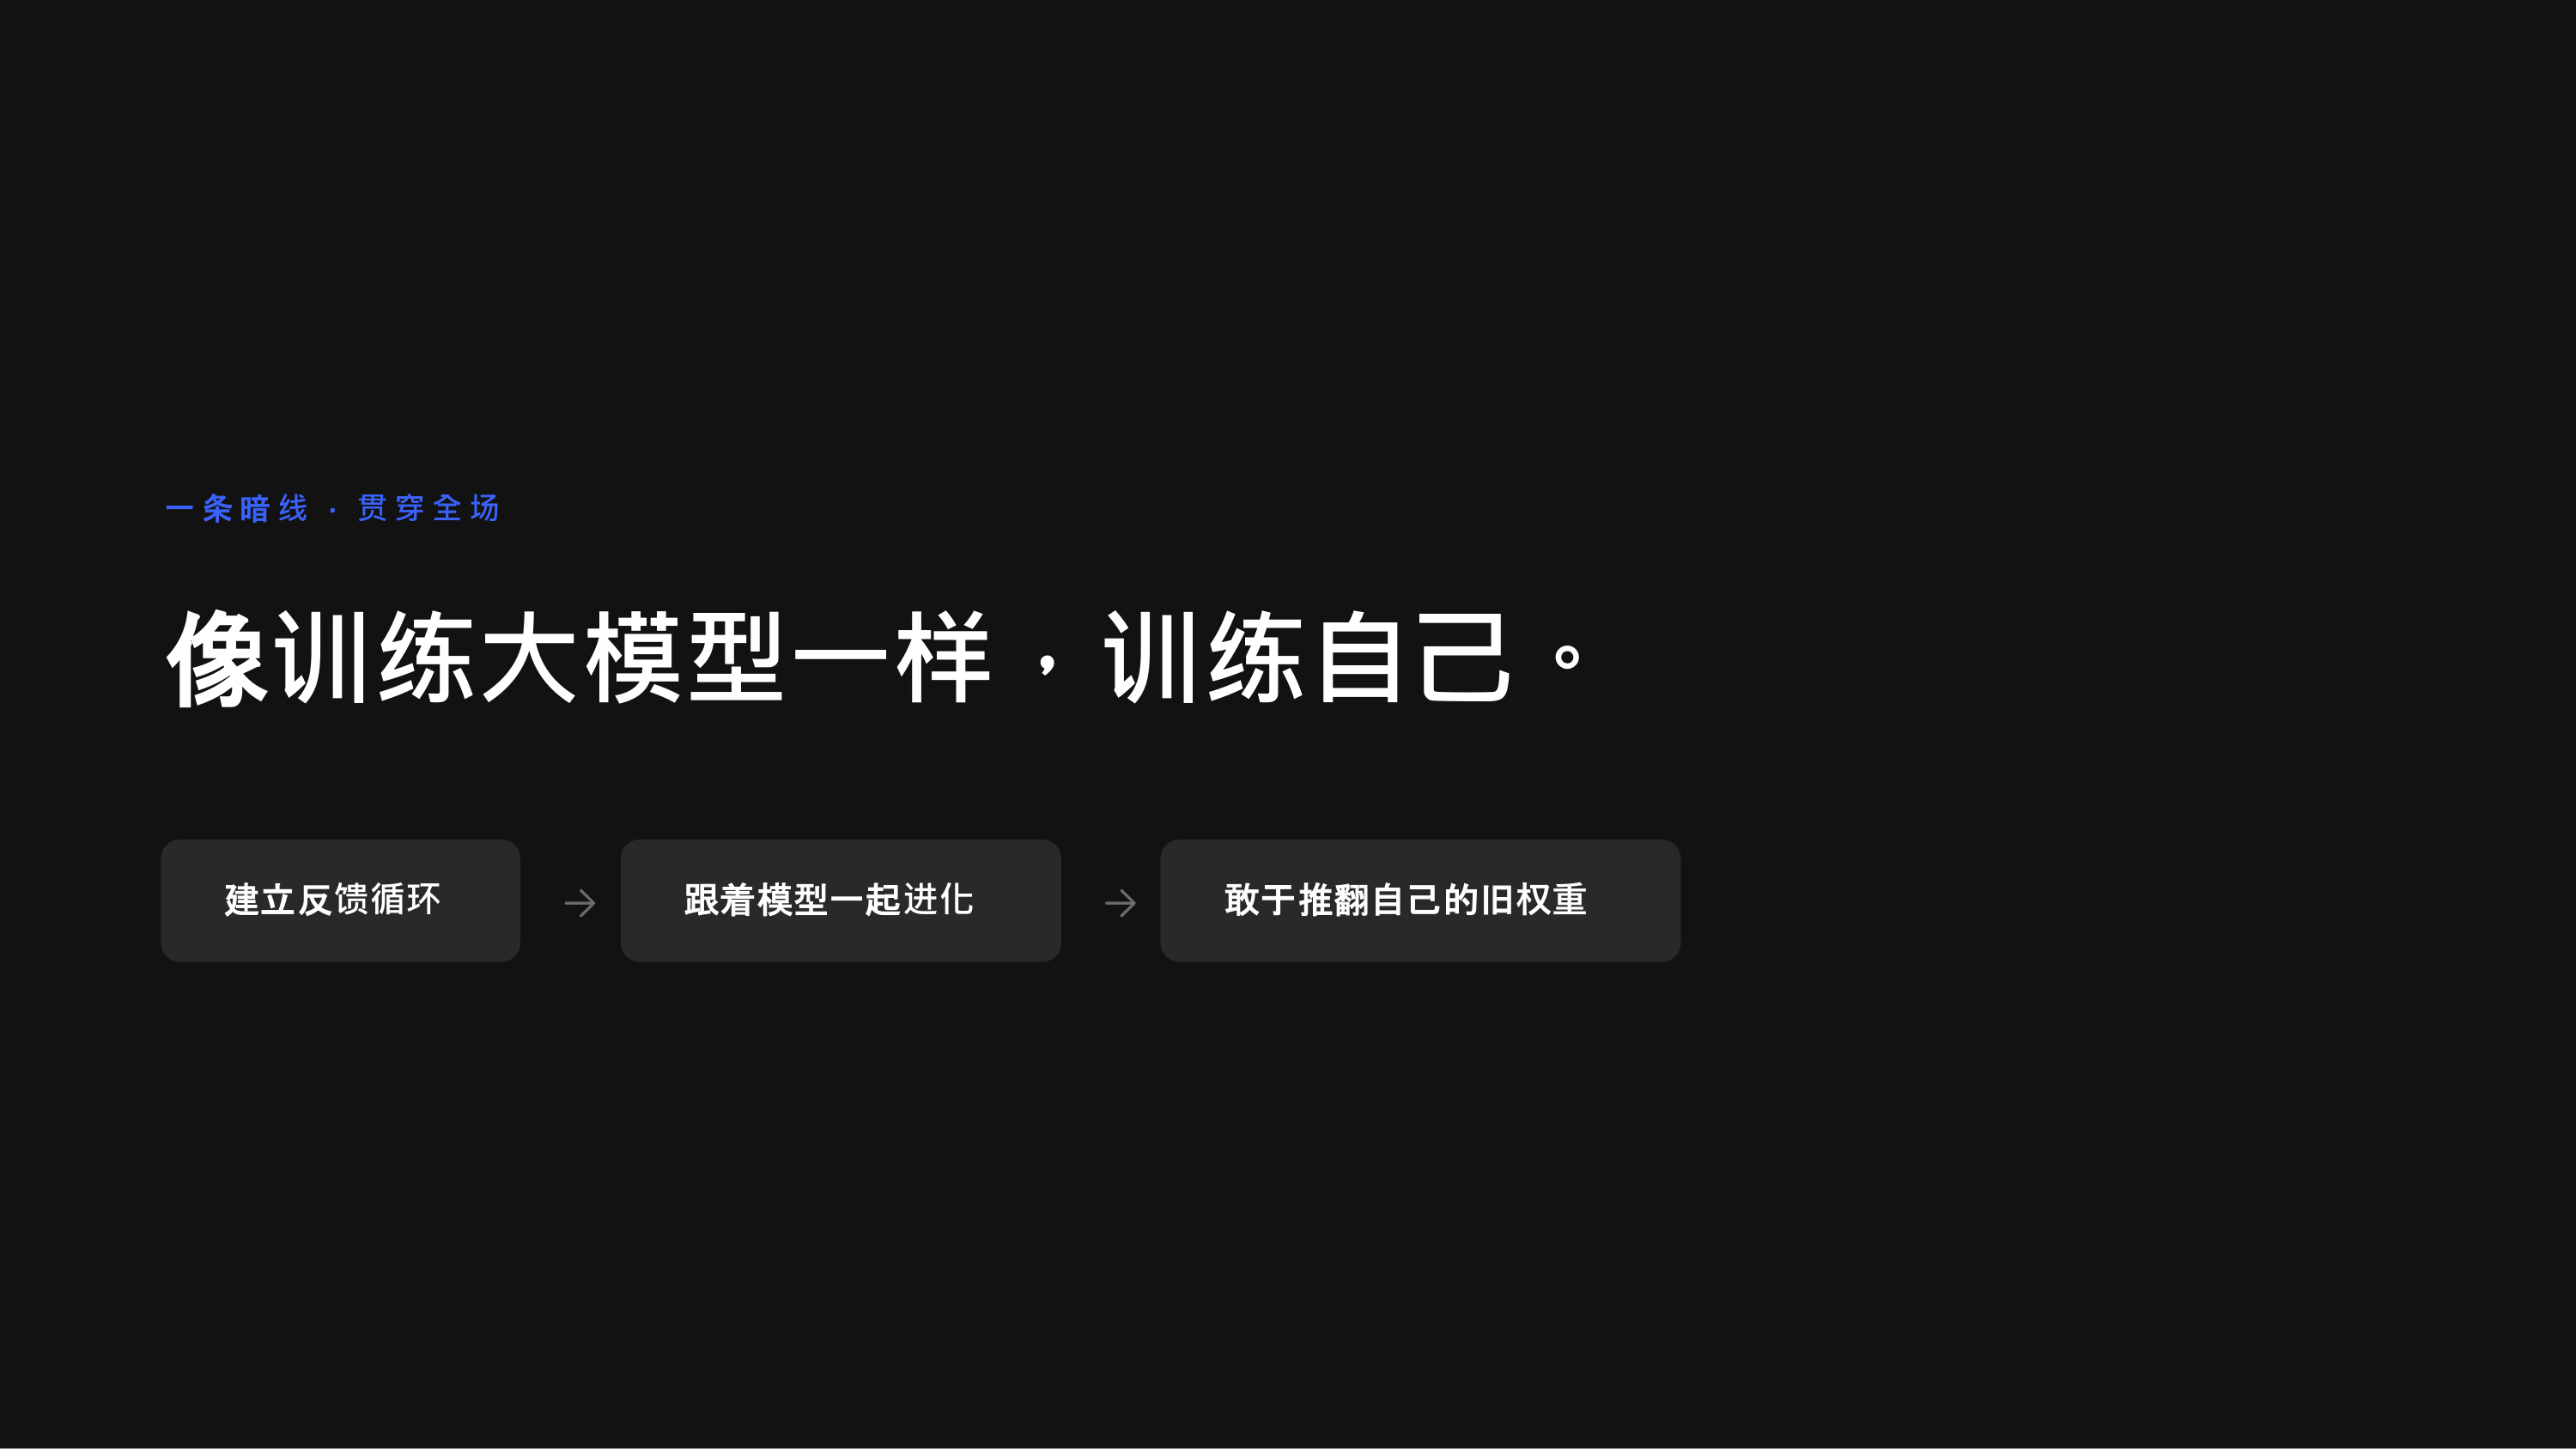 贯穿全场的暗线:建立反馈循环→跟着模型一起进化→敢于推翻旧权重
▲ 贯穿全场的暗线:建立反馈循环 → 跟着模型一起进化 → 敢于推翻旧权重
一、找需求:盯着模型能力的边界线
上半场我用一个自己做的 AI 产品贯穿始终:转录翻译 App(BaoCut),输入英文视频,输出中文字幕。选它做例子,是因为它是我亲手做的,踩过不少坑,每个判断和弯路都能讲出当时的真实考量。别人的案例只能看结果,自己的案例才能拆决策。
想法的起点很早。年轻时《反恐 24 小时》正火,人人字幕组第一时间把美剧翻译出来,我觉得这件事很了不起。后来有了 AI,我自己要看吴恩达的教学视频,就想:能不能像字幕组一样,也做出双语字幕?
但需求不能拍脑袋就做。你以为大家都需要的功能,做出来可能没人用;没人用就没反馈,项目慢慢就停了。动手前我先问自己三件事:
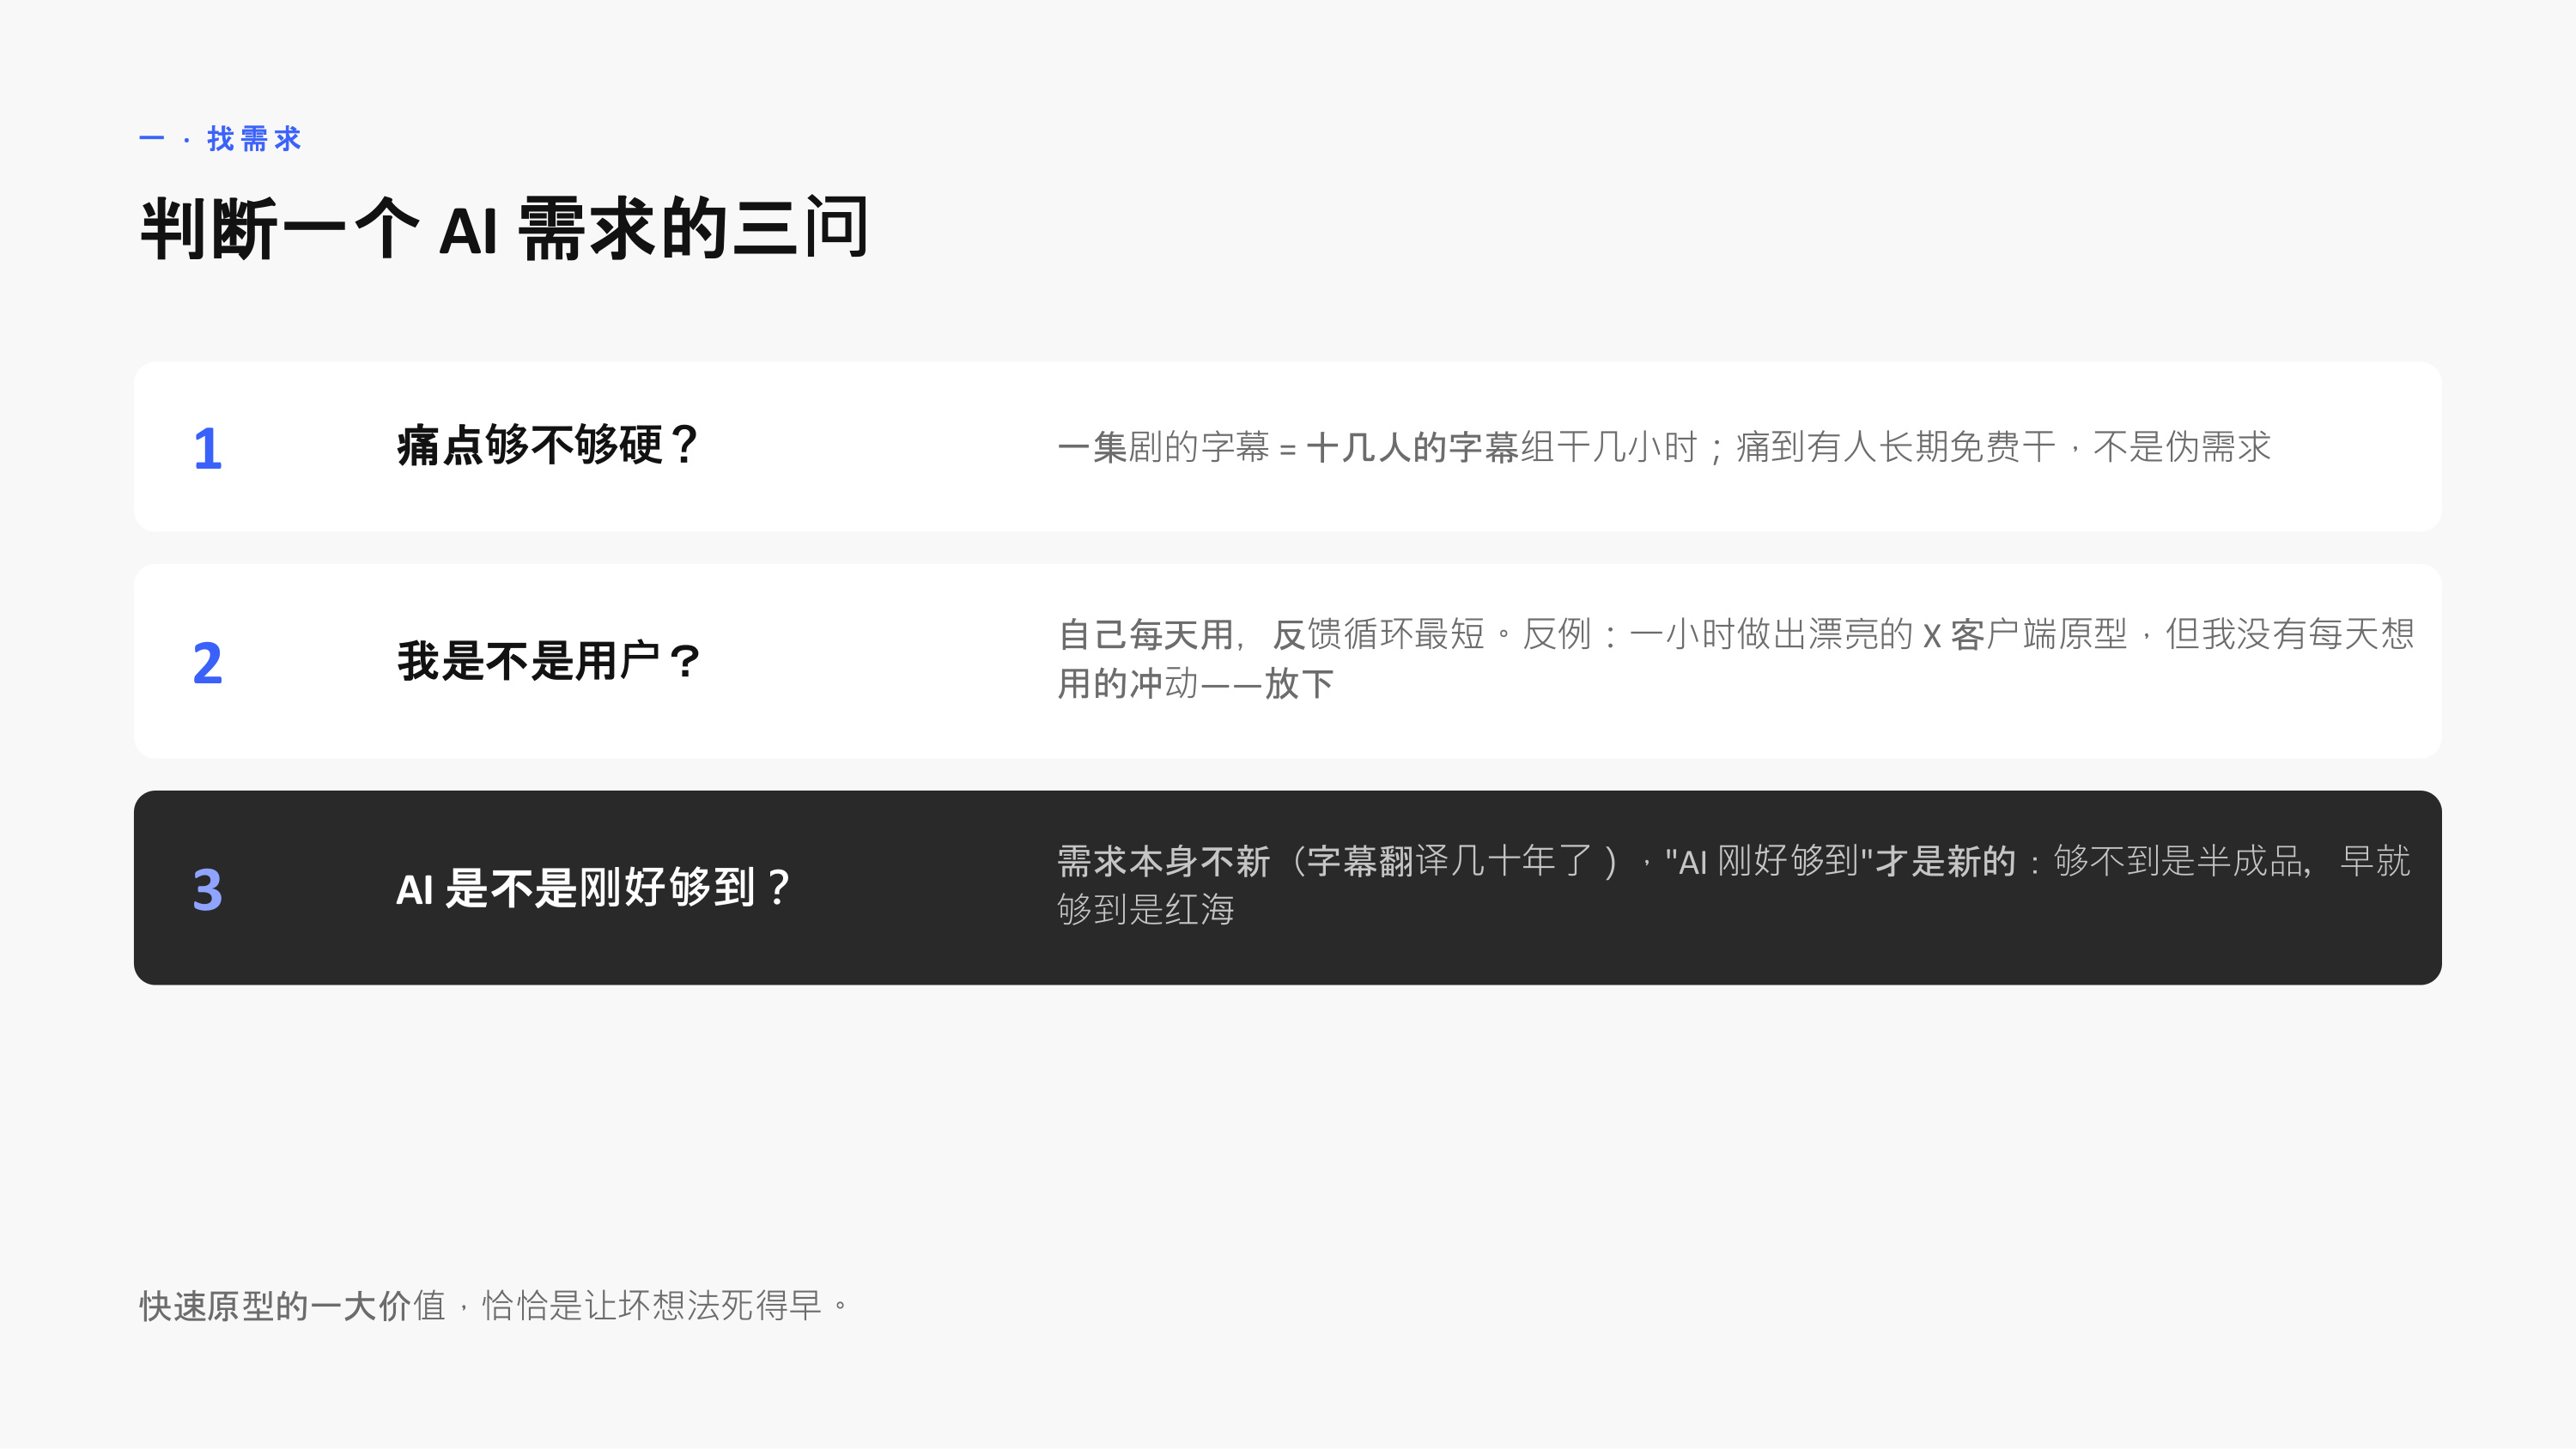 判断一个 AI 需求的三问:痛点够不够硬、我是不是用户、AI 是不是刚好够到
▲ 判断一个 AI 需求的三问:痛点够不够硬、我是不是用户、AI 是不是刚好够到
- 痛点够不够硬
真痛点:很多人想看英文深度内容但听力跟不上,刚需真实存在。
- 我是不是真实用户
我自己做自媒体天天翻视频,每天都在用,能第一时间发现哪里不好用。
- AI 是不是刚好够到
Whisper 负责听写,大模型负责翻译,Agent 负责自动对齐时间轴。AI 让以前做不到的事跑通了。
1.1 一个提示词的三级命运
关于第三问“AI 是不是刚好够到”,插一个例子。我写过一个出圈的生图提示词,就是 Nano Banana 城市天气图,Google CEO 在推特上公开致谢过它。
这个提示词迭代了很多版本。GPT 刚出画图模型时我就在用,但那时要手动输入城市、天气一大堆信息,才能画出一张图,有人围观却火不起来。到了 Nano Banana 这代,Gemini 内置搜索能自己查天气,我把提示词简化到只输一个城市名:输入上海,就生成一张带当天天气效果的上海地标图。这一下有了传播性,每个人都想试自己的城市,生成后贴回来分享,从中文圈传到英文圈,最后被 Google 官方注意到。
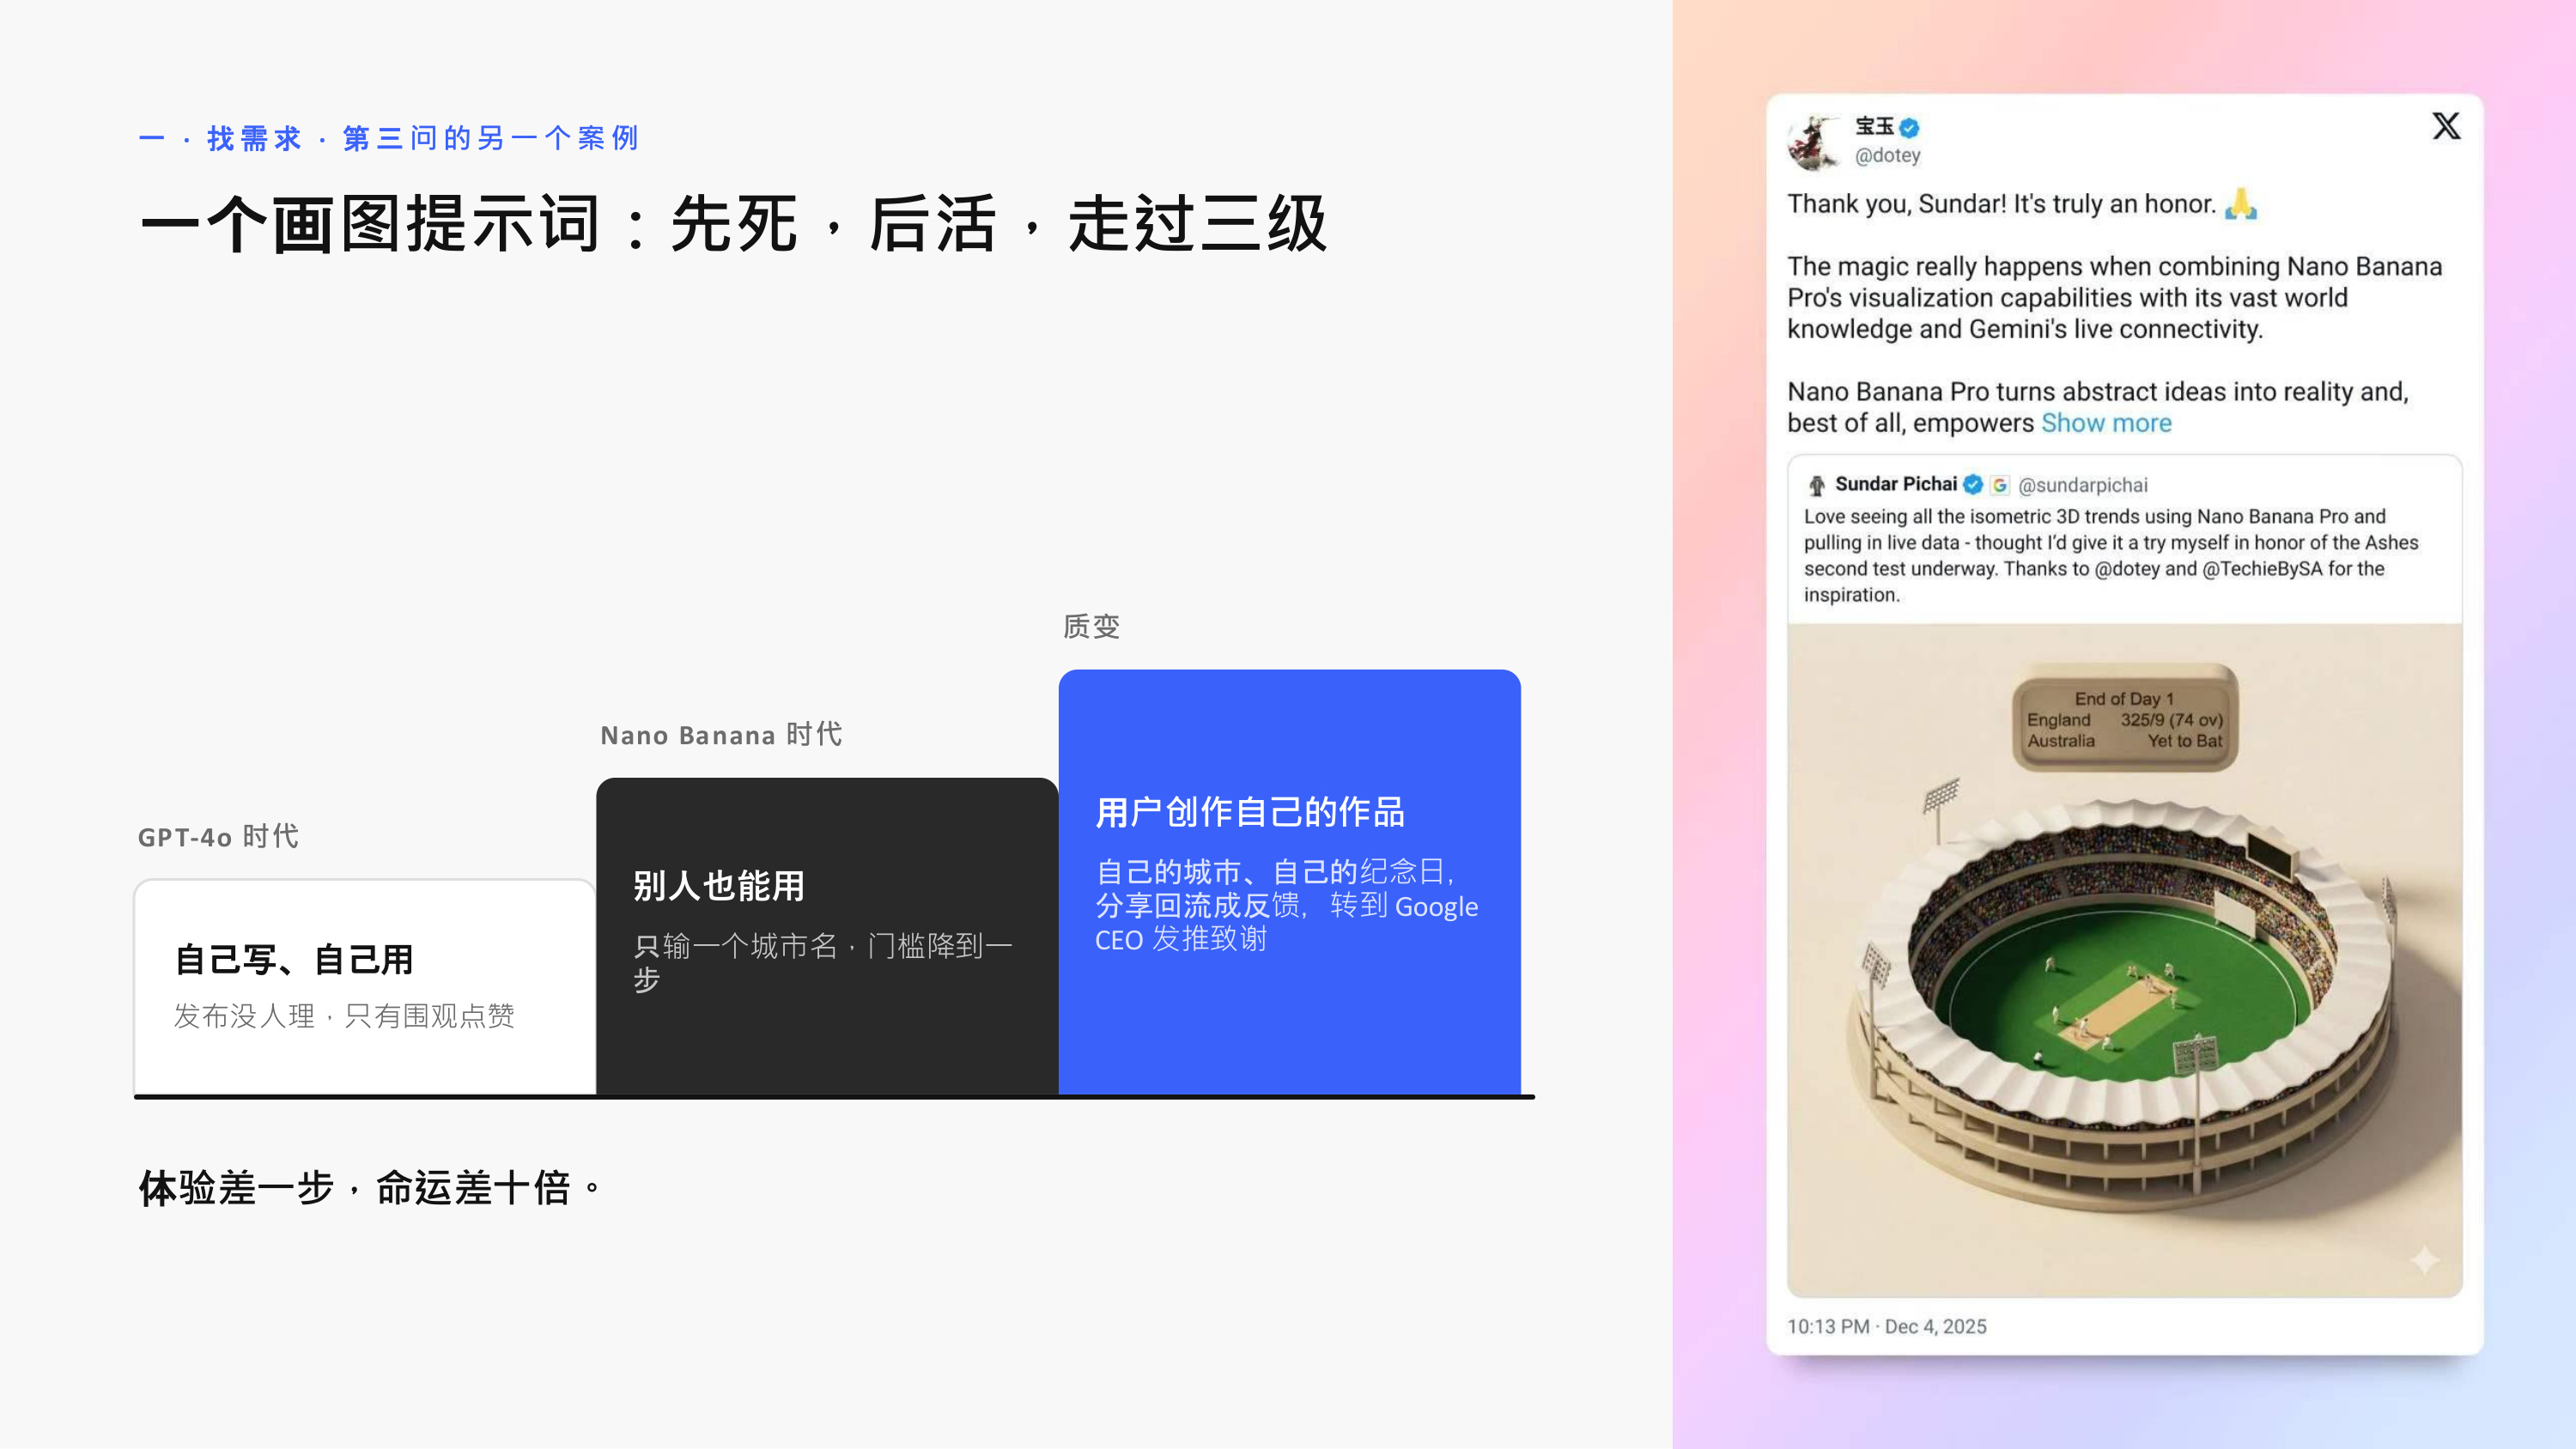 同一个提示词的三级命运:体验差一步,命运差十倍
▲ 同一个提示词的三级命运:体验差一步,命运差十倍
同一个需求,模型没有检索能力时,它只是个普通提示词;能力到了,就能让所有人参与。需求一直都在,只是模型能力边界刚好扫过了它。另一点是品味:人人都能用 AI 生成内容,想出圈还得靠自己的审美判断。
1.2 跟着模型进化的方向走
回头看模型的几次跃迁:GPT-3 时代是自动补全,能做的事有限,比如写营销文案;ChatGPT 有了对话能力,聊天机器人这类需求一下冒出来;这一两年有了 Agent 能力,能按目标调工具自动完成任务,Claude Code 和 Manus 就是长在新能力上的产品。
所以找需求要盯着模型能力演进的方向。每次模型升级,边界线向外扩一圈,扫过的地方都是新需求。凭空想出的点子做出来往往没人用,紧贴能力边界线才容易找到真机会。
二、判边界:能力、成本、价值,一个需求要连闯三关
找到需求,接下来评估值不值得做。我看三个角度:AI 的能力现在做不做得到?成本成不成立?交付的价值是不是用户真要的?多数人只盯着第一关。
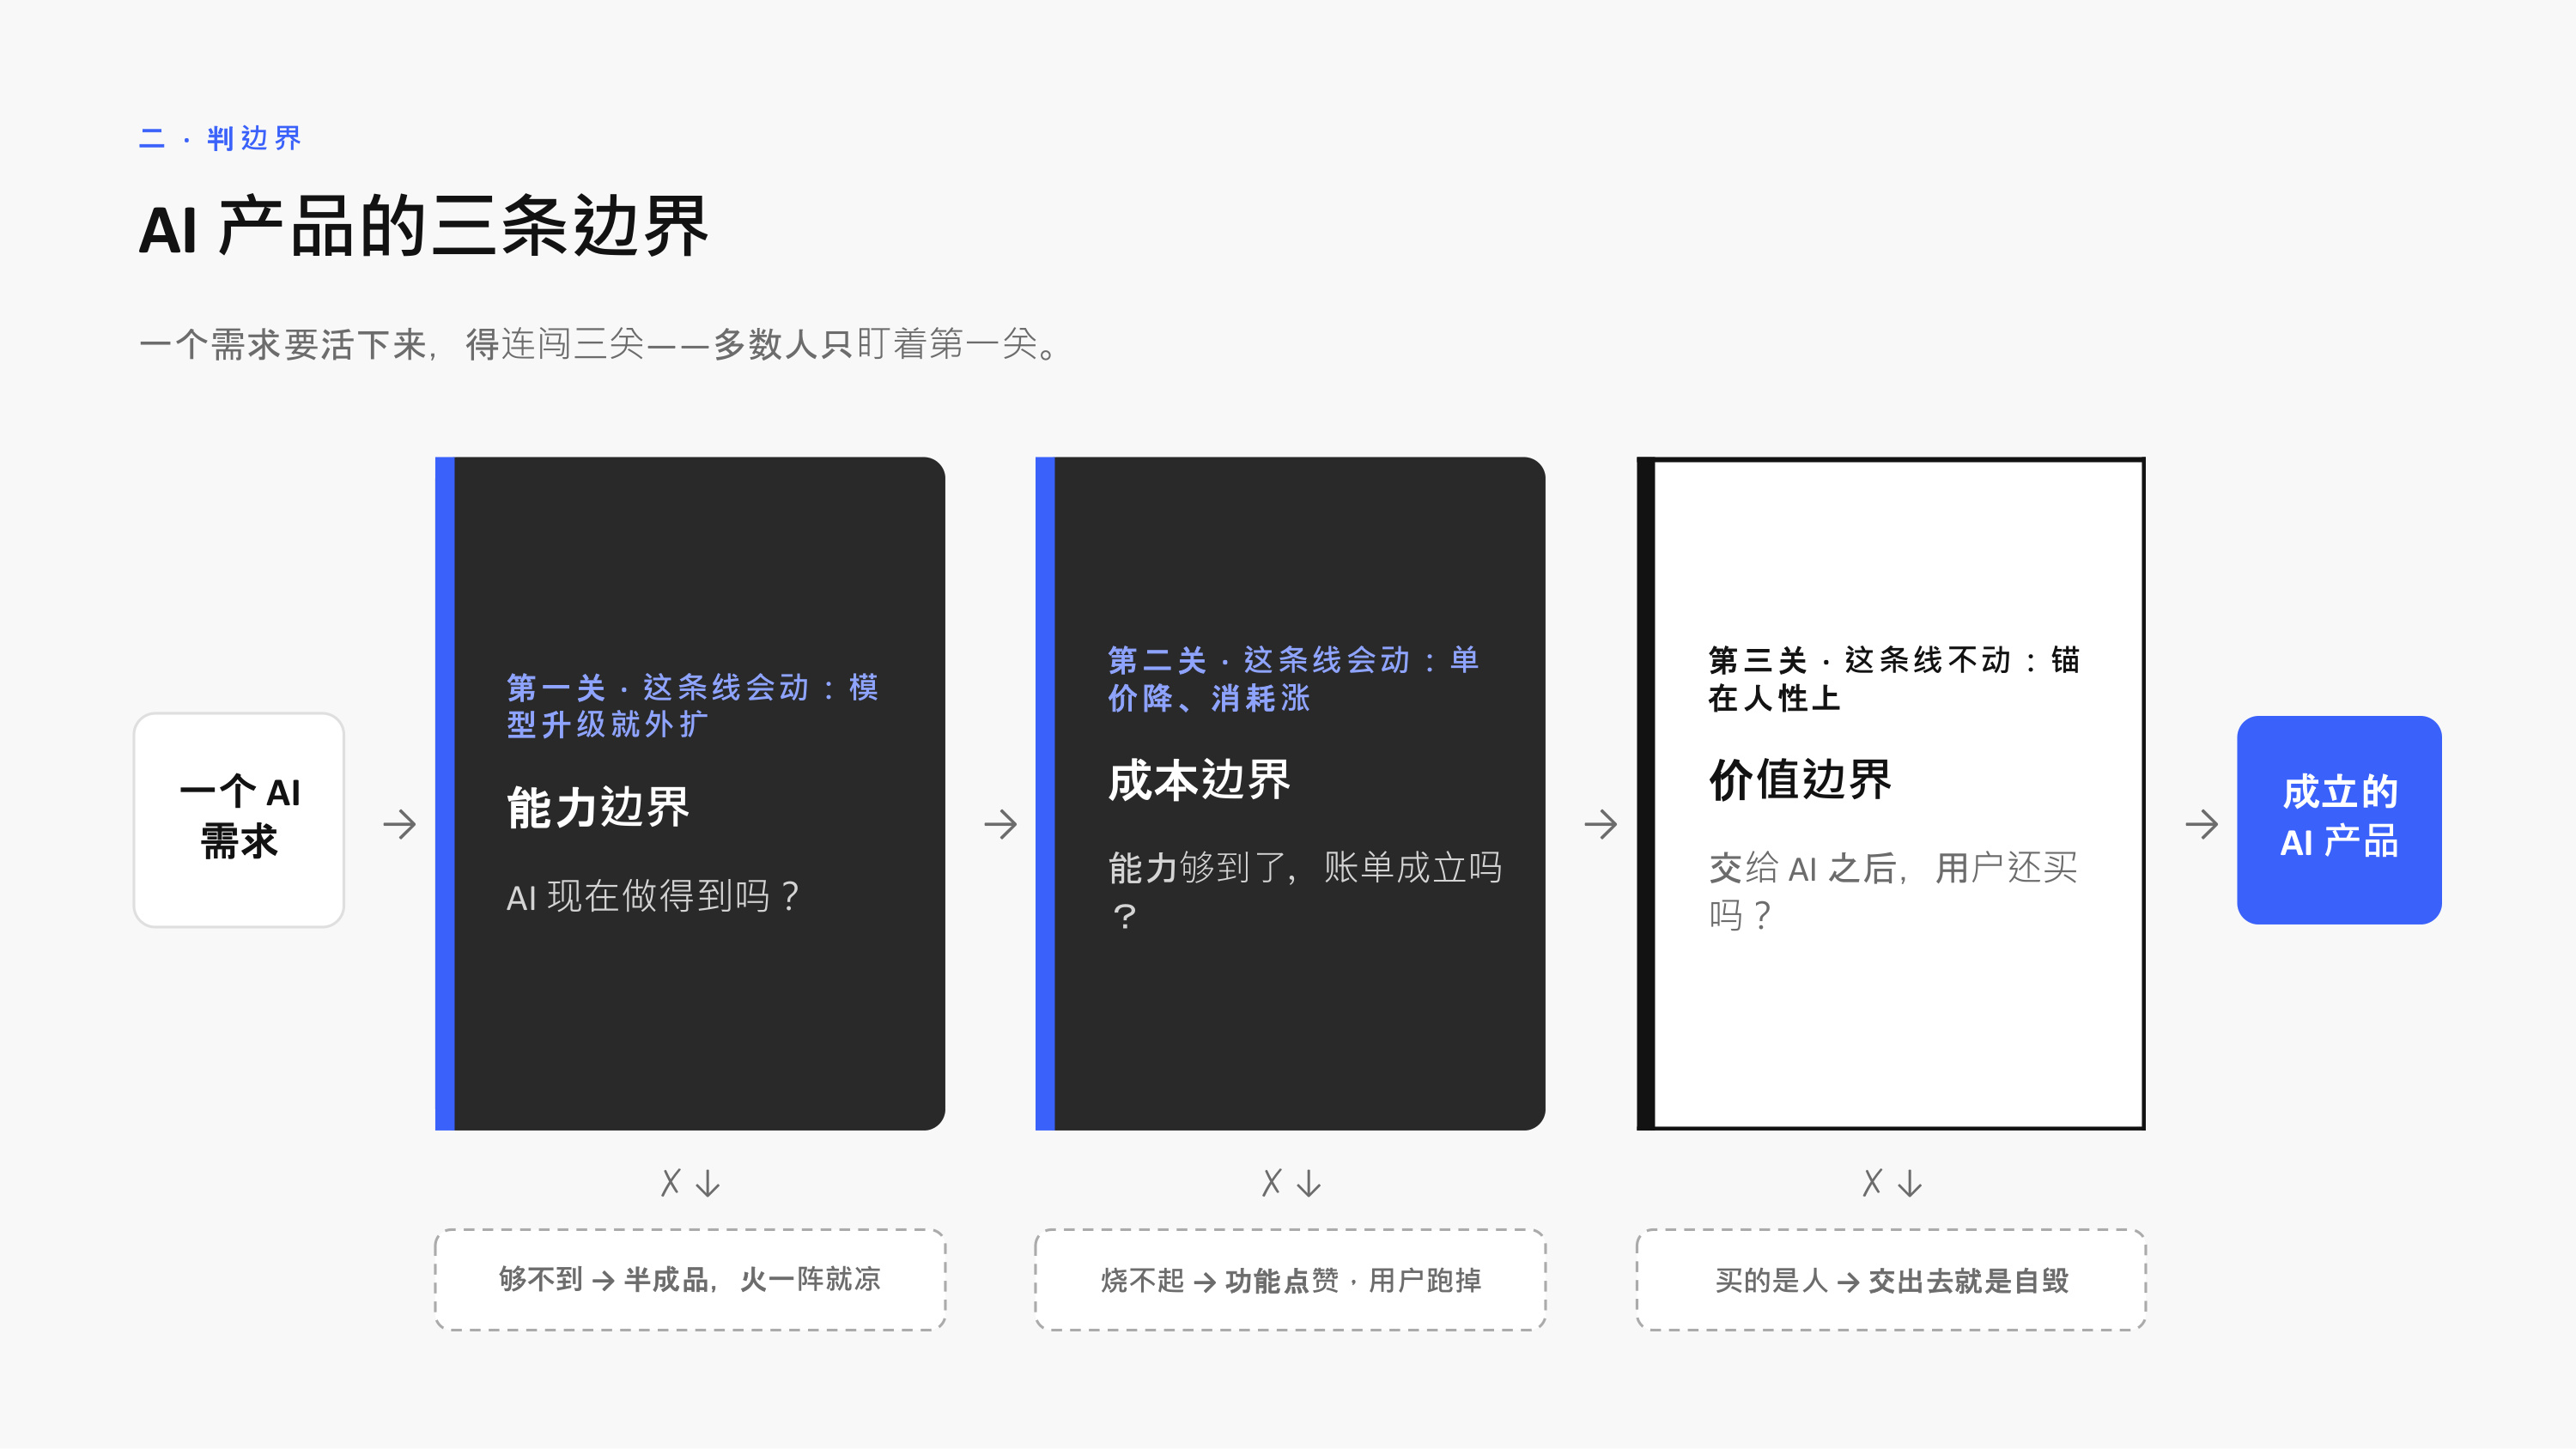 AI 产品的三条边界:能力线会动、成本线会动,价值线锚在人性上不动
▲ AI 产品的三条边界:能力线会动、成本线会动,价值线锚在人性上不动
2.1 能力边界:同一个想法,两种命运
2023 年 GPT-4 刚出时,有个叫 AutoGPT 的项目:通用 Agent 雏形,你输入任务,它就不停调 GPT-4、调 Google 搜索,汇总成报告。GitHub 上 Star 涨得飞快,但火了一阵就凉了。原因很简单:那时 Agent 能力没到,任务经常打转;调 Google API 要付费,GPT-4 又非常贵,烧大把 Token 交付不了结果。
Manus 同样是做“通用 Agent”,但它踩在了模型能力刚够用的节点上:模型已经能自己列待办清单、逐条执行并交付结果,因此迅速出圈。决定成败的关键在于能力边界,过早入场只会白烧 Token。
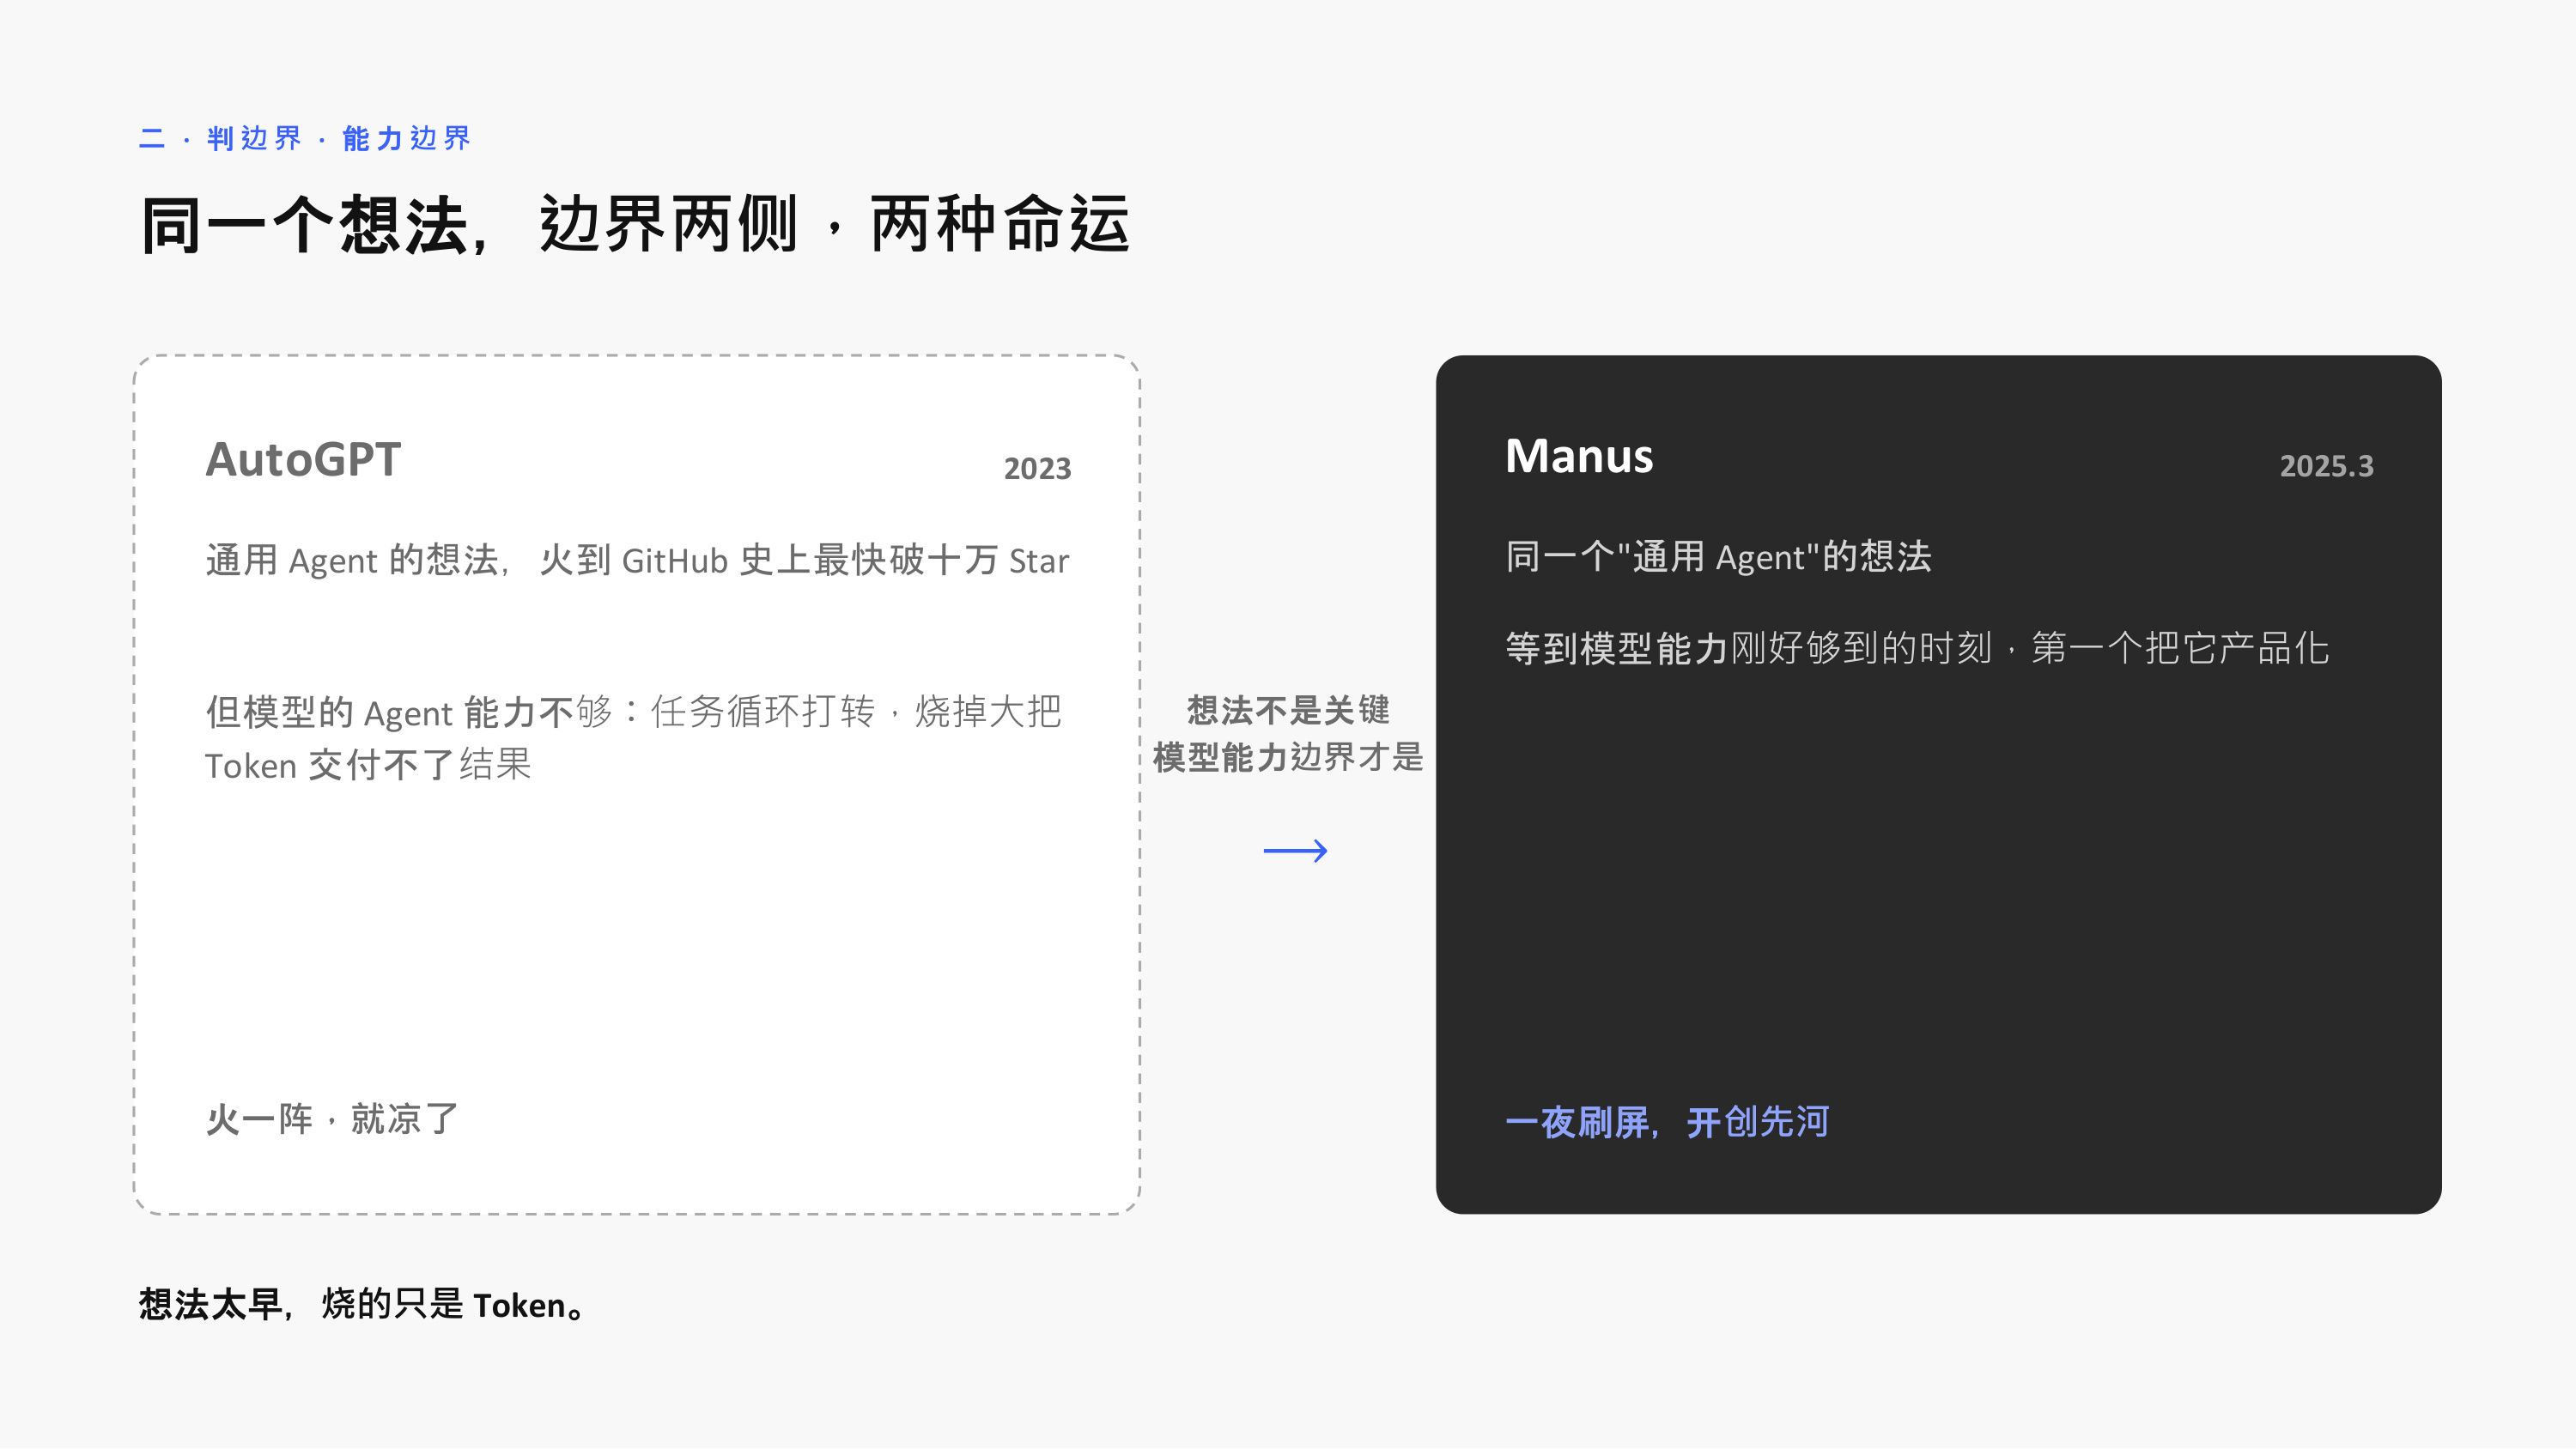 AutoGPT 与 Manus:同一个想法,边界两侧,两种命运
▲ AutoGPT 与 Manus:同一个想法,边界两侧,两种命运
边界线还在继续外扩。Claude Code 用最精简的命令行循环调用工具写代码,形态直接服务于模型能力;“小龙虾”(OpenClaw)支持在 Telegram、微信和 QQ 发消息派活,跑通了 Skill 机制。模型原本只学过公开语料,现在写几份 Markdown 规范文件,就能教它自动配图并发布,把个人私有流程装进去。
再往后,Codex 引入了 GUI 与 Computer Use 能力:写完网页后能自己驱动浏览器点鼠标、敲键盘跑完测试。以前要人全程盯着的中间环节,现在只需最后验收。如今各家都在推“Work”类办公 Agent,能力边界每次外扩都会冒出新的溢出点,盯紧这些地方就能找到新需求。
我的产品也是一层层解锁的:Whisper 解锁听写,大模型解锁翻译和拆字幕,Agent 解锁自主执行和验收。最早翻半小时字幕,我要校对一两个小时;现在 Codex 翻完,我花五分钟看一遍就行,时间轴对得非常准。每解锁一层能力,产品就能重设计一次。
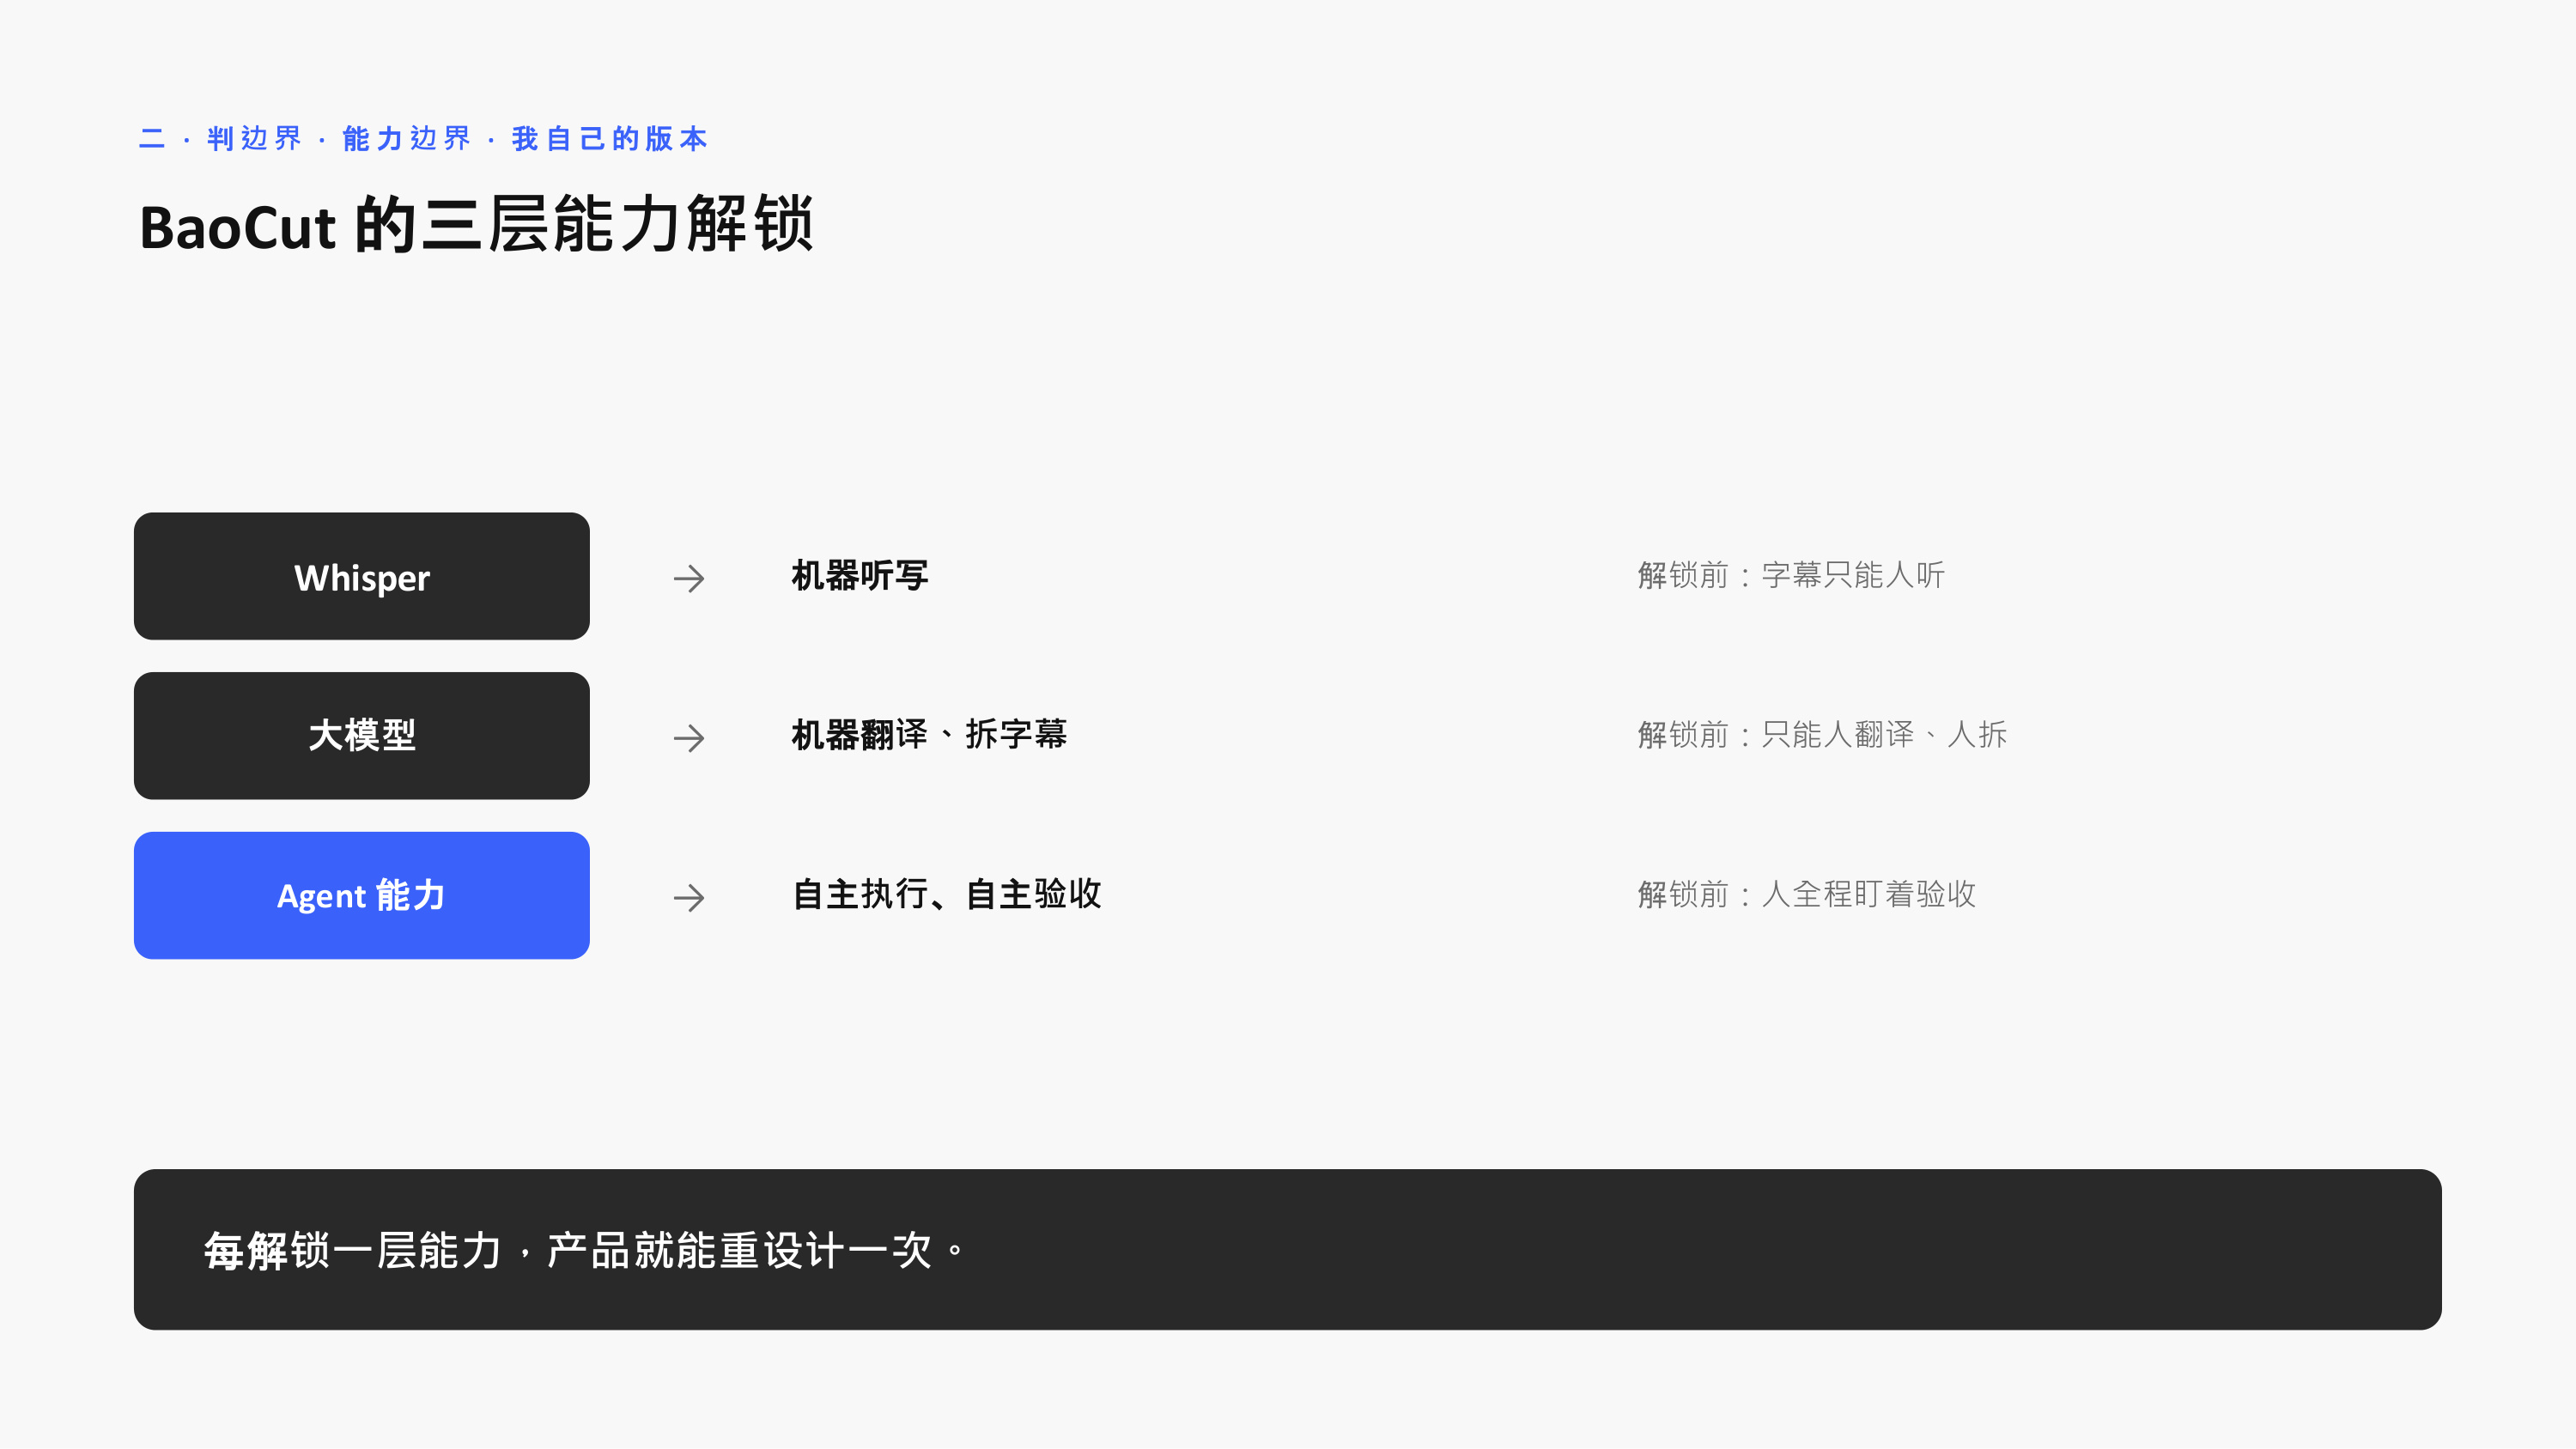 BaoCut 的三层能力解锁:Whisper → 大模型 → Agent
▲ BaoCut 的三层能力解锁:Whisper → 大模型 → Agent,每解锁一层产品就能重设计一次
2.2 成本边界:账单会直接杀死产品
第二个因素是成本。GPT-4 时代翻半小时视频要几美元,我自己勉强接受,普通人太贵,那个版本我一直自己用。现在 DeepSeek 这类模型出来,一小时视频几毛钱就能翻完。但成本要动态看:Token 单价在降,Agent 模式下消耗量上去了,不能只看单价。公式很简单:调用次数 × 每次 Token 量 × 单价,降成本就从这三个因子下手。
我有过一次真实优化。最早让模型直接输出结构化 JSON,十句字幕加标记就有几十 K Token,结构越复杂单次处理量越小,半小时视频要发几十上百次请求,用户抱怨一个视频用掉 20% 周额度。后来改成纯文本和 HTML 输出,HTML 对模型友好,单次吞吐量大了,请求次数也降了下来。代价是解析变复杂,润色后要用 diff 算法找改动并对回时间轴。但这就是工程取舍:让模型输出简单格式,复杂解析交给代码;初翻用便宜模型,只有对齐时间轴才用贵模型。一轮下来,单集请求从 33 次降到 12 次,耗时从 31 分钟降到 18 分钟。
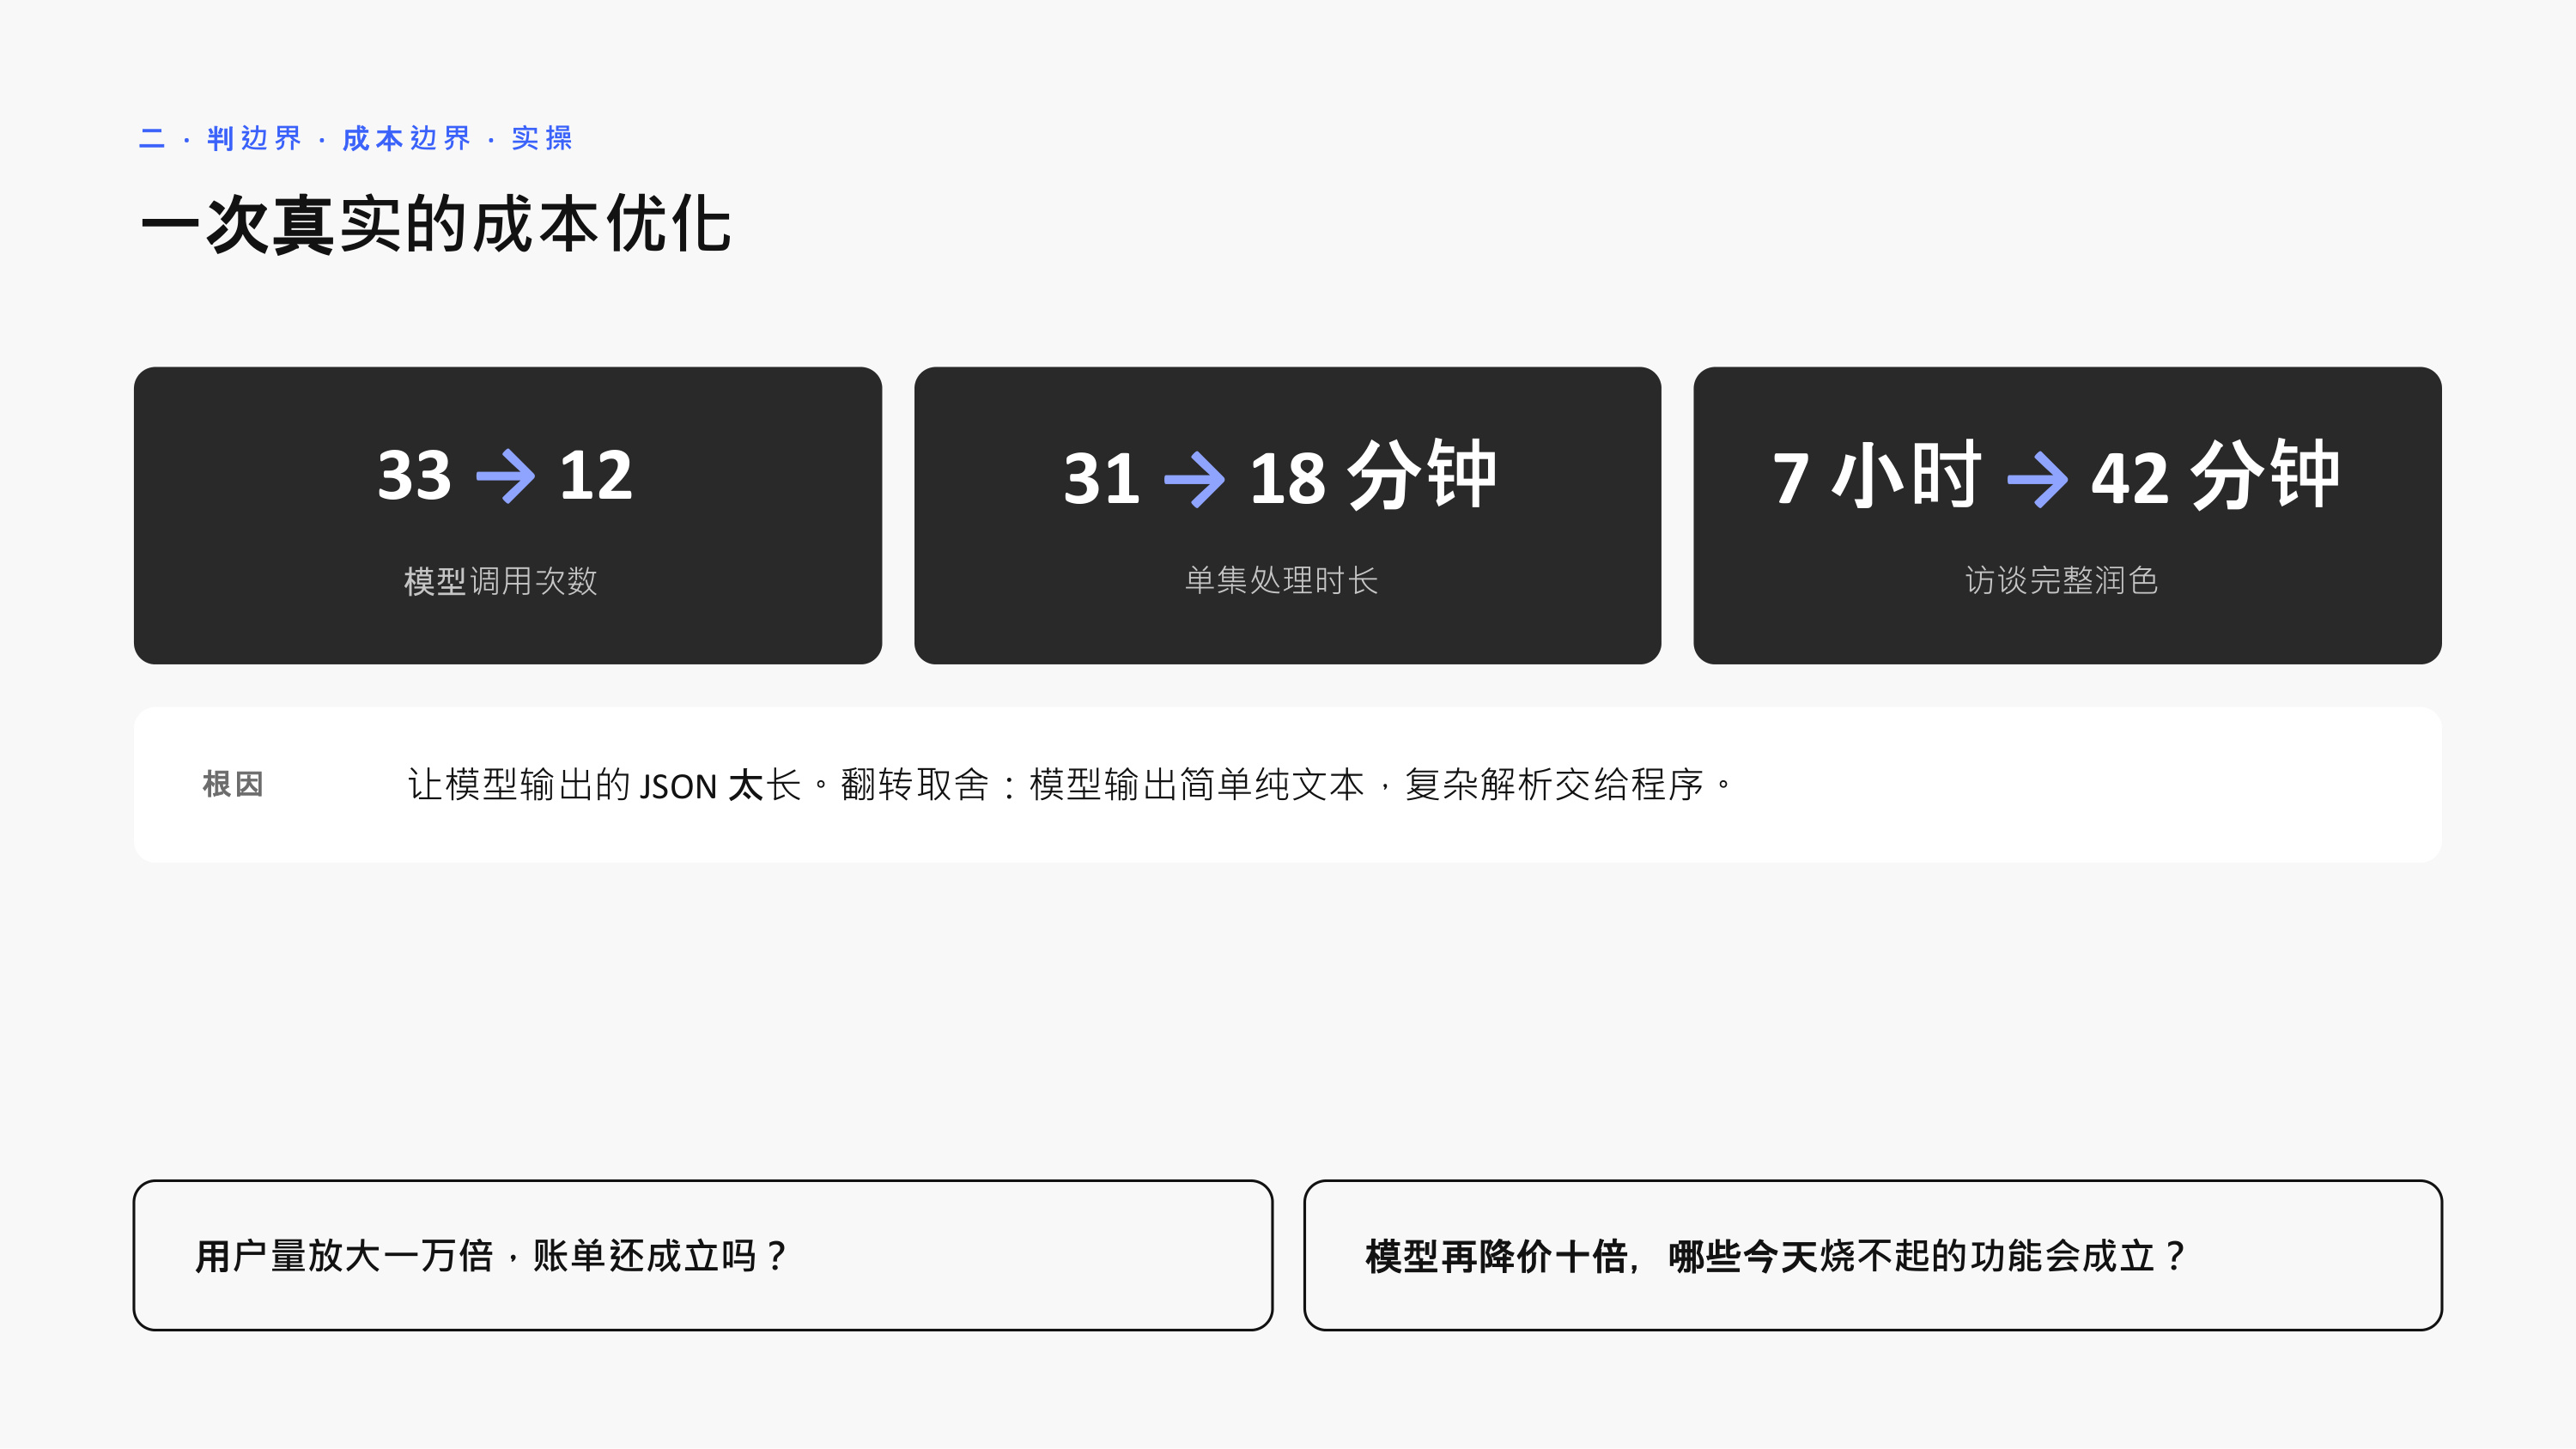 一次真实的成本优化:调用 33 → 12 次,单集处理 31 → 18 分钟
▲ 一次真实的成本优化:调用 33 → 12 次,单集处理 31 → 18 分钟
2.3 价值边界:用户买的是结果,还是结果背后的人
第三关是价值。字幕翻译用户要的是确定性结果,英文进去、准确中文出来,不在乎谁翻的。但不是所有东西都这样:AI 自动写小说、做视频,很多人天然抵触,叫“AI 垃圾”;哪怕我只让 AI 润色文章,都有读者评论“AI 味很重”。如果产品只是在生产更多 AI 垃圾,就要想想值不值得做。用户买的是结果还是结果背后的人,这条线锚在人性上,不随模型升级移动。
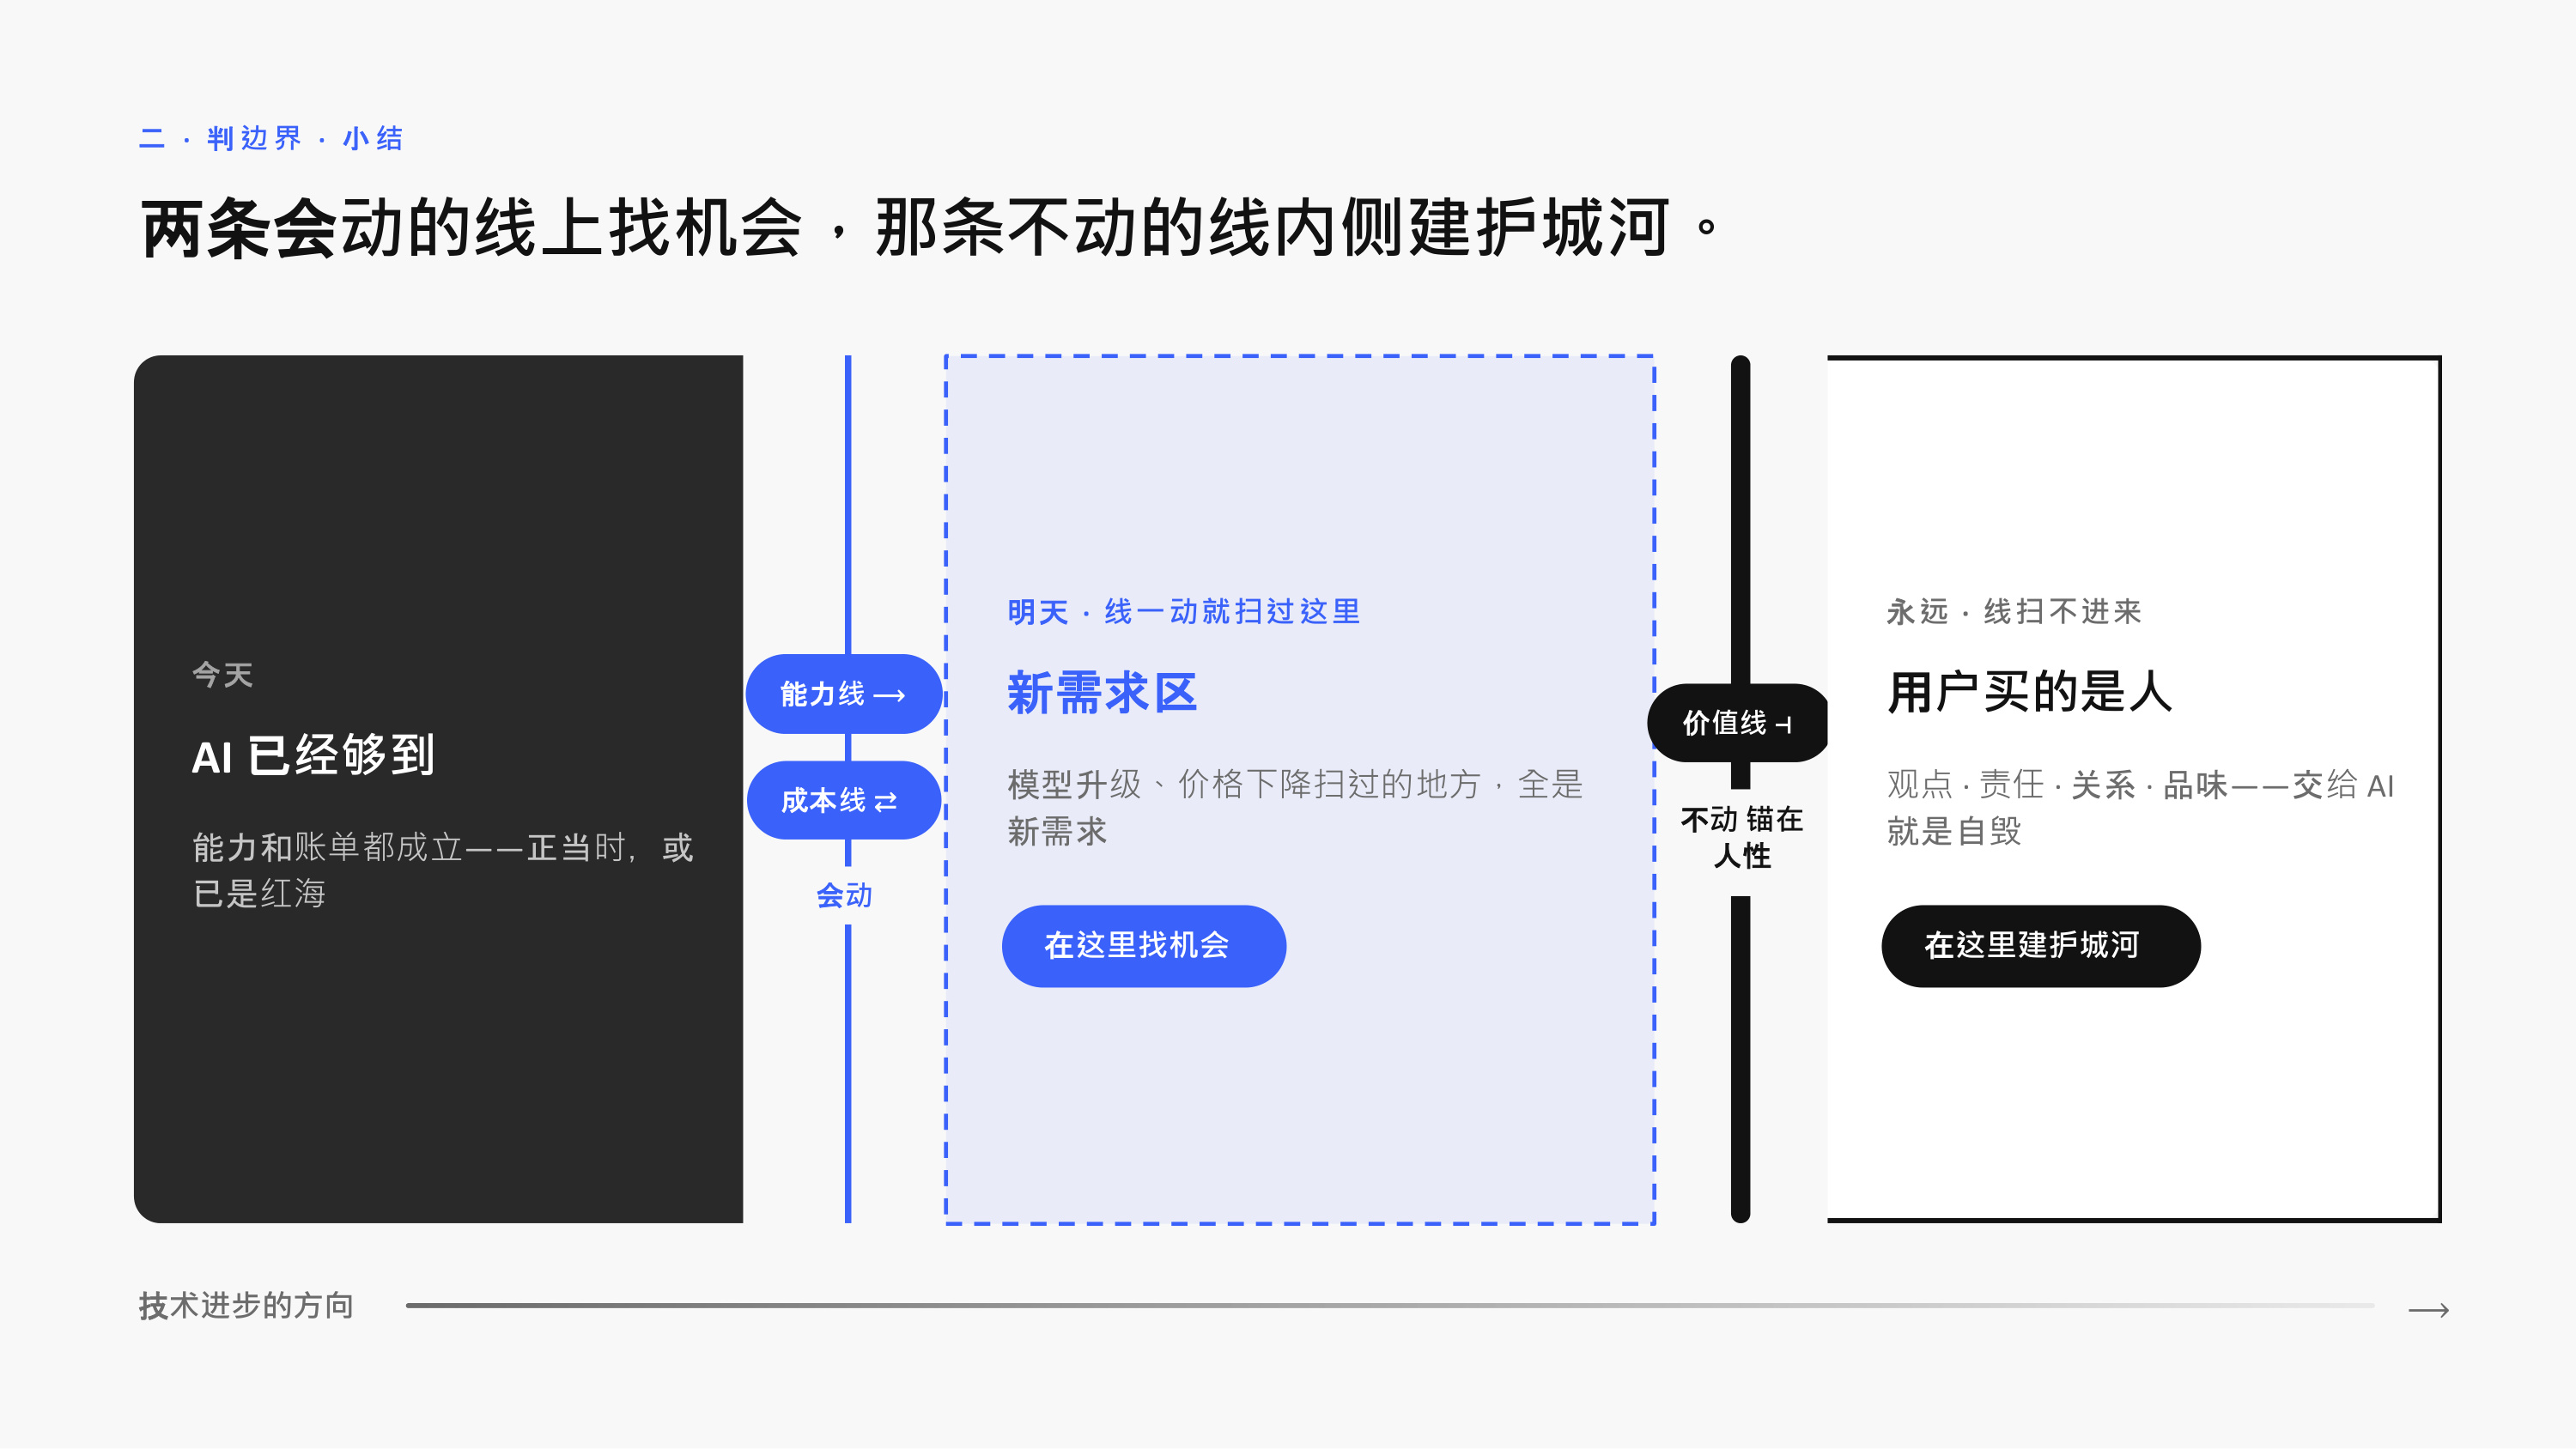 两条会动的线上找机会,在那条不动的线内侧建护城河
▲ 两条会动的线上找机会,在那条不动的线内侧建护城河
三、最小验证:让坏想法死得早
决定做了,下一步是怎么快速做出来。这个项目我两三年前就开了,一直没发布:视频编辑器工作量大,Whisper 早期时间戳对不准,业余时间老被打断,眼看要进“半成品坟场”。破局靠两个选择。
第一个是 Claude Design:用指令直接生成高保真交互原型,不用写代码,配模拟数据,几分钟就能上手测试。从头做没人做过的东西,靠写代码反馈周期太长;用原型,周期压到几小时,马上知道哪里不对。MVP 决策也在这步做:只做 Mac、只做最简单的播放和字幕。
第二个有点阴差阳错:我用了完全不熟的 Swift 加 AppKit。这些年我主要做前端,Electron、TypeScript 特别熟,用熟的语言有个坏处,你老想自己控制代码,一控制你就成了瓶颈,不放心让 AI 写。Swift 不熟,只能交给 AI,我只管验收,代码都不怎么看。正因为不熟才能放手,几天就做出能跑的 MVP。在不熟悉的领域开始,反而更接近 AI 原生思维。
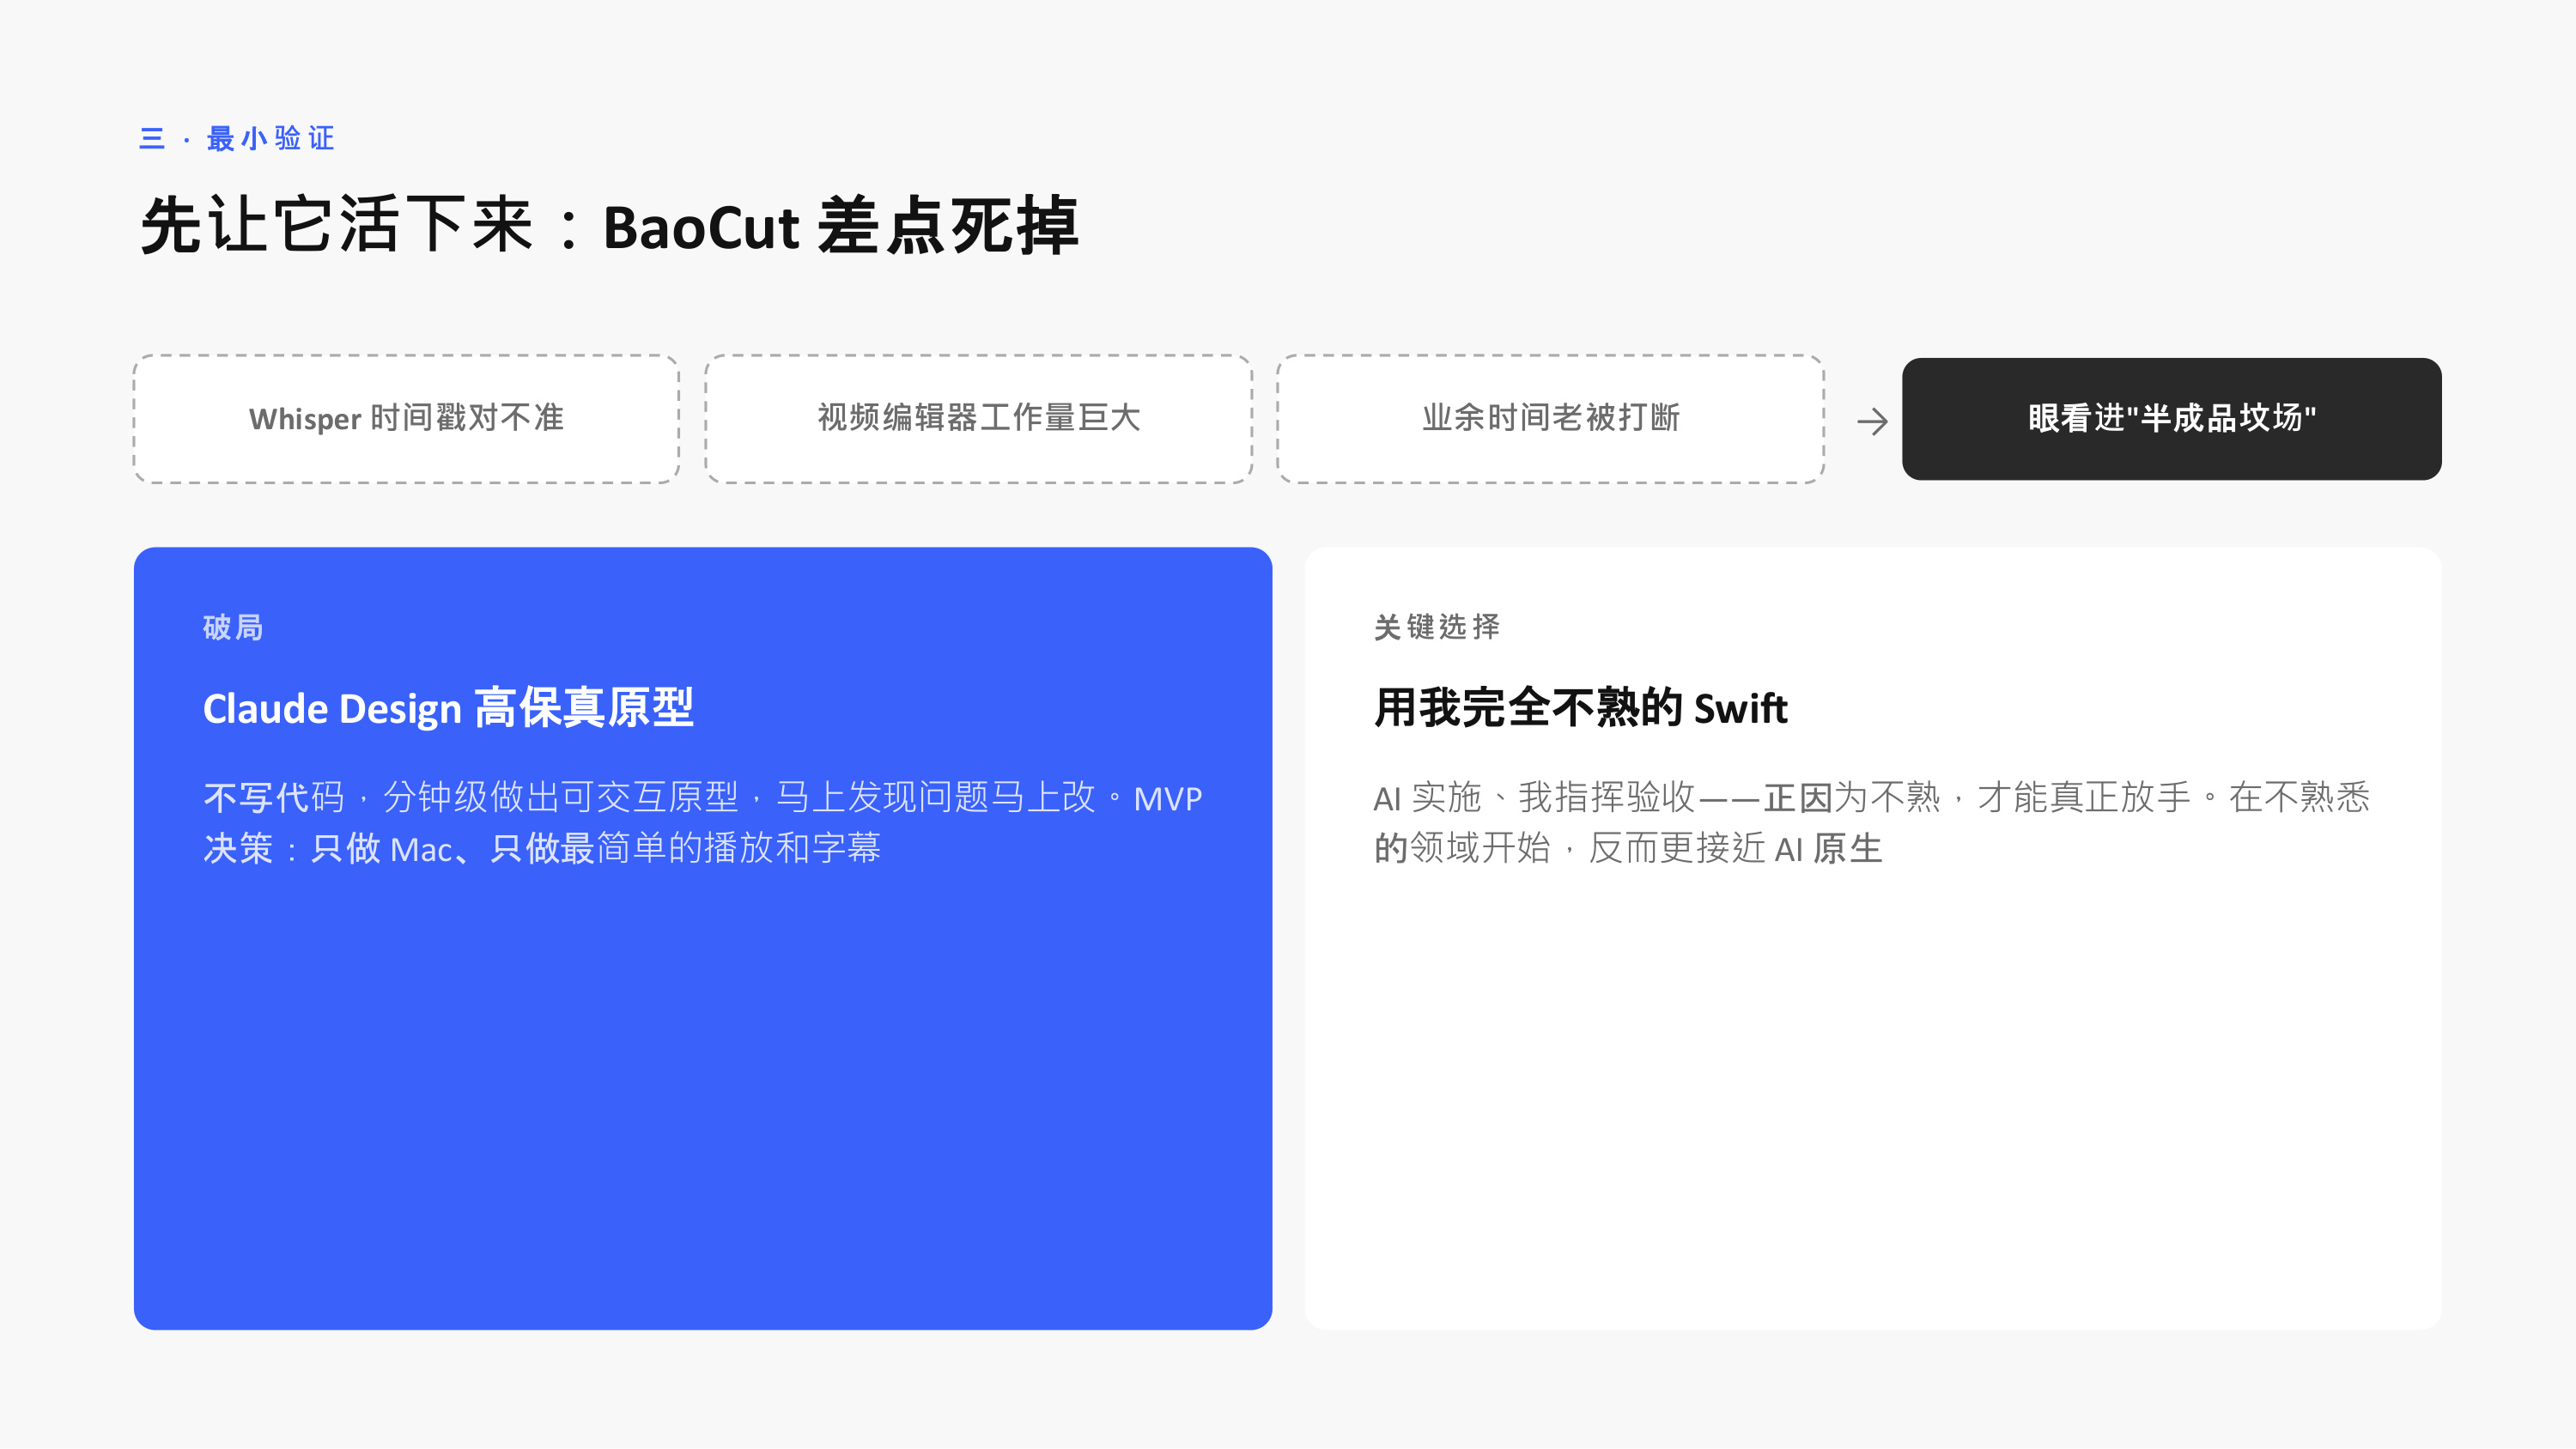 BaoCut 差点死掉:高保真原型与一门不熟悉的语言救了它
▲ BaoCut 差点死掉:高保真原型与一门不熟悉的语言救了它
最小验证的另一面是让坏想法死得早。反例:我嫌刷推特微博太花时间,用 AI 一小时做了个客户端原型,挺漂亮,但做出来发现还不如网页方便,没有每天想用的冲动,砍掉。字幕 App 相反,比脚本好用太多,我每天都在用,就一直迭代到现在。
四、重设计:不要让 AI 模仿人
4.1 V1:模拟人类字幕组
GPT-4 时代的第一版,直觉做法是照搬字幕组流程:先用 Whisper 听写转成 SRT,再交给大模型翻译,最后人工校对并用算法调整时间轴。这套方案能跑通,但毛病不少:模型翻译时常擅自合并上下两条字幕,导致时间戳错位;人工校对得从头到尾看一遍视频,翻一集要花一两个小时;遇到长句还得再调大模型拆分。后来 V1.5 用工作流编排和规则算法打补丁,虽然有所缓解,但在旧框架里修修补补,收益越来越低。
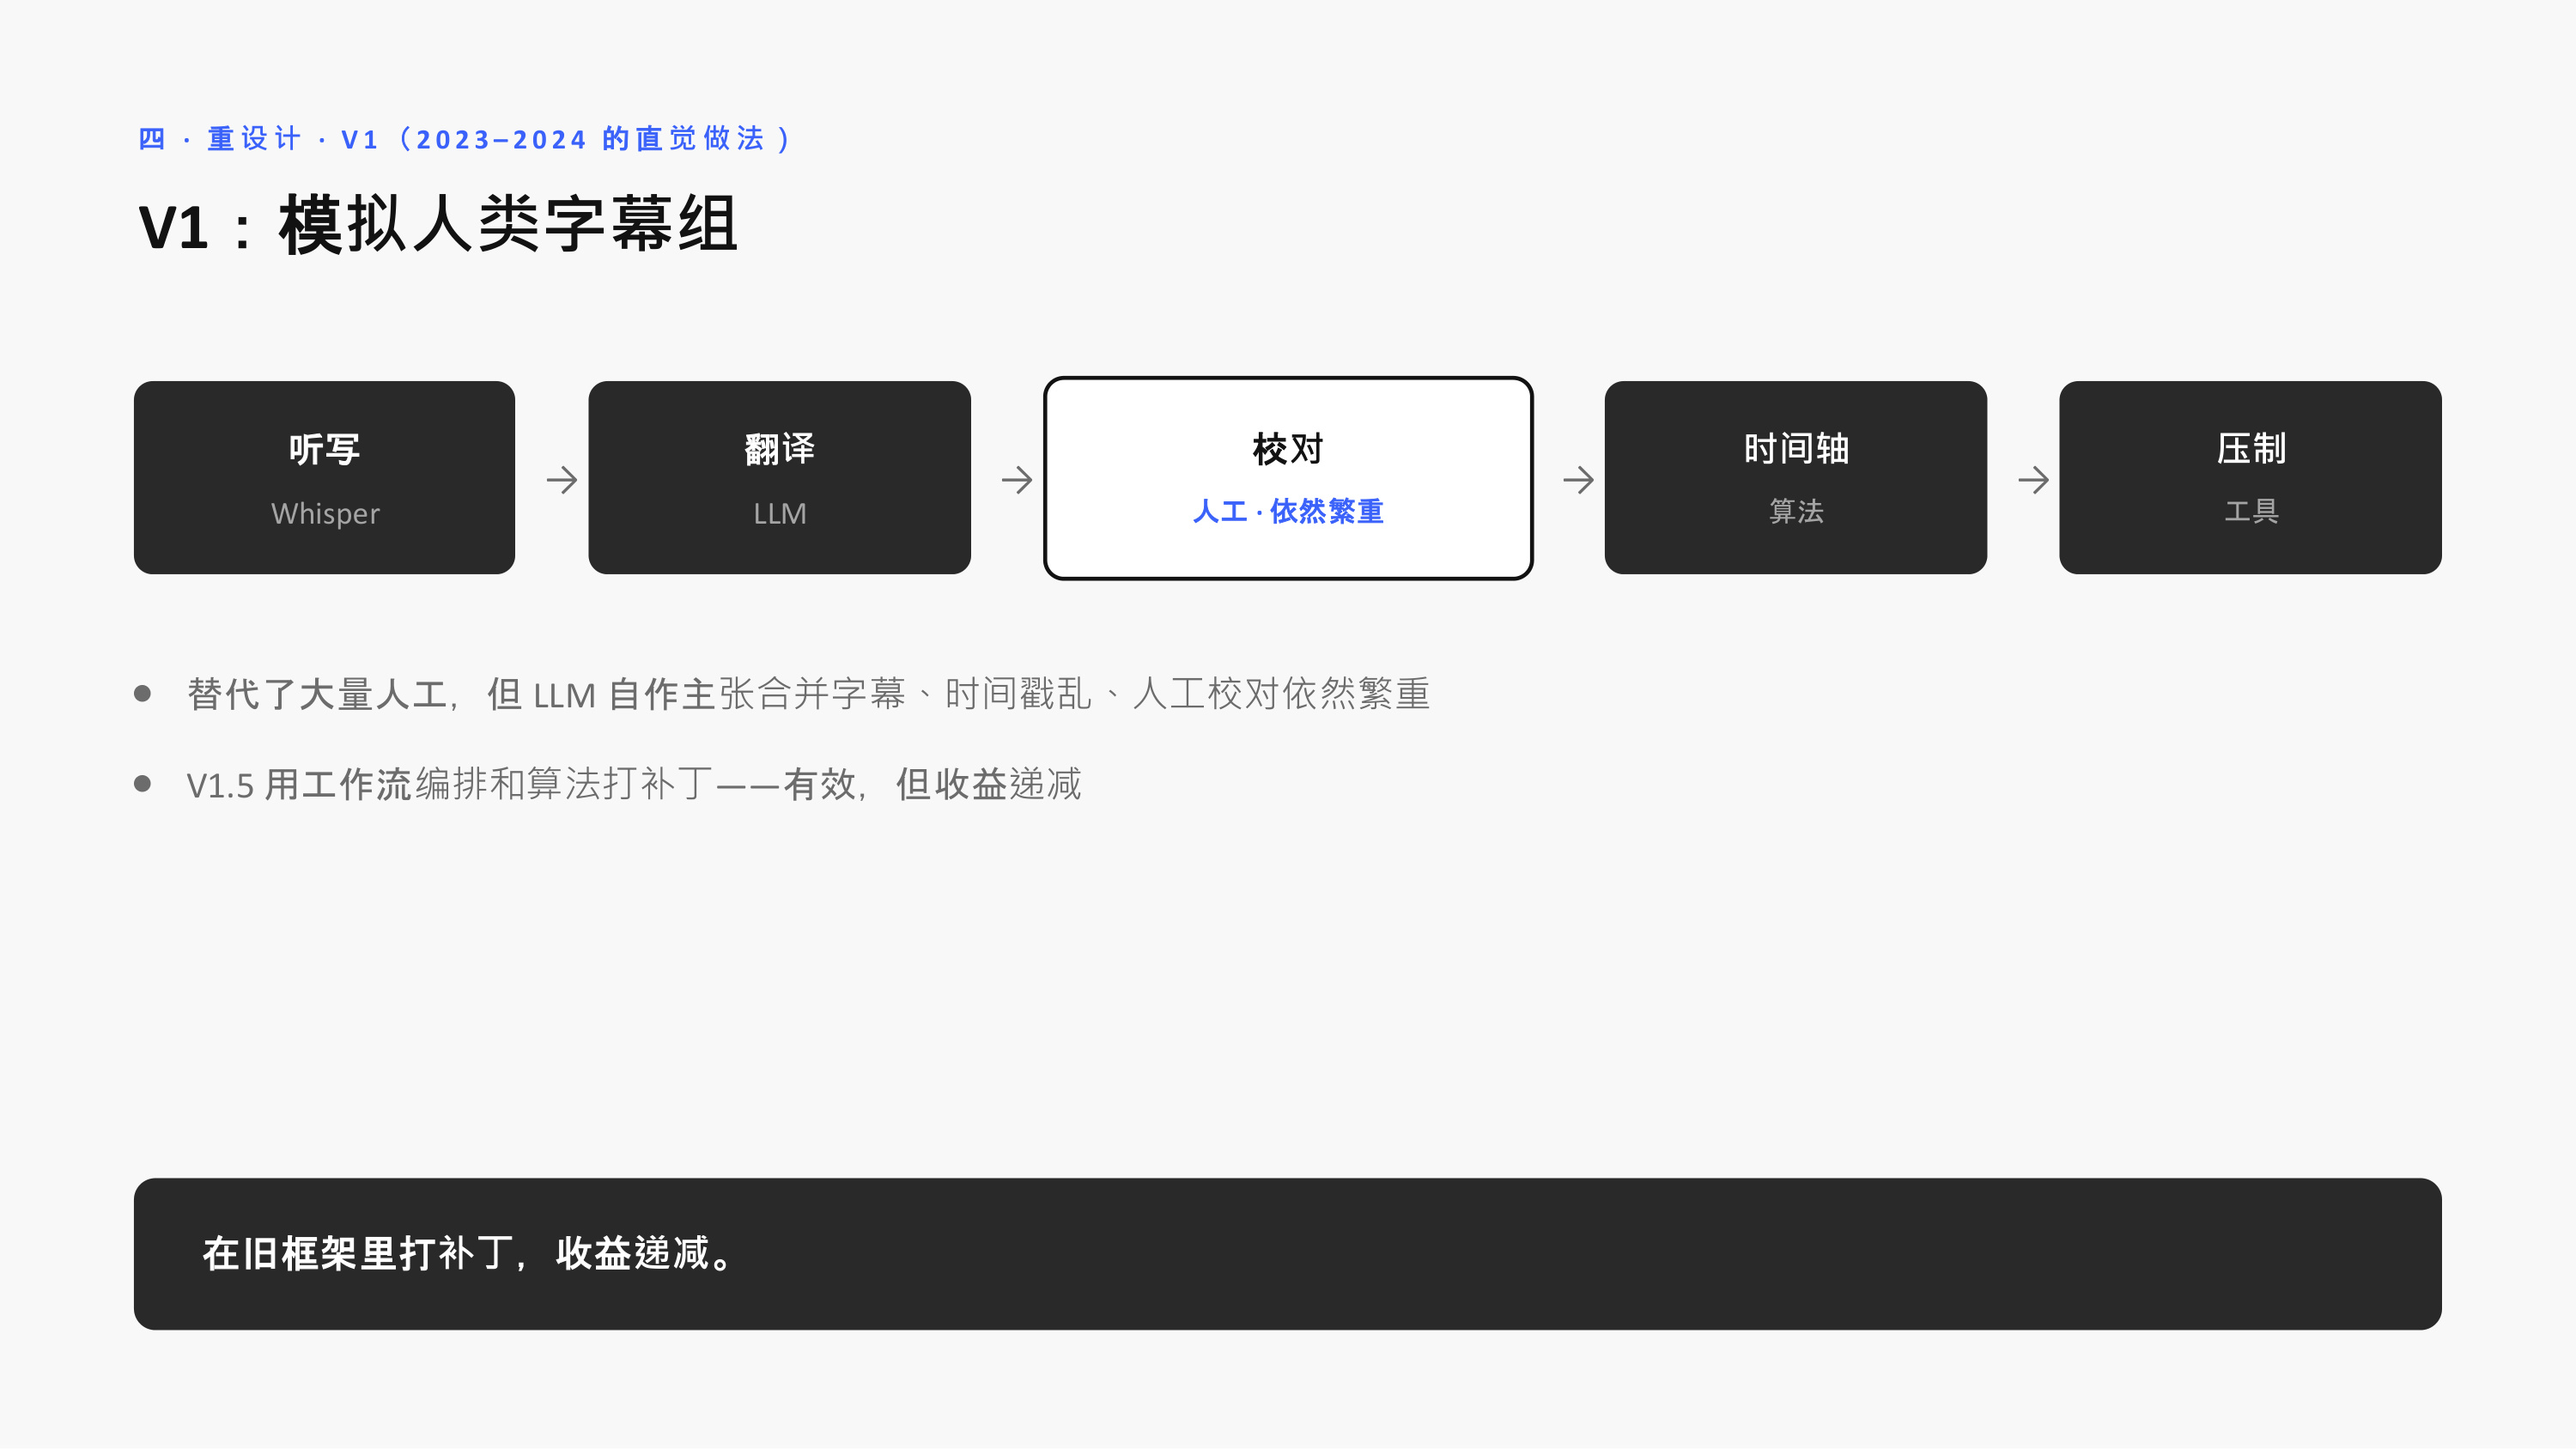 V1 模拟人类字幕组:工具替代了大量人工,但校对依然繁重
▲ V1 模拟人类字幕组:工具替代了大量人工,但校对依然繁重
4.2 V2:以终为始,三连追问
到了 Agent 时代,我重新思考这个产品,思路一句话:以终为始。终点很简单,把英文视频翻译成中文字幕。不问“原流程哪步还能优化”,从终点倒推,连追三个问题:
1第一问:为什么对不齐?
中英文语序不同,英文倒装、中文正序,SRT 条目级对不上,模型为了对上就把两段合并。但句子级一定能一一对应,为什么非要先拆 SRT?因为在模仿字幕组。Whisper 有个选项叫 word timestamp,每个词都有时间戳。我转录时保留词级时间戳,翻译按句子对齐,再回头按词级时间戳重拆,时间轴不用人工对。
2第二问:为什么翻译质量差?
一小时字幕太长,必须分页翻,分页后术语不一致。改进:先做整体分析提取术语表,每页翻译时注入本页术语,保证全局风格一致。
3第三问:为什么这么多人工?
因为在模仿字幕组每步人工校验。V2 里每步都给 Agent 验证工具,比如用脚本校验每条英文是不是正好对应一条中文,Agent 自己验收,人只兜底。配套地,界面从 GUI 变成命令行工具加 Skill 文件,数据从数据库改成静态文件。整个流程 Agent 自主完成,人只在两头:输入视频,最后验收。
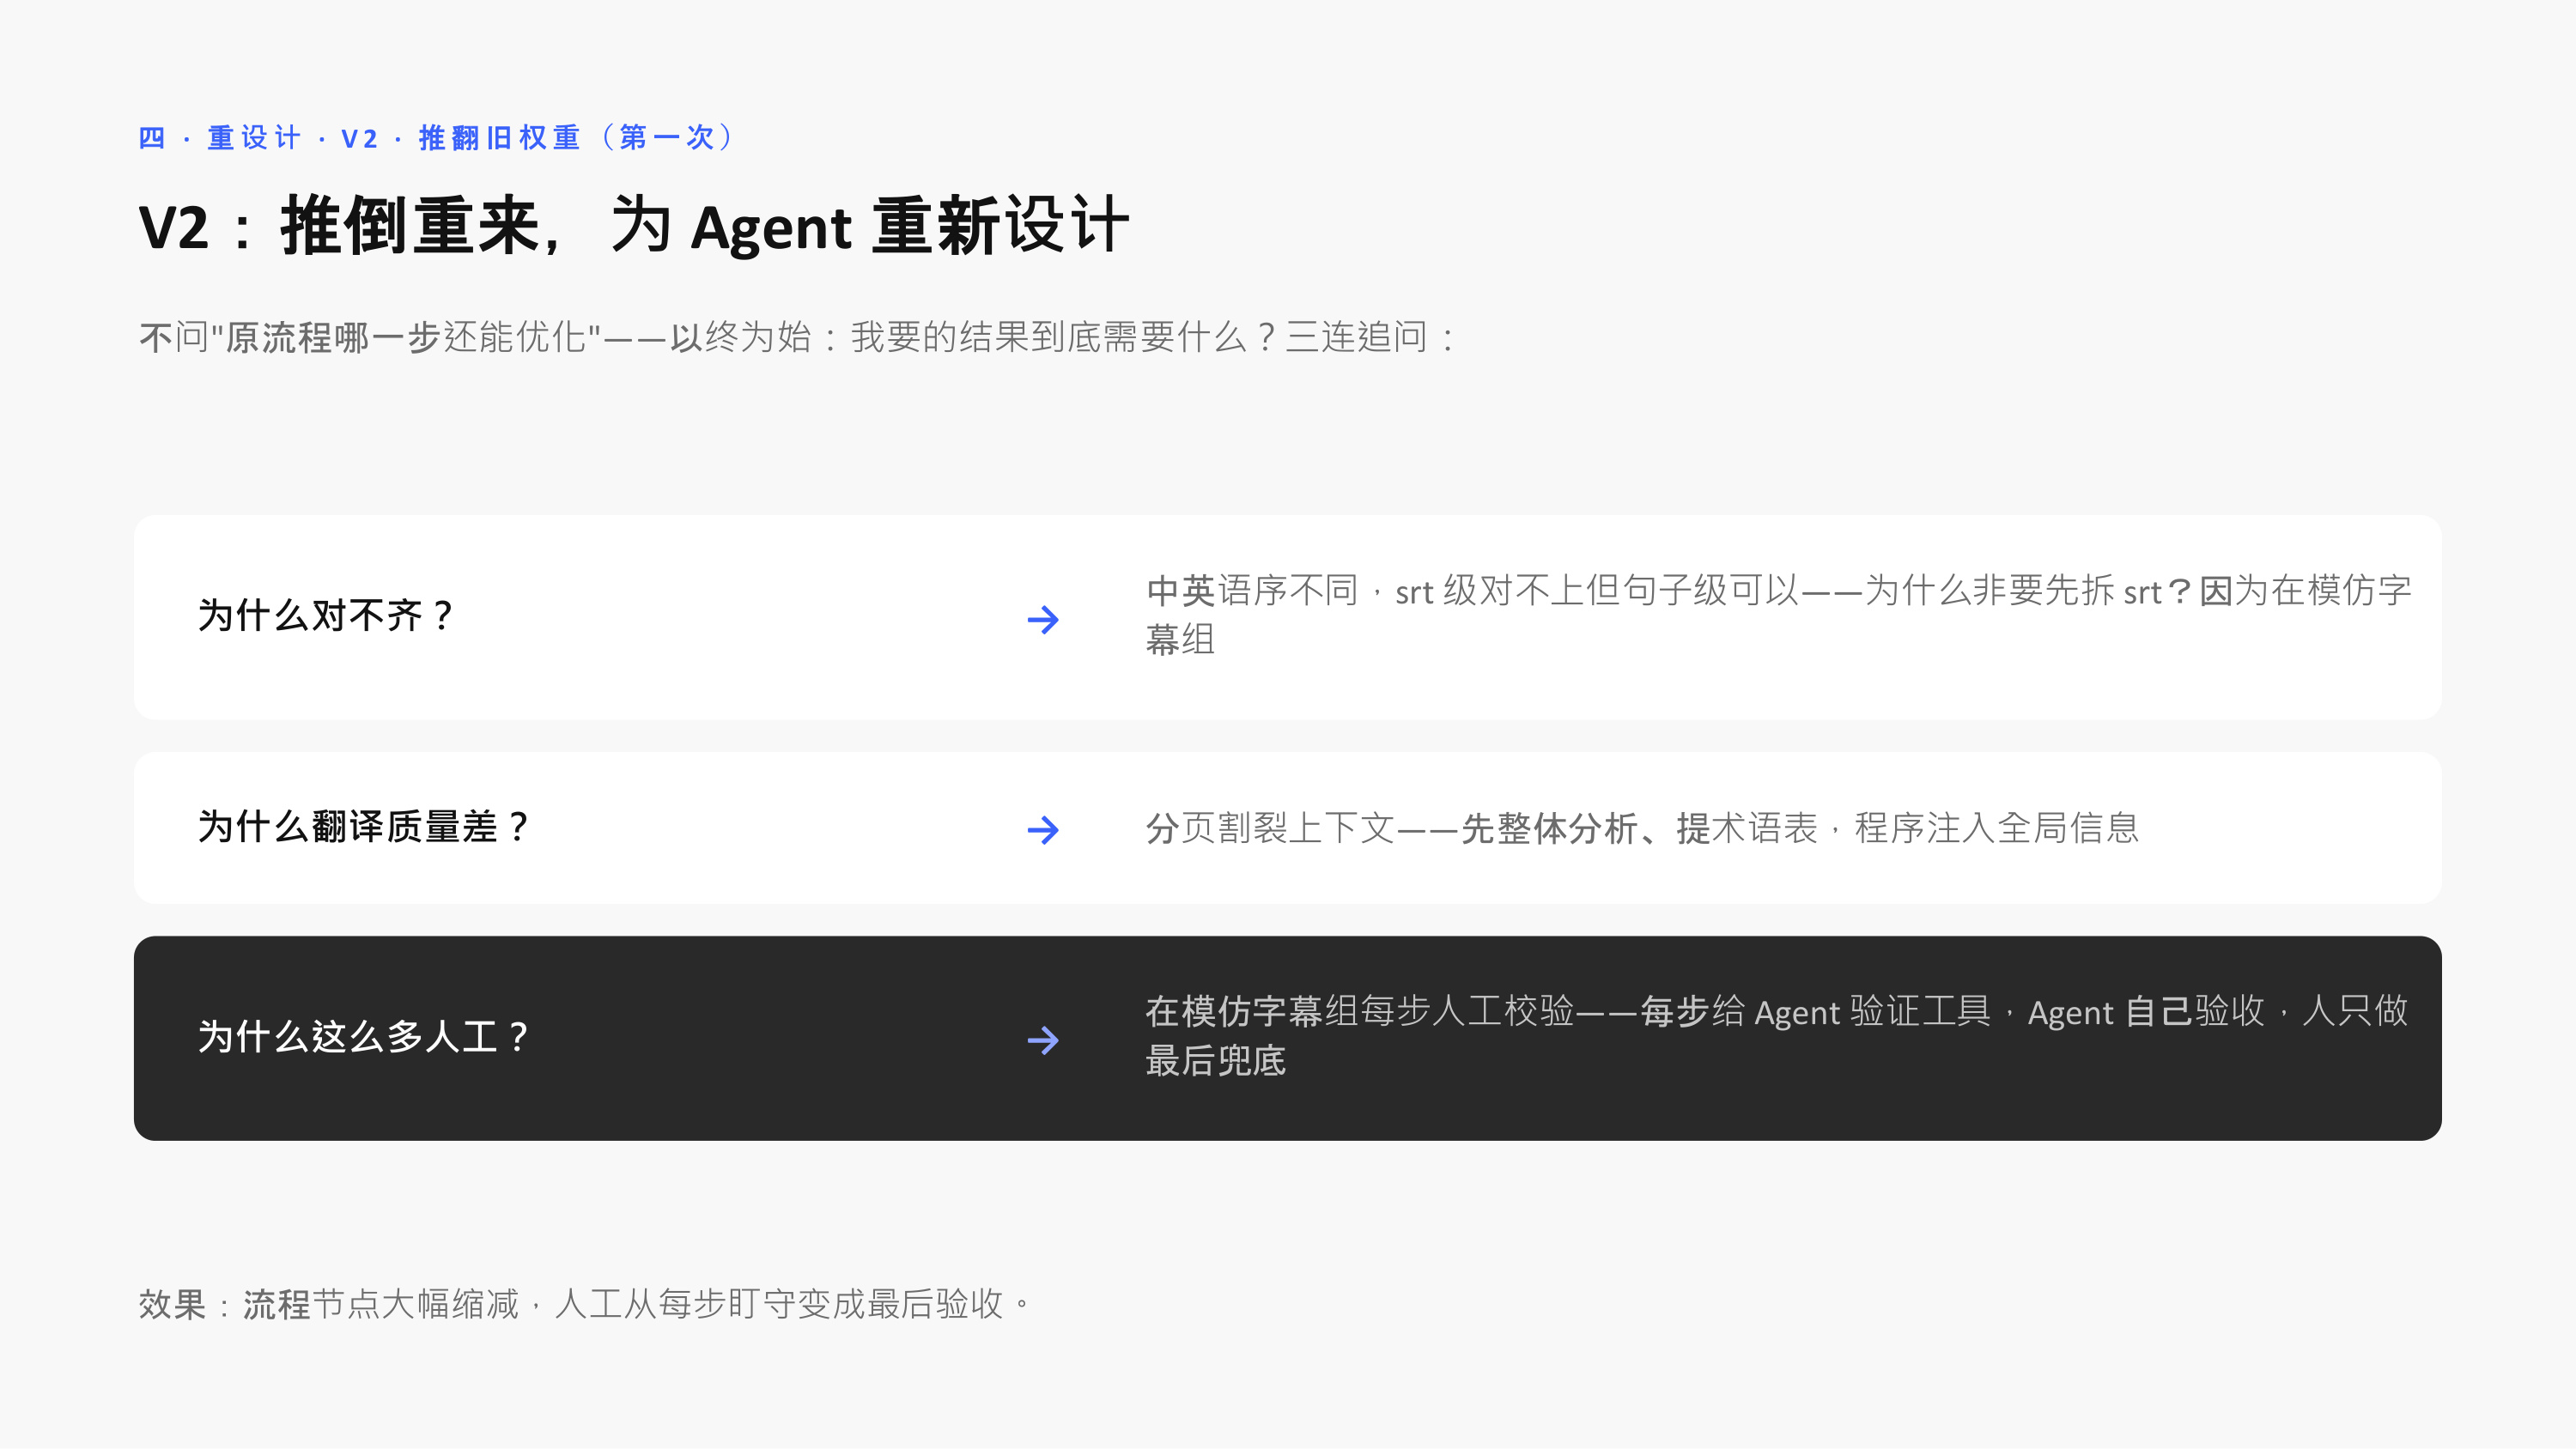 V2 推倒重来:以终为始三连追问
▲ V2 推倒重来:不问原流程哪步能优化,以终为始三连追问
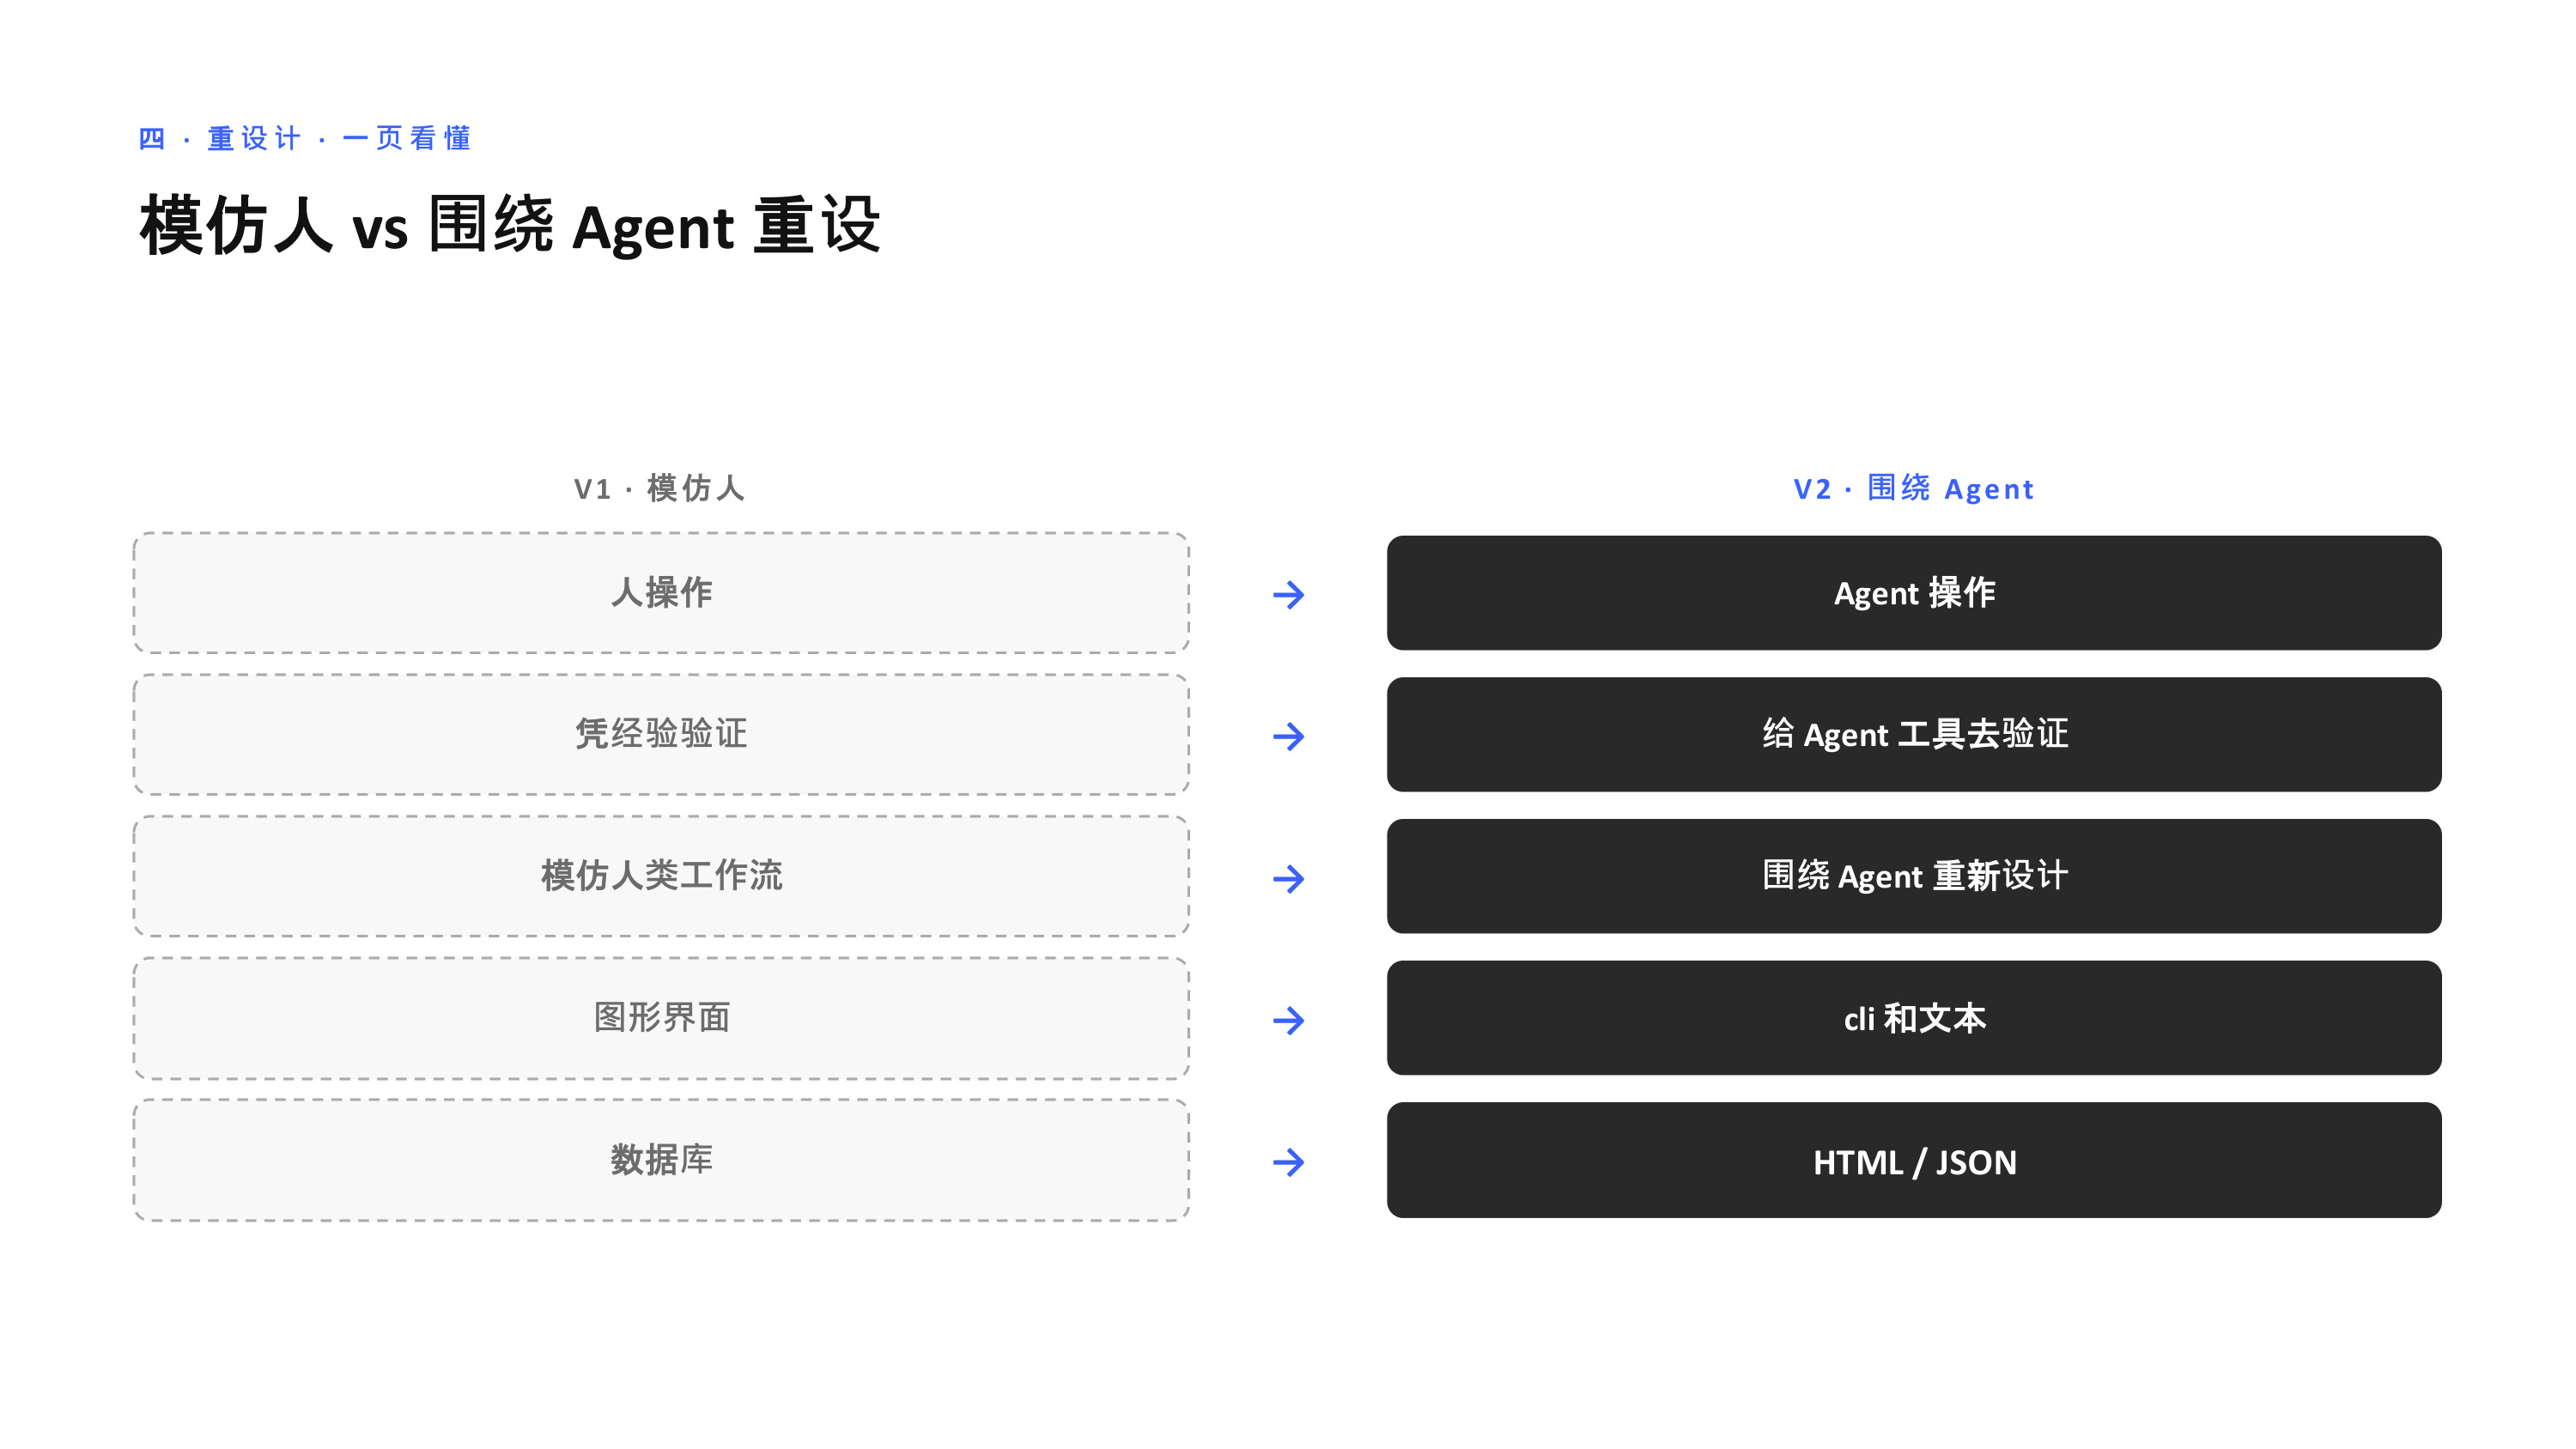 一页看懂:从模仿人到围绕 Agent 重设
▲ 一页看懂:从“模仿人”到“围绕 Agent 重设”
4.3 三条设计准则
- 准则一:让 Agent 操作它最熟悉的格式。HTML、Markdown 和纯文本在训练语料里占比最高,技术选型前先问一句:这种格式模型见得多吗?
- 准则二:给设计规范,不给死模板。固定模板是专家捷径,给规范配模型推理看似笨办法,但《苦涩的教训》早就验证了通用方法终将胜过人工捷径。模型每升级一次,产品不用改代码就能自动变准,这就是“搭架子等模型”。
- 准则三:把 App 做成 Agent 的插件。现在用户遇到需求会先打开 Agent,再由 Agent 调用底层工具。最真实的信号来自我自己:BaoCut 是我写的 App,但现在连我都不点开它的界面了。直接在 Codex 里丢个视频链接说“帮我翻译这个字幕”,它调起 BaoCut 命令行跑完,我只做最后确认。连作者本人都绕过了图形界面,这就是入口迁移最直接的证据。
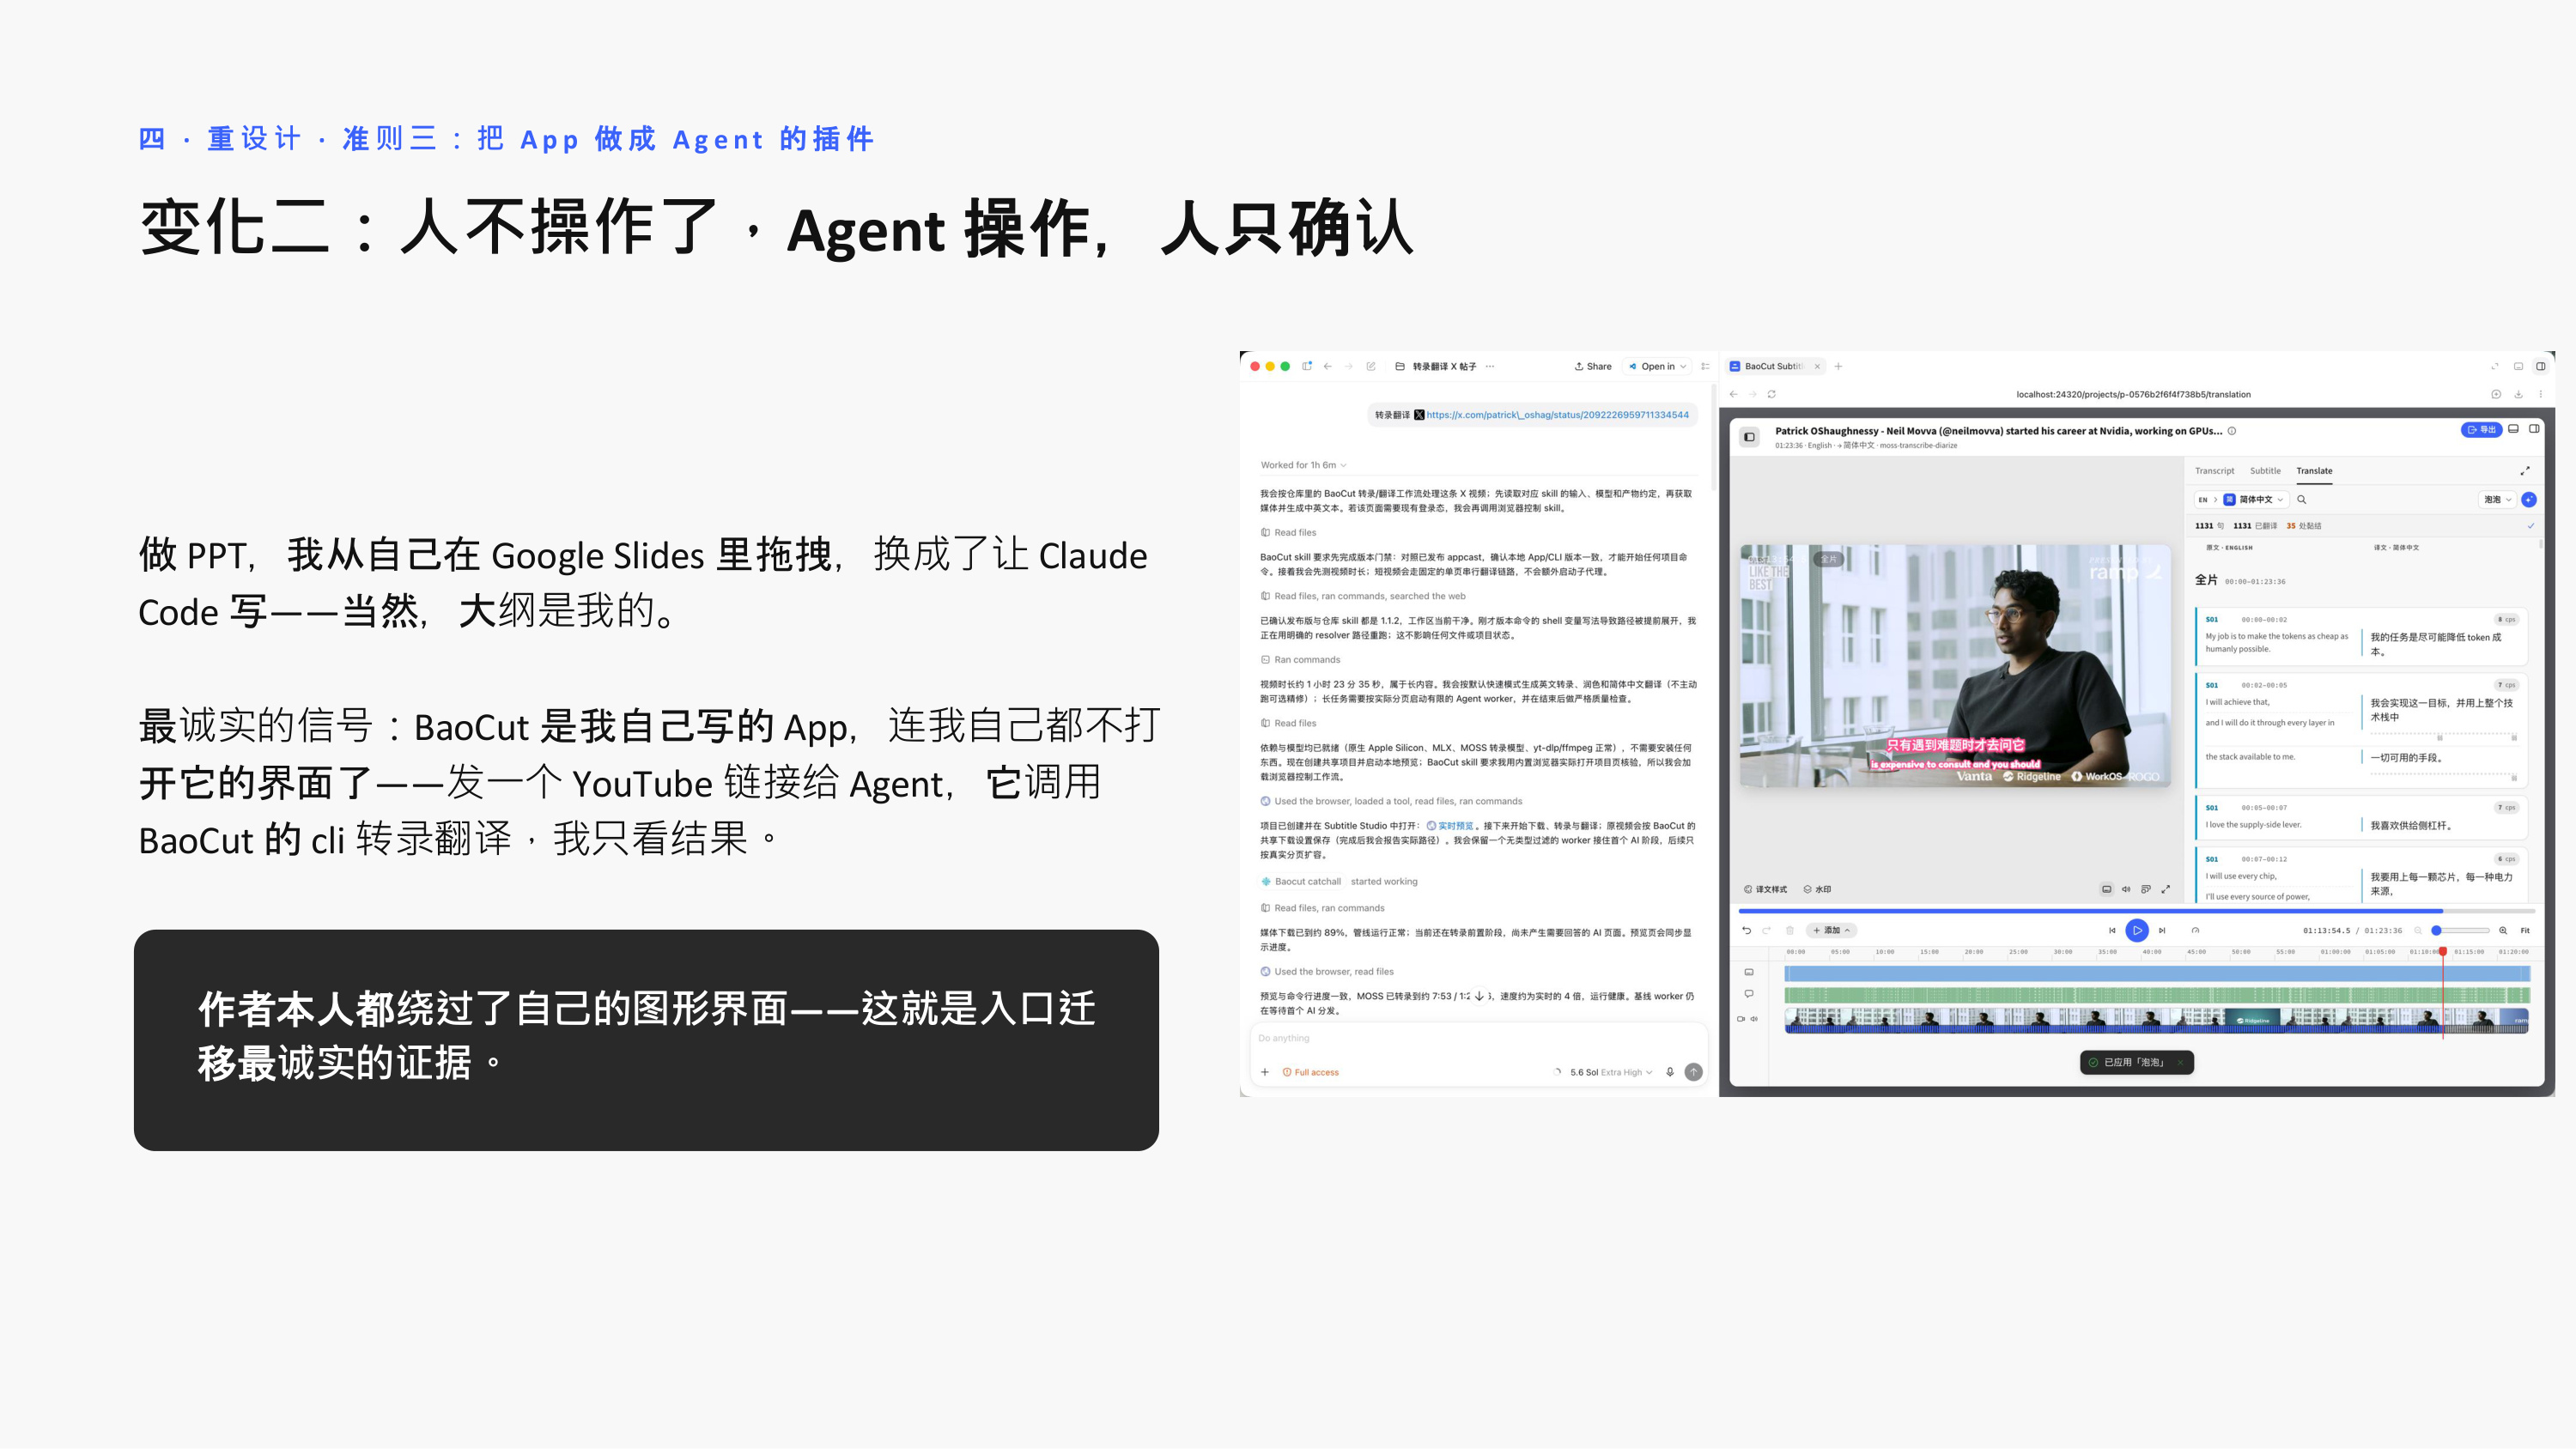 作者本人都绕过了自己的图形界面:入口迁移最直接的证据
▲ 作者本人都绕过了自己的图形界面:入口迁移最直接的证据
五、落地验证:流程没变,人的角色变了
新功能怎么上线?上周有个真实案例:一位用户有两台电脑,一台显卡强但不常用,另一台天天用但性能弱,希望能“远程转录”,用日常主力机调度另一台机器的显卡跑字幕。需求很实在,我按标准工程流程推进,全程没打开代码编辑器。
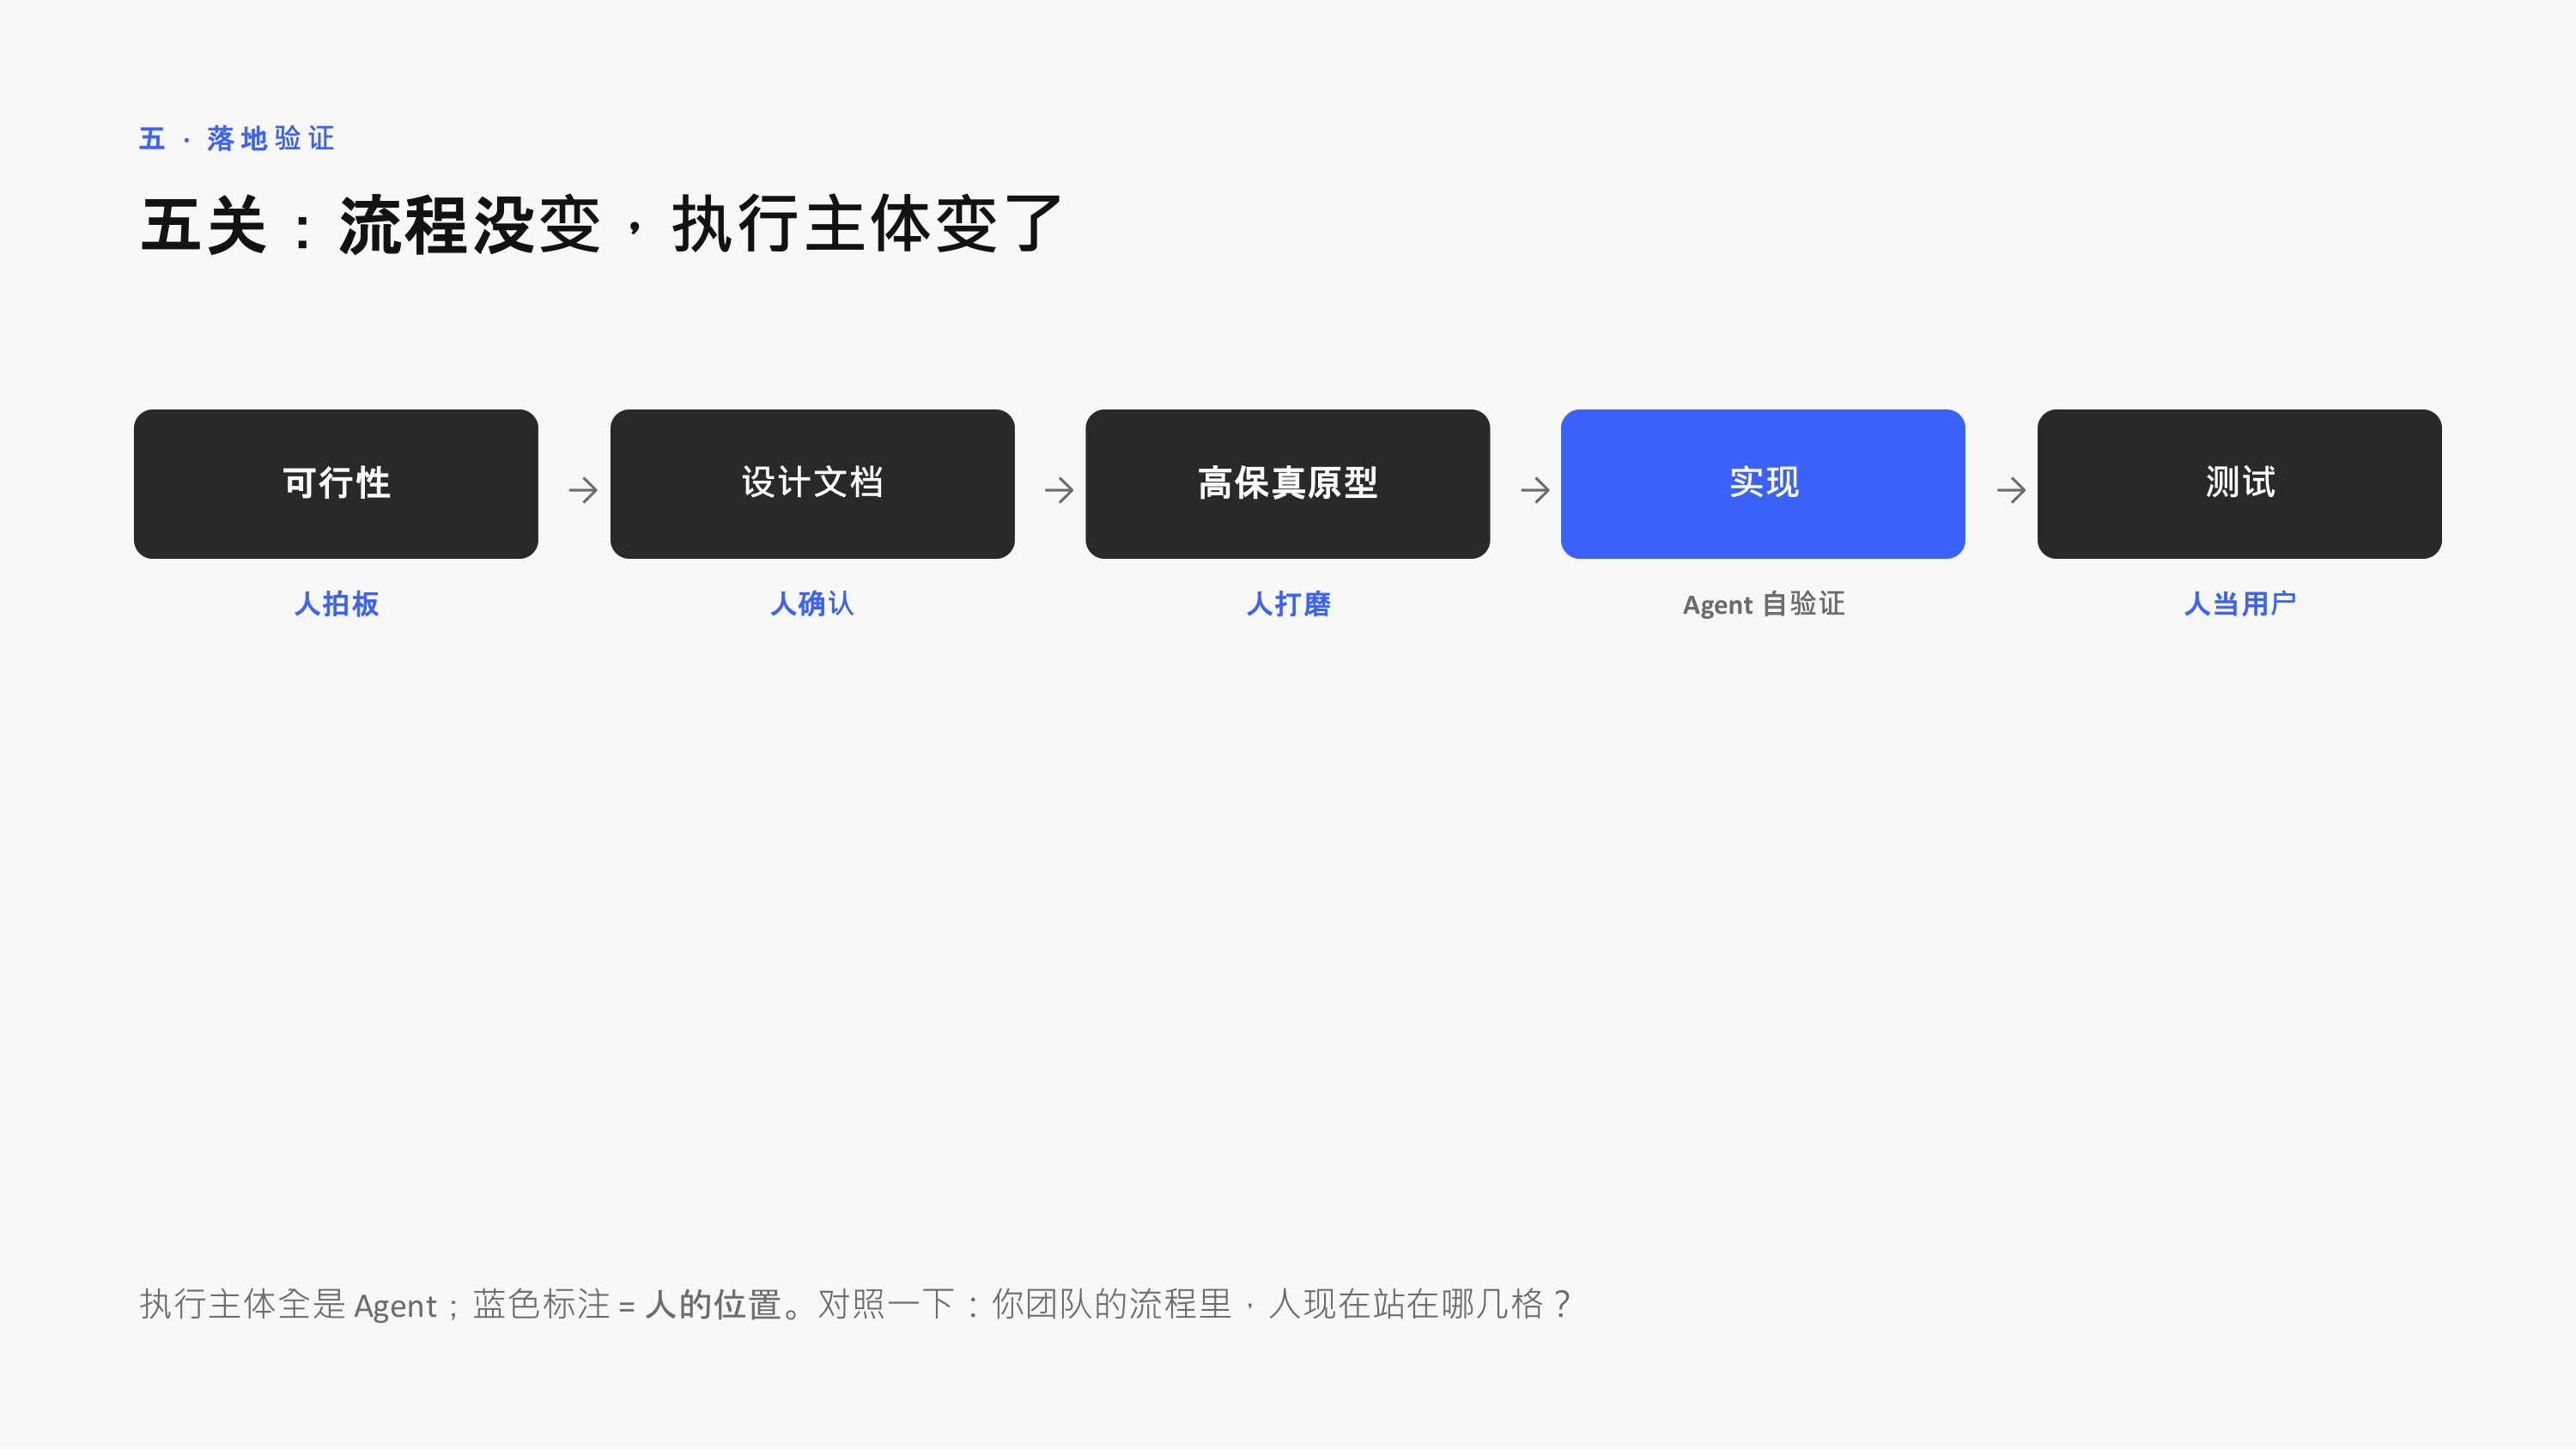 落地五关:流程没变,执行主体变了
▲ 落地五关:流程没变,执行主体变了,人的位置在关键节点上
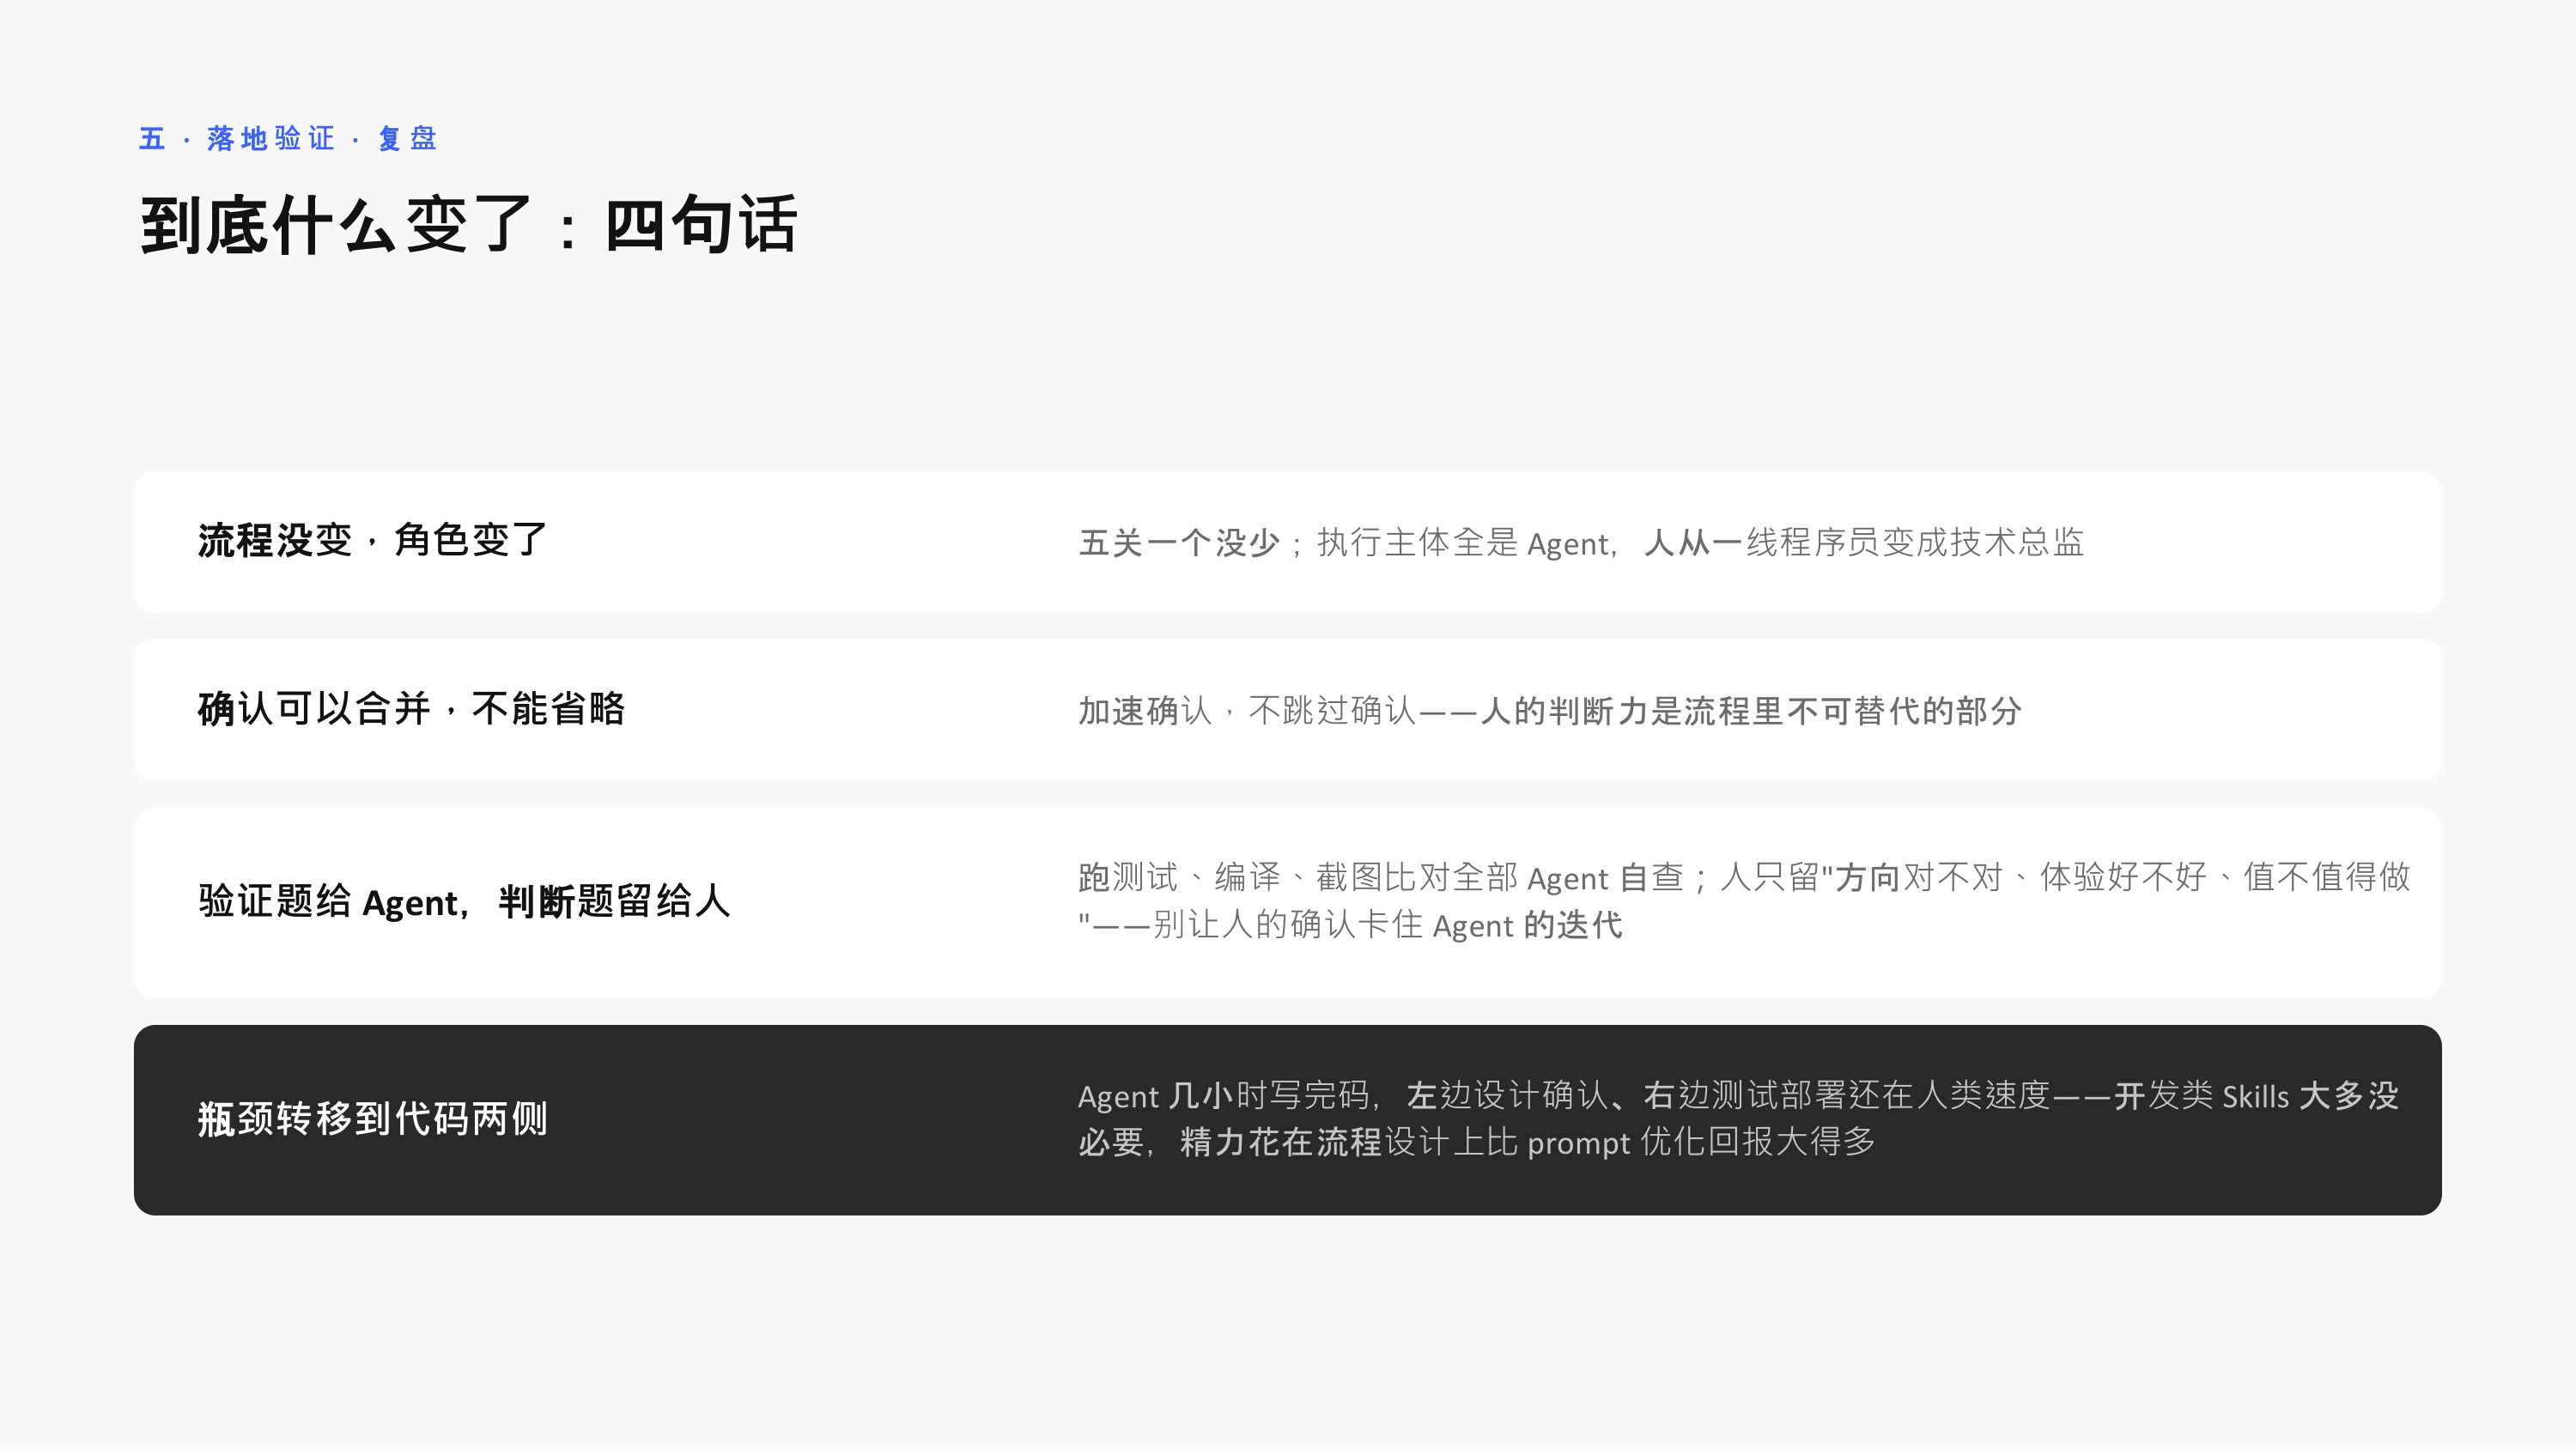 复盘四句话
▲ 复盘四句话:角色变了、确认合并不省略、验证题给 Agent、瓶颈在两侧
• 第一关 可行性:Agent 分析罗列方案,人做判断拍板;
• 第二关 设计文档:文档是一等公民,对人是确认载体,对 Agent 是跨 Session 上下文接力棒;
• 第三关 高保真原型:数据全模拟,看见实物才知道差距,把需求、原型和 UI 合成一次确认;
• 第四关 模块化实现:拆成小阶段目标,一次一个小版本,代码交给 AI 写;
• 第五关 测试验收:把自己当普通用户凭直觉试用,抓功能、性能与安全,把问题扔回给 Agent 改。
整个功能前后历时一两天,实际投入只有几小时,放在以前至少要开发几周。工程流程一步没少,变化的是人的角色:从写代码的程序员转成产品经理兼测试,更接近管理者。确认环节可以合并,但不能省略。验证题交给 Agent,判断题留给人。
六、一页落地地图与持续演进
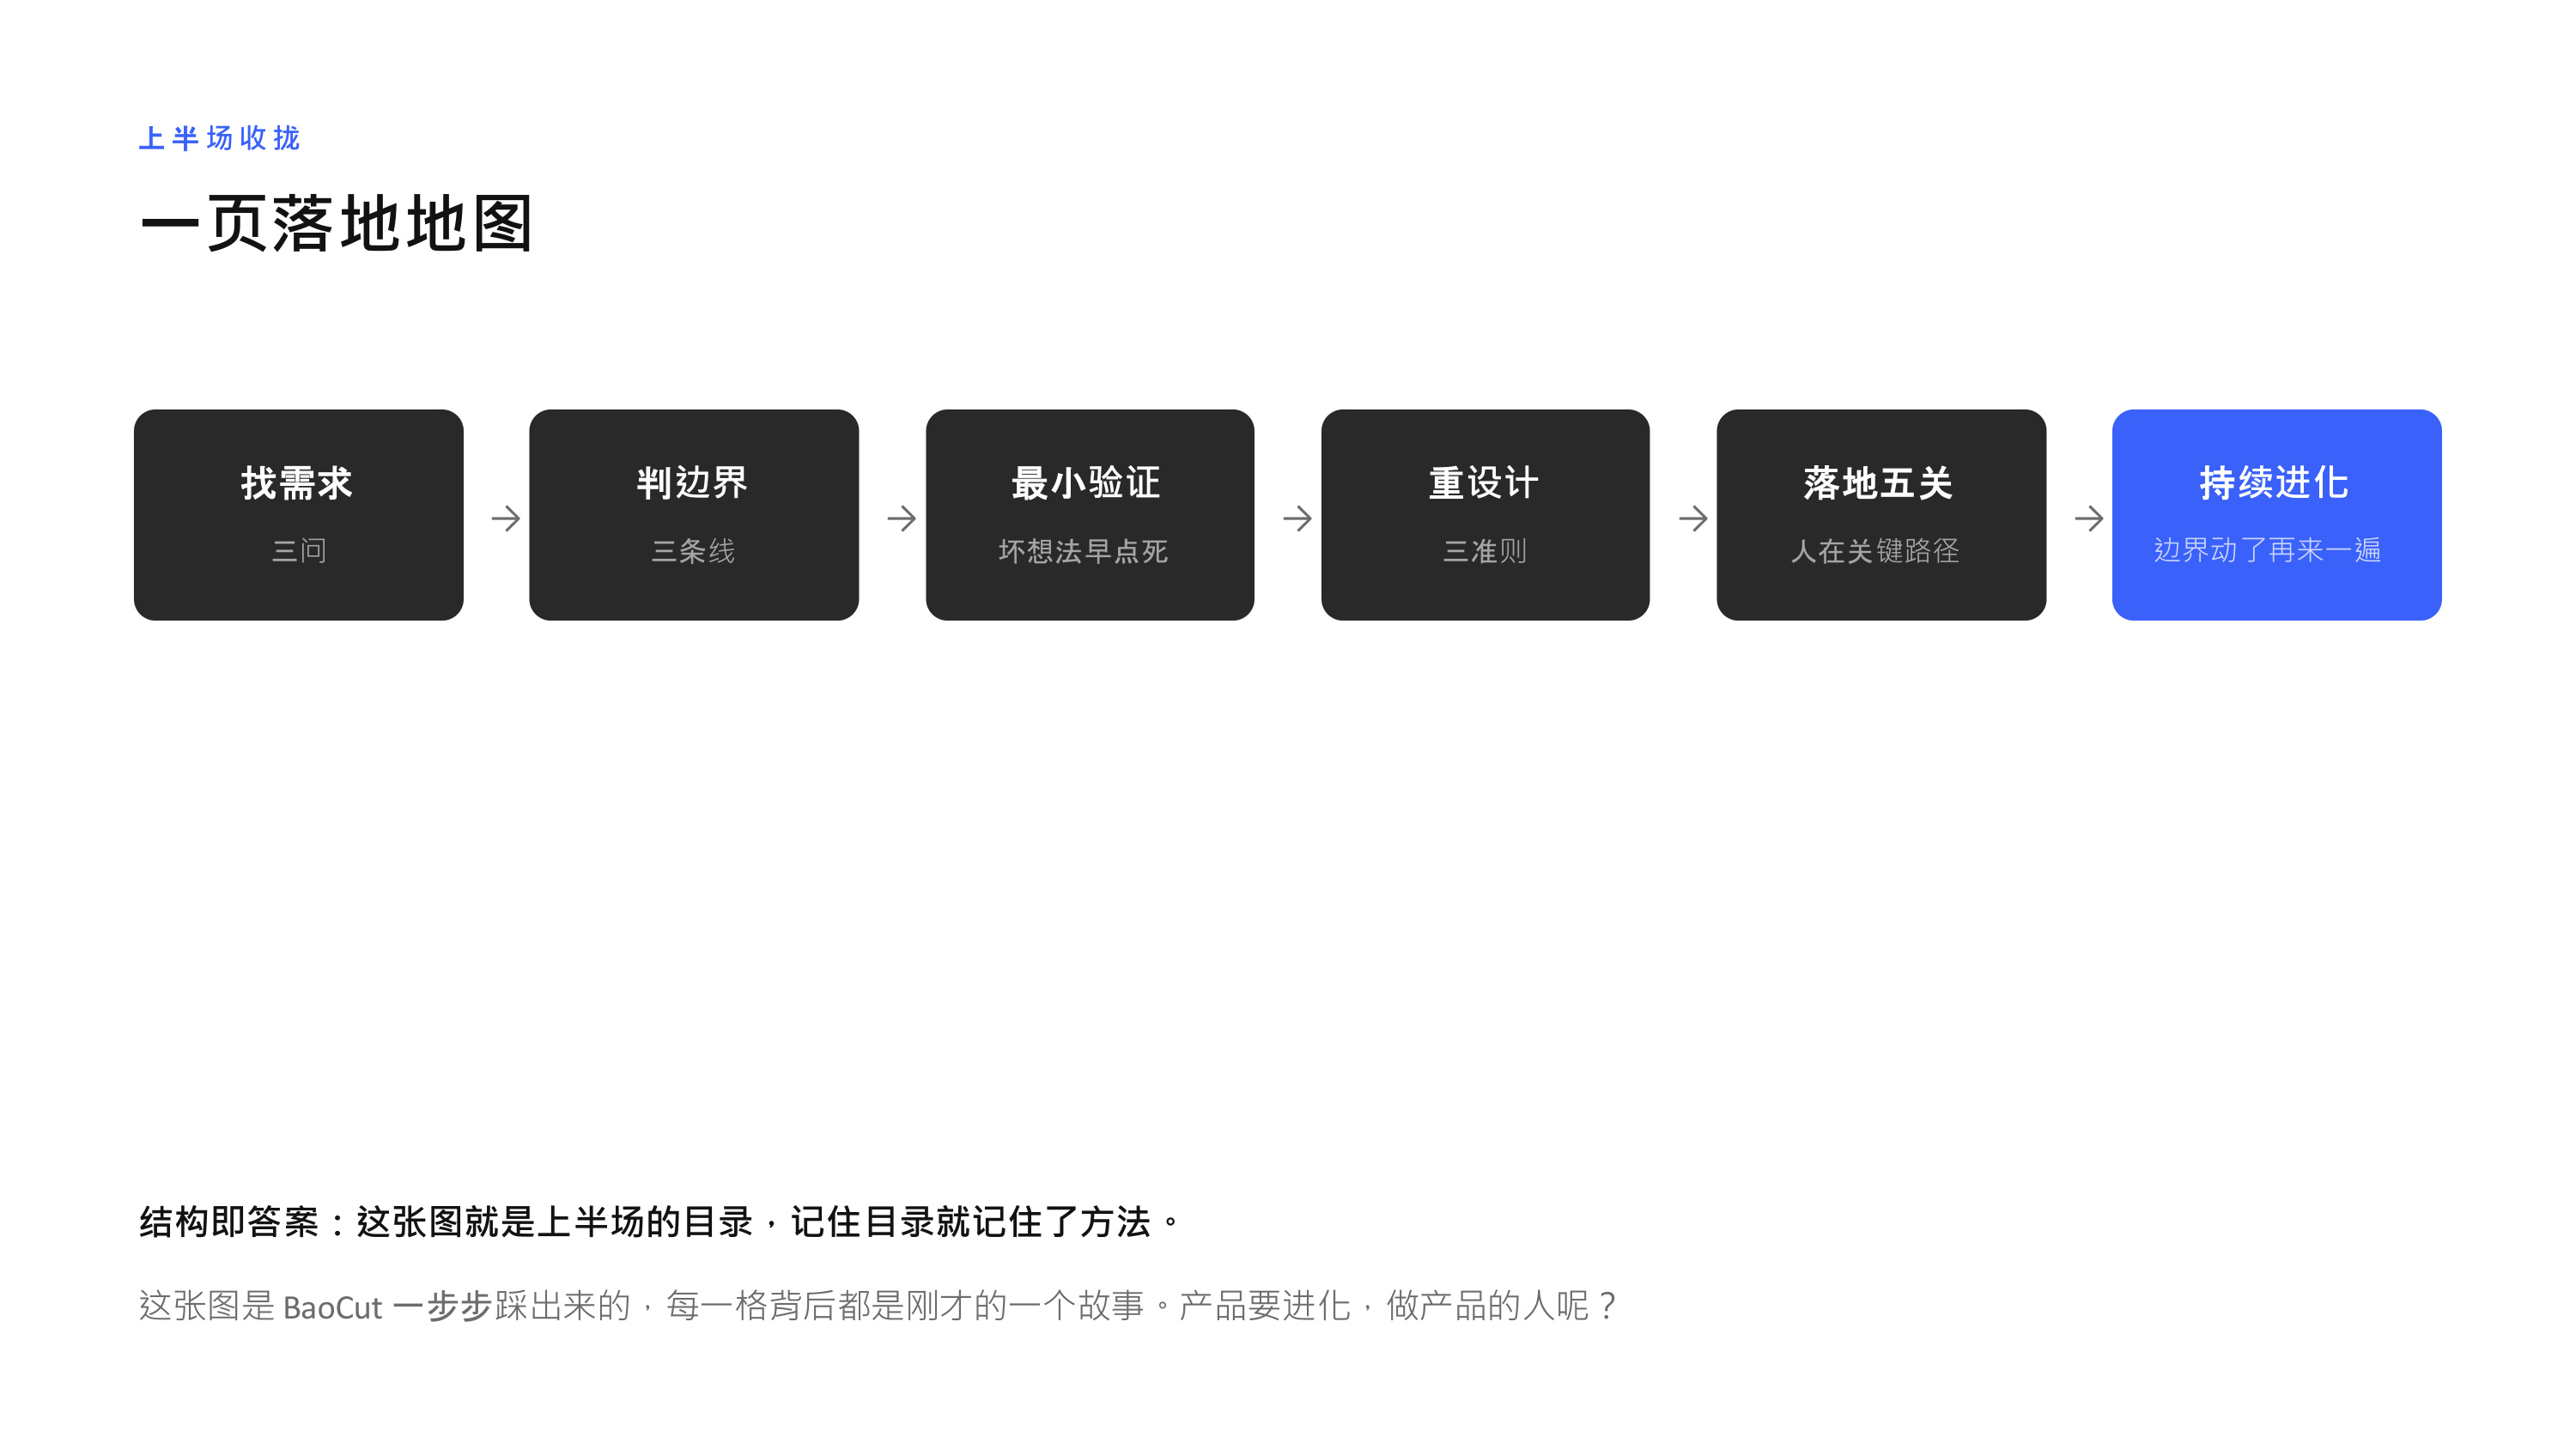 一页落地地图:找需求 → 判边界 → 最小验证 → 重设计 → 落地五关 → 持续进化
▲ 一页落地地图:找需求 → 判边界 → 最小验证 → 重设计 → 落地五关 → 持续进化
做 AI 产品,第一步先筛需求:痛点够不够硬、自己是不是真实用户、AI 能力是不是刚好够到;第二步过三道关:能力、成本和价值。动手时先用高保真原型快速试错,让坏想法尽早淘汰。系统设计要顺应模型习性:配好自检工具,采用模型熟悉的文本格式,给规范而不给死模板。开发阶段把精力放在需求定义和结果验收两头。
模型还在持续演进。今天单 Agent 能干活,明天可能是多 Agent 协同。每次能力边界向外扩一圈,都值得重新审视:在新的边界下,什么样的架构最顺手,又有哪些新需求浮现出来。就像训练大模型要不断更新旧权重,做产品的人也要敢于推翻自己过去的答案。
腾讯内部问答记录(Q&A)
 AI 原生思维腾讯学堂精彩问答
▲ 腾讯学堂现场精彩互动问答
Q1在和 AI 协作的过程中,有没有一个具体的习惯或方法,对个人成长帮助最大?
我的经验就一条:先用起来。只有实践才有真实感悟,我今天讲的开发过程,你不自己做一遍,能带走的东西很有限。最根本的是 建立反馈循环:定义想做的事,AI 帮你做成,你验收;分享出去收反馈;把经验写出来,AI 帮你整素材,输出又倒逼你系统思考。小循环做项目,大循环做分享。把人的成长做成一套 Loop Engineering。
Q2哪些事情该交给 AI 做,哪些事情要留给人这个 Human in the Loop?
执行层交给 AI,不用有心理负担。写代码、生成 PPT 样式让 AI 做就很好。程序员别把自己当写代码的,当 Tech Lead 或 Engineering Manager,AI 是你的员工。你的价值在两头:定义问题和验收结果。定义问题靠反复练习,验收靠品味。
Q3品味感觉有点虚无缥缈,怎么界定和提升品味?
有点像模型的监督微调。编程、数学有客观标准,跑测试就知道;写作没有。我的办法是大量输入加自己上手:读很多文章,自己也写;好的差的一对比,品味就出来了。画图、视频也一样。这件事 AI 短期替代不了,就像大模型靠数据训练涌现能力,人也一样。
Q4作为非工程师,怎么判断 Vibe Coding 出来的代码是否靠谱?
不用太纠结代码格式整不整洁。把自己当成 QA 测试,重点盯三件事:功能完不完整、性能稳不稳定(CPU 与内存占用),以及最高优先级的安全风险(如 SQL 注入与弱口令排查)。其余内部实现直接当黑盒即可。
Q5传统硬件、创意或销售岗位,不知道怎么用 AI 提效,有什么上手建议?
先把 Agent 用起来,别停在网页聊天框。日常重复性的信息整理工作都可以交给它试。比如采购时让 Agent 比价选型,梳理保险条款和合同细则,或者让 Codex 指引走完苹果开发者证书申请这类陌生流程。这跟岗位关系不大,关键是多去试探能力边界,像打游戏开地图一样一点点拓宽。
Q6长生命周期的老项目,文档少、测试不足,AI 一改就出问题怎么破?
抓好两件事:第一是补齐上下文,在仓库里维护一份 AGENTS.md 或 CLAUDE.md,写明目录结构与编码约定;第二是给 Agent 配自检手段,每次加需求或修 Bug 时顺手补上跨模块集成测试,老代码库照样能稳步重构。
原文整理自:宝玉(@dotey) 在腾讯学堂的公开技术分享《AI 原生思维:像训练大模型一样训练自己》。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。